Videogenerierungsmodelle entwickeln sich rasant, aber die meisten funktionieren immer noch wie Szenengeneratoren. Sie erzeugen einen Clip un...
Videogenerierungsmodelle entwickeln sich rasant, doch die meisten bleiben auf der Ebene von Materialgeneratoren. Sie erzeugen einen Clip, und der Ersteller muss anschließend in einer separaten Schnittanwendung Untertitel, Typografie, Übergänge, Farbkorrektur, Musik, Rhythmus und visuelle Effekte selbst bearbeiten.
Genau für diese Änderung des Arbeitsablaufs wurde MiniMax H3 entwickelt.
H3 wurde am 31. Juli 2026 veröffentlicht und ist ein universelles multimodales Videomodell, das im selben Kontext Text, Bilder, Videos und Audioeingaben verarbeiten kann. Es kann 4 bis 15 Sekunden lange Videos mit synchronisiertem Stereoton erzeugen, mit einer Ausgabeauflösung von bis zu 768p oder maximal 2K.
MiniMax gibt an, dass das Modell darauf ausgelegt ist, am gesamten Content-Produktionsprozess teilzunehmen – nicht nur an der Erzeugung von Rohmaterial. Die Zielanwendungen umfassen Werbung, Markenkommunikation, E-Commerce, Produktdesign, UI und UX, Gaming, animierte Poster, Titelsequenzen sowie Social-Media-Inhalte.
MiniMax positioniert H3 als Open-Weight-, universelles multimodales Videomodell.
Der ursprüngliche Bericht beschreibt diesen Wandel als den „Programmierung-Moment" der Videogenerierung. Diese Metapher ist nicht wörtlich zu verstehen, aber die Idee dahinter ist wertvoll: Ersteller können zunehmend das gewünschte Ergebnis beschreiben, Referenzmaterial bereitstellen, die Ausgabe prüfen und über natürliche Sprachbefehle iterieren – ohne jede Ebene manuell aufbauen zu müssen.
Open-Weight-Status: MiniMax gab zunächst an, dass die Gewichte innerhalb weniger Tage veröffentlicht würden. Die offiziellen H3-Base-Checkpoints sind jetzt auf Hugging Face verfügbar, unter der MiniMax-H3-Community-Lizenz. Allerdings sind H3-Context-IR, H3-Regenerate-2K sowie die Sparse-Attention-Implementierung nicht vollständig in der initialen Gewichtsveröffentlichung enthalten.
Die ersten beeindruckenden Beispiele sind keine einfachen Filmaufnahmen. Sie umfassen dynamische Typografie, handgezeichnete Effekte, Produktgrafiken, animierte Titelsequenzen, Musik, Dialoge und Übergänge.
Diese werden normalerweise als separate Postproduktionsaufgaben betrachtet.
Ein traditioneller Arbeitsablauf könnte so aussehen:
H3 versucht, mehrere dieser Entscheidungen in einem Modell zu integrieren.
Ein Prompt kann visuellen Stil, Kamerareihenfolge, Rhythmus, Bildschirmtext, Regieanweisungen, Klanglandschaften und Übergangseffekte beschreiben. Referenzdateien können Charaktere, Produkte, Bewegungen, Kamerastil, Sound, Filmmusik oder Schnittrhythmus liefern.
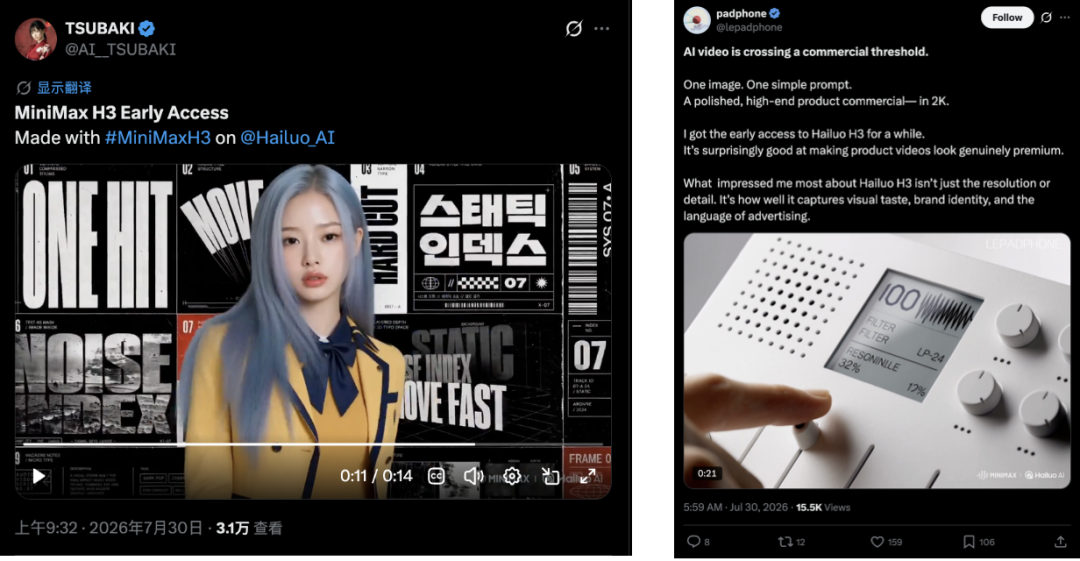
Frühe Tester erstellten mit H3 stilisierte Charaktervideos und hochwertige Produktdarstellungen.
Das bedeutet nicht, dass professionelle Schnittsoftware überflüssig wird. Längere Projekte benötigen weiterhin präzise Timeline-Kontrolle, Asset-Verwaltung, Korrekturen, rechtliche Prüfungen und die Auslieferung in mehreren Formaten.
Der wesentliche Wandel liegt darin, dass das Modell nun in einem einzigen Generierungsschritt Inhalte erzeugen kann, die näher am fertigen Kurzvideo liegen.
Der ursprüngliche Autor testete H3 über die Hailuo-Oberfläche von MiniMax.
Das erste Experiment war ein Behind-the-Scenes-Video einer fiktiven Boygroup mit bekannten Persönlichkeiten aus der KI-Branche. Der Textprompt beschrieb den gewünschten Ton und den Schnittstil, während H3 die visuelle Sequenz erzeugte.
Anschließend testete der Autor ein Veröffentlichungsvideo mit einer Apple-typischen Präsentationsästhetik. Durch nur kurze Stil-Tags enthielt das Ergebnis halbtransparente Glaseffekte, Verläufe, dynamische Grafiken und einen präsentationsähnlichen Rhythmus.
Ein anspruchsvollerer Test verwendete einen langen Prompt zur Beschreibung eines sechs Einstellungen umfassenden Trailers. Jede Einstellung hatte ihre eigene emotionale Ausrichtung, Regieanweisung und ihr eigenes Tempo.
Laut Bericht folgte H3 der Einstellungsreihenfolge eng und erzeugte eine klar strukturierte schnelle Montage, anstatt die Anweisungen zu einem allgemeinen Clip zusammenzufassen.
Diese Art von Aufgabe testet gleich mehrere Fähigkeiten:
Die Ergebnisse bleiben subjektive Demonstrationen, keine kontrollierten Benchmarks. Ein erfolgreicher Social-Media-Fall garantiert nicht, dass jeder lange Prompt beim ersten Versuch gelingt.
Dennoch ist das Modell im Vergleich zu älteren Videosystemen, die nur kurze visuelle Beschreibungen erwarteten, deutlich besser für strukturierte kreative Anweisungen geeignet.
Text war historisch eine der schwächsten Stellen in KI-generierten Videos.
Bildmodelle müssen nur in einem Frame ein Wort korrekt darstellen. Videomodelle müssen über viele Frames hinweg dieselbe Typografie beibehalten, während sich Kamera, Oberflächen, Beleuchtung und die umgebende Szene ständig bewegen.
Ein kleiner Fehler in einem einzigen Frame kann zu Flackern, Rechtschreibfehlern oder instabiler Typografie führen.
Die ursprünglichen Tests zeigen, dass H3 bei folgenden Aspekten ein brauchbares Niveau erreicht:
Auch in den offiziellen Veröffentlichungsmaterialien von MiniMax werden präzise Text- und Markendarstellung als Kernfähigkeit genannt.
Das Modell garantiert nicht bei jeder Generierung perfekten Text. Kleine Schriftgrößen, lange Sätze, spezielle Schriftarten und komplexe Bewegungen können weiterhin zu Fehlern führen.
Der größere Wert von H3 liegt darin, dass es offenbar die Beziehung zwischen Text und Szene modellieren kann.
In einem Beispiel weist der Text, der mit einer Diamantkette assoziiert wird, reflektierende Lichteffekte und Tiefenwirkung auf – statt einer simplen flachen Überlagerung. Das kommt einer visuellen Komposition näher als einer gewöhnlichen Untertitelplatzierung.
Für kommerzielle Teams ist zuverlässige Typografie oft wertvoller als cineastische Kamerabewegungen. Werbung, Produktlaunches, Social-Media-Inhalte und mehr hängen von lesbaren Informationen ab.
H3 erzeugt Audio und Video gemeinsam.
Die offizielle Modellkarte spezifiziert Folgendes:
Die von MiniMax gelisteten unterstützten Sprachen für Dialoge:
Weitere Sprachen funktionieren möglicherweise auch, mit Qualitätsunterschieden.
Der ursprüngliche Bericht weist außerdem darauf hin, dass Nutzer Audio als Referenz bereitstellen können. H3 kann Sprachausschnitte, Musik oder andere Audiomaterialien zusammen mit Bild- und Videoreferenzen kombinieren.
In der aktuellen API kann Audio nicht als einzige Referenzeingabe verwendet werden; es muss zusätzlich ein Bild oder Video angegeben werden.
Diese Integration ist wichtig, da generierte Sprache zum Rhythmus und zur Emotionalität der Szene passen sollte. Nachträglich in Videos eingefügte Sprachaufnahmen klingen zwar korrekt, können aber von Gesichtsbewegungen, Rhythmus oder Kameraschnitten entkoppelt sein.
Das native audiovisuelle Design von H3 zielt darauf ab, diese Elemente synchron zu halten.
MiniMax bepreist H3 nach der Länge des generierten Videos.
Die aktuellen globalen Pay-as-you-go-Tarife:
| Ausgabe | Preis |
|---|---|
| 2K-Video | 0,13 US-Dollar pro Sekunde |
| 768p-Video | 0,08 US-Dollar pro Sekunde |
| 768p-zu-2K-Regenerierung | 0,05 US-Dollar pro Ausgabesekunde |
| H3-Context-IR-Eingabe | 0,90 US-Dollar pro Million Tokens |
| H3-Context-IR-Ausgabe | 3,60 US-Dollar pro Million Tokens |
Zu den aktuellen Tarifen kostet eine 10-sekündige direkte Generierung ungefähr:
| Auflösung |
Ungefähre Ausgabekosten |
|-|-|
| 768p | 0,80 USD |
| 2K | 1,30 USD |
Die Abrechnung von Referenzen folgt separaten Regeln:
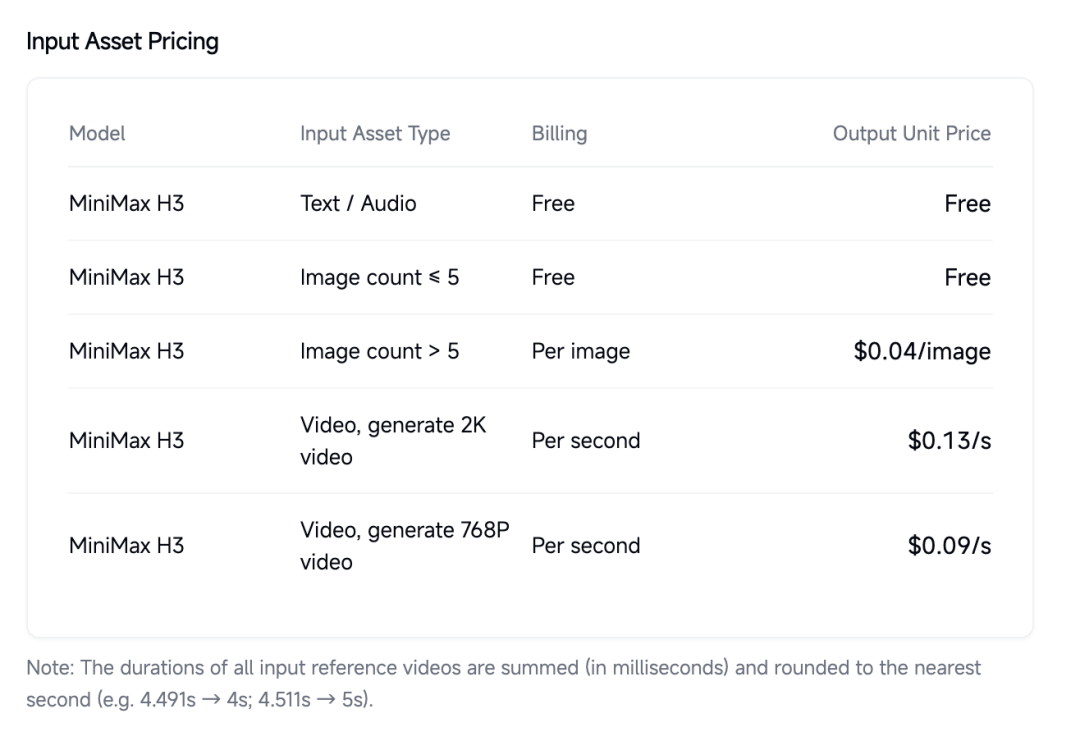
Der Quellartikel hat die ursprünglichen Eingabematerialien und Ausgabepreise von H3 auszugsweise übernommen.
Der obige Screenshot listet den 768p-Generierungspreis mit 0,09 USD pro Sekunde auf. Die aktuelle globale Preisseite von MiniMax weist nun 0,08 USD pro Sekunde aus, daher sollte die offizielle Echtzeitdokumentation als aktuelle Informationsquelle dienen.
MiniMax gibt an, dass H3 bei 2K-Auflösung weniger als ein Drittel der Kosten gängiger Wettbewerber verursacht; bei 768p-Auflösung weniger als die Hälfte der Kosten gängiger 720p-Modelle.
Dieser Vergleich basiert auf den von MiniMax ausgewählten Wettbewerbern und Einstellungen. Die tatsächlichen Kosten pro nutzbarem Video hängen von Wiederholungen, Referenzmaterialien, Segmentlänge, Neugenerierungen und davon ab, ob die erste Ausgabe direkt verwendbar ist.
Artificial Analysis führt MiniMax H3 derzeit an der Spitze seiner Video-Editing-Rangliste mit Audio.
Zum Zeitpunkt der Erstellung dieses Dokuments sieht die Rangliste wie folgt aus:
| Rang | Modell | Elo | API-Preis |
|---|---|---|---|
| 1 | MiniMax H3 | 1.129 | 7,80 USD/Minute |
| 2 | Gemini Omni Flash | 1.122 | 6,00 USD/Minute |
| 3 | HappyHorse-1.0 | 1.096 | 27,04 USD/Minute |
| 4 | Wan 2.7 | 1.080 | 16,90 USD/Minute |
| 5 | Dreamina Seedance 2.0 720p | 1.037 | 5,57 USD/Minute |
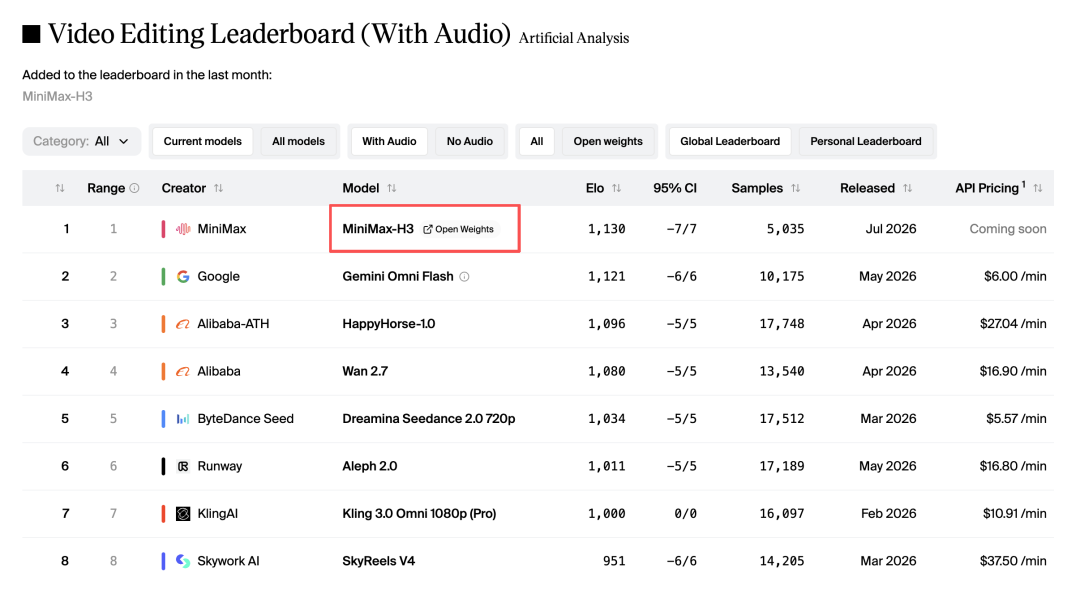
Der Quellartikel platziert H3 an der Spitze der Video-Editing-Rangliste von Artificial Analysis.
H3 schneidet auch in Tests zur Text-zu-Video- und Bild-zu-Video-Generierung hervorragend ab.
Die Ranglistenergebnisse ändern sich, wenn neue Modelle und Abstimmungen hinzukommen. Sie messen die Präferenzen einer Gruppe bei bestimmten Prompt-Sets und sollten nicht als Beleg dafür gewertet werden, dass ein Modell für alle Produktionsabläufe geeignet ist.
Dieses Ergebnis ist dennoch bemerkenswert, weil H3 eine starke Editing-Bewertung mit bereits veröffentlichten Basisgewichten kombiniert, während viele führende Videomodelle weiterhin geschlossen bleiben.
H3 behandelt Text, Bilder, Videos und Audio nicht als getrennte Eingabemodalitäten.
Es nimmt sie als einen einheitlichen multimodalen Kontext auf und versucht, die Beziehung zwischen diesen Materialien und der angeforderten Ausgabe zu verstehen.
Ein Prompt kann H3 beispielsweise auffordern:
Die offizielle API unterstützt derzeit:
| Referenztyp | Limit |
|---|---|
| Bilder | Bis zu 9 |
| Videoclips | Bis zu 3 |
| Audioclips | Bis zu 3 |
| Gesamtzahl gemischter Dateien | Bis zu 12 |
Referenzvideos und Audioclips müssen zwischen 2 und 15 Sekunden lang sein, wobei die maximale Gesamtdauer pro Medientyp 15 Sekunden beträgt.
Das Prompt-Limit liegt bei 7.000 Zeichen.
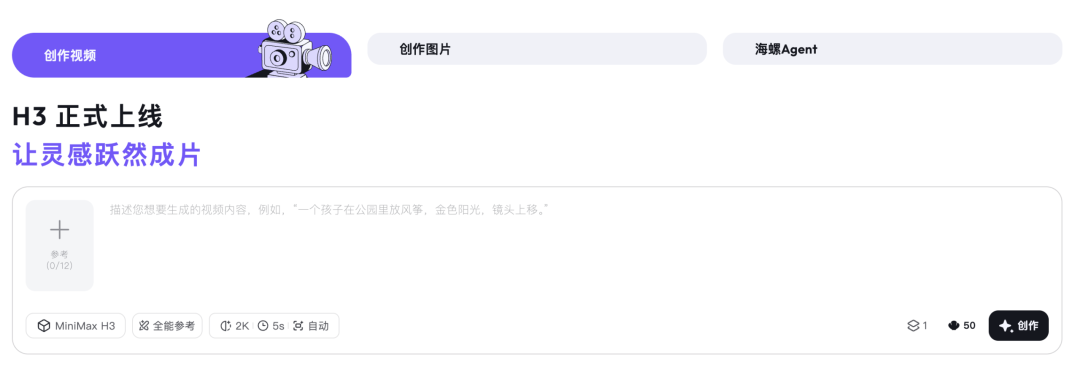
Die Conch-Oberfläche integriert Prompt, multimodale Referenzen, Auflösung, Dauer und Seitenverhältnis.
Dieses Design macht Referenzmaterialien wichtiger als das Schreiben extrem langer Prompts.
Ein Text kann den gewünschten Lichteffekt beschreiben, aber ein Referenzbild kann denselben visuellen Effekt direkter vermitteln. Eine Textbeschreibung kann eine Aktion erklären, aber ein Referenzvideo kann das präzise Timing zeigen.
Der Wert des Modells liegt darin, zu interpretieren, wie diese Referenzen neu kombiniert werden sollten, anstatt sie lediglich zu kopieren.
Der Quellartikel hebt eine kleine, aber praktische Produktfunktion hervor: Hochgeladene Materialien erscheinen im Bereich „Zuletzt verwendet“.
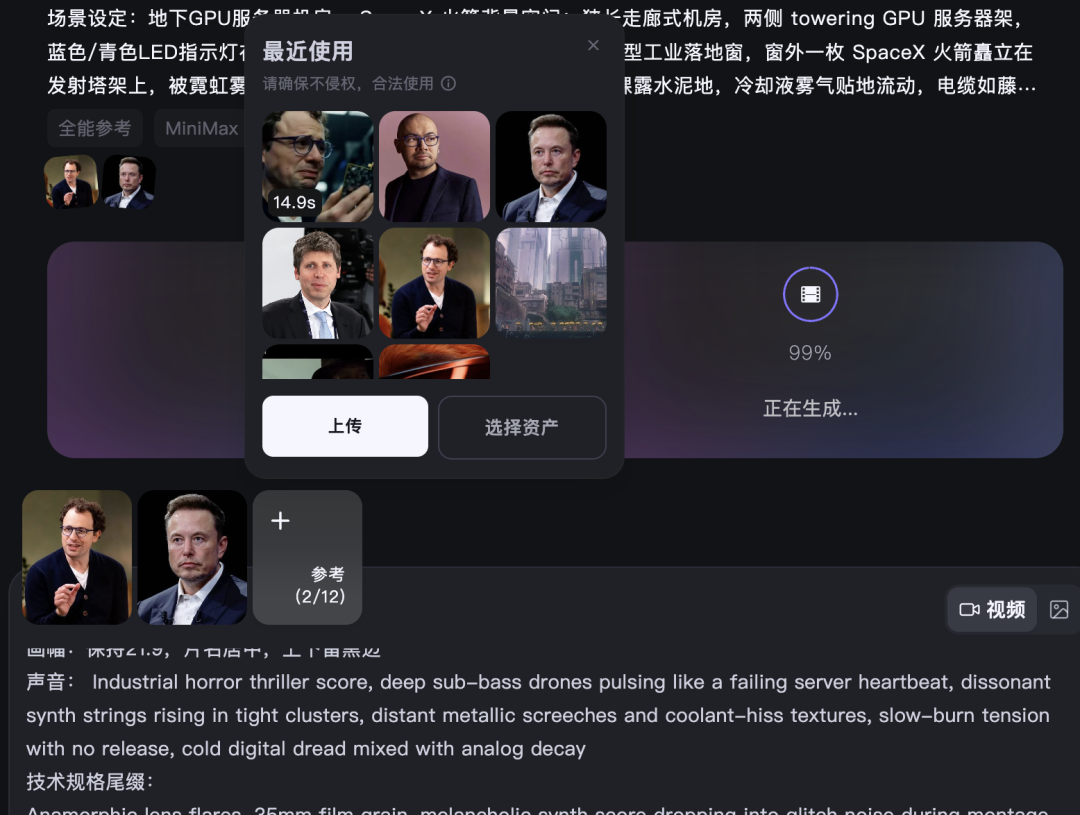
Zuvor hochgeladene Bilder und Referenzmaterialien können aus dem Panel „Zuletzt verwendet“ wiederverwendet werden.
Dies ist praktisch für Workflows, die wiederholt dieselben Charaktere, Produkte, Logos, Markenfarben, Stimmen, visuelle Stile, Orte oder Bewegungsreferenzen verwenden.
Es reduziert den Aufwand, bei jeder Generierung dieselben Dateien hochzuladen und zu organisieren.
MiniMax beschreibt H3 als ein System, das um Aufgabenverallgemeinerung herum aufgebaut ist, nicht als eine Sammlung unabhängiger Spezialmodelle.
Frühere Generierungssysteme teilten kreative Arbeit oft in isolierte Aufgaben auf, wie Text-zu-Video, Bild-zu-Video, Erstes/Letztes-Frame-Generierung, Charakterreferenz, Stilreferenz, Bewegungsübertragung, Audio-Referenz, Video-Editing, Soundeffekt-Generierung und Musikgenerierung.
H3 wurde trainiert, diese Beziehungen in einem einzigen multimodalen System über natürliche Sprache auszudrücken.
Der vollständige Online-Workflow von H3 umfasst drei Hauptmodule:
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Multimodale Eingabe
      ↓
H3-Context-IR
      ↓
H3-Base (768p)
      ↓
H3-Regenerate-2K
      ↓
Endvideo (mit Stereo-Audio)
H3-Context-IR ist ein gehostetes Vorverarbeitungs- und Orchestrierungssystem.
Es analysiert die Beziehungen zwischen Text, Bildern, Videos und Audio und erzeugt dann eine strukturierte Zwischenrepräsentation, die H3-Base verwenden kann.
Das System kann Anweisungsanalyse, Kreuzmodale Verknüpfung, Zeitanalyse, Szenenzerlegung, Audio-Video-Beziehungsmodellierung, Prompt-Vervollständigung für fehlende Details sowie komplexe logische Schlussfolgerungen durchführen.
Der technische Blog von MiniMax weist darauf hin, dass einige Quellmaterialien etwa 100.000 Token an Inferenzrechnung benötigen, bevor sie auf eine durchschnittliche Kontextrepräsentation von etwa 4.000 Token reduziert werden.
H3-Context-IR ist nicht in der ersten Open-Source-Gewichtsversion enthalten, da es von mehreren gehosteten Modellen und Diensten abhängt.
MiniMax stellt diese Funktion über eine API bereit und veröffentlicht Leitfäden für Teams, die eigene Vorverarbeitungssysteme aufbauen möchten.
H3-Base erzeugt Videos und Stereoton mit einer Auflösung von 768p.
Verschiedene Eingabemodalitäten werden über entsprechende Encoder oder VAEs kodiert, zu einer einheitlichen multimodalen Sequenz verpackt und dann dem H3-Omni-Transformer zugeführt.
Die veröffentlichten Modelle bieten zwei aufgabenspezifische Checkpoints:
| Checkpoint | Hauptaufgabe |
|---|---|
| H3-Base-FL2VA | Text-zu-Video sowie Erst- und Endbild-zu-Video |
| H3-Base-Ref2VA | Referenzbasierte Audio- und Videoerzeugung |
Beide Checkpoints verwenden BF16-Präzision.
Der 2K-Workflow von H3 ist kein herkömmliches Super-Resolution-Upscaling-Tool.
Die 768p-Ergebnisse und der ursprüngliche multimodale Kontext werden zurück an H3 geführt, sodass das Modell die Ausgabe mit höherer Auflösung neu erzeugen kann.
MiniMax bezeichnet dies als In-Context-Regenerierung (Context Regeneration).
Herkömmliche Super-Resolution-Systeme versuchen, fehlende Details aus niedrig aufgelösten Videos zu schließen. H3 kann die ursprünglichen Prompts und Referenzinformationen wiederverwenden, was dazu beitragen kann, kleine Texte, Produktdetails und Szeneninformationen genauer wiederherzustellen.
H3-Regenerate-2K ist nicht in der ersten Open-Weight-Version enthalten. Es ist derzeit über MiniMax' verwaltete Workflows und die API verfügbar.
MiniMax identifiziert vier Haupttechnologien hinter dem System.
Bei herkömmlichen Video-Prompts beschreibt eine Textanweisung das Zielmaterial.
Bei H3 hingegen
muss die Bildunterschrift auch beschreiben, wie sich jede Referenz auf die Ausgabe bezieht, wie die Referenzen zueinander stehen, welche Aktion aus welchem Video stammen soll, welcher Ton zu welcher Figur gehört, wie sich das Audio über mehrere Einstellungen hinweg verändert und welche Inhalte beibehalten oder bearbeitet werden sollen.
Sprache ist die Brücke, die diese multimodalen Beziehungen verbindet.
MiniMax hat spezielle Modelle und eine All-Modalitäts-Verständnispipeline entwickelt, um diese Repräsentation zu erzeugen.
H3 verwendet getrennte latente Räume für Video und Audio.
Der visuelle VAE ist ein zeitlich kausaler Video-Autoencoder mit 16-facher räumlicher Komprimierung, 4-facher zeitlicher Komprimierung, 24 latenten Kanälen und zusätzlicher Chunk-Verarbeitung vor dem Transformer.
MiniMax gibt an, dass der neue VAE im Vergleich zu früheren Methoden eine 4-fache Verbesserung der effektiven Sequenzlänge bietet, die Trainings- und Inferenzkosten senkt und die native 2K-Erzeugung unterstützt.
Der Audio-VAE verarbeitet zunächst die linken und rechten Stereokanäle unabhängig voneinander und setzt sie dann wieder zusammen. Er komprimiert 32-kHz-Audio auf 40 Hz latente Tokens pro Kanal.
Der H3-Omni-Transformer ist ein dichter Single-Stream-Transformer.
Die offizielle Modellkarte listet auf:
MiniMax erklärt, dass die AdaLN-Modulationsausgaben vorab berechnet und zwischengespeichert werden können. Daher müssen für reine Inferenz-Bereitstellungen diese Parameter nicht geladen werden.
Das Modell trennt während des Trainings Verständnis- und Erzeugungsaufgaben, um mit stark variierenden multimodalen Sequenzlängen besser umzugehen. MiniMax berichtet, dass dies den End-to-End-Trainingsdurchsatz um fast 30 % gesteigert hat.
H3 verwendet beim Training native sparsame Aufmerksamkeit, um die Kosten langer multimodaler Sequenzen zu senken.
Die erste Open-Weight-Version verwendet derzeit für die Inferenz vollständige Aufmerksamkeit. MiniMax gibt an, dass die Implementierung der sparsamen Aufmerksamkeit in einem zukünftigen Update veröffentlicht wird.
Dieser Unterschied ist für lokale Bereitstellungen wichtig, da die derzeit verfügbaren Implementierungen möglicherweise mehr Rechenressourcen benötigen als der intern optimierte Service-Stack von MiniMax.
MiniMax hat die H3-Base-Gewichte auf Hugging Face unter der MiniMax H3 Community License veröffentlicht.
Das Repository umfasst H3-Base-FL2VA, H3-Base-Ref2VA, Prozessor-/Tokenizer-Dateien, Text-Encoder, Omni-Transformer-Gewichte, visuelle und Audio-VAEs, Beispielskripte, Bereitstellungsanweisungen sowie reproduzierbare 768p-Beispiele.
Die Checkpoints verwenden die vollständigen vortrainierten Gewichte von Qwen3-VL-32B als H3-Encoder und stellen dessen verborgene Schicht an Schicht 50 dem H3-Omni-Transformer bereit.
Das Modell kann mit folgendem Befehl heruntergeladen werden:
hf download MiniMaxAI/MiniMax-H3 --local-dir MiniMax-H3
MiniMax listet SGLang, vLLM, Diffusers und ComfyUI als unterstützte oder empfohlene Inferenz-Frameworks.
Das SGLang-Beispiel verwendet vier GPUs:
sglang serve \
  --model-path MiniMaxAI/MiniMax-H3 \
  --num-gpus 4 \
  --ulysses-degree 4 \
  --performance-mode speed \

--host 0.0.0.0 \
  --port 30010 \
  --model-variant fl2va
Dies ist ein offizielles Beispiel und keine allgemeine Mindestanforderung. Tatsächlicher Speicher und Leistung hängen von Checkpoint, Dauer, Auflösung, Implementierung und Hardware ab.
H3 einfach als „vollständig Open Source" zu bezeichnen, könnte irreführend sein.
Die veröffentlichten H3-Base-Gewichte sind beträchtlich und unterstützen lokale 768p-Erzeugung. Jedoch:
Teams sollten vor der Planung kommerzieller Bereitstellungen die Lizenz- und Architekturhinweise sorgfältig prüfen.
Für Private-Label-Assets schafft die Veröffentlichung dennoch sinnvolle Optionen. Unternehmen können die Basismodelle innerhalb der Lizenzbedingungen erforschen, feinabstimmen und bereitstellen, ohne jedes Quell-Asset an eine Drittanbieter-Generierungsschnittstelle senden zu müssen.
Die offizielle API unterstützt drei Hauptgenerierungsmodi:
Der Generierungs-Workflow ist asynchron:
task_id empfangen.Entwickler können auch die offizielle MiniMax-CLI verwenden:
npm install -g mmx-cli
mmx auth login
mmx video generate \
  --model MiniMax-H3 \
  --prompt "A polished product commercial with animated typography"
Für multimodale Referenz-Workflows:
mmx video generate \
  --model MiniMax-H3 \
  --prompt "Keep the same character and follow the reference motion" \
  --reference-image character.png \
  --reference-video motion.mp4
Vor der Nutzung in Produktionsumgebungen sollten die CLI- und API-Dokumentationen konsultiert werden, da Eingabebeschränkungen, Abrechnung und unterstützte Parameter sich ändern können.
H3 beseitigt nicht alle Postproduktionsaufgaben.
Ein professionelles Marketingprojekt benötigt möglicherweise weiterhin frame-genaue Bearbeitung, Kundenabnahmen, lizenzierte Musik, rechtliche und urheberrechtliche Prüfungen, präzise Markenkonformität, Langfilme-Kontinuität, Exporte in mehreren Seitenverhältnissen, Regie für Realschauspieler sowie Farbmanagement bei der Lieferung.
H3 verändert den Ausgangspunkt.
Statt eines stummen Materials erhalten Kreative ein kurzes Asset mit Schnitt, Ton, Typografie, Voice-over, Effekten und erkennbarer visueller Richtung.
Dadurch eignet sich das Modell besonders für:
Konzeptvideo
Das Modell zeigt auch, dass Videogenerierung zunehmend weniger auf bestimmte Aufgaben beschränkt ist. Ein einzelnes System kann zunehmend eine Reihe kreativer Assets interpretieren und ein vollständigeres kreatives Briefing ausführen.
MiniMax H3 ist ein universelles multimodales System zur Videogenerierung und -bearbeitung. Es akzeptiert Text-, Bild-, Video- und Audioeingaben und kann Videos von 4 bis 15 Sekunden Dauer mit synchronisiertem Stereo-Ton erzeugen.
Ton.
Ja. Die gehostete API unterstützt 2K-Ausgabe. Der vollständige Ablauf generiert zunächst ein 768p-Ergebnis mit H3-Base und regeneriert das Video anschließend mit H3-Regenerate-2K in höherer Auflösung unter Beibehaltung des ursprünglichen Kontexts.
MiniMax hat die H3-Base-Gewichte unter seiner Community-Lizenz veröffentlicht. Das vollständige Online-System ist nicht vollständig Open Source, da H3-Context-IR, H3-Regenerate-2K und die Inferenz mit Sparse Attention nicht vollständig in der Erstveröffentlichung enthalten sind.
Ja, die veröffentlichten H3-Base-Checkpoints können lokal für die 768p-Generierung bereitgestellt werden. MiniMax bietet ein SGLang-Beispiel sowie Links zu vLLM-, Diffusers- und ComfyUI-Workflows an, allerdings benötigt das Modell erhebliche GPU-Ressourcen.
Die aktuelle globale Preisliste beträgt 0,13 US-Dollar pro Sekunde Generierung bei 2K-Auflösung und 0,08 US-Dollar pro Sekunde bei 768p-Auflösung. Referenzbilder über die ersten fünf hinaus, Referenzvideos, Regenerierung und H3-Context-IR können zusätzliche Kosten verursachen.
Ja. H3 generiert gemeinsam Video und natives 32-kHz-Stereoton, einschließlich Dialog, Musik und Soundeffekten.
Die API unterstützt bis zu neun Bilder, drei Videos und drei Audioclips, insgesamt bis zu 12 gemischte Dateien. Zudem gelten Einschränkungen bei Dauer und Dateigröße.
MiniMax hat H3 für Werbung, Markenkampagnen, E-Commerce, Produktdesign, UI und UX sowie andere kommerzielle Zwecke entwickelt. Teams sollten dennoch die Ausgabe prüfen, die Rechte an allen Eingabematerialien verifizieren und die Community-Lizenz sowie die Plattformbedingungen einsehen.
Preise: Aktuelle Preise für H3-Generierung, Referenzeingaben, Regenerierung und Context-IR.
MiniMax H3 hebt KI-Video von der reinen Segmentgenerierung auf eine höhere Ebene, indem es visuelle Generierung, Schnittlogik, Untertitel-Typografie, Dialog, Soundeffekte, Musik und multimodale Referenzen in einem System integriert.
Die gehostete Version kann Videos von 4 bis 15 Sekunden mit nativem Stereo-Ton und einer Ausgabeauflösung von bis zu 2K erzeugen. Derzeit steht sie an der Spitze des Artificial-Analysis-Videobearbeitungs-Rankings und bietet 2K-Ausgabe über die globale MiniMax-API für 0,13 US-Dollar pro generierter Sekunde.
MiniMax hat die H3-Base-Checkpoints veröffentlicht, die lokale 768p-Generierung und Weiterentwicklung unterstützen. Da Context-IR, 2K-Regenerierung und Sparse-Attention-Inferenz jedoch noch nicht vollständig Open Source sind, bleibt der vollständige gehostete Workflow teilweise geschlossen.
Der zentrale Wandel von H3 besteht nicht nur darin, bessere Bilder zu erzeugen, sondern sich von der Generierung eines einzelnen Segments hin zum Verstehen und Ausführen eines vollständigen Kurzvideo-Kreativbriefings zu entwickeln.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



