For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/minimax-m3-1-flash-api-pricing-benchmarks-c8e3fe1c.md.
MiniMax hat M3.1 Flash mit niedrigeren Token-Preisen sowie besseren gemeldeten Ergebnissen bei Reasoning- und Agentenaufgaben veröffentlicht...
MiniMax hat M3.1 Flash mit niedrigeren Token-Preisen sowie besseren gemeldeten Ergebnissen bei Reasoning- und Agentenaufgaben veröffentlicht. In der Berichterstattung von THE DECODER vom 19. Oktober erreicht das Modell 42 Punkte im Artificial Analysis Intelligence Index, verglichen mit 29 Punkten für M3.
Die entscheidende Unterscheidung besteht zwischen dem Preis eines Tokens und den Kosten für die Erledigung einer Aufgabe. Ein Modell kann bei beiden Kennzahlen günstiger sein. Die Aufgabenkosten hängen jedoch auch davon ab, wie viel das Modell generiert, wie oft es einen Versuch wiederholen muss und ob das Ergebnis tatsächlich verwendbar ist.
Der Vergleich zum Startzeitpunkt ordnet M3.1 Flash im Bericht gemeinsam mit GLM-5.3-Flash im zusammengesetzten Index ein, knapp vor Gemini 3.8 Flash und hinter DeepSeek V4.1 Flash 1017.
| Gemeldete Bewertung | M3.1 Flash | Im Bericht hervorgehobener Vergleich |
|---|---|---|
| Artificial Analysis Intelligence Index | 42 | M3: 29; GLM-5.3-Flash: 42; Gemini 3.8 Flash: 41; DeepSeek: 45. |
| Humanity's Last Exam | 48 % | DeepSeek: 43 %. |
| CritPt | 22 % | GLM: 15 %; Gemini: 18 %; DeepSeek: 24 %. |
| AA-Omniscience-Genauigkeit | 56 % | GLM: 28 %; DeepSeek: 43 %. |
| Durchschnittliche Bewertungskosten pro Aufgabe | Etwa 0,22 USD | DeepSeek: etwa 0,26 USD. |
Dies sind die zum Zeitpunkt der Veröffentlichung gemeldeten Werte. Benchmark-Konfigurationen, Snapshots und Modellversionen sind relevant; die Tabelle stellt kein universelles Ranking für jede Arbeitslast dar.

Diagrammquelle: Artificial Analysis, reproduziert von THE DECODER.
Der Bericht führt die niedrigeren Aufgabenkosten teilweise auf den geringeren Verbrauch von Ausgabe-Tokens zurück. Der Vergleich von ungefähr 189 Millionen gegenüber 224 Millionen Ausgabe-Tokens bezieht sich auf die Gesamtwerte der Benchmarks und nicht auf die von einer einzelnen gewöhnlichen Anfrage erzeugte Menge.
MiniMax behauptet separat eine fast dreimal höhere Online-Inferenzgeschwindigkeit sowie eine Reduzierung der Gesamtkosten für Agentenaufgaben um 70 % gegenüber dem Vorgängermodell. Diese Messungen des Unternehmens sind nicht identisch mit dem Kostenvergleich von Artificial Analysis. Sie sollten nicht zu einem einzigen, unabhängig verifizierten Effizienzergebnis zusammengeführt werden.
Der Bericht nennt außerdem eine Halluzinationsrate von 93 % bei AA-Omniscience. Das bedeutet nicht, dass 93 % aller Antworten falsch waren. Ebenso lässt sich daraus nicht die Fehlerquote eines eingesetzten Assistenten bei beliebigen Aufgaben ableiten.
Artificial Analysis definiert diese Rate anhand von nicht korrekten Antworten: Falsche Antworten werden durch die Summe aus falschen, teilweise richtigen und nicht beantworteten Antworten geteilt. Die Kennzahl misst die Tendenz, eine falsche Antwort zu geben, obwohl das Eingeständnis von Unsicherheit besser wäre. Die Genauigkeit zählt dagegen korrekte Antworten über alle Fragen hinweg.
Diese Unterscheidung bedeutet, dass ein Modell gleichzeitig eine vergleichsweise hohe faktische Genauigkeit und einen schlechten Umgang mit Unsicherheit aufweisen kann. Bei wissenssensiblen Aufgaben sollten daher sowohl die Belege als auch die Fähigkeit des Modells, sich zu enthalten, geprüft werden, statt sich allein auf einen zusammengesetzten Wert zu verlassen.
THE DECODER berichtet von einem Kontextfenster mit bis zu einer Million Tokens sowie der Unterstützung von Text- und Bildeingaben. Die Unterstützung von Bildeingaben darf nicht mit der Bilderzeugung verwechselt werden: Dass ein Modell ein Bild akzeptiert, bedeutet nicht, dass es auch eines erzeugen kann.
Die offizielle Startankündigung von MiniMax bestätigt einheitliche Preise pro Million Tokens:
| Token-Kategorie | Preis pro einer Million Tokens |
|---|---|
| Eingabe | 0,15 USD |
| Ausgabe | 0,60 USD |
| Gecachte Eingabe | 0,015 USD |
Der Preis für gecachte Eingaben gilt für zulässige Cache-Treffer und nicht für jedes Eingabe-Token. Eine Million nicht gecachter Eingabe-Tokens plus eine Million Ausgabe-Tokens würden bei den aufgeführten Preisen beispielsweise 0,75 USD kosten, bevor weitere anwendbare Gebühren berücksichtigt werden. Dies ist eine Veranschaulichung der Token-Kosten und keine typische Schätzung für eine Aufgabe.
Die API, der M Plan und MiniMax Code werden in der offiziellen Ankündigung als Zugriffswege genannt. THE DECODER nennt den 23. Oktober als geplantes Datum für die Veröffentlichung der Open Weights. Der geprüfte Unternehmensbeitrag sagt dagegen lediglich, dass die Gewichte später veröffentlicht werden sollen, ohne dieses Datum zu nennen. Zum Zeitpunkt der Erstellung dieses Artikels am 20. Oktober sollte eine zukünftige Veröffentlichung nicht als bereits zum Download verfügbare Gewichte beschrieben werden.
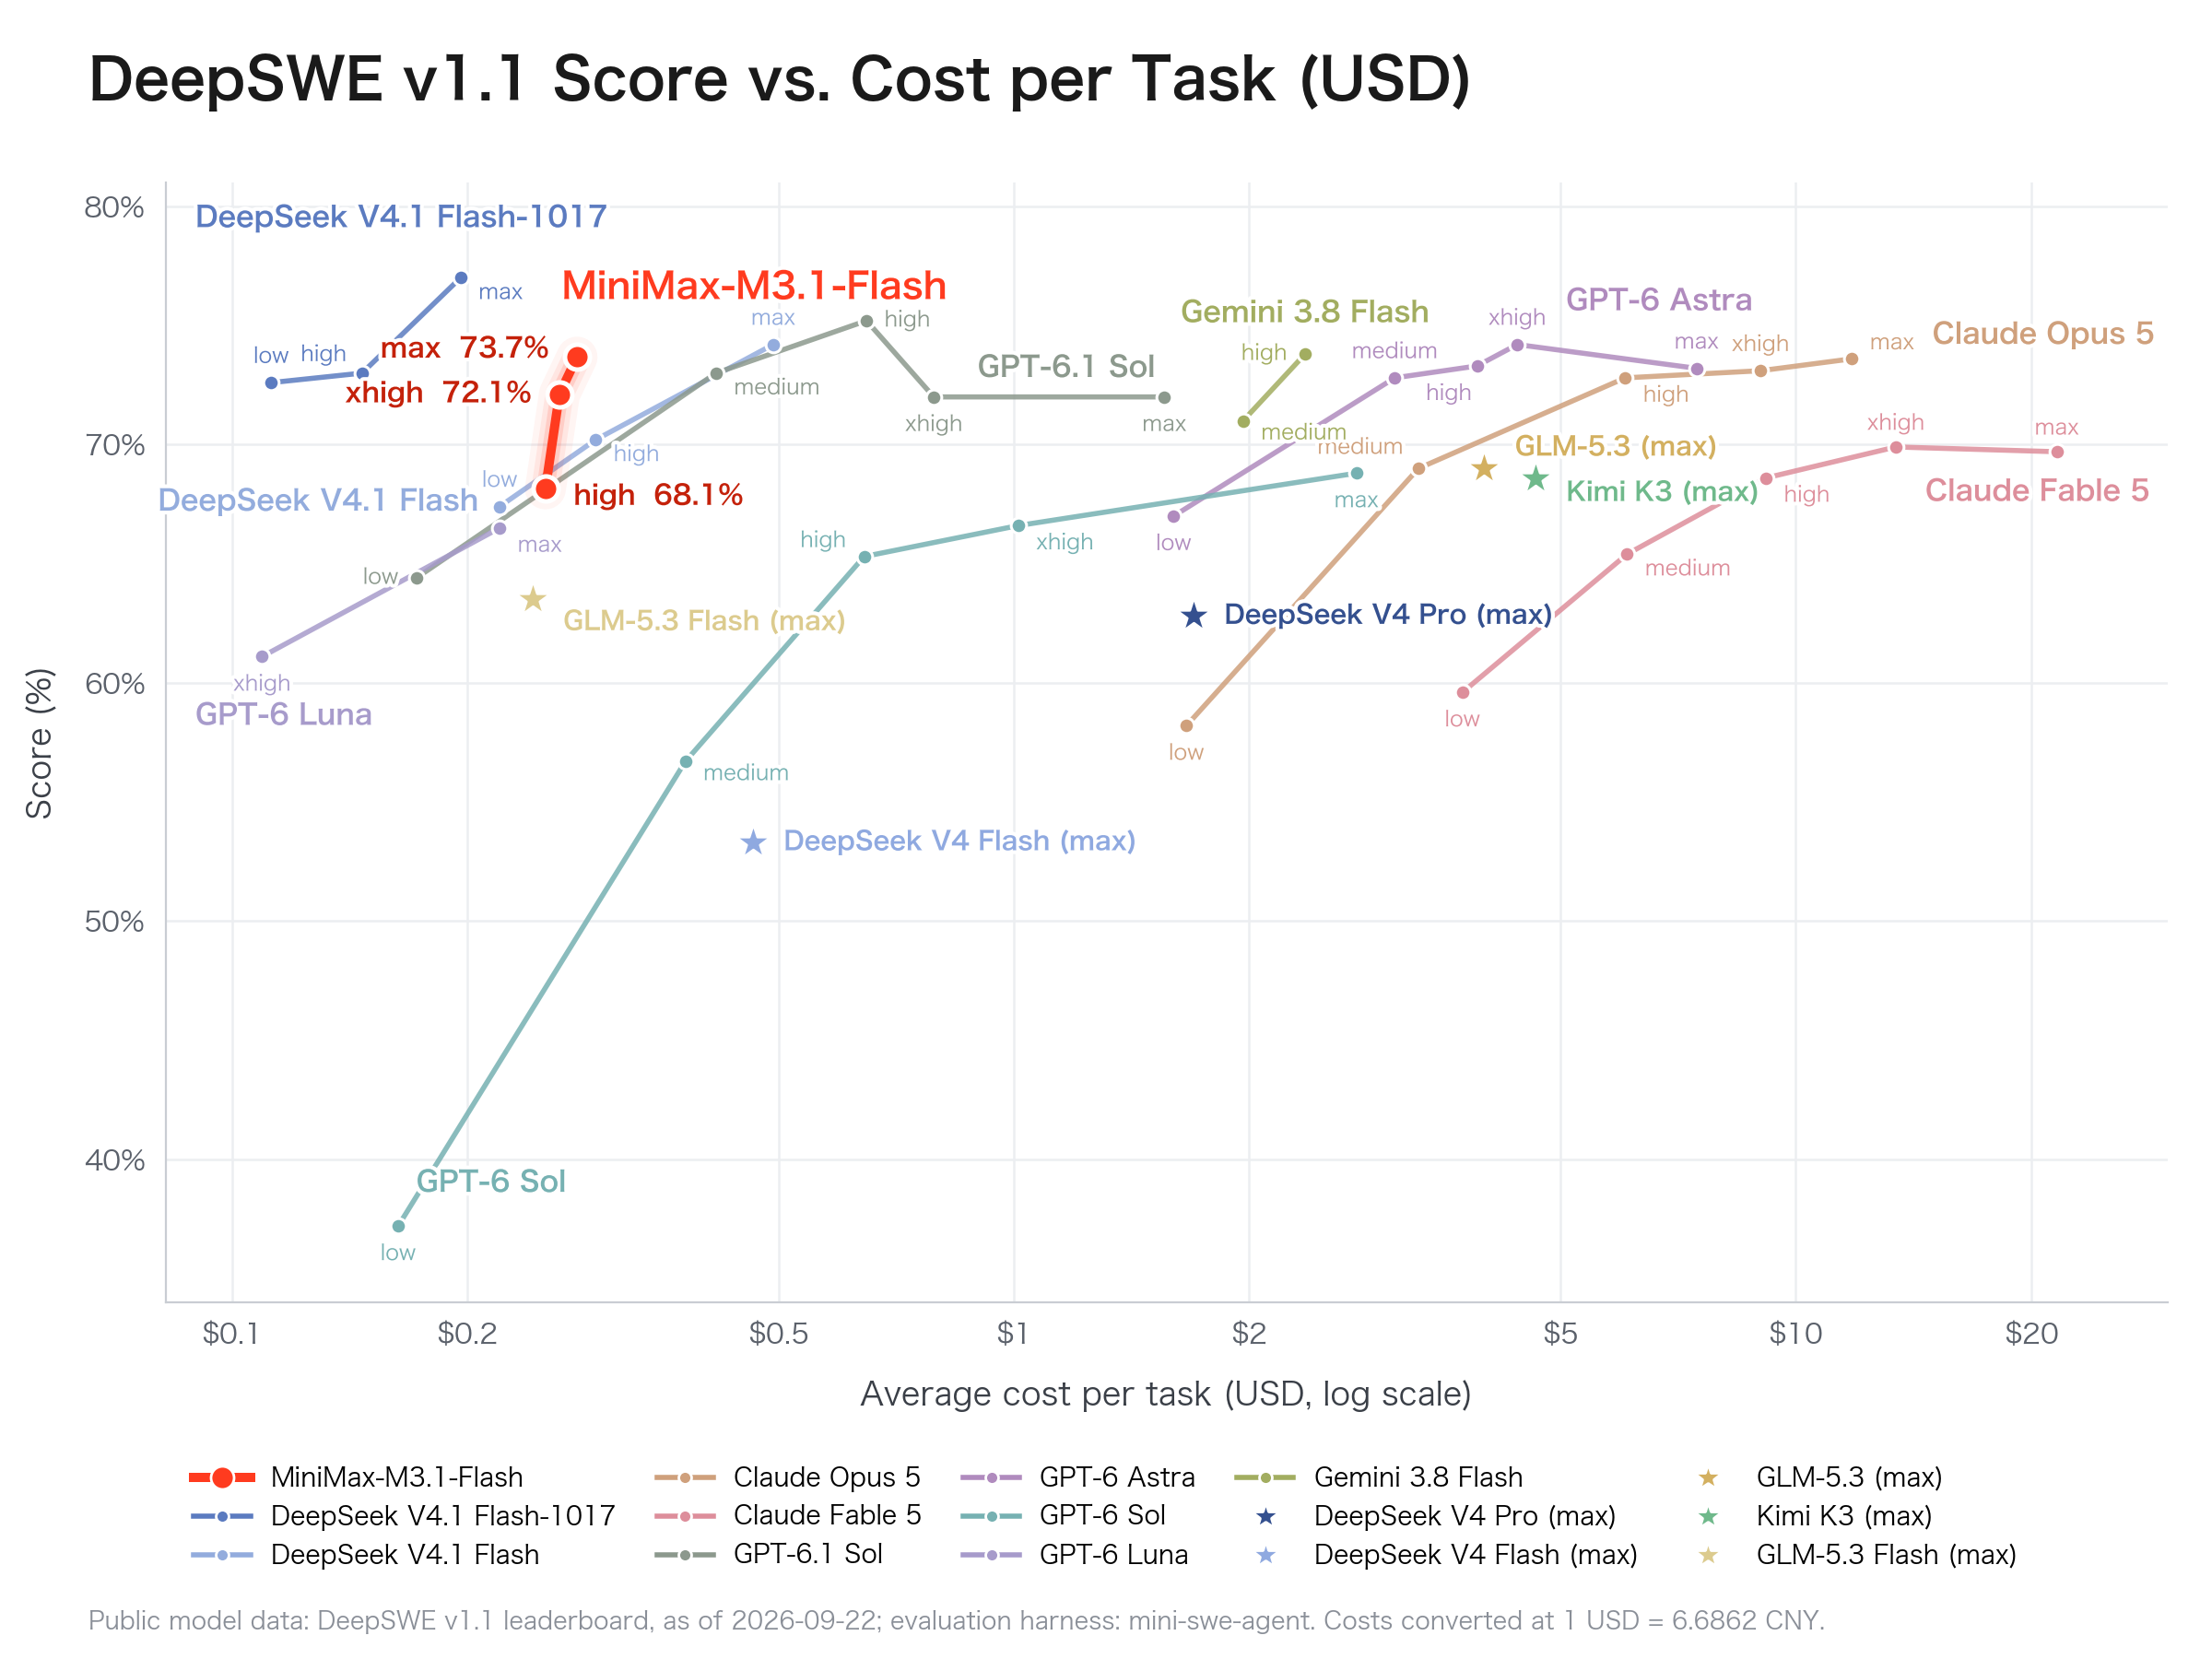
MiniMax berichtet in seinem Diagramm bis zu 73,7 % bei DeepSWE v1.1 und Aufgabenkosten von unter 0,30 USD. Die in derselben Abbildung gezeigten Einstellungen mit geringerem Aufwand tauschen einen Teil des Ergebnisses gegen niedrigere Kosten ein.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Vom Unternehmen veröffentlichtes Diagramm; die Abbildung nennt mini-swe-agent als Evaluierungs-Harness und gibt das Datum der Vergleichsdaten an.
Ein Coding-Score spiegelt das Zusammenspiel von Modell, Tools, Aufwandsstufe und Testumgebung wider. Er bedeutet nicht, dass 73,7 % der Tickets eines Unternehmens ohne Prüfung gelöst werden oder dass jede Aufgabe den dargestellten Durchschnittswert kostet.
Der abschließende Vergleich der Quelle hat keinen eindeutigen Sieger. DeepSeek führt beim zusammengesetzten Index und beim genannten Physik-Score, während MiniMax beim gemeldeten Ergebnis von Humanity's Last Exam und bei der AA-Omniscience-Genauigkeit vorne liegt.
Die niedrigeren durchschnittlichen Aufgabenkosten von MiniMax in diesem Snapshot sind ein nützlicher Beleg für eine Evaluierung, aber kein Grund für die Annahme, dass das Modell bei jeder Eingabe am günstigsten sein wird. Eine Arbeitslast mit längeren Ausgaben, fehlgeschlagenen Tool-Aufrufen oder mehr Wiederholungen kann die Rangfolge verändern.
Der Bericht unterscheidet außerdem den Veröffentlichungsstatus: Er verlinkt auf ein bereits vorhandenes Repository mit DeepSeek-Gewichten, beschreibt die MiniMax-Gewichte jedoch als bevorstehend. Open Weights, ein API-Abonnement und eine Desktop-Coding-App sind unterschiedliche Vertriebswege mit jeweils eigenen betrieblichen Anforderungen.
MiniMax M3.1 Flash ist das neue Flash-Modell von MiniMax, das über die gehosteten Produkte und die API des Unternehmens verfügbar ist. Der Start hebt Reasoning, Agentenaufgaben, Codierung und Inferenz-Effizienz hervor.
Die offizielle Ankündigung nennt 0,15 USD für Eingaben, 0,60 USD für Ausgaben und 0,015 USD für gecachte Eingaben pro einer Million Tokens. Vor der Schätzung einer Produktionsrechnung sollten die aktuellen Kontopreise und Cache-Regeln geprüft werden.
Nein. Dabei handelt es sich um einen gemeldeten Benchmark-Durchschnitt. Die tatsächlichen Kosten hängen von der Größe des Prompts, der erzeugten Ausgabe, dem Cache-Verhalten, Tool-Schleifen und Wiederholungen ab.
Nein. Der Nenner der Kennzahl enthält nicht korrekte Antworten und nicht alle Antworten. Sie betrifft in dieser Evaluierung falsche Vermutungen im Vergleich zu teilweise richtigen Antworten oder dem Verzicht auf eine Antwort.
Die geprüften Quellen beschreiben sie als bevorstehend. THE DECODER nennt den 23. Oktober, während die Ankündigung von MiniMax kein genaues Datum nennt. Nach der Veröffentlichung sollten das tatsächliche Repository und die Lizenz geprüft werden.
Die gemeldeten Ergebnisse fallen je nach Benchmark unterschiedlich aus. Die Auswahl sollte auf den konkreten Aufgaben, den Anforderungen an die Zuverlässigkeit und den in der eigenen Evaluierung gemessenen Gesamtkosten basieren.
M3.1 Flash verbindet niedrige ausgewiesene Token-Preise mit wettbewerbsfähigen gemeldeten Ergebnissen bei Reasoning und Codierung. Der Kostenvorteil ist besonders aussagekräftig, wenn die Kosten pro erfolgreich erledigter Aufgabe unter vergleichbaren Einstellungen gemessen werden.
Lesen Sie die Definitionen der Benchmarks, trennen Sie Unternehmensangaben von externen Messungen und prüfen Sie die tatsächliche Verfügbarkeit der Gewichte, bevor Sie einen Einsatz planen.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



