
MiniMax veröffentlichte M3.1 Flash am 19. Oktober, kurz nach DeepSeek V4.1 Flash-1017. Der vorliegende Artikel vergleicht beide Modelle anhand von Diagrammen, die Punktzahl und Kosten für Coding- und Agentenaufgaben gegenüberstellen. Dabei nähern sich vergleichsweise günstige Modelle bei ausgewählten Evaluierungen teureren Systemen an.
Die Formulierung „zuerst DeepSeek, danach MiniMax“ bezieht sich auf einen bestimmten Vergleich von Coding-Kosten und -Leistung. Sie sollte nicht als Rangfolge über alle Aufgaben, Modellversionen oder Bereitstellungseinstellungen verstanden werden. Die wichtigere Frage lautet, welche Konfiguration die Arbeit zuverlässig zu akzeptablen Gesamtkosten erledigt.
Coding-Ergebnisse und Agenten-Workflows in Unternehmen
Die Launch-Materialien von MiniMax nennen 73,7 % bei DeepSWE v1.1. Diese Evaluierung umfasst das Verständnis von Repositories, Entwicklung, Fehlerbehebungen und Tests. Die Tabelle der Quelle weist DeepSeek V4.1 Flash-1017 in diesem Vergleich mit 77,0, GPT-5.6 Sol mit 73,0 und Opus 5 mit 74,0 aus.
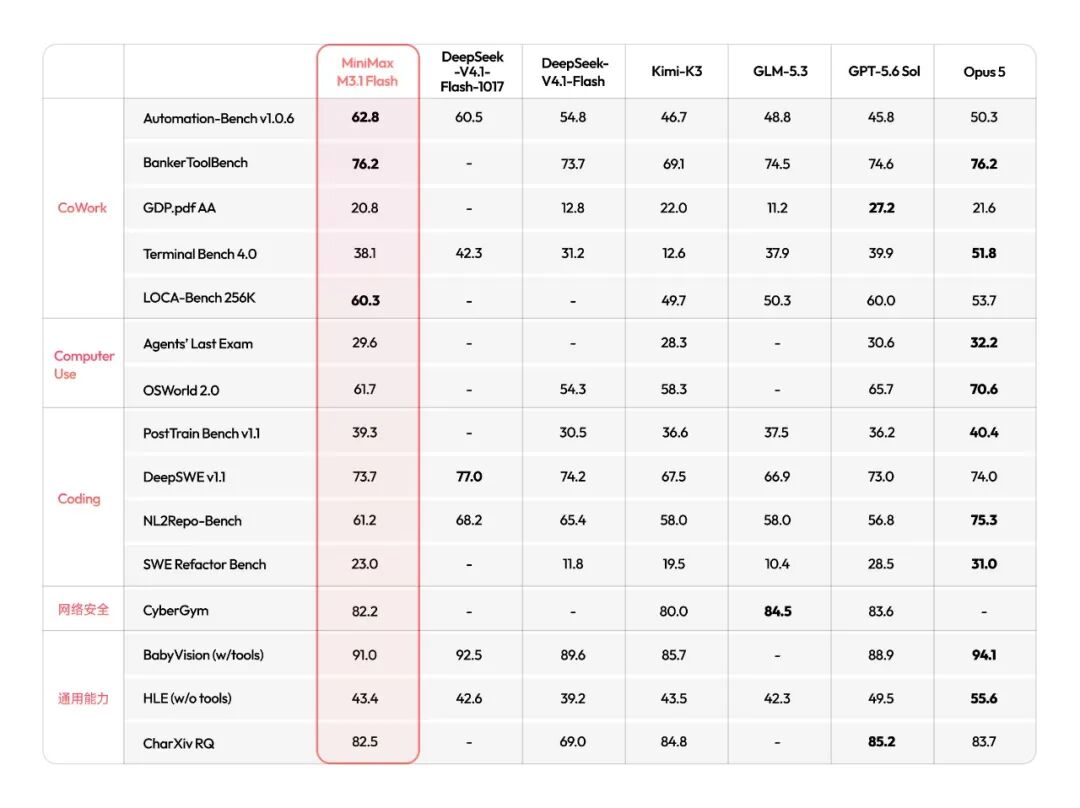
Unternehmensvergleich, reproduziert von Xinzhiyuan; Modellversionen und Evaluierungsbedingungen sind relevant.
Das Kostendiagramm zeigt M3.1 Flash bei seiner angegebenen Punktzahl nahe am unteren Kostenbereich, während DeepSeek Flash-1017 in diesem dargestellten Vergleich vorne liegt. Unterschiedliche Stufen des Denkaufwands erscheinen als separate Punkte. Daher kann die Auswahl einer Konfiguration sowohl die Kosten als auch das Ergebnis verändern.
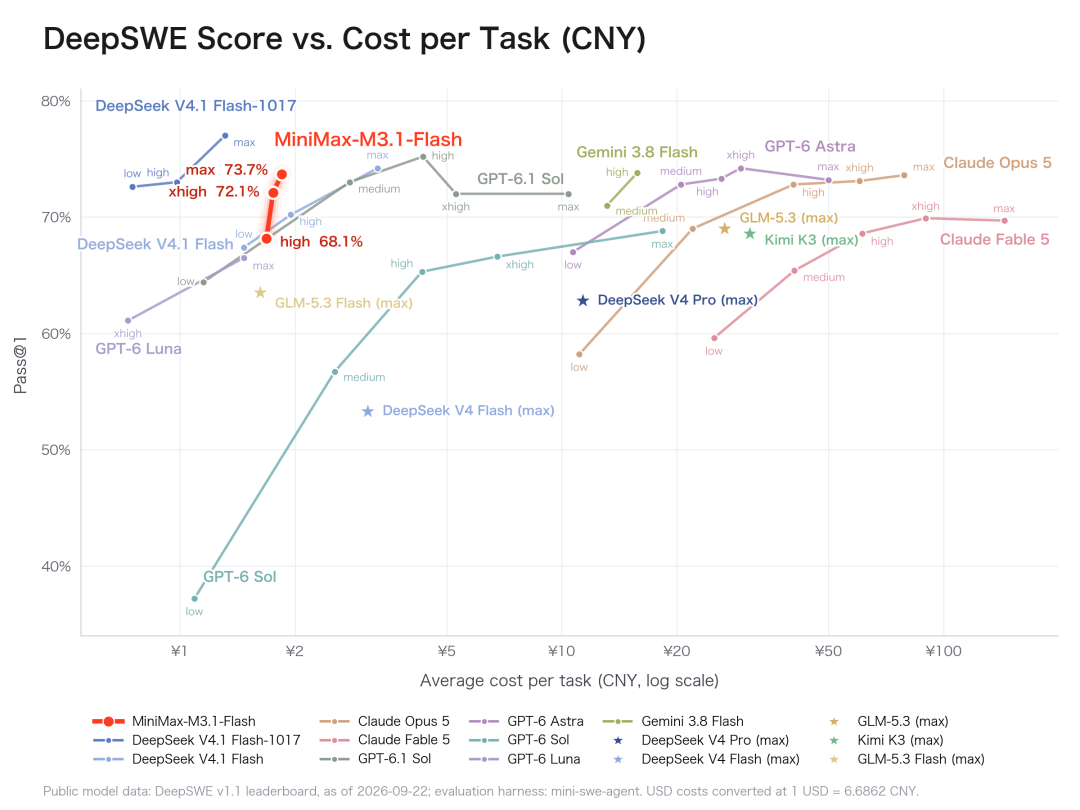
Ein Durchschnittswert von unter 2 CNY in dieser Evaluierung ist keine pauschale Gebühr für jede Fehlerbehebung. Tokenverbrauch, fehlgeschlagene Versuche, die Größe des Repositories und die Tool-Nutzung können die tatsächlichen Kosten einer Aufgabe verändern.
Automatisierung und Tool-Nutzung
Für Automation-Bench weist das bereitgestellte Diagramm bei maximalem Denkaufwand 62,8 % aus. M3.1 Flash liegt darin über den anderen dargestellten Konfigurationen, einschließlich eines MiniMax-Punkts mit geringerem Denkaufwand, der einen Teil der Punktzahl gegen niedrigere Kosten eintauscht.
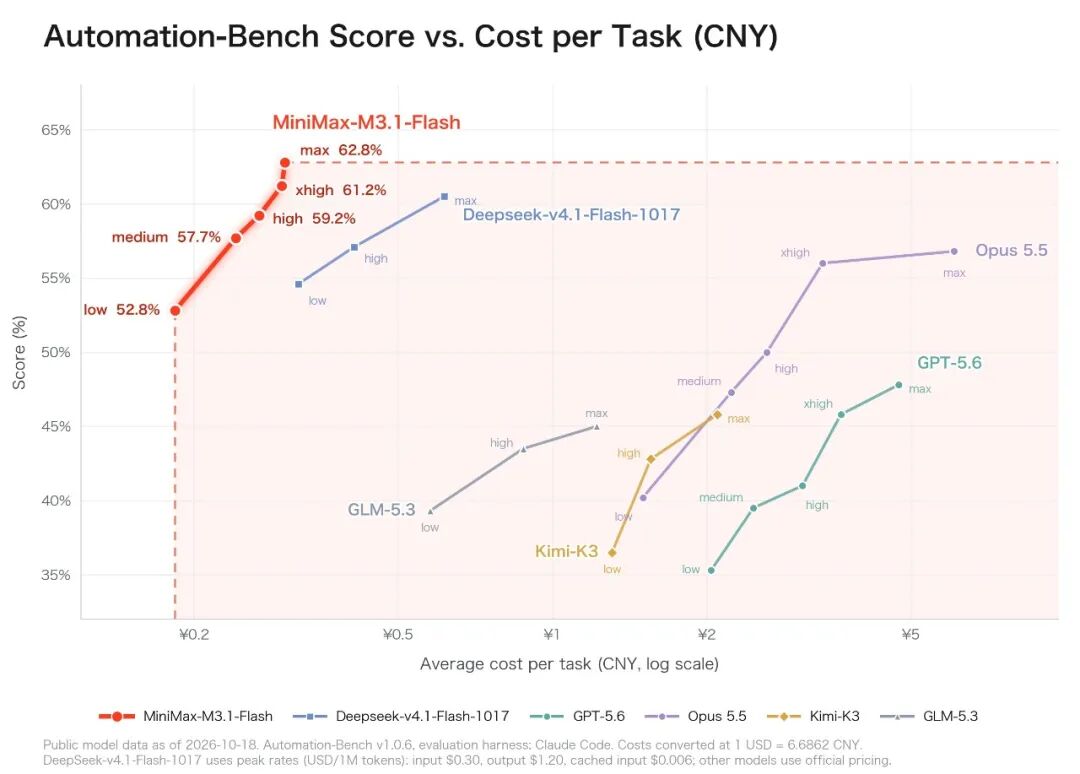
Die Quelle beschreibt Unternehmens-Workflows, die sich über SaaS-Tools und verschiedene Geschäftsbereiche erstrecken. Ein Benchmark bildet Teile dieser Arbeit ab. Er belegt jedoch nicht, dass ein Modell jeden laufenden Vertriebs-, Finanz- oder Kundensupport-Prozess erfolgreich bewältigt.
Weitere gemeldete Punktzahlen von MiniMax umfassen:
| Evaluierung | M3.1-Flash-Wert in der Quelle | Vergleichsgrenze |
|---|---|---|
| LOCA-Bench 256K | 60,3. | Knapp über dem in der Darstellung gezeigten Wert von 60,0 für GPT-5.6 Sol. |
| BankerToolBench | 76,2. | Gleichauf mit dem Wert für Opus 5 in dieser Tabelle. |
| CyberGym | 82,2. | Unter den dargestellten Werten von GLM-5.3 und GPT-5.6 Sol, in dieser Momentaufnahme jedoch weiterhin wettbewerbsfähig. |
| OSWorld 2.0 | 61,7. | Über dem dargestellten Wert von 54,3 für DeepSeek V4.1 Flash; nicht die höchste Punktzahl aller aufgeführten Modelle. |
| Agents' Last Exam | 29,6. | Unter 30,6 für GPT-5.6 Sol und 32,2 für Opus 5. |
Dies sind separate Tests und keine Werte, die ohne eine ausdrücklich beschriebene Methodik zu einer aussagekräftigen universellen Erfolgsquote gemittelt werden können.
Computer-Nutzung und die ALE-Schätzung von 739 CNY
Die offizielle Ankündigung von MiniMax bestätigt gemeldete Werte von 61,7 bei OSWorld V2 und 29,6 bei Agents' Last Exam. Die Behauptung, bei diesen Tests führend unter chinesischen Modellen zu sein, ist durch den für den Launch verwendeten Vergleich und die Testbedingungen begrenzt.
Das ALE-Diagramm der Quelle schätzt 739 CNY für die Ausführung des vollständigen Sets mit 152 Aufgaben bei einer Bestehensquote von 29,6 %. Es besagt nicht, dass jede Aufgabe bestanden wurde oder dass die Kosten pro erfolgreicher Aufgabe anfallen.
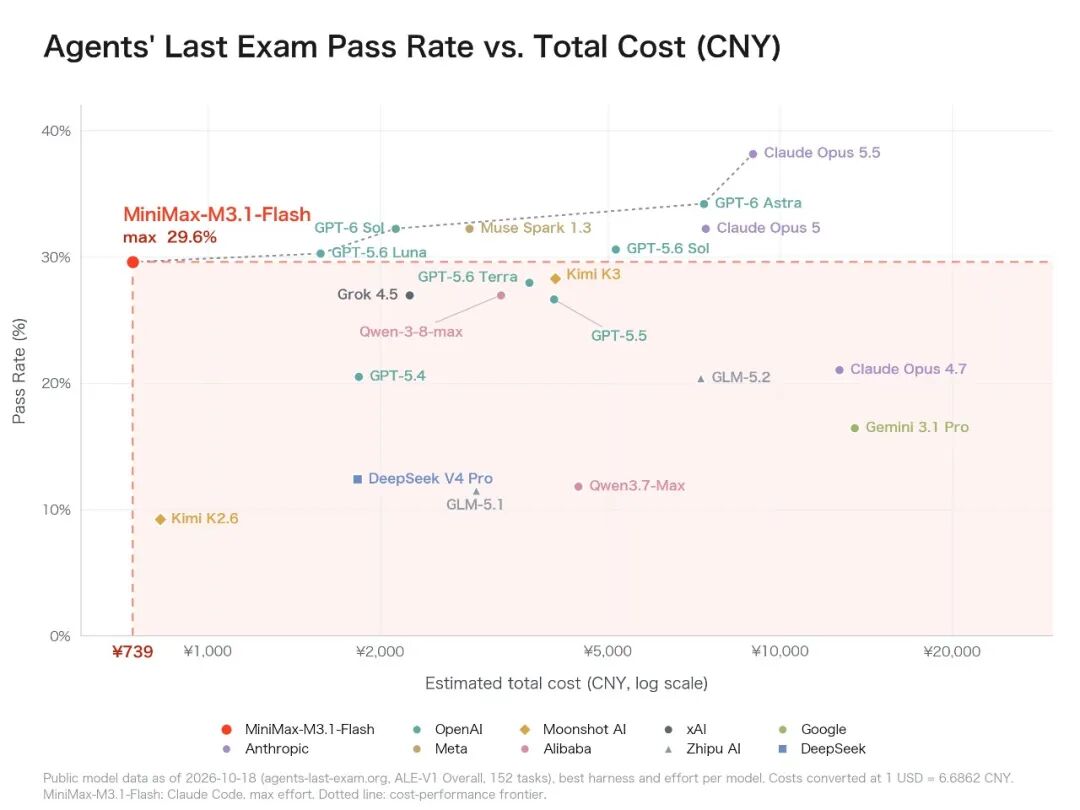
Die Division von 739 CNY durch 152 ergibt ungefähr 4,86 CNY pro bearbeiteter Aufgabe. Diese Rechnung erklärt die Größenordnung des Diagramms. Kosten für Integration, Infrastruktur oder menschliche Prüfung in einem Unternehmen sind darin nicht enthalten.
Die gestrichelte Effizienzgrenze verbindet ausgewählte Konfigurationen mit günstigen Ergebnissen im Verhältnis zu ihren dargestellten Kosten. Ihre Form hängt von den einbezogenen Modellen, dem Evaluierungszeitpunkt und den Kostenannahmen ab. Ein Punkt auf dieser Grenze ist nützlicher Vergleichsbeleg, aber kein Beweis dafür, dass dieselbe Konfiguration für alle Workloads am günstigsten ist.
Tokenpreise und Cache-Berechnungen
Die offizielle englische Ankündigung von MiniMax nennt Pauschalpreise pro einer Million Token von 0,15 $ für Eingaben, 0,60 $ für Ausgaben und 0,015 $ für zwischengespeicherte Eingaben. Der bereitgestellte chinesische Artikel stellt einen CNY-Tarif von 1 CNY für Eingaben, 4 CNY für Ausgaben und 0,10 CNY für Cache-Lesevorgänge dar.
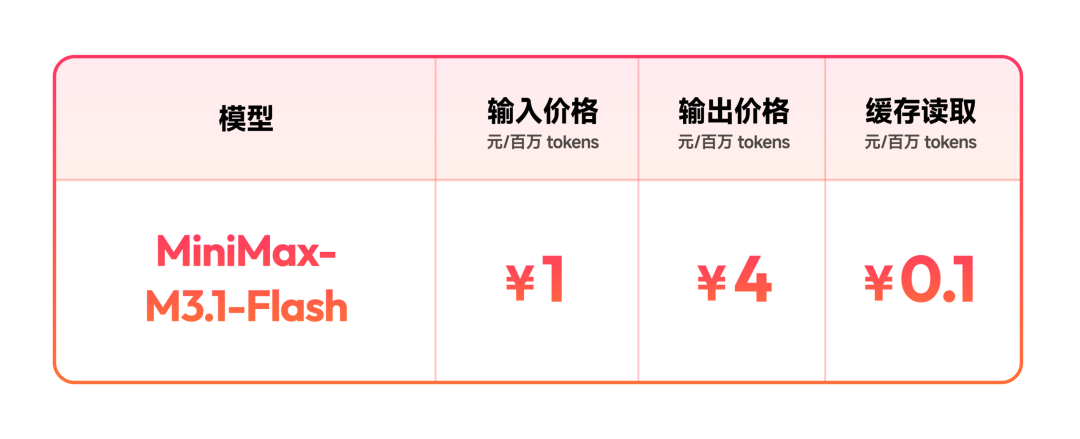
Die beiden Währungspläne sollten nicht als exakte Live-Äquivalente auf Basis von Wechselkursen verstanden werden. Verwenden Sie den Tarif der tatsächlich eingesetzten Abrechnungsplattform und des entsprechenden Kontos.
Die Quelle vergleicht den CNY-Tarif von MiniMax mit gemeldeten DeepSeek-Tarifen für Spitzen- und Nebenzeiten. Die Beispiele für eine Milliarde Eingabe-Token lassen sich unter den angegebenen Annahmen überprüfen:
| Cache-Trefferrate | Eingabekosten von MiniMax | Eingabekosten von DeepSeek zu Spitzenzeiten in der Quelle | Niedrigerer Betrag in diesem Beispiel |
|---|---|---|---|
| 90 % | 190 CNY. | 236 CNY. | MiniMax um 46 CNY. |
| 95 % | 145 CNY. | 138 CNY. | DeepSeek um 7 CNY. |
| 99 % | 109 CNY. | 59,60 CNY. | DeepSeek um 49,40 CNY. |
Bei MiniMax und einer Trefferrate von 90 % entsprechen eine Milliarde Eingabe-Token 1.000 Einheiten zu je einer Million Token: 100 × 1 + 900 × 0.10 = 190. Ausgabetoken sind in diesen Beispielen nur für Eingaben nicht enthalten. Ebenso unberücksichtigt bleiben Gebühren, die von den zitierten Tarifen nicht abgedeckt werden.
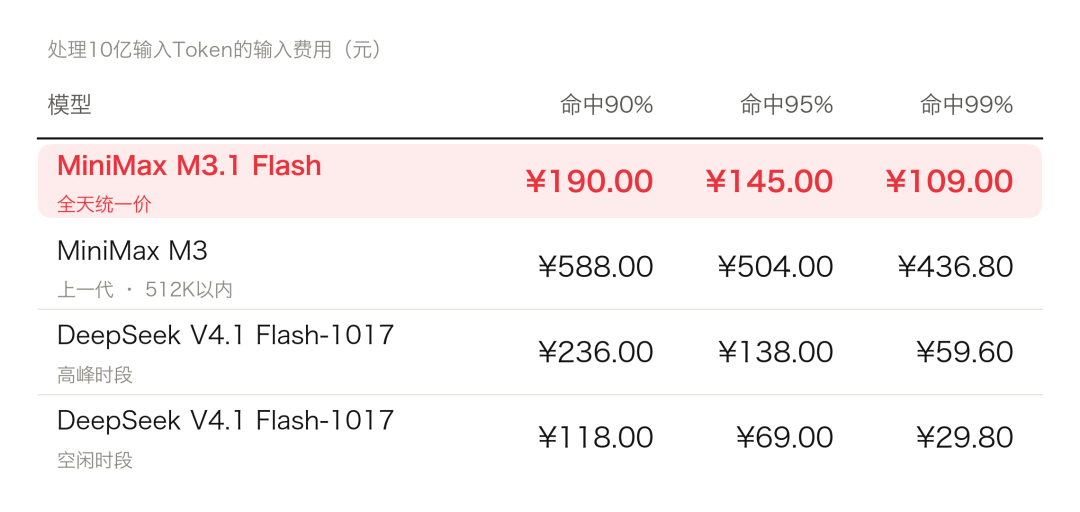
Dies zeigt auch, warum ein niedrigerer Preis für nicht zwischengespeicherte Eingaben nicht automatisch die niedrigste Rechnung garantiert, wenn Caching den Großteil der Nutzung ausmacht. Die Hochrechnung des Artikels von einem Benchmark-Durchschnitt auf 1.000 Geschäftsaufgaben dient der Budgetveranschaulichung und ist kein Angebotspreis für die Ausführung dieser Aufgaben in der Produktion.
MiniMax behauptet außerdem eine Senkung der Gesamtkosten für Agentenaufgaben um 70 % gegenüber dem Vorgänger. Diese Aussage zum Workload unterscheidet sich von einer einfachen Senkung des Preises pro Token.
Inferenzgeschwindigkeit, Space Bunny und API-Einstellungen
Erstelle in Minuten eine Showcase-Website und gewinne Leads
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Das Unternehmen bezeichnet den anonym getesteten Space Bunny als eine frühe Version von M3.1 Flash und gibt an, mehr als 200 Billionen Token verarbeitet zu haben. Es berichtet von einer Ausgabegeschwindigkeit von mehr als 200 Token pro Sekunde und einer mittleren Geschwindigkeit von über 170 Token pro Sekunde sowie von einer nahezu dreifach höheren Geschwindigkeit bei der Online-Inferenz.
Dies sind Messwerte des Unternehmens. Token pro Sekunde messen den Ausgabedurchsatz. Die Zeit bis zum Abschluss einer Agentenaufgabe umfasst jedoch auch Schlussfolgerungen, Tool-Aufrufe, Wartezeiten, Wiederholungen und Tests.
Der Leitfaden zur Modellaufruf-API von MiniMax bestätigt ein Kontextfenster von 1.000.000 Token sowie die Eingabe von Text, Bildern und Videos. Die Unterstützung dieser Eingaben bedeutet nicht, dass das Modell Bilder oder Videos erzeugt.
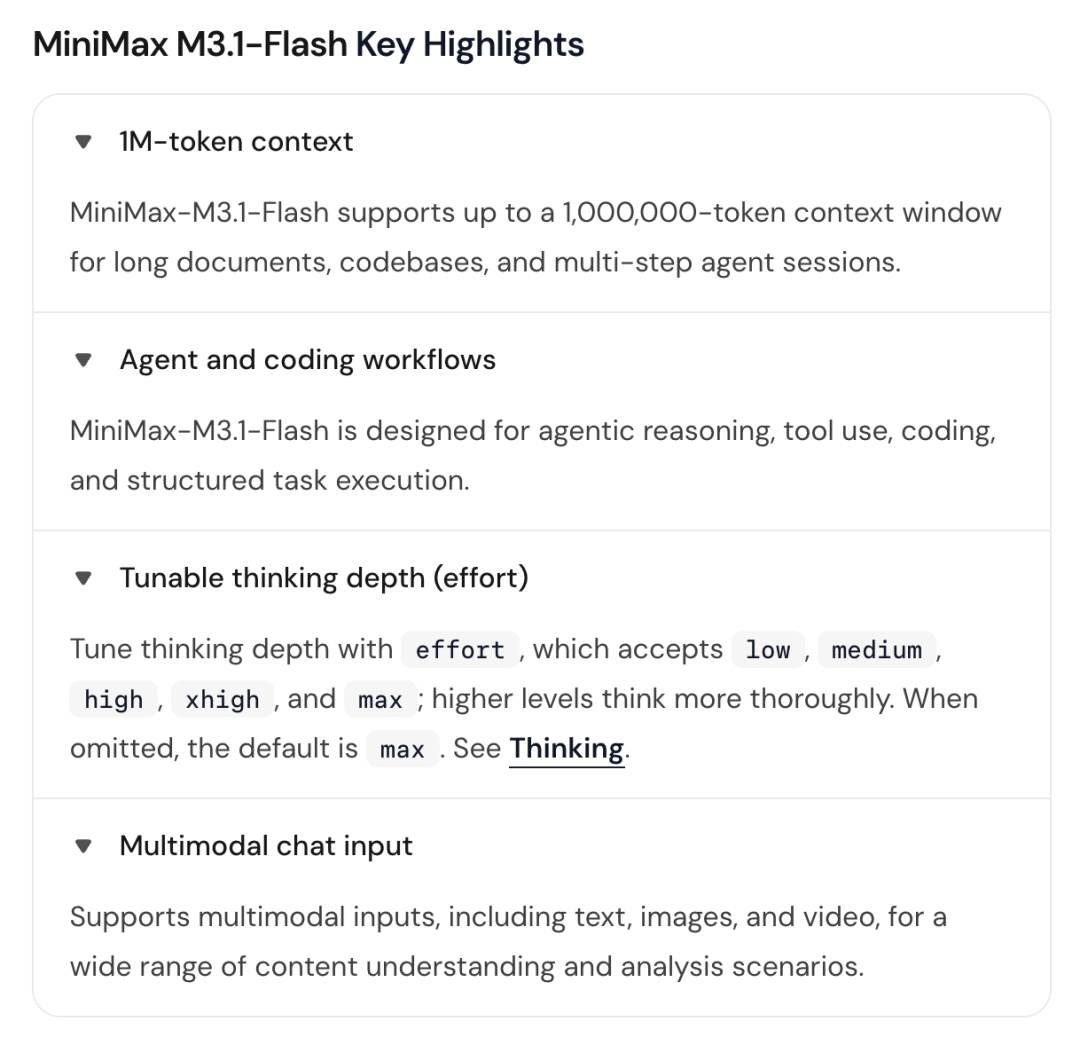
Der Leitfaden bestätigt fünf Stufen des Denkaufwands: low, medium, high, xhigh und max. Wenn die Einstellung nicht angegeben wird, ist max der Standardwert; der Denkaufwand kann nicht deaktiviert werden. Welches Anfragefeld verwendet wird, hängt vom Protokoll ab:
| Protokoll | Feld für die Denktiefe |
|---|---|
| Anthropic-kompatibel | output_config.effort. |
| OpenAI-kompatible Chat Completions | reasoning_effort. |
| OpenAI Responses | reasoning.effort. |
Diese Feldnamen sollten nicht zu einem einzigen Top-Level-Parameter effort zusammengefasst werden. Laut dem offiziellen Leitfaden erzeugen höhere Stufen im Allgemeinen mehr Denktoken und erhöhen die Latenz. Eine niedrigere Stufe reduziert diesen Aufwand, schaltet ihn jedoch nicht aus.
Der Launch-Zugang umfasst die MiniMax API, M Plan und MiniMax Code. In der Ankündigung heißt es, dass die Modellgewichte später veröffentlicht werden. Dieser Artikel impliziert daher nicht, dass beim Launch bereits eine selbst hostbare Version oder deren endgültige Lizenz verfügbar war.
Die Beispiele „Folding City“ und Pagode aus der Quelle
Xinzhiyuan beschreibt, wie das Modell mit Codex verbunden und zur Erstellung einer interaktiven Faltstadt aufgefordert wurde. Der Darstellung zufolge umfasst das Ergebnis einen Schieberegler zum Falten, eine nächtliche Beleuchtung und eine Ansicht, die zur Untersuchung der Szene gedreht werden kann.
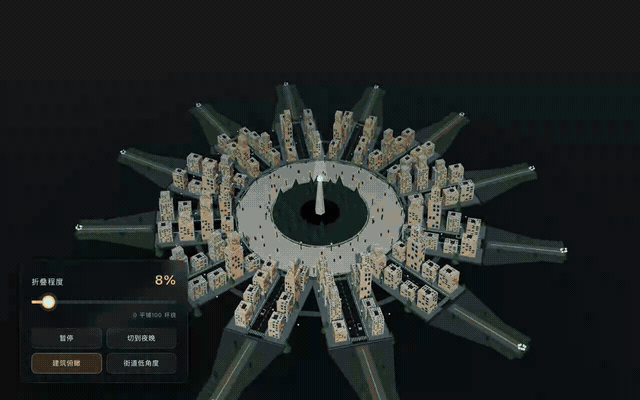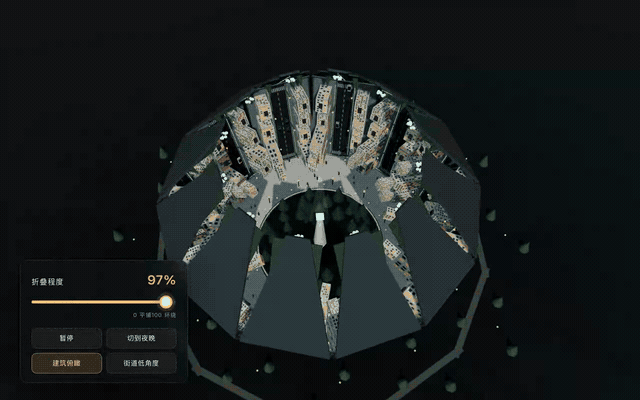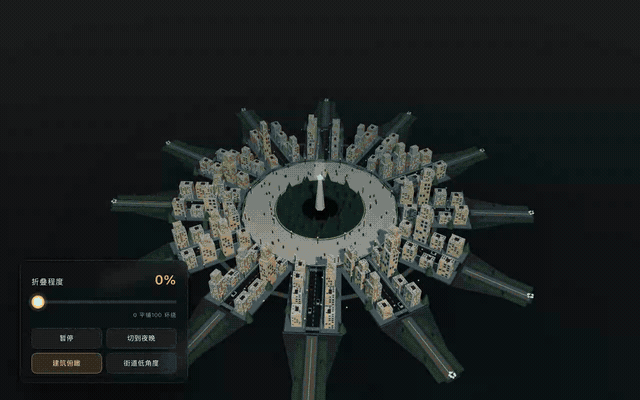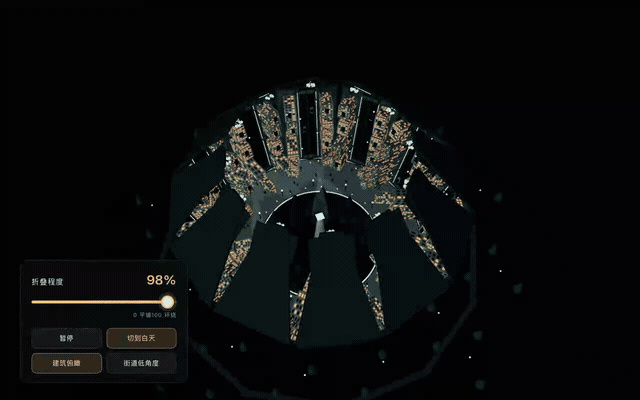
Dies ist eine Demonstration des Herausgebers und kein neuer Test, der für dieses Dokument durchgeführt wurde. Das Bild veranschaulicht eine ausgewählte Ausgabe, belegt jedoch weder Bildrate noch Codequalität oder browserübergreifendes Verhalten.
Der Artikel reproduziert außerdem das Pagodenbeispiel des Entwicklers AJ, das angeblich in einem API-Aufruf mit maximalem Denkaufwand und etwa 50.000 Token erzeugt wurde. Die Einschätzung dieses Entwicklers, dass die visuelle Wirkung stärker sei, ist ein persönliches Urteil und kein standardisierter Vergleich mit DeepSeek.
Ein Flash-Modell passend zur Aufgabe auswählen
Der Vergleich der Quelle deutet auf unterschiedliche Stärken hin: die Position von DeepSeek im dargestellten Diagramm zur Softwareentwicklung sowie die starken Ergebnisse von MiniMax bei Unternehmens-Workflows. Diese Unterschiede sprechen dafür, beide Modelle mit repräsentativen Aufgaben zu testen, statt sich auf eine einzelne Schlagzeilen-Rangliste zu verlassen.
Verfolgen Sie nach der Prüfung die Erfolgsquote, die verstrichene Zeit, Wiederholungen und die Gesamtausgaben. Ein niedrigerer Tokenpreis ist vor allem dann relevant, wenn das Modell die erforderliche Aufgabe erledigen kann, ohne durch zusätzliche Nacharbeit die Einsparung wieder aufzuheben.
MiniMax kündigt außerdem an, dass später eine Pro-Variante erscheinen soll. Dieses zukünftige Produkt sollte getrennt vom dokumentierten Launch-Verhalten von M3.1 Flash betrachtet werden.
FAQ
Ist MiniMax M3.1 Flash insgesamt das zweitbeste Modell?
Die Rangfolge der Quelle bezieht sich auf einen bestimmten Vergleich von Coding-Punktzahl und Kosten. Andere Evaluierungen in diesem Artikel zeigen abweichende Rangfolgen und Gleichstände.
Wie hoch sind die offiziellen Tokenpreise in US-Dollar?
Die Ankündigung von MiniMax nennt 0,15 $ für Eingaben, 0,60 $ für Ausgaben und 0,015 $ für zwischengespeicherte Eingaben pro einer Million Token. Prüfen Sie die geltende Abrechnungsplattform, bevor Sie anhand eines Tarifs in einer anderen Währung budgetieren.
Bedeutet der ALE-Wert von 739 CNY, dass alle Aufgaben bestanden wurden?
Nein. Dabei handelt es sich um geschätzte Gesamtkosten für einen vollständigen Lauf mit 152 bearbeiteten Aufgaben. Die gemeldete Bestehensquote beträgt 29,6 %. Kosten außerhalb der Annahmen des Diagramms sind nicht enthalten.
Welche Eingaben und welche Kontextlänge unterstützt der Leitfaden?
Der offizielle Leitfaden nennt Text-, Bild- und Videoeingaben sowie einen Kontext von bis zu einer Million Token. Das Verstehen von Eingaben bedeutet nicht automatisch, dass Bilder oder Videos erzeugt werden können.
Was geschieht, wenn die Einstellung für den Denkaufwand nicht angegeben wird?
Laut Dokumentation ist max der Standardwert. Verwenden Sie das korrekte protokollspezifische Feld, um eine niedrigere Stufe auszuwählen. Der Denkaufwand kann nicht deaktiviert werden.
Waren die Modellgewichte beim Launch bereits verfügbar?
In der Launch-Ankündigung heißt es, dass sie später veröffentlicht werden sollen. Der gehostete API-Zugang und die angekündigte Veröffentlichung der Modellgewichte sind zwei getrennte Aussagen zur Verfügbarkeit.
Verwandte Tools
- MiniMax API Platform: Gehosteter Zugang zu MiniMax-Modellen und Entwicklerdiensten.
- MiniMax Code: Die in der Launch-Ankündigung angebotene Desktop-Anwendung für Coding.
- M Plan: Der für den MiniMax-Zugang genannte Abonnementweg.
- DeepSeek-Flash-1017-Repository: Das veröffentlichte Repository des Vergleichsmodells.
Verwandte Links
- Bereitgestellter Artikel auf BAAI Hub: Die Quelle der CNY-Vergleiche und illustrierten Beispiele.
- Ankündigung von MiniMax zu M3.1 Flash: Offizielle Launch-Preise, Zugangsmöglichkeiten und Benchmark-Aussagen des Unternehmens.
- Leitfaden zum Modellaufruf von MiniMax: Verifizierter Kontext, Eingabeformate und protokollspezifische Steuerung des Denkaufwands.
- MiniMax API Platform: Der offizielle Einstiegspunkt für Entwickler.
- Download von MiniMax Code: Das von der offiziellen Ankündigung verlinkte Desktop-Produkt.
- DeepSeek V4.1 Flash-1017: Das für den Vergleich relevante Modell-Repository.
Zusammenfassung
M3.1 Flash kombiniert günstige Tokenpreise mit wettbewerbsfähigen, vom Unternehmen gemeldeten Ergebnissen bei Coding, Automatisierung und Computer-Nutzung. Sein Wert hängt von den Einstellungen für den Denkaufwand, dem Cache-Verhalten und der Frage ab, ob das Modell den tatsächlichen Workflow mit akzeptablem Nacharbeitsaufwand abschließt.
Verwenden Sie Benchmark-Diagramme, um festzulegen, was getestet werden sollte. Lassen Sie anschließend erfolgreiche Ergebnisse, die verstrichene Zeit und die vollständige Rechnung über die Wahl des Modells entscheiden.


