For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/muse-wonder-benchmarks-coding-results-lim-2cf7d1eb.md.
Die Einführung von Meta Muse Wonder lieferte zwei sehr unterschiedliche Arten von Belegen: starke Benchmark-Ergebnisse und Entwicklerdemonst...
Die Einführung von Meta Muse Wonder lieferte zwei sehr unterschiedliche Arten von Belegen: starke Benchmark-Ergebnisse und Entwicklerdemonstrationen, die teilweise deutlich weniger überzeugend waren. Ein chinesischer Bericht von Xinzhiyuan, erneut veröffentlicht auf BAAI Hub, macht aus dieser Lücke eine deutliche Kritik an benchmarkorientierter Optimierung.
Die Meinungsverschiedenheit verdient eine genaue Prüfung, doch eine schwache Demonstration belegt kein Schummeln. Für eine faire Bewertung braucht es die genaue Modellvariante, die getestete Aufgabe, die Agentensoftware rund um das Modell und die Quelle jedes Ergebnisses.
Die Quelle beschreibt, wie Entwickler Browser- oder 3D-Spielausgaben verglichen und Wonder gegenüber konkurrierenden Modellen als enttäuschend empfanden. Diese Demonstrationen lassen sich leicht prüfen: Zuschauer können sehen, ob die Bewegung funktioniert, sich die Kamera sinnvoll verhält und die Szene dem angeforderten Ergebnis ähnelt.
Die Quelle zitiert zudem Metas Alexandr Wang mit der Aussage, das Team habe nicht ausdrücklich für 3D-Demospiele trainiert, und ermutigt Entwickler, echte Programmierarbeit auszuprobieren. Diese Aussage wird von Xinzhiyuan berichtet; sie sollte nicht als pauschale Erklärung für jede fehlgeschlagene Programmieraufgabe dienen.
Spieldemonstrationen bleiben relevante Belege. Sie prüfen eine reale Kombination aus Codegenerierung, visueller Beurteilung, Interaktion und Debugging. Ihre Einschränkung liegt im Umfang: Ein Prompt und ein einzelner Durchlauf können keine Aussage über die Leistung bei Repository-Wartung, Terminalarbeit oder langen Softwareprojekten treffen.
Metas primäre Ankündigung stellt Muse Wonder und Muse Wonder Full als Modelle für persönliche und professionelle Agenten vor. Wonder wird über die Meta Model API und Muse Code angeboten; Full steht Muse-Code-Abonnenten zur Verfügung.
Die Ankündigung definiert Active Memory als das Behalten wichtiger Kontexte über Gespräche hinweg und deren Abruf, wenn sie relevant sind. Active Focus beschreibt anhaltende Fortschritte auf ein Ziel hin, einschließlich des Ausprobierens von Alternativen, der Anpassung an neue Informationen, des Einholens von Klarstellungen und der Überprüfung vor wichtigen Aktionen.
Diese Beschreibungen helfen zu erklären, was Meta verbessern möchte. Es handelt sich um Produkt- und Evaluierungsbehauptungen, nicht um Garantien dafür, dass ein Agent jede übertragene Aufgabe abschließt.
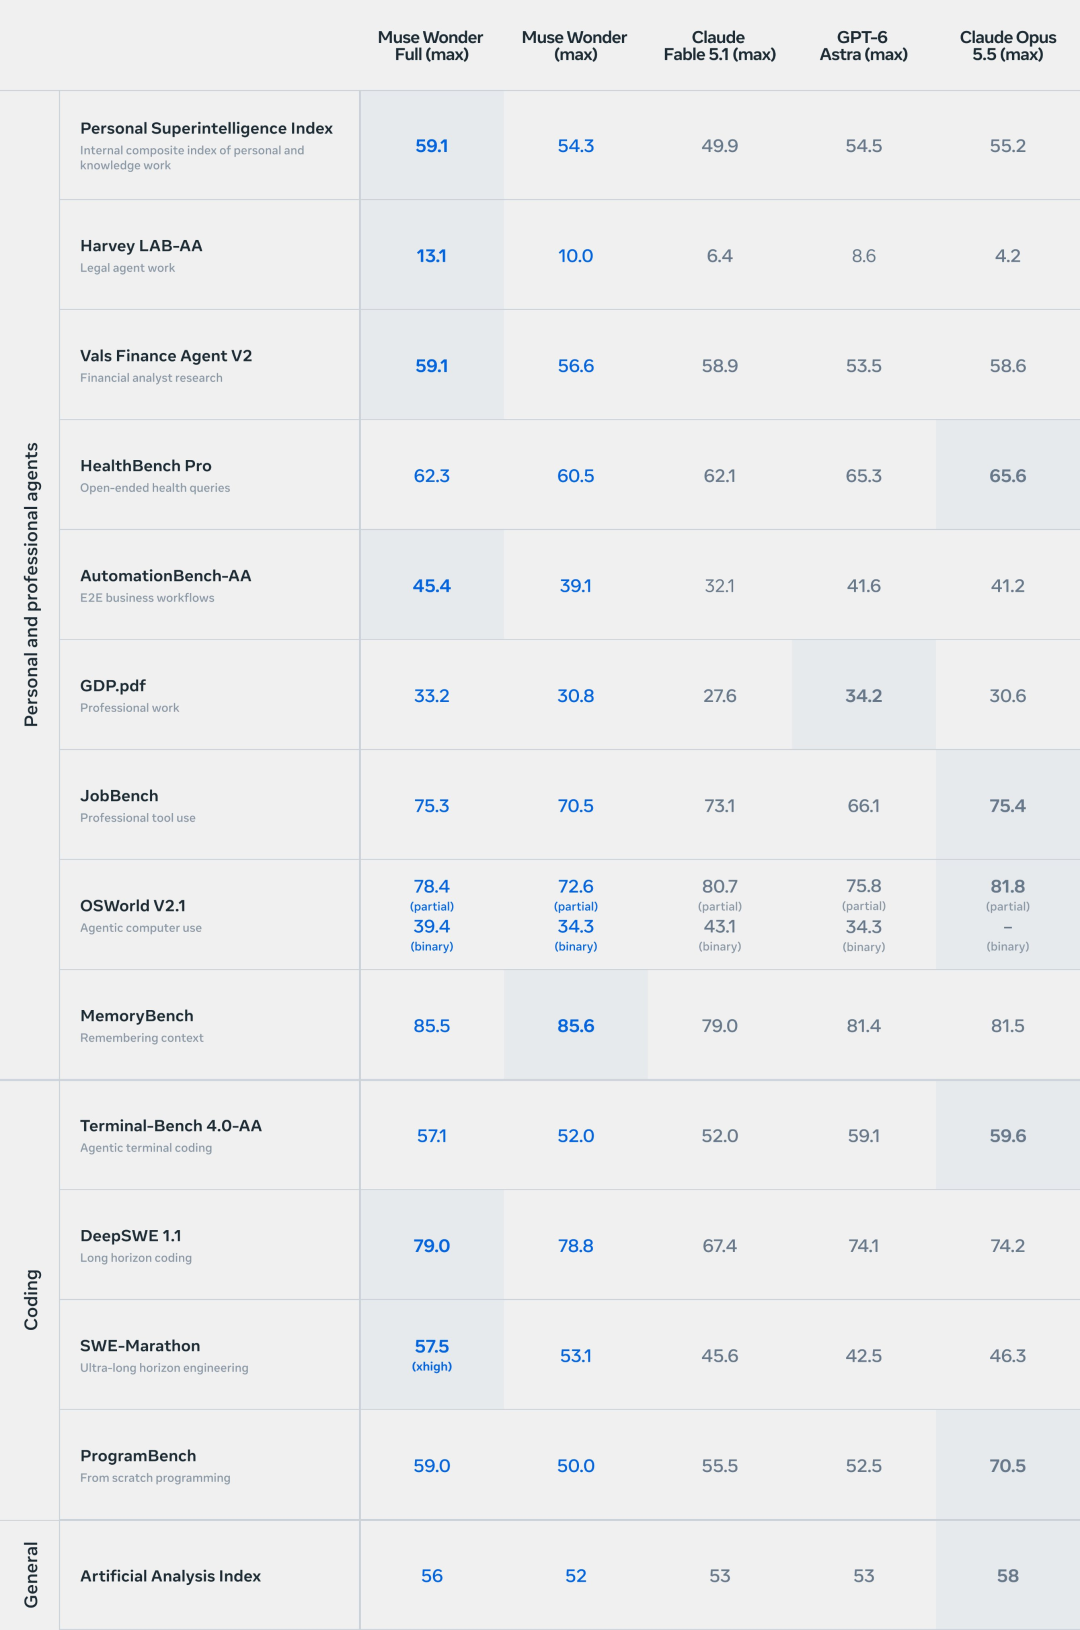
Metas veröffentlichte Vergleichstabelle, von Xinzhiyuan auf BAAI Hub reproduziert. Die Werte beziehen sich auf die in den Launch-Materialien gezeigten Konfigurationen und Evaluierungsbedingungen.
Die Tabelle zeigt keinen universellen Gewinner. Die Coding-Ergebnisse unterscheiden sich je nach Aufgabe erheblich:
| Evaluierung | Muse Wonder Full | Claude Opus 5.5 | Richtung des Vergleichs |
|---|---|---|---|
| DeepSWE 1.1 | 79.0 | 74.2 | Full erzielt einen höheren Wert |
| SWE-Marathon | 57.5 | 46.3 | Full erzielt unter dem berichteten Setup einen höheren Wert |
| Terminal-Bench 4.0-AA | 57.1 | 59.6 | Opus erzielt einen höheren Wert |
| ProgramBench | 59.0 | 70.5 | Opus erzielt einen höheren Wert |
Metas begleitendes Material berichtet außerdem über Stärken bei Speicher- und Agenten-Workflows sowie über Bereiche, in denen andere Modelle führen. Ein starkes Ergebnis bei langlaufender Softwarearbeit bedeutet nicht automatisch die beste Leistung bei der Neuentwicklung einer Anwendung.
Die Evaluierungsbedingungen sind insbesondere bei SWE-Marathon wichtig. Metas Model Card beschreibt, dass Wettbewerber über Codex und Claude Code ausgeführt wurden, während das hervorgehobene Ergebnis von Wonder Full eine xhigh-Konfiguration verwendet. Dies sind aussagekräftige Ergebnisse auf Produktebene, aber kein einzelnes kontrolliertes Experiment mit einem identischen Agenten-Framework für jedes Modell.
Metas Launch-Blog behandelt ausdrücklich die Lücke zwischen vertrauten Benchmarks und unbekannten Aufgaben. Die Analyse vergleicht In-Distribution- und Out-of-Distribution-Leistung, wenn der Rechenaufwand zur Inferenzzeit steigt, und argumentiert, dass das stärkere Basismodell von Wonder Full die Übertragbarkeit von Post-Training-Gewinnen auf andere Aufgaben verbessert.
Das ist relevante technische Evidenz für Metas Position. Es handelt sich jedoch weiterhin um eine vom Modellentwickler ausgewählte und präsentierte Evaluierung und sie klärt nicht jede Beschwerde über die Ausgabe eines Entwicklers.
Ebenso belegen Berichte über eine enttäuschende Spieldemo weder Benchmark-Kontamination noch Ergebnismanipulation. Um solche Behauptungen zu belegen, wären direktere Nachweise über Daten, Methoden oder manipulierte Ergebnisse erforderlich, als der Quellartikel liefert.
Unabhängige Berichterstattung von Artificial Analysis nennt Intelligence-Index-v4.3-Werte von 56 für Wonder Full und 52 für Wonder bei maximalem Reasoning-Aufwand. Ein API-Nutzer, der das reguläre Wonder testet, bewertet daher ein anderes Launch-Angebot als das Full-Modell, das in mehreren Diagrammen im Mittelpunkt steht.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Artificial Analysis führt für beide Varianten ein Kontextfenster von einer Million Token auf. Für Wonder nennt die Quelle 4 US-Dollar pro Million Input-Token, 0,20 US-Dollar für gecachte Eingaben und 20 US-Dollar für Output. Die geschätzten 4,52 US-Dollar pro Intelligence-Index-Aufgabe sind evaluierungsspezifische Kosten und kein Festpreis für eine beliebige Nutzeranfrage.
Die Quelle kritisiert außerdem das Fehlen einer öffentlichen Open-Weight-Veröffentlichung. Weder die geprüfte Launch-Ankündigung noch die Zugriffsbeschreibung stellen einen herunterladbaren Release der Wonder-Gewichte bereit; Entwickler sollten daher nicht davon ausgehen, dass lokales Self-Hosting verfügbar ist.
Meta erklärt, dass Wonder in seinem Prometheus-Rechenzentrum im Gigawatt-Maßstab trainiert wurde. Der BAAI-Artikel verbindet den Launch mit Aussagen von Mark Zuckerberg und Wang über den Umfang der KI-Infrastrukturinvestitionen und die Rolle persönlicher Agenten im Handel.
Diese Aussagen beschreiben eine übergeordnete Strategie. Sie sollten nicht in eine verifizierte Trainingskostenzahl für dieses konkrete Modell umgedeutet werden. Ebenso ist ein Beispiel für Agenten, die Dienstleistungen verhandeln oder kaufen, eine Vision für das Produktverhalten und kein Nachweis dafür, dass jeder solche Workflow bereits eingeführt wurde.
Der nächste sinnvolle Schritt sind wiederholbare Tests: Anforderungen konstant halten, Variante und Reasoning-Einstellung benennen, die Umgebung dokumentieren und abgeschlossene Arbeit messen. Das kann sowohl Stärken als auch Schwächen verlässlicher sichtbar machen als ein einzelner Schlagzeilenwert oder ein einzelnes auffälliges Scheitern.
Nein. Sie können schwache Leistung bei den demonstrierten Aufgaben zeigen, doch der Nachweis von Benchmark-Schummeln erfordert getrennte Belege zu Evaluierungsmethoden, Daten oder manipulierten Ergebnissen.
Es handelt sich um unterschiedliche Angebote innerhalb der Modellfamilie mit verschiedenen Zugangswegen zum Launch. Artificial Analysis berichtet bei maximalem Reasoning-Aufwand Werte von 52 für Wonder und 56 für Full im Intelligence Index v4.3.
Die zitierte Tabelle liefert je nach Coding-Evaluierung unterschiedliche Antworten. Full führt bei DeepSWE 1.1 und im berichteten SWE-Marathon-Setup, während Opus bei Terminal-Bench 4.0-AA und ProgramBench führt.
Nur mit einer Einschränkung zum Setup. Metas Model Card beschreibt, dass Wettbewerber ihre Coding-Produkte verwenden, sodass Unterschiede beim Agentenverhalten und bei den Werkzeugen neben den zugrunde liegenden Modellen das Ergebnis beeinflussen können.
Die Launch-Berichterstattung von Artificial Analysis nennt 4 US-Dollar pro Million Input-Token, 0,20 US-Dollar pro Million gecachter Input-Token und 20 US-Dollar pro Million Output-Token. Prüfen Sie vor einer Produktionsnutzung die aktuellen Abrechnungsbedingungen des Anbieters.
Aus den geprüften Launch-Materialien ließ sich kein öffentlicher Download der Gewichte ableiten. Die dokumentierten Zugangswege sind die API und Muse Code für Wonder sowie der Muse-Code-Abonnementzugang für Full.
Die Launch-Ergebnisse von Muse Wonder zeigen eine Modellfamilie mit starken Scores für Agenten und Software Engineering, uneinheitlichen Ergebnissen über verschiedene Coding-Kategorien hinweg sowie unterschiedlichen Zugangswegen für die reguläre und die Full-Variante.
Die hilfreiche Schlussfolgerung ist aufgabenspezifisch: Prüfen Sie das genaue Modell und testen Sie abgeschlossene Arbeit, bevor Sie entweder eine pauschale Siegesbehauptung oder einen Schummelvorwurf akzeptieren.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.