For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/muse-wonder-full-vs-gemini-4-argon-benchm-70ca5d3f.md.
Metas Einführung von Muse Wonder bringt zwei ähnlich benannte Modelle in ein wettbewerbsintensives Umfeld. Damit stellt sich zunächst eine u...
Metas Einführung von Muse Wonder bringt zwei ähnlich benannte Modelle in ein wettbewerbsintensives Umfeld. Damit stellt sich zunächst eine ungewöhnlich praktische Frage: Betrachten Sie Muse Wonder oder Muse Wonder Full?
Artificial Analysis berichtet für den Intelligence Index v4.3 Werte von 52 für Wonder und 56 für Wonder Full, jeweils bei maximalem Reasoning-Aufwand. Der auf BAAI Hub erneut veröffentlichte chinesische Artikel konzentriert sich darauf, dass Full vor dem berichteten Ergebnis von 53 Punkten für Gemini 4 Argon liegt. Dabei handelt es sich um einen Benchmark-Vergleich bestimmter Modellkonfigurationen und nicht um einen Beweis dafür, dass eine der Wonder-Varianten jede reale Aufgabe gewinnt.
Metas offizielle Ankündigung besagt, dass Muse Wonder über die Meta Model API und Muse Code verfügbar ist. Muse Wonder Full ist für Abonnenten von Muse Code verfügbar. Das Unternehmen erklärt, dass Wonder später auch Funktionen in seinem Muse-Assistenten unterstützen wird, zunächst für Abonnenten.
| Modell | Intelligence Index v4.3, maximaler Aufwand | Von Meta beschriebener Zugang zum Start |
|---|---|---|
| Muse Wonder | 52 | Meta Model API und Muse Code |
| Muse Wonder Full | 56 | Muse-Code-Abonnement |
Diese Unterschiede sind wichtig, wenn Sie ein veröffentlichtes Ergebnis reproduzieren möchten. Der Zugriff auf Wonder über die API ist nicht dasselbe wie die Bewertung von Full über das Coding-Produkt.
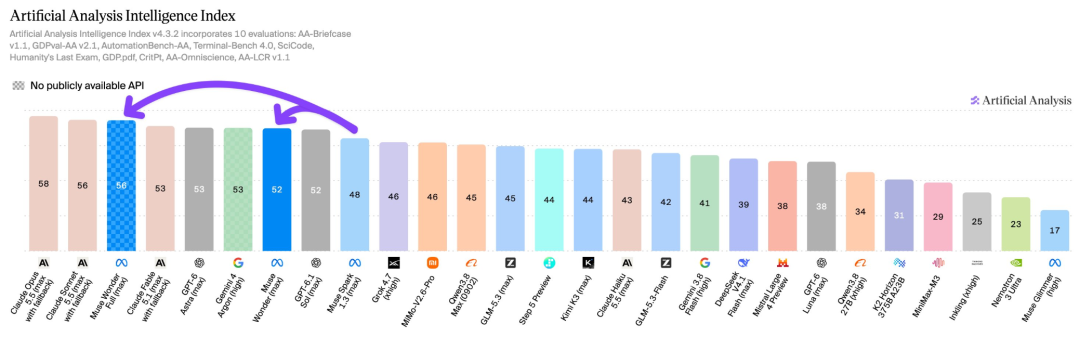
Diagramm: Artificial Analysis, reproduziert und kommentiert im QbitAI-Bericht auf BAAI Hub. Es zeigt den Vergleich zum Zeitpunkt der Veröffentlichung der Quelle.
Artificial Analysis berichtet zudem für beide Varianten Kontextfenster von einer Million Token. In der Startanalyse werden für die Wonder API Preise von 4 US-Dollar pro Million Eingabe-Token, 0,20 US-Dollar pro Million zwischengespeicherter Eingabe-Token und 20 US-Dollar pro Million Ausgabe-Token genannt. Für Full wird in dieser Analyse kein Token-Preis genannt, weil der Zugang zum Start über ein Abonnementprodukt erfolgt.
Der BAAI-Artikel betont den zum Berichtszeitpunkt stärker eingeschränkten Zugang zu Gemini 4 Argon. Die Verfügbarkeit kann sich schnell ändern; dieser historische Kontrast sollte daher nicht als Zusage zu den aktuellen Zugangsregeln eines der beiden Anbieter verstanden werden.
Meta positioniert Wonder als Modellfamilie für persönliche und professionelle Agenten. In der Ankündigung erhalten zwei wiederkehrende Fähigkeiten unterschiedliche Bezeichnungen.
Active Memory betrifft das Behalten wichtiger Informationen über Gespräche hinweg und das Abrufen der Details, die für eine neue Aufgabe relevant sind. Für einen persönlichen Assistenten könnte das bedeuten, eine bereits bekannte Präferenz zu berücksichtigen, ohne dass der Nutzer sie jedes Mal erneut nennen muss.
Active Focus betrifft die konsequente Verfolgung eines Ziels, wenn der erste Versuch scheitert. Meta beschreibt dabei alternative Ansätze, die Anpassung an neue Informationen, das Einholen von Rückfragen bei Bedarf und die Prüfung vor wichtigen Aktionen.
Für das Programmieren werden beide Verhaltensweisen benötigt. Ein Agent muss möglicherweise eine ursprüngliche Vorgabe über mehrere Runden von Änderungen, fehlgeschlagenen Tests und Überarbeitungen hinweg bewahren. Meta erklärt, dass die Wonder-Modelle mit vielfältigen Aufgaben trainiert wurden, die längere Arbeitsphasen erfordern, und dabei auf dem Skalierungsansatz von Muse Spark aufbauen.
Die Quelle stellt starke Benchmarks für Software Engineering gemischten Reaktionen auf 3D-Spiel-Demonstrationen gegenüber. Dabei handelt es sich um unterschiedliche Workloads, auch wenn beide verlangen, dass das Modell Code schreibt.
DeepSWE 1.1 testet die Arbeit an bestehender Software, während ProgramBench das Erstellen von Programmen von Grund auf betrifft. Die Vergleichstabelle in Metas Startmaterial meldet 59,0 für Wonder Full und 70,5 für Claude Opus 5.5 bei ProgramBench. Ein Modell kann daher bei einer Art von Engineering-Aufgabe führen und bei einer anderen zurückliegen.
Der Originalbericht beschreibt außerdem Entwickler, die Opus für eine Unity-Demonstration bevorzugten, sowie einen weiteren Entwickler, der einen erfolgreichen Durchlauf mit Wonder Full meldete. Dies sind individuelle Beobachtungen mit unterschiedlichen Prompts, Umgebungen und Erfolgskriterien. Ihre Abweichung ist ein Grund, das Aufgaben-Setup zu prüfen, statt ihre Anekdoten zu einer universellen Rangliste zusammenzufassen.
Eine weitere Einschränkung ist bei langlaufenden Softwaretests wichtig: Metas Model Card besagt, dass der SWE-Marathon-Vergleich die Coding-Agenten der konkurrierenden Anbieter einsetzt, darunter Codex und Claude Code. Das macht das Ergebnis für einen End-to-End-Produktvergleich relevant, es handelt sich jedoch nicht um einen kontrollierten Vergleich, bei dem jedes Modell dieselbe Agenten-Harness verwendet.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Damit erhält der Benchmark aus der Überschrift ein praktisches Gegenstück. Ein Modell, das eine weniger überzeugende Spiel-Demo erzeugt, kann für eine Wartungsaufgabe dennoch nützlich sein, und ein hoher Indexwert entschuldigt keine fehlerhafte Ausgabe.
Es ist die Full-Variante in Metas Modellfamilie Muse Wonder. Metas Startankündigung macht sie für Muse-Code-Abonnenten verfügbar, während die reguläre Wonder-Variante zusätzlich über einen API-Zugang verfügt.
Der Intelligence-Index-Vergleich der Quelle zum Startzeitpunkt ordnet Wonder Full mit 56 Punkten und Gemini 4 Argon mit 53 Punkten ein. Das beschreibt den jeweiligen Index und die gezeigten Konfigurationen, nicht ein Ergebnis für jede Aufgabe oder Bewertung.
Metas Ankündigung unterscheidet die beiden Zugangswege. Sie führt Wonder für die API und Muse Code auf, während Full für Abonnenten von Muse Code vorgesehen ist.
In der Startberichterstattung von Artificial Analysis werden 4 US-Dollar pro Million Eingabe-Token, 0,20 US-Dollar für zwischengespeicherte Eingaben und 20 US-Dollar für Ausgaben genannt. Dies sind zum Veröffentlichungszeitpunkt gemeldete Preise; prüfen Sie vor dem Einsatz die Abrechnungsbedingungen des Anbieters.
Active Memory betrifft das Abrufen nützlicher Informationen aus früheren Gesprächen. Active Focus betrifft die ausdauernde Ausführung, einschließlich des Versuchs eines anderen Ansatzes, wenn eine Aufgabe auf ein Hindernis stößt.
Sie zeigen eine Schwäche bei diesen konkreten Aufgaben und Einstellungen. Eine umfassendere Bewertung der Coding-Leistung schließt auch Repository-Wartung, Debugging, Tool-Nutzung und das Erfüllen von Anforderungen in längeren Workflows ein.
Die starken Werte von Wonder Full zum Start machen es zu einer relevanten Option für anspruchsvolle Agentenarbeit. Das reguläre Wonder-Modell hat einen anderen Wert und einen anderen Zugangsweg; deshalb muss die Variantenbezeichnung bei jeder Leistungsbehauptung mitgenannt werden.
Nutzen Sie Benchmark-Ranglisten, um einen Kandidaten für einen Test auszuwählen, und vergleichen Sie anschließend das genaue Modell bei der Arbeit, die es für Sie erledigen soll.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



