
Laut einem QbitAI-Artikel vom 21. Oktober könnte eine weitere Welle von Modellveröffentlichungen bevorstehen. Der Bericht behandelt ein noch nicht veröffentlichtes Claude-Modell, ein Google-Modell namens Carbon sowie einen GPT-6.1-Terra-Identifier, der angeblich in einer Microsoft-Evaluierungskonfiguration gefunden wurde.
Dabei handelt es sich um unterschiedliche Arten von Belegen. Eindrücke privater Tester, ein Name in einem Codebestand und veröffentlichte Evaluierungsergebnisse sollten nicht als gleichwertiger Nachweis einer Produkteinführung behandelt werden. Die am klarsten bestätigte Entwicklung in dieser Zusammenstellung ist OpenAIs separat veröffentlichte Arbeit zu Programmiersprachen, die bislang weniger umfassend unterstützt werden.
Ein noch nicht veröffentlichtes Claude-Modell soll über einzelne Fehler hinausblicken
QbitAI führt seine Informationen zu Claude auf The Information zurück. In dieser Darstellung beschreibt ein früher Nutzer ein verbessertes logisches Schlussfolgern und eine stärkere Fähigkeit, das Ziel hinter einer Anfrage zu erkennen.
Das Programmierbeispiel betrifft die Ursachenanalyse: Statt nur einen einzelnen gemeldeten Fehler zu beheben, erkennt das Modell angeblich eine umfassendere Ursache für ähnliche Fehler und fragt, ob der Nutzer diese Fehlerklasse insgesamt bearbeiten lassen möchte. Vor einer Ausweitung der Änderung nachzufragen, ist ein wichtiger Bestandteil dieses Beispiels – insbesondere in einem Repository, in dem eine umfassendere Korrektur andere, nicht damit verbundene Funktionen beeinflussen könnte.
Die Darstellung beschreibt außerdem weniger konventionelle Antworten auf offene Fragen. Das Beispiel zur Aktienauswahl ist eine Anekdote über die Entwicklung eines neuen Ansatzes und kein Beleg für eine Anlageperformance. Validierte Renditen, eine finanzielle Benchmark oder ein einsetzbarer Handelsalgorithmus werden nicht vorgelegt.
Die Identität des Modells bleibt in der Quelle ungeklärt. Namen wie Fable und Opus werden als Möglichkeiten genannt, nicht als bestätigte Produktbezeichnungen. Außerdem gibt es keinen reproduzierbaren Benchmark, der die Größe der behaupteten Verbesserung belegt.
Gemini Carbon und die Grenzen internen Feedbacks
Der nächste Teil betrifft das angeblich interne Carbon-Modell von Google. Laut der vorliegenden Darstellung übertrifft es Argon beim Programmieren und bleibt bei visuellen Aufgaben wie der Videoanalyse oder der Untersuchung des Frontend-Verhaltens leistungsfähig.
Außerdem wird berichtet, dass Mitarbeitende Carbon über eine interne Programmierplattform namens Jetski ausprobierten und die Erfahrung im Vergleich zu Opus 5.5 positiv bewerteten. Dabei handelt es sich um informelle Eindrücke aus einer internen Umgebung. Unterschiede bei Prompts, Tool-Zugriffen und Testbedingungen verhindern, dass daraus ein allgemeines Modellranking abgeleitet werden kann.
QbitAI beschreibt Argon, Barium und Carbon als interne Entwicklungsnamen und erklärt, dass ein Barium-B-Kandidat schließlich zum öffentlich als Argon bezeichneten Modell wurde. Diese Namensgeschichte wird hier als Teil der Darstellung der Quelle wiedergegeben. Ein interner Name allein belegt nicht die genaue Trainingsabstammung eines öffentlich verfügbaren Modells.
Der Artikel behandelt anschließend einen Social-Media-Beitrag über rekursive Selbstverbesserung, kurz RSI. Der zeitliche Zusammenhang wird als möglicher Hinweis auf Carbon interpretiert. Eine soziale Äußerung belegt nicht, dass Carbon durch RSI trainiert wurde, und die Quelle liefert keine technische Beschreibung eines solchen Systems. Auch die Erklärung, wonach YouTube-Trainingsdaten verwendet wurden, wird durch keine verifizierte Offenlegung der Trainingsdaten in den für diesen Artikel geprüften Materialien gestützt.
Ein GPT-6.1-Terra-Name erscheint in einem Evaluierungs-Screenshot
Der vorliegende Artikel zeigt einen Beitrag von Lumina über einen Microsoft-Pull-Request, in dem angeblich GPT-5.6-Terra-Evaluierungseinstellungen durch GPT-6.1-Terra ersetzt werden. Der zugehörige Screenshot zeigt gpt-6.1-terra als Standard für das Bewertungsmodell.
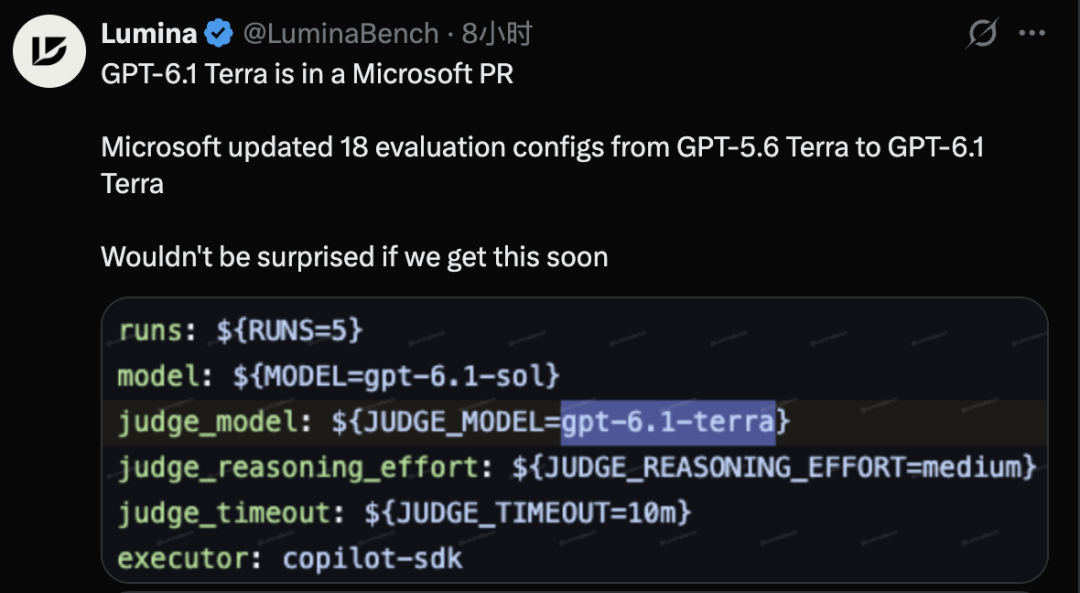
Quelle des Screenshots: von QbitAI und BAAI Hub reproduzierter Lumina-Beitrag.
Eine Konfigurationszeichenfolge ist ein nützlicher Beleg dafür, dass ein Name referenziert wurde. Sie belegt jedoch weder einen allgemein verfügbaren Endpunkt noch einen Preis, ein Veröffentlichungsdatum oder eine bestimmte Leistungsklasse. Der für diesen Artikel geprüfte öffentliche Modellkatalog von OpenAI enthielt keinen bestätigten Eintrag für die Veröffentlichung von GPT-6.1 Terra.
Die Quelle nutzt diesen Fund, um die Theorie infrage zu stellen, GPT-6.1 Sol sei lediglich Terra unter einem anderen Namen. Weder ein Screenshot noch Spekulationen über die Namensgebung reichen aus, um die Trainings- oder Produktentscheidungen hinter den Modellen zu rekonstruieren.
Einige Reaktionen in dem Artikel sind abwertend, während andere vermuten, dass ein günstigeres Modell eine umfassendere Integration von ChatGPT und Programmier-Workflows unterstützen könnte. Diese Produktstrategie bleibt in dieser Darstellung eine Interpretation und ist weder ein bestätigter Rollout-Plan noch eine Zusage für einen kostenlosen Tarif.
Bestätigte Fortschritte bei COBOL und anderen ressourcenarmen Programmiersprachen
OpenAIs Forschungsankündigung vom 19. Oktober beschreibt zwei Evaluierungen: die Entwicklung SQLite-kompatibler Software in 20 Sprachen sowie die Migration von COBOL unter Beibehaltung des Verhaltens. Der Begriff „ressourcenarm“ bezieht sich hier auf die vergleichsweise geringe Menge an Code und Dokumentation für das Training und nicht auf die Bedeutung einer Sprache oder den erforderlichen Rechenaufwand.
Erstelle in Minuten eine Showcase-Website und gewinne Leads
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Bei der Evaluierung der COBOL-Migration erreicht GPT-6.1 Sol 86,6 % bei geringem Schlussfolgerungsaufwand, verglichen mit 5,4 % für GPT-5.6 Sol unter derselben Einstellung. OpenAI berichtet 97,9 % bei höherem Schlussfolgerungsaufwand. Diese Werte stammen aus der Evaluierung von OpenAI und sind keine Erfolgsquoten, die für beliebige Migrationen von Banksystemen garantiert werden.
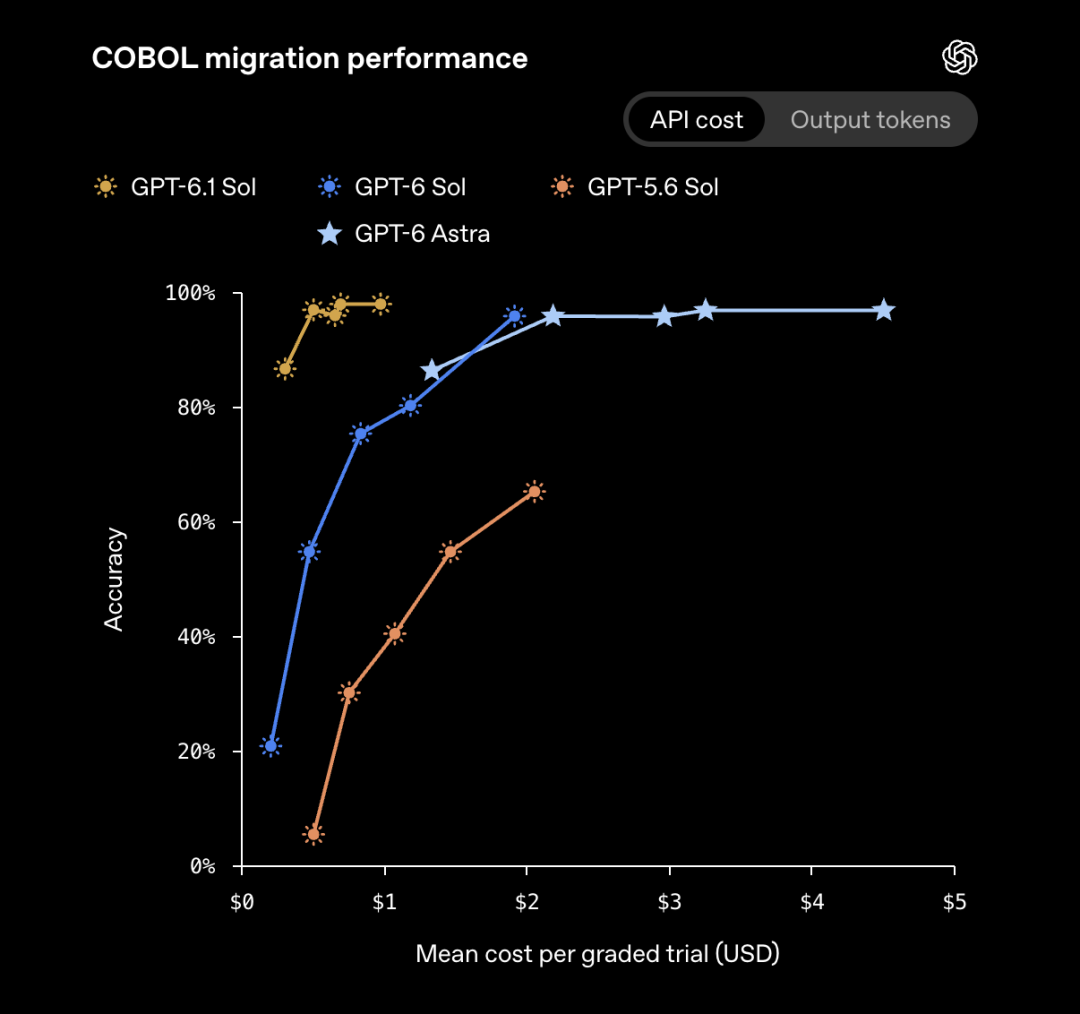
Diagramm: OpenAI; im vorliegenden Artikel reproduziert.
Die Bewahrung des Programmverhaltens ist wichtig, weil ein Programm zwar kompiliert werden kann, sich aber dennoch Rundungen, Datensatzverarbeitung oder beobachtbare Ausgaben verändern können. Bei der Anwendung einer Migration auf ein reales System bleiben eine Prüfung durch Experten und repräsentative Tests erforderlich.
Die Quelle schließt mit der Erwartung weiterer chinesischer Modellveröffentlichungen, darunter Kimi, GLM und MiniMax, nachdem die Aktivitäten rund um DeepSeek erneut zugenommen haben. Ein vollständiger, bestätigter Veröffentlichungszeitplan wird nicht genannt. Diese Erwartungen sollten daher offen bleiben und nicht als geplante Markteinführungen dargestellt werden.
FAQ
Wurde das neue Claude-Modell offiziell identifiziert?
Der vorliegende Artikel bestätigt keinen endgültigen öffentlichen Namen. Die Beschreibungen seiner Fähigkeiten stammen aus einem gemeldeten privaten Test und nicht aus einer verifizierten Veröffentlichungsspezifikation.
Ist Gemini Carbon eine bestätigte öffentliche Veröffentlichung?
Die Quelle beschreibt ein internes Modell und das Feedback von Mitarbeitenden. Sie liefert weder ein verifiziertes öffentliches Veröffentlichungsdatum noch einen zugänglichen Carbon-Modellendpunkt.
Belegt der RSI-Beitrag, dass Carbon sich selbst verbessern kann?
Nein. Die vorliegende Darstellung enthält keine technischen Belege für diese Behauptung. Der Artikel verknüpft eine Äußerung in sozialen Medien mit den Berichten über das Modell; das bleibt eine Schlussfolgerung.
Ist GPT-6.1 Terra über die OpenAI API verfügbar?
Der Fund im Code belegt keine API-Verfügbarkeit. Der für diesen Artikel geprüfte offizielle Katalog bestätigte keine öffentliche Veröffentlichung von GPT-6.1 Terra.
Welches Ergebnis erzielte GPT-6.1 Sol bei der COBOL-Migration?
OpenAI berichtet 86,6 % bei geringem Schlussfolgerungsaufwand und 97,9 % bei einer höheren Einstellung. Diese Werte beschreiben die Bedingungen der Evaluierung und stellen keine universelle Garantie für Migrationen dar.
Können von KI erzeugte Migrationen von Legacy-Code sofort produktiv eingesetzt werden?
Eine erfolgreiche Generierung oder Kompilierung reicht nicht aus, um ein gleichwertiges Verhalten zu belegen. Teams benötigen weiterhin Tests, die Geschäftsregeln, Datenformate und Abhängigkeiten des Systems abdecken, sowie eine Prüfung durch Experten.
Verwandte Tools
- Claude: Die Assistentenplattform von Anthropic, die von der unbestätigten Modellidentität in diesem Bericht zu unterscheiden ist.
- Gemini: Der öffentliche Assistentendienst von Google, getrennt von den beschriebenen internen Tests.
- OpenAI-Modellkatalog: Offizielle Dokumentation zur Überprüfung veröffentlichter Modell-Identifier.
Verwandte Links
- Bereitgestellter QbitAI-Artikel auf BAAI Hub: Die Quelle für die Zusammenstellung der Modellberichte und die Screenshots.
- OpenAIs Forschung zu ressourcenarmen Programmiersprachen: Die Primärquelle für die Ergebnisse der COBOL-Evaluierung.
- Veröffentlichter Modellkatalog von OpenAI: Eine Referenz zur Überprüfung von Modelllisten, anstatt aus Leaks auf die Verfügbarkeit zu schließen.
- Erste von QbitAI zitierte Quelle in sozialen Medien: Eine vom vorliegenden Artikel aufgeführte ursprüngliche Quelle in sozialen Medien; die zugrunde liegenden Behauptungen wurden hier nicht unabhängig authentifiziert.
- Zweite von QbitAI zitierte Quelle in sozialen Medien: Eine weitere vom Artikel bereitgestellte Referenz und keine offizielle Veröffentlichungsankündigung.
Zusammenfassung
Die Zusammenstellung verweist auf mögliche neue Claude- und Gemini-Modelle sowie auf einen Terra-Identifier in Evaluierungscode. Ihre endgültige Markenbezeichnung, Verfügbarkeit und vergleichbare Leistungsfähigkeit bleiben auf Grundlage der verfügbaren Belege unklar.
Das bestätigte Ergebnis ist enger gefasst: OpenAI hat verbesserte Evaluierungsergebnisse für Legacy-Sprachen veröffentlicht, während die übrigen Behauptungen zu Modellveröffentlichungen weiterhin einer offiziellen Bestätigung bedürfen.


