For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/nvidia-aspire-v1-0-robot-debugging-skills-a8a0a489.md.
NVIDIA hat ASPIRE V1.0 veröffentlicht, ein Robotik-Framework, das Ausführungsfehler als Grundlage für den nächsten Versuch nutzt. Ein Coding...
NVIDIA hat ASPIRE V1.0 veröffentlicht, ein Robotik-Framework, das Ausführungsfehler als Grundlage für den nächsten Versuch nutzt. Ein Coding-Agent schreibt ein Steuerungsprogramm für den Roboter, führt es aus, prüft das Ergebnis und korrigiert den Code. Erfolgreiche Korrekturen können anschließend als wiederverwendbare Einträge in einer Skill-Bibliothek gespeichert werden.
ASPIRE steht für Agentic Skill Programming through Iterative Robot Exploration. Die zentrale Idee ist, dass sich Erfahrungen als abrufbares operatives Wissen ansammeln können, statt jede Verbesserung in neu trainierte Modellgewichte einarbeiten zu müssen.
Die Veröffentlichung unterstreicht außerdem, wie wichtig das zugrunde liegende Reasoning-Modell ist. QbitAI berichtet von einer deutlichen Verbesserung, nachdem das Team GPT-6 Astra eingebunden hatte. Die aktuellen Materialien von NVIDIA zeigen starke Ergebnisse mit mehreren Spitzenmodellen, während Ausführungs-Engine und Skill-Mechanismus unverändert bleiben.
Ein fehlgeschlagener Greifversuch verrät für sich genommen nicht, woran es lag. Möglicherweise wurde das Objekt falsch lokalisiert, ein Greifkandidat ist ungeeignet, der Arm kann das Ziel nicht erreichen oder die geplante Bewegung kollidiert mit der Umgebung.
Die Ausführungs-Engine von ASPIRE zeichnet Belege für Wahrnehmungs-, Planungs-, Greif- und Steuerungsaufrufe auf. Dazu gehören Beobachtungen, Eingaben und Ausgaben sowie, sofern verfügbar, visuelle Belege. Der Agent kann den relevanten Teil dieser multimodalen Ablaufspur prüfen, statt den abschließenden Fehlschlag als einziges Feedback zu behandeln.
Der Arbeitsablauf ist einfach:
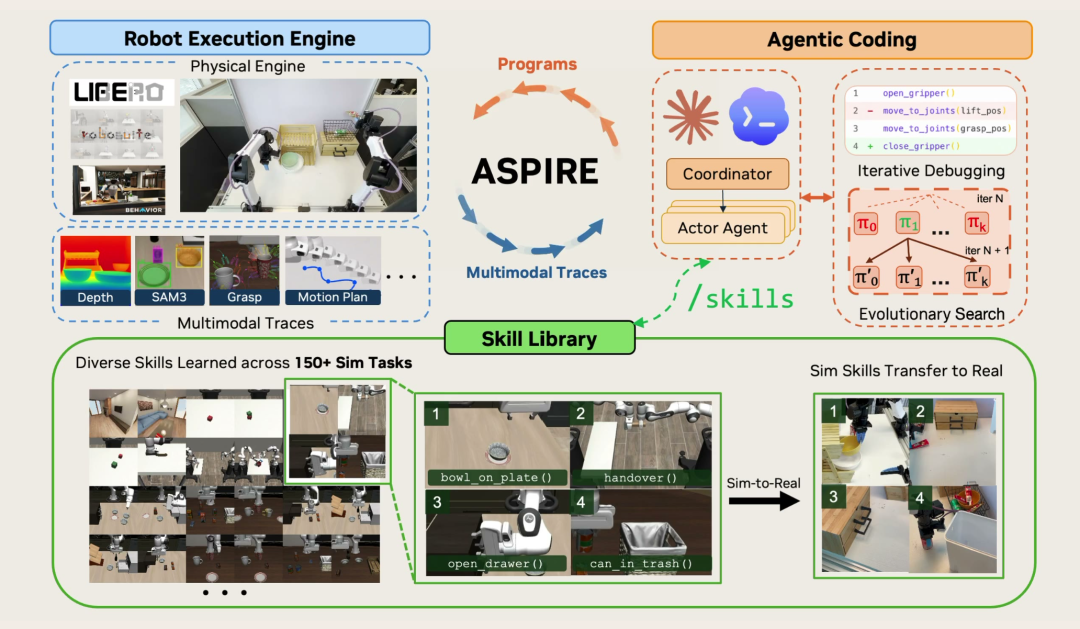
Diagramm der ASPIRE-Methode, dem Forschungsteam zugeschrieben und im ursprünglichen Bericht wiedergegeben.
Das Framework untersucht außerdem alternative Programme mithilfe evolutionärer Suche. Anstatt einen einzigen fehlgeschlagenen Ansatz immer wieder anzupassen, können Agenten verschiedene Abfolgen, Planer oder Greifstrategien untersuchen und anschließend diejenigen Ansätze beibehalten, die Ausführungsprüfungen bestehen.
Bei einem niedrig liegenden Objekt kann es beispielsweise erforderlich sein, die Position des Roboters zu ändern, den Arm zu wechseln oder einen anderen Bewegungsplaner auszuprobieren. Das nützliche Ergebnis ist sowohl ein korrigiertes Programm als auch eine Erklärung dazu, wann diese Korrektur anzuwenden ist.
Eine einmalige Korrektur hilft bei einer einzelnen Aufgabe. Ein abrufbarer Skill kann bei späteren Aufgaben mit derselben zugrunde liegenden Schwierigkeit helfen.
ASPIRE verdichtet validierte Korrekturen zu textbasiertem Roboterwissen. Bei einer künftigen Aufgabe ruft der Agent relevante Einträge ab und nutzt sie beim Erstellen eines neuen Programms als In-Context-Anleitung. Das ist etwas anderes, als einfach eine alte Trajektorie mit festen Koordinaten erneut abzuspielen.
Der Quelle zufolge umfasst die dargestellte Bibliothek mehr als 90 Skills, die über 150 Aufgaben in 18 Kategorien abdecken. Dazu gehören Wahrnehmung, Greifen, Navigation, Objektsuche, beidhändige Manipulation und Wiederherstellung nach Fehlern. NVIDIA beschreibt den öffentlichen Explorer als repräsentative Auswahl, nicht als vollständiges Verzeichnis.
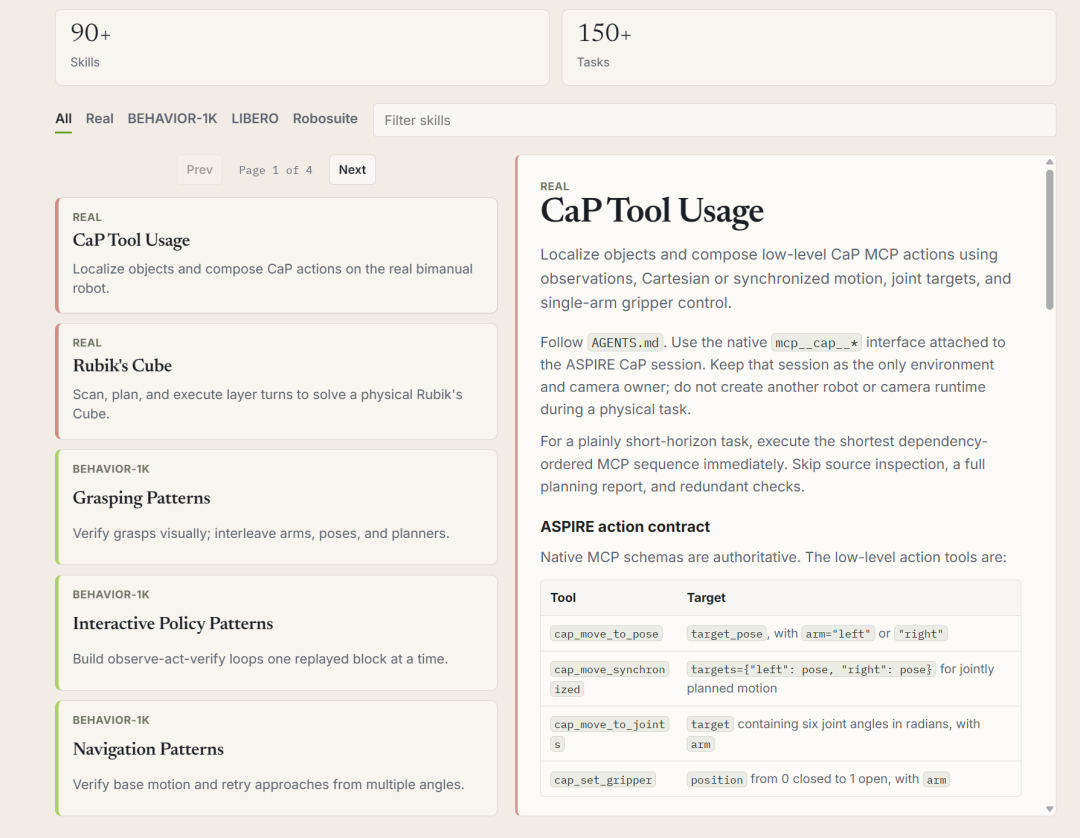
Benutzeroberfläche der Skill-Bibliothek, wie im ursprünglichen Bericht gezeigt.
Das Projekt berichtet von 31 % Zero-Shot-Erfolg bei repräsentativen, zuvor ungesehenen Aufgaben mit langem Planungshorizont, verglichen mit 4 % bei früheren Methoden, die umfangreiches Reasoning zur Testzeit und wiederholte Versuche nutzten. Dieses Ergebnis gilt für ein bestimmtes Evaluations-Setup und ist keine allgemeingültige Erfolgsquote für neue Haushaltsaufgaben.
Die Forschenden berichten außerdem von ersten Übertragungen zwischen verschiedenen Roboterkörpern, von der Simulation auf reale Roboter. Der Abruf eines passenden, in der Simulation entdeckten Skills verringerte die Zahl der benötigten Tokens, bis ein erstes erfolgreiches Programm für einen realen Roboter erreicht wurde, und verbesserte die Erfolgsquote dieses Programms bei zurückgehaltenen Aufgaben. Damit ist nicht belegt, dass jeder simulierte Skill unverändert auf jeden Roboter oder jede API übertragbar ist.
Im ursprünglichen Bericht wird beschrieben, dass das Team sein früheres Backend Claude Opus 4.6 durch GPT-6 Astra ersetzte und dabei einen deutlichen Sprung bei den Simulationsergebnissen beobachtete. Auch Jim Fans Ankündigung zufolge übertraf Claude Opus 5.5 Astra leicht, während Sonnet 5.5 ein günstiges Verhältnis zwischen Kosten und Fähigkeiten bot – in diesem Vergleich zu etwa 12 US-Dollar pro Aufgabe.
Die aktuelle offizielle Projektseite nennt folgende zentrale Ergebnisse mit Claude Opus 5.5:
| Evaluation | Vom Projekt berichtetes Ergebnis | Umfang |
|---|---|---|
| LIBERO-Pro | 99 % durchschnittliche Erfolgsquote | Alle 80 getesteten Aufgaben |
| Robosuite | 100 % Erfolg bei repräsentativen Aufgaben | Ausgewählte Aufgaben, nicht die gesamte Suite |
| BEHAVIOR-1K | 100 % Erfolg bei repräsentativen Aufgaben | Ausgewählte Aufgaben, nicht alle 1.000 Aktivitäten |
Die Quelle nennt sieben repräsentative Robosuite-Aufgaben und zwei repräsentative BEHAVIOR-1K-Aufgaben. Diese Bezugsgrößen sind wichtig: Das Ergebnis sollte nicht so dargestellt werden, als löse ASPIRE alle Aufgaben von BEHAVIOR-1K.
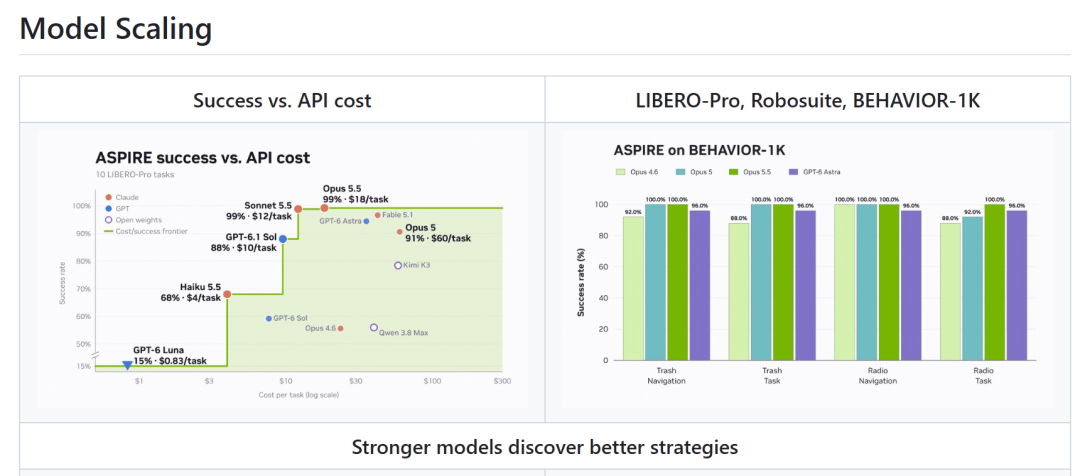
Vergleich zur Modellskalierung aus dem ASPIRE-Projekt, wie im Bericht dargestellt.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Ein separates Experiment zur Modellskalierung im Repository evaluiert 10 LIBERO-Pro-Aufgaben und berichtet je nach Modell Erfolgsquoten zwischen 15 % und 99 %. Dieses Experiment darf nicht mit dem Ergebnis für den vollständigen Satz aus 80 Aufgaben verwechselt werden.
Der praktische Punkt ist, dass Wahrnehmungs-Tools, Steuerungsschnittstellen und angesammelte Skills auch dann nützlich bleiben können, wenn sich das Modell ändert. Das Projekt beschreibt dies als eine robotikspezifische Ausprägung des umfassenderen Musters, bei dem leistungsfähigeres allgemeines Reasoning ein bestehendes Agentensystem verbessert.
Das öffentliche Repository enthält Code, Konfigurationen, Agenten-Skills und Runbooks zur Reproduktion der Experimente. Von NVIDIA bereitgestelltes Material und Projektbeiträge stehen unter Apache 2.0 zur Verfügung; für Komponenten Dritter gelten weiterhin deren jeweilige Bedingungen.
Das Repository unterscheidet zwischen Simulationsexperimenten und dem Betrieb realer Roboter. Für die Simulationsumgebung sind Vorbereitungen auf dem Host erforderlich, darunter CUDA, uv und Zugriff auf zugangsbeschränkte SAM3-Gewichte. Zur Reproduktion eines Experiments müssen außerdem Suite, Aufgabensatz, Seed-Plan und Ausgabepfade ausgewählt werden. Ein einzelner allgemeiner Befehl reproduziert nicht automatisch jedes veröffentlichte Ergebnis.
Wichtig: Laut README hat der generierte Python-Code uneingeschränkten Importzugriff; Testprozesse und Watchdogs bilden keine Sicherheits-Sandbox. Die offiziellen Hinweise empfehlen einen isolierten Host sowie separate Autorisierungs- und Kontrollmaßnahmen für physische Hardware. Ein erfolgreicher Simulationslauf reicht nicht als Vorbereitung für einen unbeaufsichtigten Betrieb in der realen Welt aus.
Das Projekt nennt außerdem ungelöste Einschränkungen: zuverlässige Erfolgserkennung, sichere Rücksetzungen, Sicherheitsüberwachung, Kalibrierung, eine feste Primitive-API, kostspielige Suche und eine noch unvollständige Verwaltung des langfristigen Skill-Gedächtnisses. Einträge in der Bibliothek können veralten oder mit wachsender Sammlung zu spezifisch werden.
Der Bericht endet mit einer separaten Entwicklung von World Labs. Der offizielle Beitrag bestätigt, dass der Beta-Zugang für Atlas schrittweise freigeschaltet wird. Die Demonstration konzentriert sich auf die präzise Steuerung von Kamerafahrten.
QbitAI berichtet darüber hinaus von Ausgaben mit einer Dauer von einer Minute und einer Auflösung von 1440p, Rekonstruktion aus Bildern oder Smartphone-Videos, Punktwolken- und Gaussian-Splat-Ausgaben sowie RGB-/Tiefensimulation für die Robotik. Diese detaillierten Spezifikationen wurden durch den kurzen offiziellen Beitrag, der für diesen Artikel verfügbar war, nicht unabhängig bestätigt.
Die Generierung von Umgebungen und das Erlernen von Roboter-Skills könnten sich als Forschungsrichtungen ergänzen. Die hier geprüften Quellen kündigen keine Integration von ASPIRE und Atlas an. Diese Kombination bleibt daher eine im Bericht angedeutete Möglichkeit und ist kein veröffentlichter Arbeitsablauf.
ASPIRE ist ein Robotik-Framework, in dem Coding-Agenten Steuerungsprogramme für Roboter schreiben, ausführen und debuggen. Validierte Erkenntnisse werden als wiederverwendbare Skills für spätere Aufgaben gespeichert.
Das Projekt setzt auf die Verfeinerung von Skills und angesammeltes operatives Wissen statt auf Gradienten-Updates des zugrunde liegenden Modells. Ein eingefrorenes Spitzenmodell kann diese Skills abrufen und beim Schreiben neuer Programme nutzen.
Nein. Das berichtete Ergebnis von 100 % bezieht sich auf ausgewählte repräsentative BEHAVIOR-1K-Aufgaben, nicht auf die gesamte Sammlung von Aktivitäten. Die Angabe von 99 % für LIBERO-Pro hat einen anderen Umfang: 80 getestete Aufgaben.
Das Projekt evaluiert mehrere Spitzenmodelle und beschreibt das Framework als unabhängig vom jeweiligen Coding-Agenten. Erfolg und Kosten hängen weiterhin vom Modell, der Aufgabe und der Experimentkonfiguration ab; Kompatibilität allein garantiert keine gleichwertigen Ergebnisse.
Die Forschenden berichten von ersten Hinweisen darauf, dass ausgewählte, in der Simulation entdeckte Skills den Debugging-Aufwand bei realen Robotern mit unterschiedlichen Bauformen und APIs verringern. Für den physischen Betrieb sind weiterhin Kalibrierung, Überwachung, sichere Rücksetzungen und die Überprüfung der Ergebnisse erforderlich.
Das offizielle Projekt erklärt ausdrücklich, dass ASPIRE noch kein vollständig autonomes Lernsystem für die reale Welt ist. Auch das README unterscheidet zwischen der Nutzung in Simulationen und den erforderlichen Bedienerkontrollen für reale Hardware.
ASPIRE verbindet Ablaufspuren von Roboterausführungen mit einem Coding- und Debugging-Zyklus und speichert anschließend validierte Korrekturen als wiederverwendbares Wissen. Mit Code, Runbooks und einem Skill-Explorer macht die Veröffentlichung diesen Arbeitsablauf nachvollziehbar.
Die Ergebnisse zeigen eine vielversprechende Modellskalierung und erste Übertragungen von Skills, zugleich gelten wichtige Einschränkungen hinsichtlich der Benchmark-Abdeckung und des Einsatzes in der realen Welt. Der wiederverwendbare Skill-Zyklus ist der zentrale Beitrag; nahezu perfekte Ergebnisse bei ausgewählten Benchmarks machen kontrollierte Tests in der realen Welt nicht überflüssig.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



