For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/nvidia-vera-rubin-at-ocp-2026-mgx-1-2-dsx-6b3d7f12.md.
Während AI Factories von Megawatt- zu Infrastruktur im Gigawatt-Maßstab wachsen, besteht die Herausforderung nicht mehr nur darin, schneller...
Während AI Factories von Megawatt- zu Infrastruktur im Gigawatt-Maßstab wachsen, besteht die Herausforderung nicht mehr nur darin, schnellere Beschleuniger in einem Rechenzentrum einzusetzen. Stromversorgung, Flüssigkeitskühlung, Networking, Wartbarkeit, Netzverhalten und interoperable Rack-Designs müssen gemeinsam skalieren.
Auf dem Open Compute Project Global Summit 2026 in San Jose kündigte NVIDIA eine Reihe von Partnerschaften, offenen Spezifikationen und Softwarebeiträgen an, die eine einheitlichere Grundlage für KI-Infrastruktur der nächsten Generation schaffen sollen.
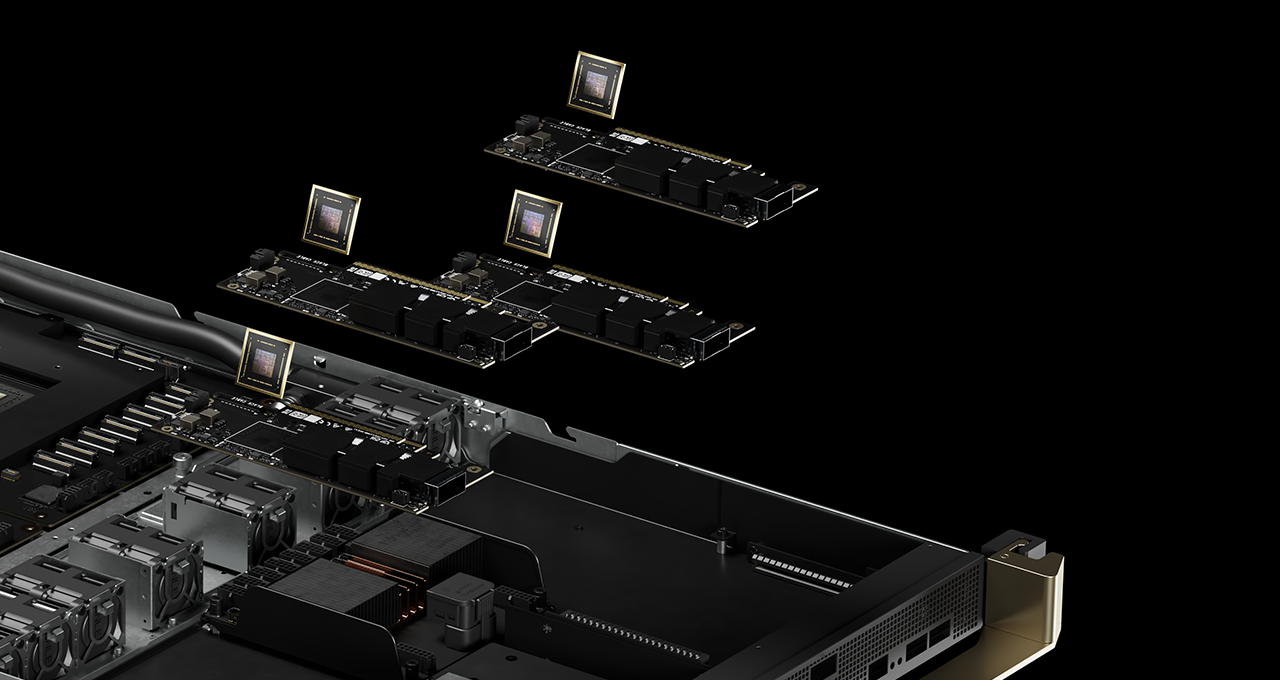
Im Mittelpunkt steht NVIDIA Vera Rubin. NVIDIA brachte zentrale Rack- und Compute-Tray-Designs für Vera Rubin über die offene Architektur NVIDIA MGX in OCP ein. Dadurch können Systemhersteller und Infrastrukturpartner mit einem gemeinsamen Referenzdesign arbeiten, anstatt jede Ebene unabhängig aufzubauen.
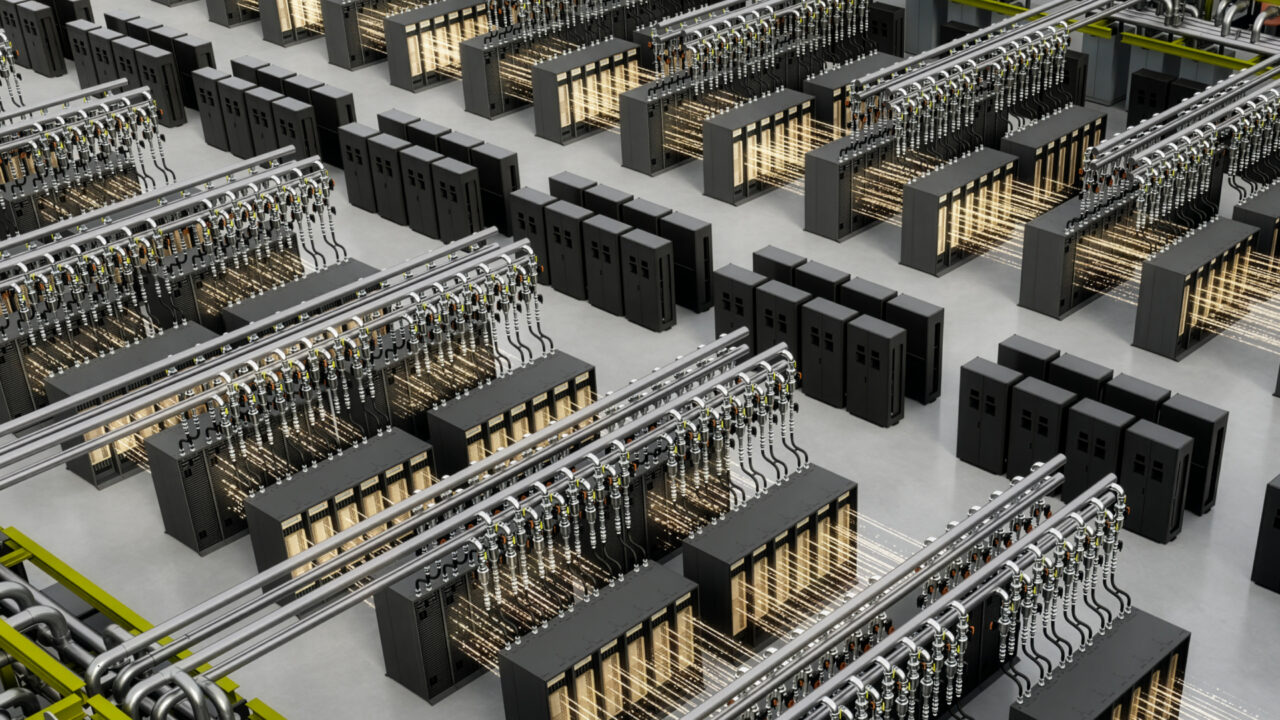
Die Ankündigungen umfassen drei miteinander verbundene Ebenen der AI Factory:
Das Ergebnis ist ein breiterer Vorstoß hin zu offener, wiederholbarer Infrastruktur, die Partner weltweit herstellen, bereitstellen und warten können.
Auf dem OCP Global Summit 2026 kündigten NVIDIA und seine Ökosystempartner mehrere Infrastrukturinitiativen rund um Vera Rubin an.
Zu den wichtigsten Ankündigungen gehören:
Auf der Veranstaltung bezeichnete Ian Buck, Vice President für Hyperscale und High-Performance Computing bei NVIDIA, offene Infrastruktur als einen zunehmend wichtigen Faktor für die weltweite Skalierung von AI Factories.
Das gemeinsame Thema aller Ankündigungen ist Co-Design. Compute, Networking, Stromversorgung, Kühlung und Software werden als Teile eines Gesamtsystems betrachtet und nicht als isolierte Ebenen.
NVIDIA schloss sich weiteren Branchenteilnehmern an und brachte über die Open DC Initiative von OCP die Referenzarchitektur für KI-Rechenzentren der dritten Generation MGX ein.
Die aktualisierte Spezifikation MGX 1.2 erweitert die Architektur für leistungsstärkere, flüssigkeitsgekühlte AI Factories.
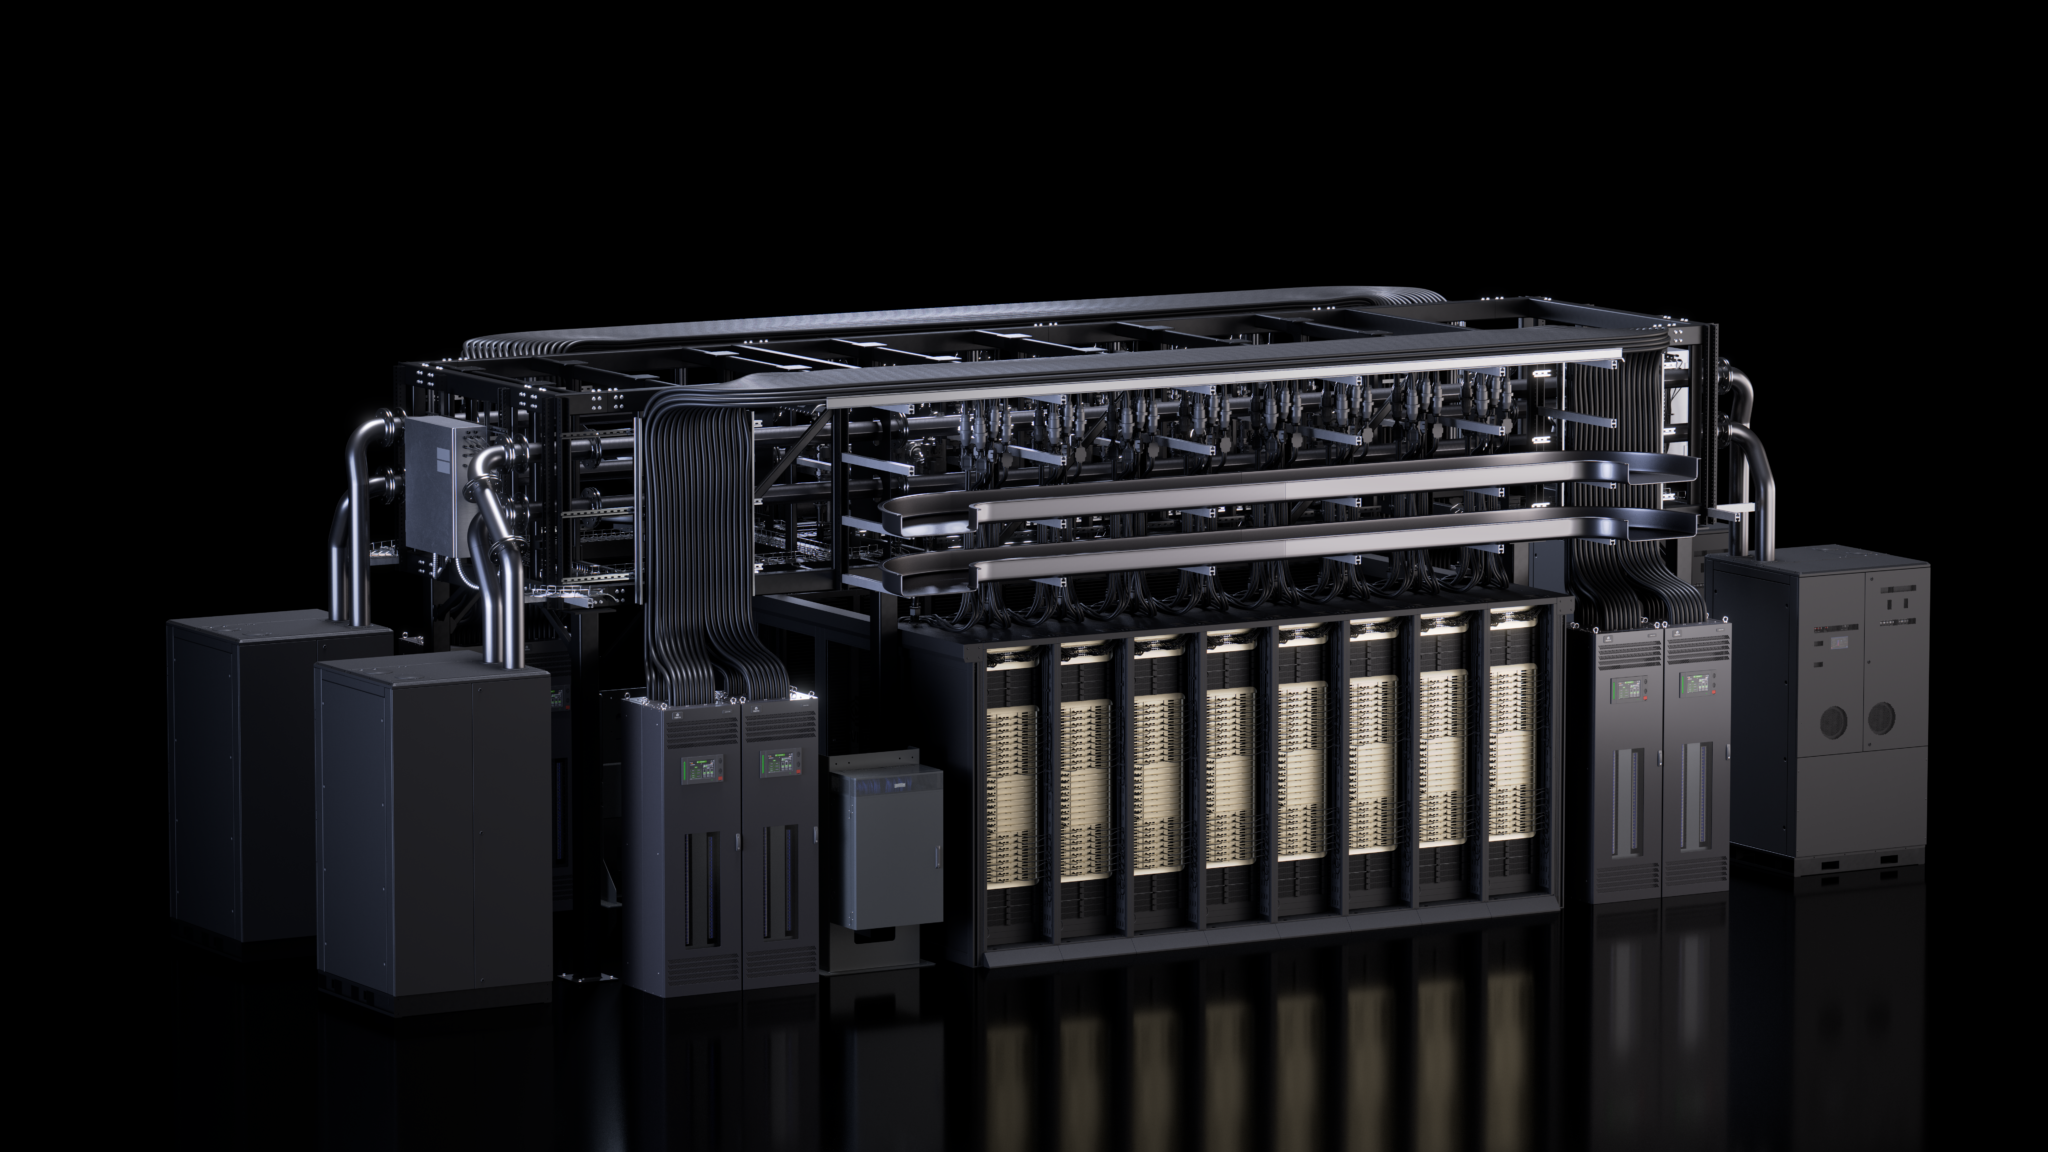
Zu den wichtigsten Ergänzungen gehören:
NVIDIA zufolge kann die Architektur Rack-Bereitstellungen von bis zu 250 kW unterstützen und zugleich Wartbarkeit sowie Wiederverwendung der Infrastruktur verbessern.
MGX ist eine modulare Referenzarchitektur und kein einzelnes festes Serverdesign.
Dadurch erhalten OEMs, ODMs und Infrastrukturpartner eine gemeinsame mechanische, elektrische und kühlungstechnische Grundlage, während sie weiterhin unterschiedliche Kombinationen aus CPUs, GPUs, Netzwerkkomponenten und Speicher einsetzen können.
Für Vera Rubin bedeutet das, dass Partner auf Basis eines bekannten Rack-Designs bauen können, anstatt jedes Mal mit einer proprietären Plattform neu zu beginnen.
Die Plattform Vera Rubin NVL72 kombiniert:
Sie kann anschließend über NVIDIA Quantum-X800 InfiniBand oder Spectrum-X Ethernet horizontal skaliert werden.
NVIDIA überträgt dieselben MGX-Designprinzipien auch auf ein dediziertes Vera-CPU-Rack.
Während Vera Rubin NVL72 für großskaliges Training und Inferenz ausgelegt ist, richtet sich das Vera-CPU-Rack an CPU-intensive Agenten-Workloads wie:
Die übergeordnete Idee besteht darin, die physische Infrastruktur konsistent zu halten, auch wenn unterschiedliche Teile eines KI-Workloads verschiedene Compute-Ressourcen erfordern.
Die Plattform DSX AI Factory von NVIDIA soll Compute, Networking, Stromversorgung, Kühlung, Anlagen und Software als ein optimiertes Gesamtsystem koordinieren.
Im Zentrum der Softwareebene steht DSX OS, das NVIDIA als offene Betriebsebene für wiederholbare Abläufe in AI Factories beschreibt.
Auf der OCP erweiterte NVIDIA DSX OS um vier Open-Source-Komponenten.
NVIDIA Config Manager automatisiert die Switch-Konfiguration im großen Maßstab.
Er soll Betreibern dabei helfen, konsistente Netzwerk-Fabrics mit möglichst wenig manueller Konfiguration bereitzustellen, zu validieren und zu warten.
NVIDIA Cluster Readiness Engine führt Belastungstests von GPU-Clustern mit Workload-Simulationen durch, bevor produktives Training beginnt.
Ziel ist es, Hardware- oder Infrastrukturprobleme früh genug zu erkennen, um kostspielige Ausfälle von Trainingsjobs zu vermeiden.
NVIDIA Rack Management Service stellt eine Hardware-Abstraktion und Betriebsebene auf Rack-Ebene bereit.
Anstatt jeden Server unabhängig zu behandeln, behandelt die Software Racks als primäre Betriebseinheiten für Firmware-Management und großskalige Infrastruktursteuerung.
Cluster API Provider für NVIDIA Infrastructure Controller soll die Bare-Metal-Bereitstellung und das Onboarding von Mandanten beschleunigen.
NVIDIA zufolge besteht das Ziel darin, rohe KI-Hardware innerhalb von Stunden statt Tagen in produktionsreife Cluster zu verwandeln.
Diese Komponenten wurden aus den Erfahrungen von NVIDIA beim Betrieb von DGX Cloud entwickelt und sollen Funktionen von AI Factories leichter in Multi-Tenant-Cloud-Plattformen integrierbar machen.
Große KI-Installationen benötigen mehr als ein gemeinsames Rack-Design. Auch Anlagen, Kühlsysteme, Stromarchitektur und das Verhalten gegenüber dem öffentlichen Stromnetz benötigen gemeinsame Erwartungen.
Auf der OCP schloss sich NVIDIA mit AMD, Google und Meta zusammen, um eine aktualisierte offene Rechenzentrumsspezifikation für KI-Infrastruktur der nächsten Generation zu veröffentlichen.
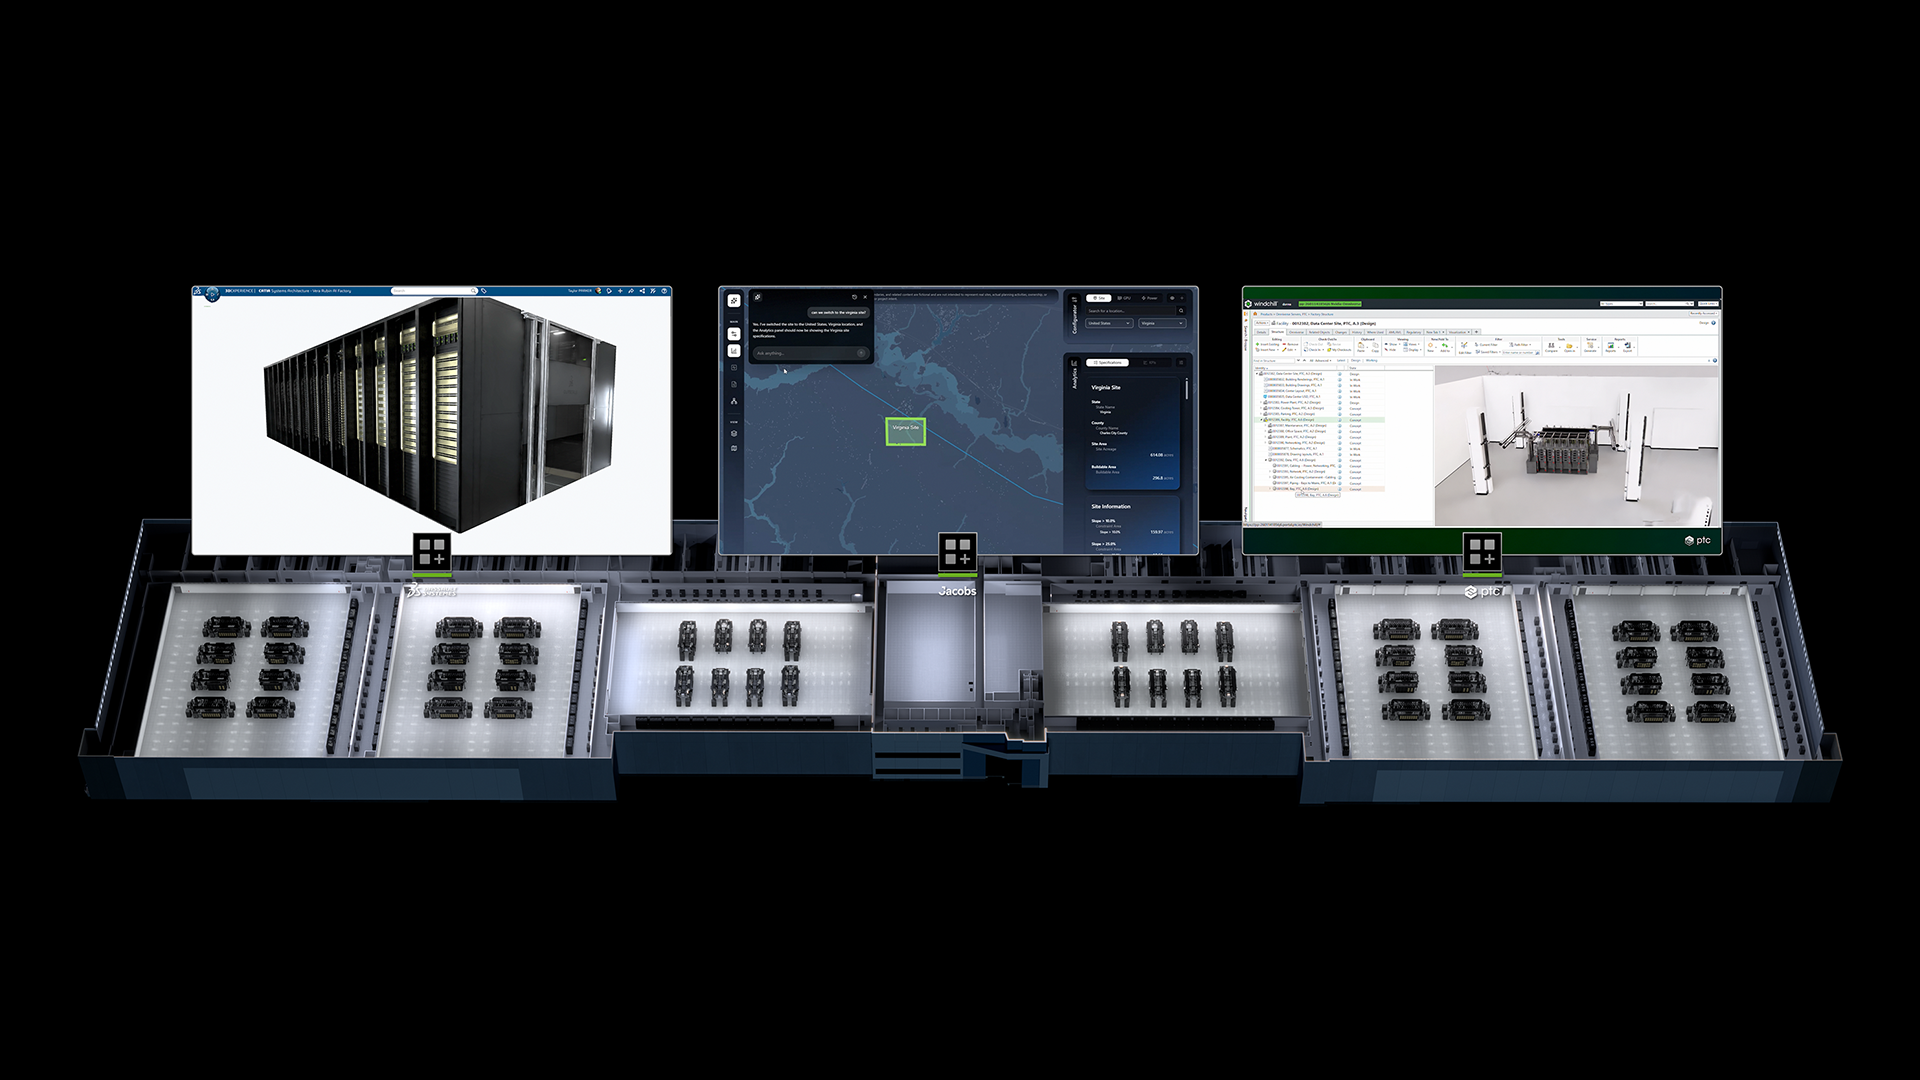
Die Open Data Center Specification v0.7 definiert einen gemeinsamen Bauplan für das Anlagendesign von AI Factories.
Sie behandelt unter anderem:
Zweck ist es, Herstellern, Colocation-Anbietern und Betreibern ein gemeinsames Ziel zu geben, anstatt sie auf eine jeweils separate proprietäre Spezifikation jedes Kunden warten zu lassen.
Google, Meta, Microsoft und NVIDIA veröffentlichten außerdem die OCP Grid Resilience Specification.
Diese Spezifikation definiert, wie sehr große KI-Infrastruktur bei Störungen im öffentlichen Stromnetz reagieren sollte.
Das Designziel besteht darin, dass KI-Anlagen:
Dies wird immer wichtiger, da AI Factories groß genug werden, dass abrupte Änderungen ihrer Leistungsaufnahme das umliegende Stromnetz beeinflussen können.
NVIDIA erklärt, dass seine DSX-Referenzdesigns einen umsetzbaren Weg von diesen offenen Standards zu realer Infrastruktur für AI Factories bieten.
Die Leistungsdichte wird zu einer der größten Einschränkungen beim Design von AI Factories.
Mit dem Wachstum von Trainings-, Inferenz- und Reasoning-Clustern erfordert die herkömmliche Niederspannungsverteilung immer mehr Kupfer, Verkabelung und Umwandlungshardware.
Auf der OCP stellte Visionbay.ai Pläne für K-1 vor, eine AI-Factory-Plattform auf Basis einer 800-VDC-Architektur, die mit Blick auf zukünftige Vera-Rubin-Bereitstellungen entworfen wurde.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
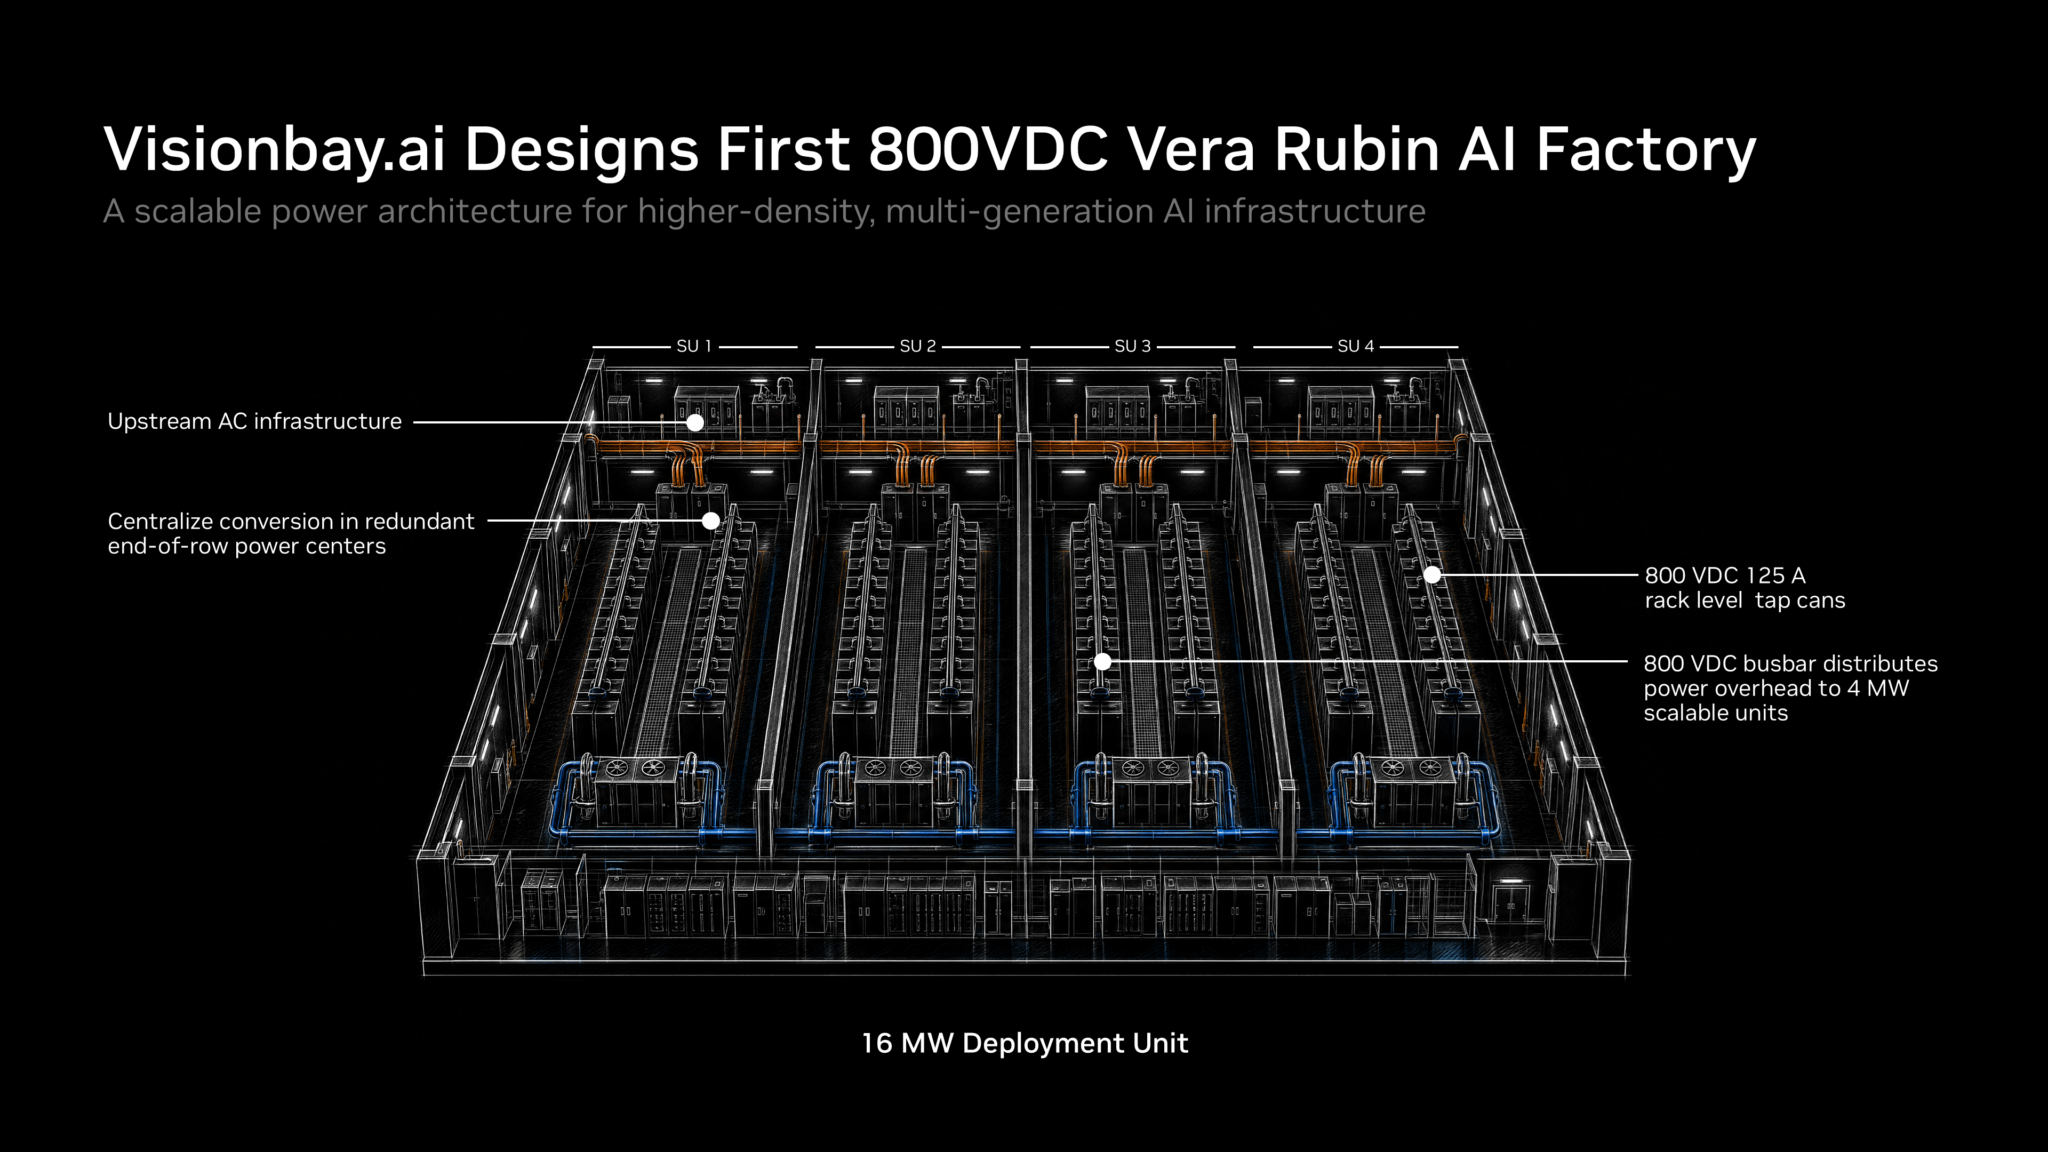
Das Design kombiniert die 800-VDC-Referenzarchitektur von NVIDIA mit Energie- und Wärmetechnologien von Vertiv.
Die Architektur soll Hochspannungs-Gleichstromverteilung näher an die Compute-Ebene bringen.
Anstatt Niederspannungsstrom wiederholt umzuwandeln und über große Mengen an Kupfer zu verteilen, verwendet K-1 Stromzentren auf Cluster-Ebene. Diese zentralisieren die AC-zu-DC-Umwandlung und verteilen anschließend 800 VDC näher an die Racks.
NVIDIA zufolge kann dieser Ansatz:
Die Plattform ist außerdem für eine schrittweise Einführung ausgelegt, statt eine vollständige Umstellung einer gesamten Anlage auf 800 VDC auf einmal zu verlangen.
Dadurch erhalten Betreiber einen Weg, Hochspannungs-Gleichstrom dort einzuführen, wo er den größten Nutzen bietet, und gleichzeitig die Kompatibilität mit bestehender Infrastruktur zu bewahren.
Auf der OCP kündigten Meta und NVIDIA einen weiteren Schritt ihrer Networking-Zusammenarbeit an.
Meta übernimmt NVIDIA Spectrum-6 Ethernet-Switches mit 102,4 Tb/s für größere Vera-Rubin-AI-Factories, die auf offener Netzwerkinfrastruktur laufen.
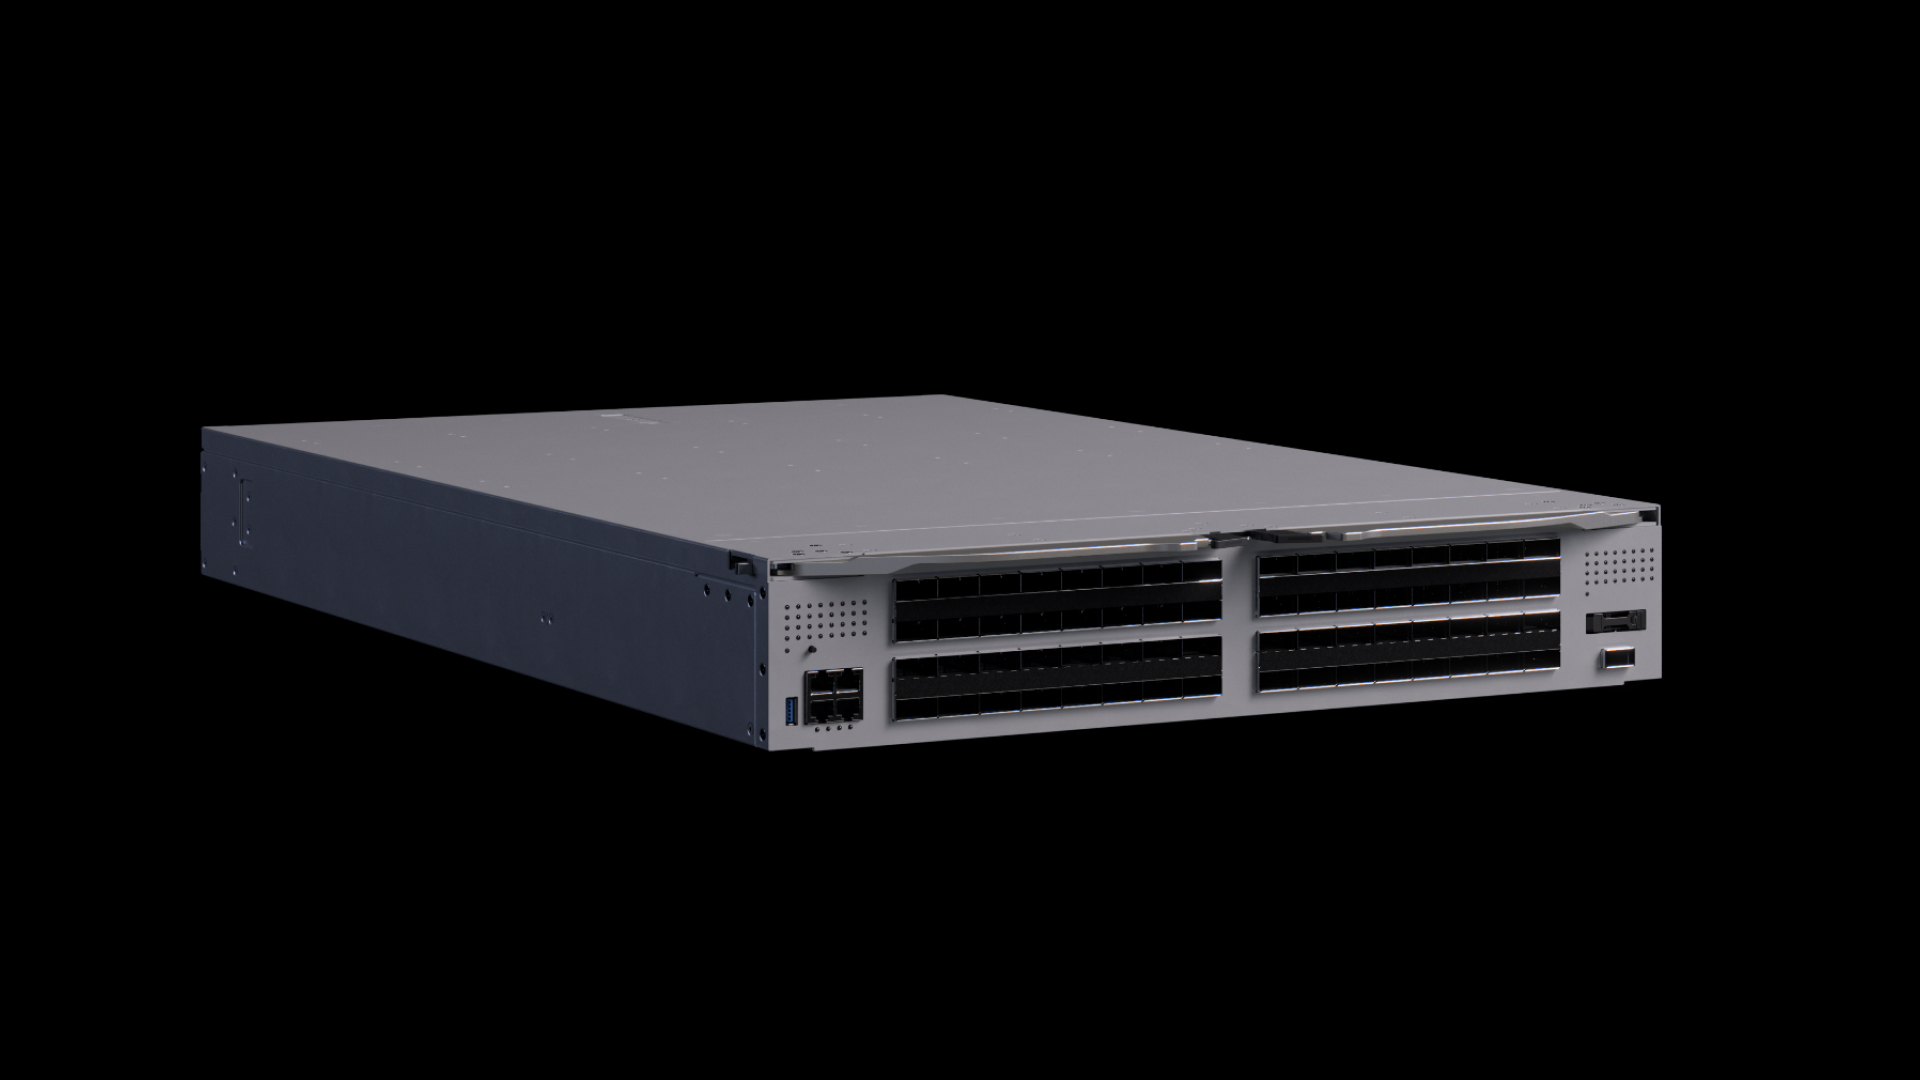
Spectrum-6 bietet:
Metas Spectrum-6-basierter Switch heißt N-IceCube.
Er wurde für die Integration in IcePack, Metas flüssigkeitsgekühltes 100T-Netzwerk-Rack, entwickelt.
N-IceCube nutzt FBOSS, das Open-Source-Netzwerkbetriebssystem von Meta.
FBOSS verwendet das Switch Abstraction Interface (SAI), einen OCP-Standard, der eine herstellerunabhängige Schnittstelle zur Steuerung von Switch-Hardware bereitstellt.
So kann Meta eine vertraute Software-Steuerebene nutzen und gleichzeitig Switching-Silizium von Spectrum-6 einsetzen.
Ein wesentlicher Teil der Zusammenarbeit ist die Technologie Spectrum-X Multiplane.
Mithilfe von Spectrum-6-Switches und ConnectX-9 SuperNICs verteilt Multiplane GPU-Datenverkehr hardwareseitig über bis zu acht unabhängige Netzwerkebenen.
Das Design soll AI Factories mit mehr als 100.000 GPUs unterstützen und gleichzeitig die Anzahl benötigter Switch-Ebenen reduzieren.
Mehrere Pfade erhöhen auch die Resilienz.
Fällt eine Netzwerkkomponente aus, kann der Datenverkehr auf die verbleibenden Ebenen wechseln. Der Workload kann mit reduzierter Bandbreite weiterlaufen, anstatt dass die gesamte Fabric ausfällt.
Das Ergebnis ist eine Netzwerkarchitektur, die sowohl hochgradig skalierbar als auch unter realen Produktionsbedingungen leichter zu betreiben sein soll.
Mit dem Wachstum von KI-Clustern wird die physische optische Verbindung selbst zu einem begrenzenden Faktor.
NVIDIA und Cisco kündigten Pläne für Ultra-Dense Small Form Factor Pluggable (USFP) an, ein neues steckbares optisches Transceiver-Modul für KI-Networking der nächsten Generation.
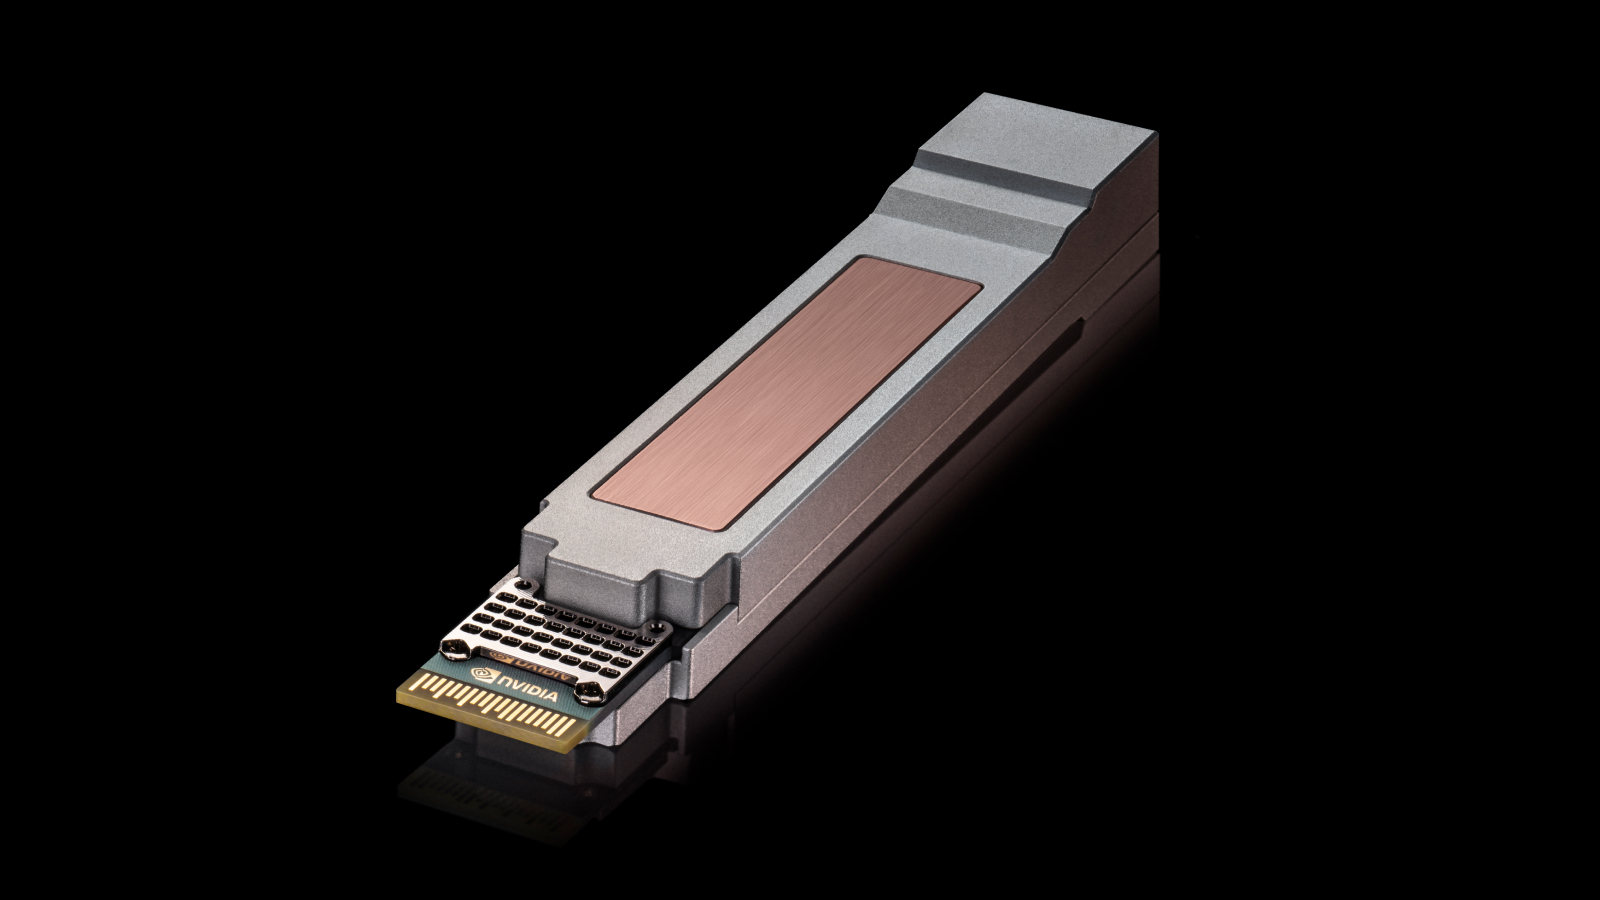
USFP soll einen Weg zu Networking mit 400 Gb/s pro Lane bieten und dabei ungefähr dieselbe Grundfläche wie der weit verbreitete OSFP-Formfaktor mit 200 Gb/s pro Lane beibehalten.
Das geplante Design umfasst:
Ziel ist es, mehr Compute-Ressourcen zu verbinden, ohne zusätzliche Netzwerkebenen hinzuzufügen, die Latenz, Stromverbrauch und betriebliche Komplexität erhöhen.
NVIDIA und Cisco arbeiten mit TE Connectivity und Amphenol an Käfigen, Steckverbindern und Modulen und planen, USFP über eine gemeinschaftlich geführte Initiative mit mehreren Bezugsquellen weiterzuentwickeln.
Dadurch bleibt das Design im Einklang mit dem breiteren OCP-Thema der Interoperabilität, statt ein optisches Ökosystem eines einzelnen Anbieters zu schaffen.
NVIDIA und Google kündigten außerdem an, dass Falcon Transport auf zukünftigen NVIDIA ConnectX-10 SuperNICs und BlueField DPUs unterstützt werden soll.
Falcon ist ein Transportprotokoll von Google für zuverlässige, leistungsstarke Kommunikation über Ethernet-Netzwerke, insbesondere bei Überlastung.
Es unterstützt unter anderem:
Die Zusammenarbeit kombiniert NVIDIA-Hardwarebeschleunigung mit der Software DOCA, um Falcon zu implementieren und gleichzeitig standardisierte RDMA-Programmierschnittstellen für Anwendungen verfügbar zu halten.
Das ist wichtig, weil NVIDIA- und Google-Netzwerkhardware dadurch eine gemeinsame Transportebene erhalten, während Software weiterhin vertraute RDMA-APIs verwenden kann.
In großen KI-Fabrics kann Falcon Datenverkehr über mehrere Pfade verteilen, sich an Überlastung anpassen und Paketverluste wiederherstellen, ohne dass Anwendungen diese Details direkt verwalten müssen.
NVIDIA brachte zentrale Vera-Rubin-Rack- und Compute-Tray-Designs über die offene MGX-Architektur in OCP ein und beteiligte sich an neuen Standards für Anlagen, Stromnetze und Networking. Außerdem veröffentlichte das Unternehmen vier neue Open-Source-Infrastrukturkomponenten für DSX OS.
MGX 1.2 ist eine aktualisierte Referenzarchitektur auf Rack-Ebene für hochdichtes beschleunigtes Computing. Sie ergänzt Blind-Mate-Flüssigkeitskühlung, eine 5.000-A-Busbar, native 19-Zoll-Unterstützung, konfigurierbare I/O-Schächte und Unterstützung für Racks mit bis zu 250 kW.
Die neu hervorgehobenen Komponenten sind NVIDIA Config Manager, Cluster Readiness Engine, Rack Management Service und Cluster API Provider für NVIDIA Infrastructure Controller. Sie decken Netzwerkkonfiguration, Cluster-Gesundheitstests, Betrieb auf Rack-Ebene und Bare-Metal-Bereitstellung ab.
Höhere Gleichspannungsverteilung kann den Bedarf an Kupfer, Verkabelung und Umwandlungsgeräten verringern, wenn die Rack-Leistung steigt. Das NVIDIA-Design soll künftige AI Racks im Megawatt-Bereich unterstützen und zugleich eine schrittweise Einführung in bestehenden Anlagen ermöglichen.
Spectrum-6 ist NVIDIAs Ethernet-Switch-Plattform mit 102,4 Tb/s für AI Factories. Sie bietet Networking mit 200 Gb/s pro Lane und wird von Meta als Teil seiner N-IceCube- und Spectrum-X-Multiplane-Architektur eingesetzt.
USFP ist ein neuer Formfaktor für steckbare optische Module, der von NVIDIA und Cisco für Networking mit 400 Gb/s pro Lane entwickelt wird. Er soll die Bandbreitendichte und Energieeffizienz steigern und zugleich die Wartbarkeit steckbarer Optik erhalten.
Falcon ist Googles leistungsstarkes Ethernet-Transportprotokoll. Zukünftige ConnectX-10 SuperNICs und BlueField DPUs sollen es über NVIDIA-Hardwarebeschleunigung und DOCA-Software unterstützen und dabei RDMA-Programmierschnittstellen erhalten.
Ja. NVIDIA kündigte im Mai 2026 an, dass Vera Rubin mit globalen System- und Lieferkettenpartnern in die vollständige Produktion hochgefahren werde und Systeme im großen Maßstab gefertigt würden.
Auf dem OCP Global Summit 2026 entwickelte NVIDIA Vera Rubin von einer Compute-Plattform zu einem offeneren Infrastruktur-Bauplan weiter. MGX 1.2 standardisiert weitere Teile des Rack-, Kühlungs- und Stromdesigns, während DSX OS Open-Source-Tools für die Konfiguration, Validierung und den Betrieb großer KI-Cluster ergänzt.
Das umgebende Ökosystem bewegt sich in dieselbe Richtung. Neue OCP-Spezifikationen für Anlagen und Stromnetze definieren, wie große AI Factories gebaut werden und wie sie sich bei Stromstörungen verhalten sollen. Das 800-VDC-Design von Visionbay adressiert die steigende Rack-Dichte, während Meta, Cisco und Google den Networking-Stack durch Spectrum-6, USFP und Falcon Transport erweitern.
Das zentrale Thema ist Interoperabilität: Vera Rubin entwickelt sich nicht nur zu einer GPU-Plattform, sondern zu einer gemeinsamen Referenzarchitektur für Compute, Networking, Stromversorgung, Kühlung und Betrieb.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



