For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/openai-28-day-sprint-day-1-gpt-6-speed-bo-37dfc44c.md.
OpenAI begann den Oktober mit einer ungewöhnlichen öffentlichen Zusage von Thibault „Tibo“ Sottiaux, der die Arbeit an Codex- und ChatGPT-Pr...
OpenAI begann den Oktober mit einer ungewöhnlichen öffentlichen Zusage von Thibault „Tibo“ Sottiaux, der die Arbeit an Codex- und ChatGPT-Produkten leitet.
Für 28 Tage erklärte das Team, dass es jeden Tag eines von zwei Dingen tun werde: eine klare Verbesserung ausliefern, die für die meisten Codex- oder ChatGPT-Work-Nutzer relevant ist, oder eine vollständige Nutzungszurücksetzung bereitstellen.
Die erste Auslieferung erfolgte am 5. Oktober 2026. OpenAI erklärte, die Standard-Antwortgeschwindigkeit von GPT-6 Astra und GPT-6.1 Sol für Abonnenten in OpenAI-Produkten und unterstützten Partneranwendungen mit Mit ChatGPT anmelden um etwa 50 % optimiert zu haben.
Das klingt nach einem einfachen Erfolg. Die Reaktionen fielen jedoch komplexer aus.
Die Geschwindigkeitsankündigung fiel mit drei weiteren Änderungen zusammen, die für Power-User relevant waren: OpenAI führte ein neues visuelles Werbeformat für ChatGPT ein, veröffentlichte seinen EU-Plan für Textwasserzeichen und veränderte die Wirtschaftlichkeit seiner höherpreisigen Pro-Abonnements. Anschließend argumentierte ein neuer Bericht von SemiAnalysis, dass Anthropic-Abonnements bei einigen gängigen Modellstufen derzeit deutlich mehr API-äquivalenten Wert bieten.
Das Ergebnis war ein erster Tag, der weniger wie eine eindeutige Siegesrunde wirkte als wie eine Momentaufnahme der Zielkonflikte, die OpenAI bewältigen möchte: schnellere Modelle, höhere Infrastrukturkosten, neue Monetarisierung, regulatorische Compliance und Nutzer, die jedes Limit und jeden Token zunehmend mit konkurrierenden Produkten vergleichen.
Der 28-Tage-Sprint begann mit einer einfachen Regel.
Tibo erklärte, dass OpenAI in den folgenden 28 Tagen entweder täglich eine Verbesserung ausliefern werde, die für die meisten Codex- und Work-Nutzer klar relevant ist, oder eine vollständige Zurücksetzung bereitstellen werde.
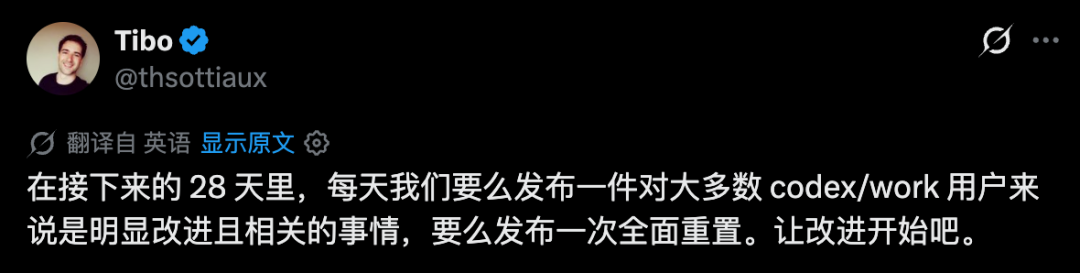
Das Team grenzte seine kurzfristigen Prioritäten zudem auf einige Bereiche ein:
Die Zusage erfolgte nach einer Phase ungewöhnlich sichtbarer Frustration über Modellgeschwindigkeit, Ausfälle und wechselnde Nutzungskontingente.
Für Tag 1 entschied sich OpenAI für die Inferenzleistung.
Das erste ausgelieferte Element war eine Optimierung der Standardgeschwindigkeit für GPT-6 Astra und GPT-6.1 Sol.
OpenAIs aktuelles Help Center beschreibt die Verbesserung als eine ungefähr 50-prozentige Steigerung der Textgenerierungsgeschwindigkeit bei der Standardgeschwindigkeitseinstellung.
Die Änderung gilt, wenn die Modelle über ein ChatGPT-Abonnement in OpenAI-Produkten oder in unterstützten Partneranwendungen verwendet werden, die sich über Mit ChatGPT anmelden authentifizieren, einschließlich Beispielen wie OpenCode, Pi, Amp und Devin.
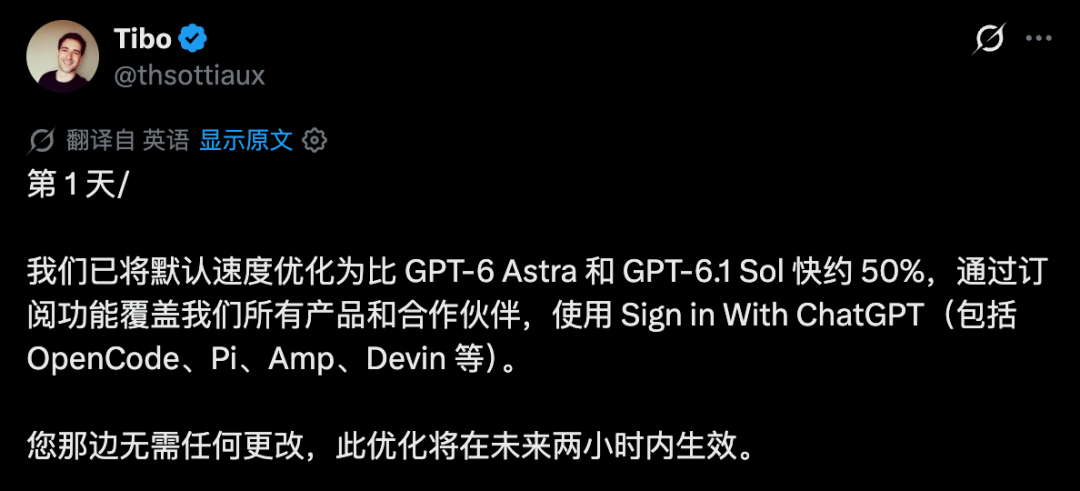
Nutzer müssen weder Fast noch Ultrafast aktivieren, um diese Optimierung der Standardgeschwindigkeit zu erhalten.
OpenAIs Community-Tracker beschrieb die Änderung als eine Erhöhung der Standard-Ausgaberate von ungefähr 30 Token pro Sekunde auf rund 50 Token pro Sekunde.
Diese Zahl erfordert eine wichtige Einschränkung: Eine schnellere Token-Generierung bedeutet nicht, dass eine vollständige Codex- oder Work-Aufgabe 50 % schneller abgeschlossen wird.
Agentische Aufgaben verbringen häufig Zeit mit Aktivitäten wie:
Wenn die Textgenerierung des Modells nur einen Teil der gesamten Aufgabe ausmacht, kann sich die End-to-End-Latenz deutlich weniger als die genannte Prozentzahl verbessern.
GPT-6.1 Sol hatte kurz nach seiner Einführung am 29. September bereits Beschwerden über Latenz ausgelöst.
Die BAAI-Quelle weist darauf hin, dass einige Nutzer selbst Antworten im Fast-Modus während hoher Auslastung langsamer als erwartet empfanden. Tibo bestätigte öffentlich eine ungewöhnlich hohe Last und erklärte, die Serviceleistung werde wiederhergestellt; betroffenen zahlenden Nutzern wurden Nutzungszurücksetzungen angeboten.
Das erklärt, warum die Inferenzoptimierung zum ersten Element des 28-Tage-Programms wurde.
OpenAI fügte an Tag 1 kein neues Modell hinzu. Stattdessen sollten die Modelle, die Menschen bereits verwendeten, schneller wirken.
Die Geschwindigkeitsankündigung war nicht die einzige OpenAI-Nachricht in dieser Woche.
Am 5. Oktober kündigte OpenAI ein neues visuelles Anzeigenformat für ChatGPT an.
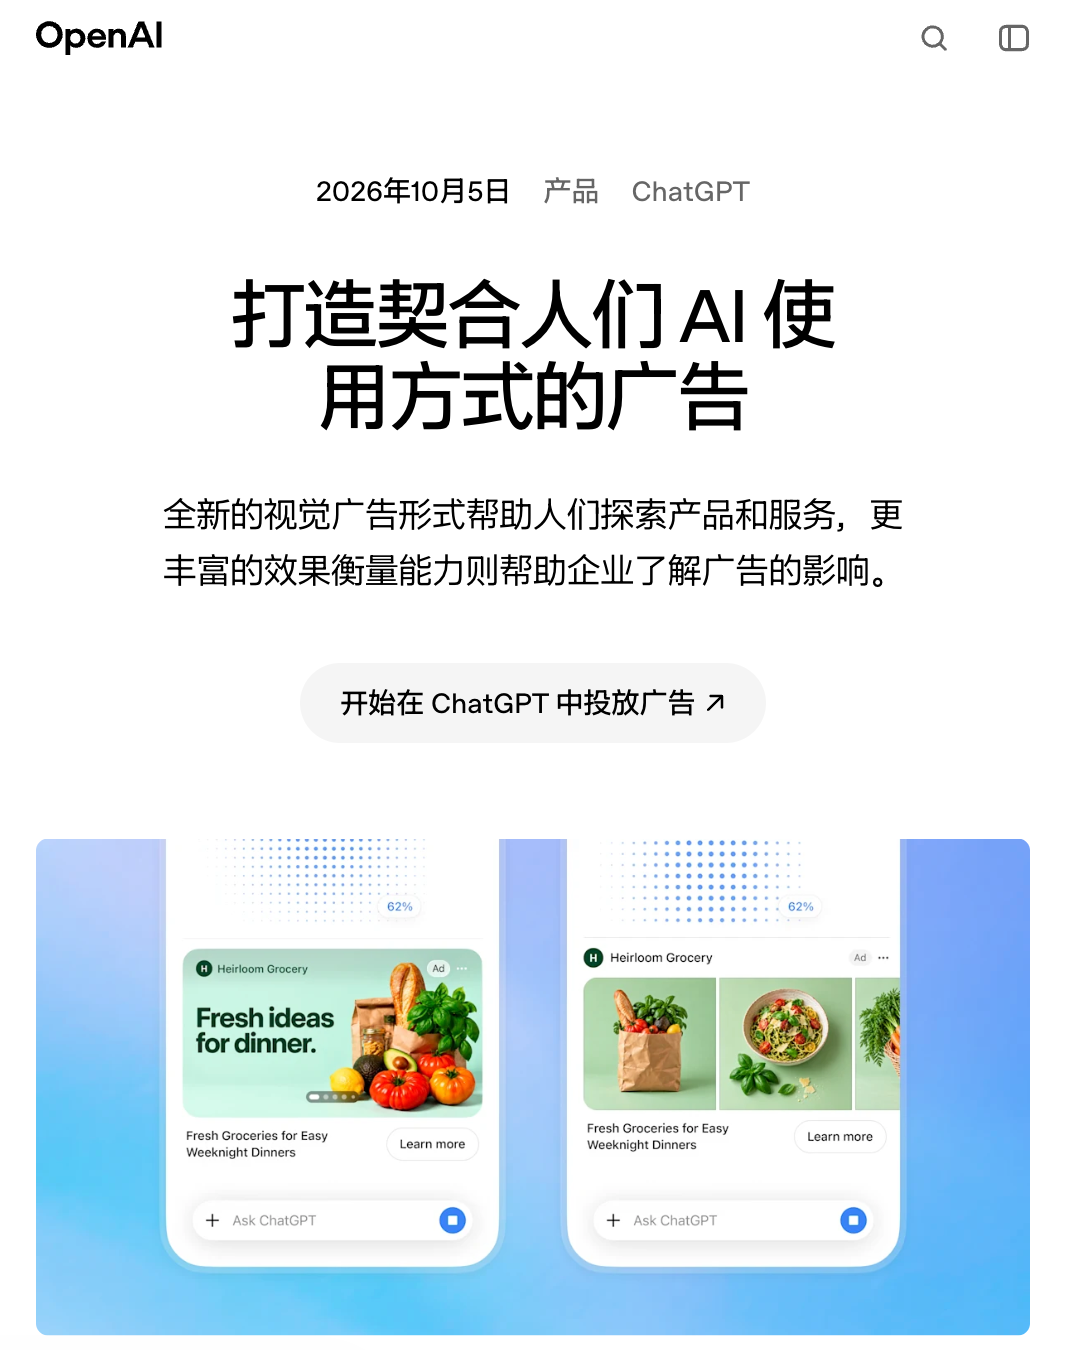
Das Format soll Produktinspirationen, Produktnutzung oder andere Markenbilder zeigen, während Menschen in ChatGPT Produkte und Dienstleistungen erkunden.
Der erste Test ist enger gefasst, als einige Schlagzeilen vermuten lassen.
OpenAI erklärt, dass die erste Einführung:
Das Unternehmen erklärt außerdem, dass Anzeigen deutlich gekennzeichnet werden und vom generierten Bild getrennt bleiben.
Laut OpenAI beeinflusst Werbung die Antworten von ChatGPT nicht.
Die Ankündigung geht über ein neues visuelles Anzeigenformat hinaus.
OpenAI baut einen umfassenderen Stack zur Werbemessung auf, mit Partnern für Attribution, Conversion-Daten, Inkrementalität und Markeneignung.
Von OpenAI genannte Partner umfassen Dienste wie:
OpenAI erklärt, dass ChatGPT inzwischen 1,2 Milliarden Menschen pro Woche erreicht, wodurch Werbung neben Abonnements zu einem bedeutenden zusätzlichen Geschäftsmodell wird.
Die erklärten Grundsätze des Unternehmens bleiben: Antworten sollen unabhängig bleiben, Nutzerunterhaltungen sollen für Werbetreibende privat bleiben und Menschen sollen die Kontrolle über ihre Werbeerfahrung behalten.
Eine zweite Ankündigung konzentrierte sich auf Herkunftsnachweise statt auf Monetarisierung.
OpenAI veröffentlichte seinen Plan zur Erfüllung der Transparenzanforderungen des EU AI Act durch die Einführung eines statistischen Textwasserzeichens namens textGrain.
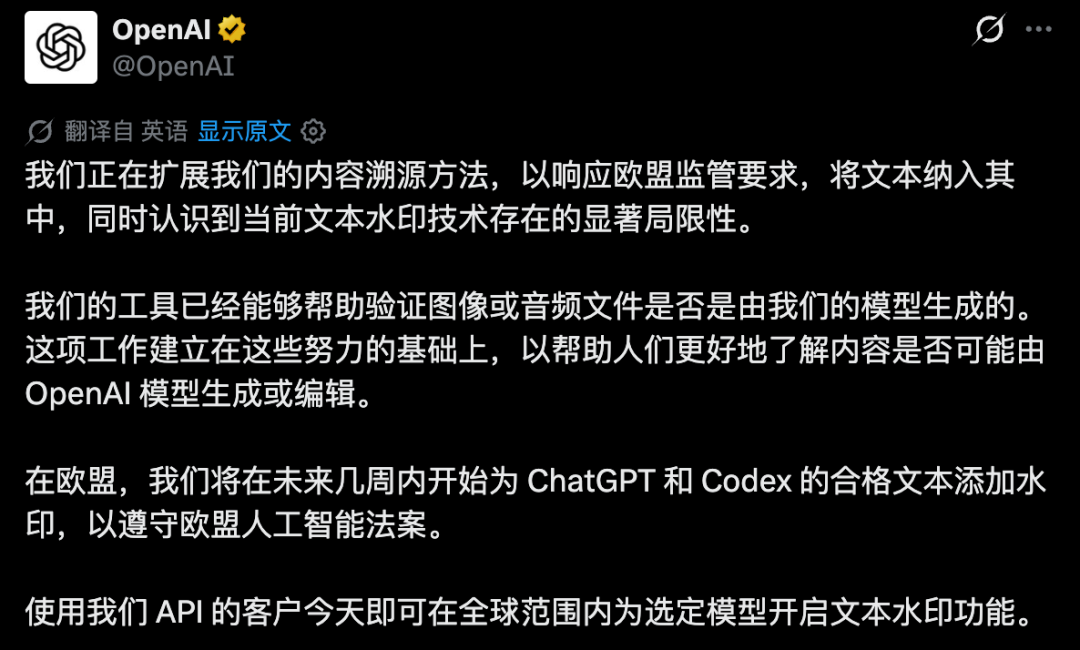
Das Wasserzeichen ist kein verstecktes Unicode-Zeichen, kein unsichtbares Leerzeichen und kein Metadaten-Tag.
Stattdessen beeinflusst textGrain auf subtile Weise, wie das Modell zwischen möglichen Wörtern oder Wortbestandteilen auswählt. Über einen ausreichend langen Text hinweg erzeugen diese Entscheidungen ein statistisches Signal, nach dem ein Detektor suchen kann.
OpenAIs Einführung folgt zwei unterschiedlichen Pfaden:
| Produktpfad | Status des Wasserzeichens |
|---|---|
| ChatGPT und Codex in der EU | Einführung in den kommenden Wochen für berechtigte Textausgaben |
| OpenAI API weltweit | Opt-in für ausgewählte Modelle; standardmäßig deaktiviert |
| Öffentlicher Detektor | Zum Start nicht allgemein öffentlich verfügbar |
| Zugang für Forschende / Experten | Auf Antrag und im Einzelfall verfügbar |
Der Quellartikel stellt korrekt den Zusammenhang mit dem EU AI Act her, doch es ist wichtig, das Wasserzeichen zum Start nicht als globalen ChatGPT-Standard zu beschreiben.
OpenAI erklärt ausdrücklich, dass die erste Einführung für ChatGPT und Codex nur in der EU erfolgt.
OpenAI ist ungewöhnlich direkt darin, was das Wasserzeichen nicht beweisen kann.
Ein erkanntes Wasserzeichen belegt nicht:
Das Fehlen eines erkannten Wasserzeichens beweist ebenfalls keine menschliche Urheberschaft.
OpenAIs eigene Auswertung zeigt, warum. Bei einer Zielrate falsch positiver Ergebnisse von 1 % wird die Erkennung bei längeren, nicht eingeschränkten Texten stärker, während kurze, stark eingeschränkte, übersetzte oder bearbeitete Texte deutlich schwieriger klassifizierbar sein können.
Das Unternehmen berichtet, dass das Ersetzen selbst eines moderaten Anteils von Wörtern durch Synonyme das Signal erheblich schwächen kann.
textGrain ist daher ein Herkunftssignal und kein unfehlbarer Detektor für Urheberschaft.
Wenn Anzeigen und Wasserzeichen für einige Nutzer störend waren, war die Wirtschaftlichkeit von Abonnements für Entwickler, die Codex und agentische Workflows intensiv nutzen, unmittelbarer relevant.
Am 5. Oktober veröffentlichte das unabhängige Forschungsunternehmen für Halbleiter und KI-Infrastruktur SemiAnalysis einen Bericht, der die praktischen Grenzen großer KI-Abonnementpläne misst.
Der Bericht versucht, den API-äquivalenten Wert zu schätzen, anstatt lediglich Monatspreise zu vergleichen.
SemiAnalysis misst, wie schnell sich die Nutzungszähler von Abonnements unter kontrollierten Workloads bewegen, schätzt die Anzahl der Token innerhalb der Nutzungsfenster eines Plans und rechnet diese Limits anschließend anhand entsprechender API-Preise in einen Wert um.
Diese Methodik ist nützlich, bleibt jedoch ein von SemiAnalysis entwickelter Analyserahmen und keine offizielle Planbewertung von OpenAI oder Anthropic.
SemiAnalysis argumentiert, dass Verbraucherabonnements im Vergleich zur direkten API-Nutzung stark subventioniert sind.
Für Anthropic schätzt sein grobes Modell, dass Abonnements ungefähr 10 % des Umsatzes ausmachen, aber mehr als 40 % der Inferenzrechenleistung verbrauchen.
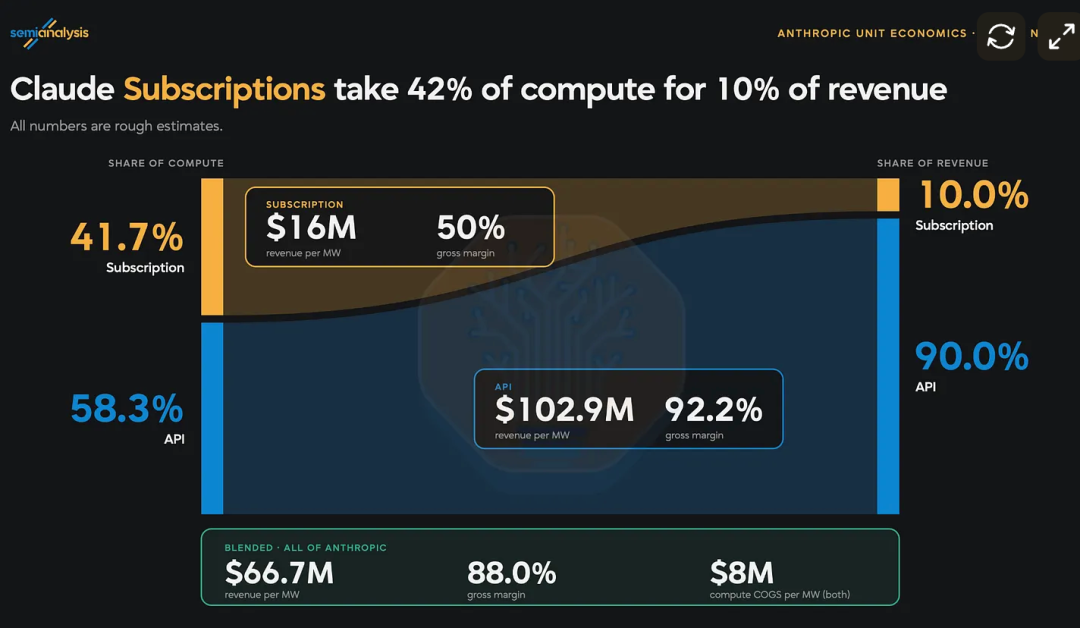
Das Unternehmen schätzt, dass dies den gemischten Umsatz pro Megawatt um ungefähr 36 Millionen US-Dollar gegenüber einem stärker API-orientierten Workload-Mix reduziert.
Die genauen wirtschaftlichen Kennzahlen sind Schätzungen und keine Finanzoffenlegungen des Unternehmens.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Der übergeordnete Druck ist jedoch leicht zu verstehen: Pauschale Monatsabonnements fördern eine intensive Nutzung, während die Inferenz von Spitzenmodellen weiterhin teuer ist.
Dadurch entsteht eine fortlaufende Spannung zwischen großzügigen Nutzungslimits und nachhaltigen Margen.
OpenAI bietet jetzt drei monatliche Pro-Stufen an:
| Plan | Monatlicher Preis | Astra Ultrafast |
|---|---|---|
| Pro 100 | 100 $ | Nein |
| Pro 200 | 200 $ | Nein |
| Pro 500 | 500 $ | Ja |
Pro 500 wurde am 29. September eingeführt und umfasst die höchste gebündelte Nutzung der drei Pro-Pläne sowie Zugriff auf Astra Ultrafast in ChatGPT Work und Codex.
OpenAI reduzierte zudem das enthaltene Kontingent für neu erworbene Pro-200-Abonnements. Kunden, die für Bestandsschutz qualifiziert sind, können das vorherige Kontingent bis zum 29. Oktober 2026 behalten.
Diese Änderung ist real und von OpenAI dokumentiert.
SemiAnalysis ergänzt eine Messung dazu, wie viel praktische Modellnutzung diese Stufen offenbar enthalten.
Laut dem Unternehmen bietet OpenAIs aktualisierter Pro-200-Plan nach seiner Testmethodik ungefähr die Hälfte des bisherigen API-äquivalenten Werts.
Der Bericht erklärt außerdem, dass die neue 500-Dollar-Stufe nur etwa 21 % mehr GPT-6-Astra-Nutzung als die alte, bestandsgeschützte 200-Dollar-Stufe bietet, obwohl Pro 500 zusätzlich Astra Ultrafast umfasst.
Das macht die Bewertung des neuen 500-Dollar-Plans mit einer einzigen Kennzahl schwierig: Sein Wert hängt teilweise davon ab, ob ein Nutzer maximale Durchsatzleistung und nicht nur Token-Volumen benötigt.
Das am häufigsten diskutierte Diagramm vergleicht GPT-6.1 Sol mit Claude Opus 5.5 unter einem agentischen Workload.
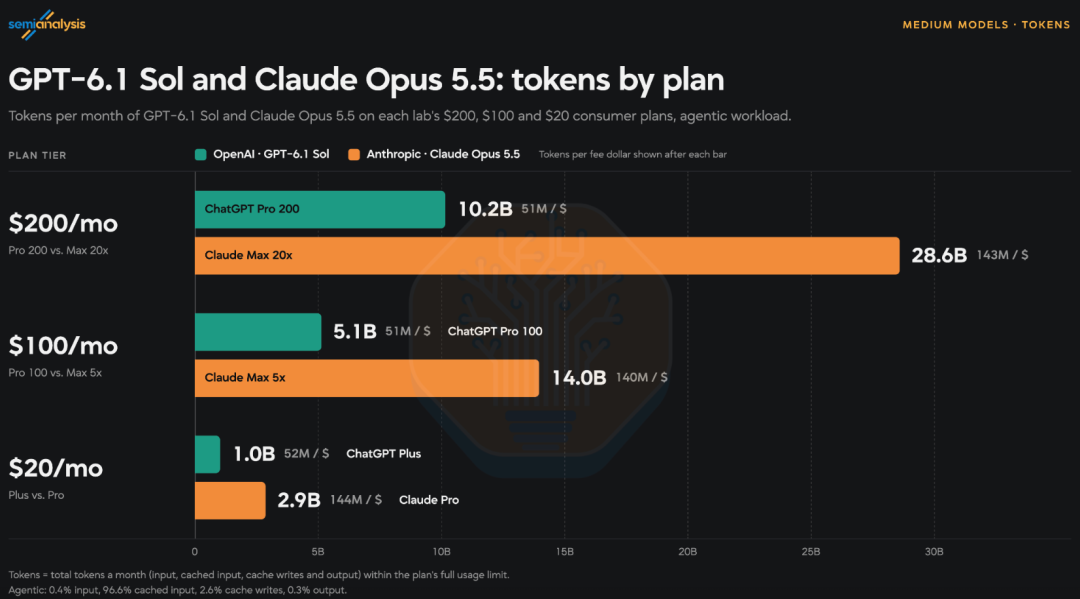
SemiAnalysis kommt zu dem Schluss, dass Anthropic in diesem Mid-Tier-Vergleich ungefähr den 5-fachen API-äquivalenten Wert bietet.
Das bedeutet nicht, dass jedes Claude-Abonnement für jeden Nutzer fünfmal besser ist.
Das Ergebnis hängt ab von:
SemiAnalysis selbst weist darauf hin, dass Token-Effizienz schwer verlässlich zu messen ist und API-äquivalenter Wert irreführend sein kann, wenn API-Preise nicht eindeutig dem praktischen Nutzen entsprechen.
Dennoch gibt der Bericht Entwicklern einen konkreten Grund, Abonnements nach dem tatsächlichen Workload statt allein nach Marketingbezeichnungen zu vergleichen.
Nach der Geschwindigkeitsankündigung an Tag 1 begannen einige Nutzer, den neuen Standarddurchsatz selbst zu messen.
Ein häufig geteiltes Ergebnis zeigte für GPT-6.1 Sol Standard über einen Messzeitraum durchschnittlich rund 31,7 Token pro Sekunde, wobei ein jüngeres kurzes Zeitfenster näher an den mittleren 30er-Werten lag.
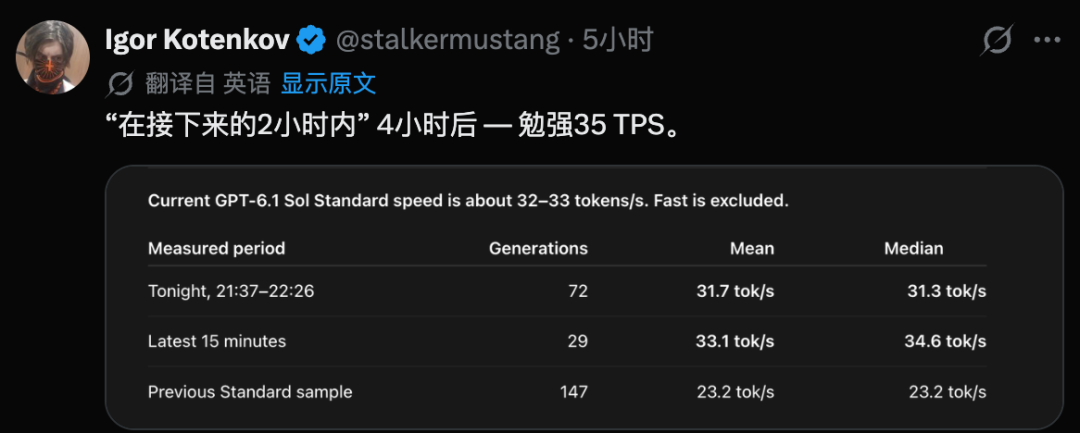
Das lag unter dem Wert von ungefähr 50 Token pro Sekunde, der mit der Ankündigung zur Einführung verbunden war.
Das bedeutet nicht zwangsläufig, dass die Optimierung fehlgeschlagen ist.
Die beobachtete Geschwindigkeit kann variieren je nach:
OpenAIs eigenes Help Center erklärt, dass der Support die Geschwindigkeitsverbesserung derzeit nicht für ein einzelnes Konto verifizieren kann.
Die offizielle Aussage sollte daher als plattformweite Optimierung und nicht als garantierter fester Durchsatz für jede Anfrage gelesen werden.
Eine weitere Reaktion im Quellartikel war skeptischer: Einige Nutzer argumentierten, GPT-6.1 Sol sei nach der Einführung bereits erheblich langsamer geworden. Daher wirkte die Geschwindigkeitserhöhung an Tag 1 eher wie die Wiederherstellung verlorener Leistung als wie eine wirklich neue Fähigkeit.
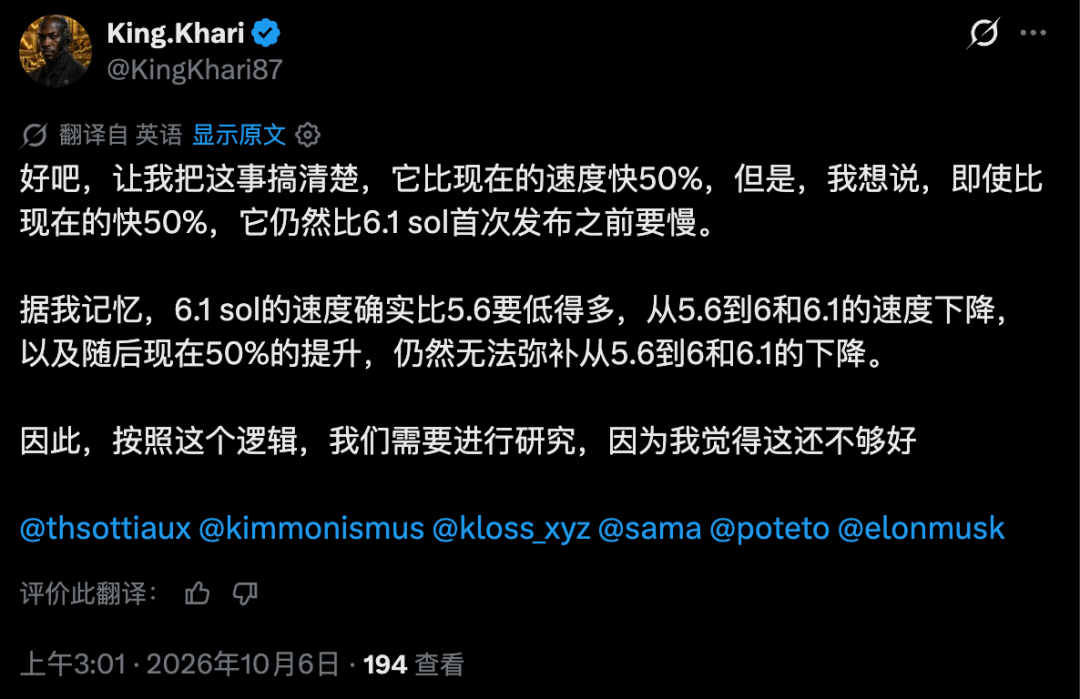
Dieses Argument lässt sich anhand öffentlicher Daten schwer beweisen, da es kein einzelnes offizielles historisches Diagramm zum Inferenzdurchsatz pro Nutzer vor und nach jedem Auslastungsereignis gibt.
Bestätigt ist, dass OpenAI eine ungewöhnlich hohe Auslastung rund um GPT-6.1 Sol anerkannte und später eine Inferenzoptimierung auslieferte, die die Standardgeschwindigkeit der Textgenerierung verbessern sollte.
Die Nutzerreaktion bleibt dennoch relevant, weil sie erklärt, warum eine technisch bedeutende Leistungsverbesserung nicht automatisch eine positive Resonanz erzeugte.
Nutzer bewerten ein Update anhand ihrer bisherigen Erfahrung und nicht nur anhand des aktuellen Benchmarks des Unternehmens.
Für sich genommen ist eine schnellere Standard-Antwortrate eine unkomplizierte Verbesserung der Nutzererfahrung.
Doch Tag 1 fiel in die Mitte mehrerer überlappender Veränderungen:
Dadurch drehte sich die Reaktion weniger um eine einzelne Inferenzoptimierung als darum, welche Prioritäten Nutzer OpenAI zuschreiben.
Für Entwickler lautet die Kernfrage praktisch:
Werden Modelle schnell genug schneller und nützlicher, um strengere Limits, höhere Tarifstufen und ein stärker kommerzialisiertes Produkterlebnis auszugleichen?
Es gibt keine einheitliche Antwort.
Ein Nutzer, der Astra Ultrafast, Codex Cloud oder das breitere Tool-Ökosystem von OpenAI schätzt, kann zu einer völlig anderen Einschätzung gelangen als ein Entwickler, der rein auf Modell-Token pro Abonnement-Dollar optimiert.
Das 28-Tage-Programm schafft eine ungewöhnlich öffentliche Feedbackschleife.
Statt eine große Roadmap anzukündigen und Nutzer warten zu lassen, zwingt OpenAI sich selbst, in täglichem Rhythmus sichtbare Verbesserungen zu liefern oder Nutzer durch eine Zurücksetzung zu entschädigen.
Der erste Tag konzentrierte sich auf Inferenzgeschwindigkeit.
Bis zum 8. Oktober war die Challenge bereits über Tag 1 hinausgegangen. Zu den späteren Updates gehörten kostenloses Auto Review, die Vereinfachung von API-Rate-Limits, ein Meetings-Plugin, die öffentliche Beta der Decisions API, Zurücksetzungen und GPT-6 mit Intelligent UI.
Dieser Artikel bleibt auf die Momentaufnahme von Tag 1 fokussiert, da dies das Thema des ursprünglichen BAAI-Berichts ist.
Der wichtigere Test ist, was die gesamten 28 Tage ergeben.
Wenn das Programm Verbesserungen liefert, die Nutzer bei alltäglicher Programmierung und Wissensarbeit tatsächlich spüren, wird die Geschwindigkeitsoptimierung wie ein sinnvoller erster Schritt wirken.
Wenn spätere Updates kosmetisch wirken, während Limits und Preise die Hauptquelle der Aufmerksamkeit bleiben, wird es schwieriger sein, die an Tag 1 sichtbare Skepsis umzukehren.
Für 28 Tage erklärte OpenAIs Tibo Sottiaux, das Team werde täglich entweder eine klare Verbesserung ausliefern, die für die meisten Codex- und ChatGPT-Work-Nutzer relevant ist, oder eine vollständige Zurücksetzung bereitstellen. Das Programm begann Anfang Oktober 2026.
OpenAI beschreibt die Optimierung an Tag 1 als eine ungefähr 50-prozentige Steigerung der Standardgeschwindigkeit für die Textgenerierung. Das bedeutet nicht, dass jede vollständige Work- oder Codex-Aufgabe 50 % schneller beendet wird, da Tool-Nutzung, Browsing, Schlussfolgern und externe Dienste ebenfalls Zeit beanspruchen.
Nein. OpenAI erklärt, dass die Verbesserung für die Standardgeschwindigkeit gilt. Fast und Ultrafast sind separate Servicestufen und Produktoptionen.
OpenAI erklärt, dass der erste Test visueller Anzeigen später im Oktober 2026 in den Vereinigten Staaten während der Bildgenerierung für Free- und Go-Nutzer beginnt. Anzeigen werden gekennzeichnet und vom generierten Bild getrennt sein.
Nein. OpenAI plant, in den kommenden Wochen textGrain-Wasserzeichen zu berechtigten ChatGPT- und Codex-Texten in der Europäischen Union hinzuzufügen. API-Kunden weltweit können sich für ausgewählte Modelle anmelden, doch in der API sind Wasserzeichen standardmäßig deaktiviert.
Pro 500 ist OpenAIs Pro-Stufe für 500 US-Dollar pro Monat. Sie enthält die höchste gebündelte Nutzung unter den Pro-Plänen und Zugriff auf Astra Ultrafast in ChatGPT Work und Codex.
Ja. OpenAI dokumentiert ein niedrigeres enthaltenes Kontingent für neu erworbene Pro-200-Abonnements, während berechtigte Bestandsschutznutzer das vorherige Kontingent bis zum 29. Oktober 2026 behalten können.
Das ist eine Schlussfolgerung von SemiAnalysis für spezifische Modell- und Workload-Vergleiche unter Verwendung seiner Methodik zum API-äquivalenten Wert. Sie sollte nicht als universelles Maß für Modellqualität oder Nutzen für jeden Nutzer behandelt werden.
OpenAI begann seinen 28-tägigen Auslieferungssprint für Codex und ChatGPT Work mit einer realen Infrastrukturverbesserung: GPT-6 Astra und GPT-6.1 Sol generieren nun in Abonnementprodukten und bei unterstützten Partnern mit Mit ChatGPT anmelden Texte bei der Standardgeschwindigkeit ungefähr 50 % schneller.
Die verhaltene Reaktion ist nachvollziehbarer, wenn man alle parallel stattfindenden Entwicklungen betrachtet. OpenAI testet visuelle Anzeigen, führt EU-Textwasserzeichen ein, strukturiert Pro-Nutzungskontingente um und verkauft eine neue Stufe für 500 Dollar mit Astra Ultrafast, während SemiAnalysis argumentiert, dass Anthropic in mehreren gängigen Abonnementvergleichen derzeit deutlich mehr API-äquivalenten Wert liefert.
Die Debatte am ersten Tag dreht sich daher nicht wirklich um Token pro Sekunde. Es geht um das gesamte Wertversprechen, das Nutzer heute bewerten: Modellqualität, Geschwindigkeit, Limits, Preise, Tooling, Datenschutz, Werbung und Zuverlässigkeit.
Tag 1 machte die Modelle schneller; die verbleibenden 27 Tage werden bestimmen, ob OpenAI das gesamte Codex- und Work-Erlebnis spürbar verbessern kann.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



