OpenAI hat eine bedeutende Preisanpassung für die GPT-5.6-Serie vorgenommen. Ab dem 30. Juli 2026 hat das Unternehmen den API-Preis von GPT-...
OpenAI hat eine wesentliche Preisänderung für die GPT-5.6-Serie vorgenommen.
Seit dem 30. Juli 2026 hat das Unternehmen den API-Preis für GPT-5.6 Luna um 80% und den Preis für GPT-5.6 Terra um 20% gesenkt. Der Preis für das Flaggschiffmodell GPT-5.6 Sol bleibt standardmäßig unverändert, aber OpenAI hat einen Schnellmodus eingeführt, der eine bis zu 2,5-mal schnellere Verarbeitung als der Standardmodus bei gleicher Modellintelligenz bietet.
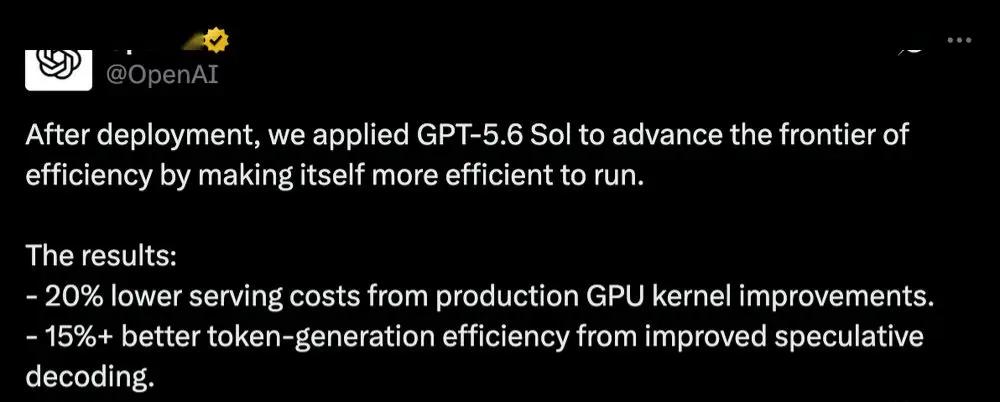
Diese Änderung erfolgt, nachdem OpenAI einen technischen Analysebericht veröffentlicht hat, der zeigt, wie GPT-5.6 Sol zur Optimierung der Systeme beigetragen hat, die für den Betrieb von GPT-5.6 selbst verwendet werden. Laut OpenAI haben Verbesserungen an produktionsreifen GPU-Kernen die End-to-End-Betriebskosten um 20% gesenkt, während Verbesserungen bei der spekulativen Dekodierung die Tokenerzeugungseffizienz um mehr als 15% gesteigert haben.
Das Ergebnis ist eine aggressivere Strategie von OpenAI an der sogenannten Preis-Leistungs-Grenze: die Menge der verwendeten Intelligenz wird an den wirtschaftlichen Wert der jeweiligen Aufgabe angepasst.
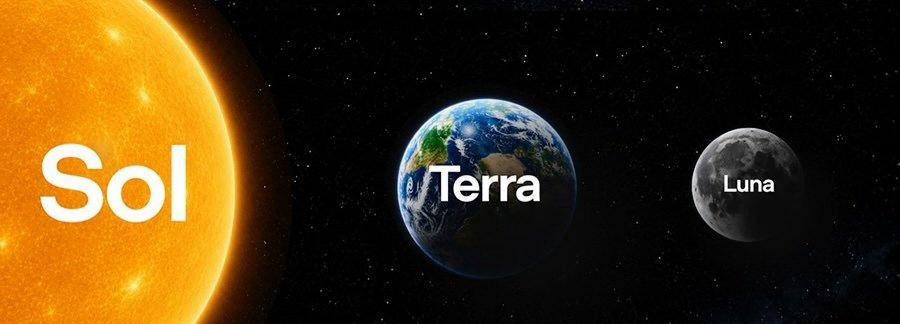
Für Entwickler liegen die wichtigsten Änderungen auf der Hand: Luna ist jetzt deutlich günstiger für hochvolumige Agenten-Workloads, Terra kostet weniger für alltägliche Nutzung, und Sol kann bei Bedarf mit einem höheren Service-Level erworben werden, wenn Latenz wichtiger ist als Preis.
Das Preisupdate vom 30. Juli umfasst die gesamte GPT-5.6-Serie, aber die Anpassungen fallen je nach Modell unterschiedlich aus.
Luna erhielt die aggressivste Preissenkung.
Die Standard-API-Preise wurden wie folgt angepasst:
| Tokentyp | Alter Preis | Neuer Preis | Änderung |
|---|---|---|---|
| Eingabe | 1,00 USD / 1 Mio. Token | 0,20 USD / 1 Mio. Token | -80% |
| Ausgabe | 6,00 USD / 1 Mio. Token | 1,20 USD / 1 Mio. Token | -80% |
OpenAI beschreibt Luna als das schnellste und erschwinglichste Modell der GPT-5.6-Serie und positioniert es für kostensensible, hochvolumige Workloads.
Dazu gehören Aufgaben wie:
Die niedrigeren Preise verändern insbesondere die Wirtschaftlichkeit von Agenten-Schleifen, da eine einzelne Benutzeranfrage mehrere Modellaufrufe umfassen kann und nicht nur eine einzelne einfache Vervollständigung.
OpenAI gibt an, dass Luna Tools verwenden und mehrstufige Workflows abschließen kann, was es praktikabel macht, mehr Arbeit an kostengünstigere Modelle zu delegieren, ohne Agentenverhalten den teureren Spitzenmodellen vorbehalten zu müssen.
Die Standard-API-Preise für Terra betragen jetzt:
| Tokentyp | Alter Preis | Neuer Preis | Änderung |
|---|---|---|---|
| Eingabe | 2,50 USD / 1 Mio. Token | 2,00 USD / 1 Mio. Token | -20% |
| Ausgabe | 15,00 USD / 1 Mio. Token | 12,00 USD / 1 Mio. Token | -20% |
Terra bleibt das Mittelklasse-Modell der GPT-5.6-Serie.
Es ist für Workloads konzipiert, die stärkere Reasoning-Fähigkeiten als Luna benötigen, aber nicht unbedingt die höheren Kosten von Sol rechtfertigen.
Typische Anwendungen umfassen:
OpenAI erwähnt Notion als einen Kunden, der Terra für persönliche Agenten-Workloads wie latenzempfindliche Fragen im Arbeitsbereich und Aufgaben mit begrenztem Umfang verwendet.
Die Standard-API-Preise für Sol bleiben unverändert:
| Tokentyp | Standardpreis |
|---|---|
| Eingabe | 5,00 USD / 1 Mio. Token |
| Ausgabe | 30,00 USD / 1 Mio. Token |
Die Änderung bei Sol ist keine Preissenkung.
Stattdessen hat OpenAI den Schnellmodus eingeführt.
Der Schnellmodus ersetzt die bisherige Bezeichnung „Priority Processing“ von OpenAI.
Für GPT-5.6 Sol gibt OpenAI an, dass der Schnellmodus bis zu 2,5-mal schneller ist als die Standardverarbeitung – bei unveränderter Modellintelligenz.
Der Preis dafür: Der Schnellmodus kostet das Doppelte der Standardverarbeitung.
Für Sol bedeutet das:
| Tokentyp | Standard | Schnellmodus |
|---|---|---|
| Eingabe | 5,00 USD / 1 Mio. | 10,00 USD / 1 Mio. |
| Cache-Eingabe | 0,50 USD / 1 Mio. | 1,00 USD / 1 Mio. |
| Ausgabe | 30,00 USD / 1 Mio. | 60,00 USD / 1 Mio. |
Bestehende API-Anfragen mit:
service_tier="priority"
bleiben abwärtskompatibel und werden zum Schnellmodus weitergeleitet.
OpenAI unterstützt außerdem:
service_tier="fast"
als umbenannte Servicekennung.
Der Schnellmodus ist besonders nützlich, wenn die Kosten des Wartens höher sind als die Kosten schnellerer Inferenz.
Beispiele umfassen:
Ein Workflow, der 20 oder 30 Modellaufrufe erfordert, kann sich selbst dann deutlich langsamer anfühlen als eine einzelne Chat-Antwort, wenn die Latenz jedes einzelnen Aufrufs gering ist. Daher kann eine schnellere Verarbeitung in Agentsystemen eine überproportionale Bedeutung haben.
Die niedrigeren Preise für Luna und Terra spiegeln sich auch in der Berechnung der Nutzung von ChatGPT Work und Codex wider.
OpenAI gibt an:
Das bedeutet nicht, dass die kostenpflichtigen Abonnements selbst günstiger werden.
Die Änderung bedeutet, dass dasselbe Kontingent bei Wahl von Luna oder Terra länger genutzt werden kann.

OpenAI hat ein Diagramm veröffentlicht, das Preis und Intelligenz auf Basis des Artificial Analysis Intelligence Index v4.1 vergleicht, um die neue Positionierung von Luna zu veranschaulichen.
Das Diagramm platziert GPT-5.6 Luna mit einem Intelligenzindex von über 50 Punkten und zeigt gleichzeitig, dass einer der Luna-Modelle nach der Preisanpassung
Die geschätzten Aufgabenkosten der Konfiguration betragen etwa 0,05 US-Dollar.
Diese Daten sollten nicht mit dem Preis eines einzelnen API-Aufrufs verwechselt werden.
Artificial Analysis berechnet die Kosten pro Intelligenzindex-Aufgabe auf Grundlage einer gewichteten Methode aus Modell-Token-Nutzung und Benchmarks. Die Kosten für reale Produktionsanfragen hängen ab von:
Eingabegröße
Ausgabegröße
Inferenztiefe
Prompt-Caching
Anzahl der Tool-Aufrufe
Anzahl der Agenten-Runden
Abrechnung langer Kontexte
Wiederholungsmechanismen
Vor der Preissenkung am 30. Juli berichtete Artificial Analysis, dass GPT-5.6 Luna in der maximalen Inferenzkonfiguration einen Intelligenzindex von etwa 51 aufwies.
Die neuen niedrigeren Token-Preise rücken Luna weiter an das kostengünstige Ende der „Intelligenz-Kosten“-Kurve.
Die von OpenAI vermittelte allgemeinere Botschaft lautet: Unternehmen sollten nicht in jedem Schritt das teuerste Modell verwenden.
Ein Workflow könnte zunächst Sol zur Beseitigung von Mehrdeutigkeiten und zur Planung einsetzen und anschließend klar definierte Implementierungs-, Test- oder Routineaufgaben an Luna delegieren.
Diese Art der Modellrouting wird umso attraktiver, wenn Modelle auf niedrigeren Ebenen bereits über die Fähigkeit zur Tool-Nutzung und zur Durchführung mehrstufiger Workflows verfügen.
Einen Tag vor der Preissenkung veröffentlichte OpenAI einen detaillierten technischen Artikel darüber, wie GPT-5.6 effizienter wurde.
Das Ungewöhnlichste an dieser Geschichte ist, dass GPT-5.6 Sol selbst am Optimierungsprozess beteiligt war.
OpenAI gab an, dass seine Ingenieure über Codex Sol einsetzten, um Produktionssysteme zu analysieren, Performance-Code zu schreiben, Alternativen zu testen und Experimente zu überwachen.
Das Unternehmen beschrieb drei Hauptebenen der Optimierung:
Auf der Inferenzebene gab OpenAI an, dass GPT-5.6 Sol Produktionskernel eigenständig neu geschrieben und optimiert hat.
GPU-Kernel sind low-level-Programme, die für die effiziente Ausführung mathematischer Operationen auf Beschleuniger-Hardware verantwortlich sind.
Selbst bei unveränderter zugrunde liegender Modellarchitektur führen ineffiziente Speicherbewegungen, Synchronisationen, Ablaufplanungen oder Datenlayouts dazu, dass teure GPU-Ressourcen nicht ausgelastet werden.
OpenAI gab an, dass Sol dabei half, folgende optimierbare Berechnungstypen zu identifizieren:
Das Unternehmen erwähnte insbesondere Triton und Gluon als zwei GPU-Programmiertechniken, die an dieser Arbeit beteiligt waren.
Laut OpenAI führten die Kernel-Verbesserungen sowie zugehörige Service-Optimierungen zu einer Senkung der End-to-End-Servicekosten für GPT-5.6 um 20 %.
Eine weitere wichtige Optimierung stammt aus der spekulativen Dekodierung.
Eine vereinfachte Version der spekulativen Dekodierung sieht folgendermaßen aus:
Daher ist die Qualität des Entwurfsmodells entscheidend.
OpenAI gab an, dass GPT-5.6 Sol Hunderte von Experimenten für die Architektur des spekulativen Modells entworfen und durchgeführt hat, mit Änderungen bei:
Sol überwachte zudem den Trainingsprozess und griff bei Hardwarefehlern oder Trainingsinstabilitäten ein.
OpenAI gab an, dass die daraus resultierenden Verbesserungen die Token-Generierungseffizienz um mehr als 15 % steigerten.
Modellkosten hängen nicht nur von dem auf einer einzelnen GPU ausgeführten Code ab.
Anfragen müssen zwischen folgenden Ebenen weitergeleitet werden:
Wenn die Arbeit ungleich verteilt ist und ein Teil der Hardware ungenutzt bleibt, können die Kosten selbst bei leistungsstarken Beschleunigern hoch bleiben.
OpenAI gab an, dass Sol dabei half, Produktionsverkehr zu analysieren, Ursachen für Lastungleichgewichte zu finden, alternative Routing-Strategien zu testen und die Heuristiken für die Verteilung von Anfragen anzupassen.
Diese Art operativer Optimierungen kann den Gesamtdurchsatz steigern, ohne entsprechende zusätzliche Hardware-Investitionen.
OpenAI optimierte auch die Agenten-Frameworks, die in Systemen wie Codex und ChatGPT Work verwendet werden.
Ein Agent kann vor der Rückgabe eines Endergebnisses mehrere Modell- und Tool-Aufrufe benötigen.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Beispielsweise könnte Codex folgende Schritte ausführen:
Jeder Zyklus kann Kontext, Tool-Definitionen, frühere Ergebnisse und Umgebungsinformationen mit sich führen.
Wenn dieser Kontext unnötig wächst, steigen auch Kosten und Latenz.
OpenAI gab an, dass sein Agenten-Framework Techniken wie verzögertes Auffinden einsetzt, bei denen Tools, Fähigkeiten, Plugins und MCP-Integrationen nur dann verfügbar gemacht werden, wenn sie benötigt werden.
Tool-Ausgaben sind standardmäßig auf 10.000 Token begrenzt, es sei denn, das Modell fordert eine andere Begrenzung an.
Dies reduziert die Wahrscheinlichkeit, dass große Tool-Ergebnisse unnötig das Kontextfenster füllen.
Agenten-Schleifen verwenden häufig dieselben Anweisungen und Kontexte mehrfach.
Prompt-Caching vermeidet die wiederholte Berechnung stabiler Prompt-Präfixe.
Aber Caching funktioniert nur, wenn wiederholte Präfixe exakt identisch bleiben.
OpenAI gab an, dass sein Framework die Nur-Anhängen-Eigenschaft des für das Modell sichtbaren Verlaufs beibehält:
Dieses Design erhöht die Wiederverwendungsrate des Prompt-Cachings in Codex und ChatGPT Work.
Das Grundprinzip ist einfach:
Ein Modell ist nicht nur billiger, weil seine Token-Kosten niedriger sind, sondern auch, weil die umgebenden Systeme von Anfang an unnötige Token-Erzeugung und -Verarbeitung vermeiden.
OpenAI beschreibt dies als eine Rückkopplungsschleife.
Stärkere Modelle helfen Ingenieuren bei der Verbesserung von:
Diese Verbesserungen senken Kosten und Latenz.
Eine effizientere Infrastruktur macht es wiederum wirtschaftlicher, stärkere Modelle in größerem Maßstab zu betreiben.
OpenAI ist der Ansicht, dass dies den Zyklus von der Modellforschung bis zur groß angelegten Bereitstellung verkürzen und so das Innovationstempo der KI beschleunigen kann.
Die nächste Generation von Optimierungsgewinnen muss gefunden werden.
Die Preissenkungen für Luna und Terra am 30. Juli sind das bisher deutlichste kundenorientierte Ergebnis.
Der ursprüngliche chinesische Bericht hob auch die lebhafte Resonanz der Entwickler-Community nach der Ankündigung hervor.
Einige Nutzer konzentrierten sich auf das Ausmaß der Luna-Preissenkung.
Die Reduzierung um 80 % ist weitaus größer als die bei Frontend-APIs üblichen schrittweisen Preisänderungen.
Andere meinten, dass Luna vor der Preissenkung bereits unterbewertet war, insbesondere für Agenten-Workloads – Szenarien, in denen kostengünstigere Modelle unter Anleitung stärkerer Planer Routineausführungen übernehmen können.
Diese Preisänderung führte auch sofort zu Vergleichen mit anderen kostenbewussten Modellen, darunter Kimi K3.
Ein in der Community kursierendes virales Meme beschrieb die Situation so: Luna beginnt plötzlich, um Nutzer zu konkurrieren, die von Kimi K3s niedriger Preispositionierung angezogen wurden.
Das Meme ist unterhaltsam, aber es ist kein technischer Benchmark-Test und wurde daher nicht in die Abbildungen des Haupttexts aufgenommen.
Eine weitere häufige Reaktion war die direkte Ansprache von @Anthropic mit der Frage, ob die Claude-API-Preise entsprechend angepasst würden.
Diese Reaktion spiegelt einen breiteren Wandel in der Wettbewerbslandschaft an der Front der großen Modelle wider.
Vor einem Jahr konzentrierte sich der sichtbarste Wettbewerb auf:
Diese Dimensionen sind weiterhin wichtig.
Aber Entwickler, die Produktions-Agenten betreiben, achten zunehmend auf:
Der günstigste Token ist nicht immer der günstigste Workflow.
Ebenso ist das intelligenteste Modell nicht unbedingt das beste Modell für jeden Schritt in einem Workflow.
Angenommen, eine Aufgabe besteht aus fünf Phasen:
Ein Team könnte in Phase 1 und 2 Sol verwenden.
Wenn die Arbeit klar definiert ist, kann Luna die Phasen 3 bis 5 übernehmen.
Je günstiger Luna ist, desto stärker ist der Anreiz, Routine-Agentenarbeit vom Flaggschiff-Modell wegzuleiten.
Das bedeutet nicht, dass Luna Sol in jeder Fähigkeit nahekommt.
Es bedeutet, dass der Wert eines kleineren Modells davon abhängt, ob es für die ihm zugewiesene spezifische Aufgabe intelligent genug ist.
OpenAIs neue Kommunikationslinie betont wiederholt Ergebnisse pro Dollar.
Das ist nützlicher, als sich nur auf Token-Preise zu konzentrieren.
Produktionsumgebungen sollten Folgendes verfolgen:
Ein Modell, das nur ein Fünftel der Kosten pro Token verursacht, kann dennoch teuer sein, wenn es viele Wiederholungen benötigt.
Ein teureres Modell, das die Arbeit mit weniger Schritten erledigt, könnte insgesamt günstiger sein.
Die neue Luna-Preisgestaltung macht die Rechnung für kleinere Modelle günstiger, aber Entwickler benötigen weiterhin
Auswertungen für spezifische Workloads.
Die Ereignisse vom 29. Juli und 30. Juli zeigen, dass OpenAI zwei verwandte Ideen gleichzeitig vorantreibt.
Erstens wird GPT-5.6 zunehmend genutzt, um die Infrastruktur zu verbessern, die GPT-5.6 selbst betreibt.
Zweitens gibt das Unternehmen einen Teil dieser Effizienzsteigerungen in Form von niedrigeren Kundenpreisen und schnelleren Serviceoptionen weiter.
Dies verändert die Wettbewerbslandschaft.
Die nächste Phase des Modellmarkts dreht sich nicht nur um:
Welches Modell ist das intelligenteste?
Sondern auch um:
Wie viel nützliche Intelligenz erhalten Entwickler für jeden ausgegebenen Dollar und jede Sekunde Latenz, die sie in Kauf nehmen?
Die 80%ige Preissenkung bei Luna macht diese Frage besonders deutlich.
Terra wird für alltägliche professionelle Arbeit günstiger.
Sol bleibt das Premium-Modell, aber der Fast-Modus ermöglicht es Entwicklern, bei Zeitdruck mehr zu zahlen, um schnellere Geschwindigkeit zu erhalten.
Da sich die Modellqualität bei mehr Aufgaben angleicht, könnten Unternehmen, die dieselbe Hardware mehr nützliche Arbeit erledigen lassen – und diese Effizienzgewinne in bessere Preise umsetzen – einen zunehmend wichtigen Wettbewerbsvorteil erlangen.
Seit dem 30. Juli 2026 listet OpenAI die Preise für GPT-5.6 Luna im Standardverarbeitungsmodus mit 0,20 USD pro Million Eingabe-Token und 1,20 USD pro Million Ausgabe-Token. Das entspricht einer Reduzierung um 80% gegenüber den ursprünglichen Preisen von 1 USD/6 USD pro Million Token.
GPT-5.6 Terra ist derzeit im Standardverarbeitungsmodus mit 2 USD pro Million Eingabe-Token und 12 USD pro Million Ausgabe-Token gelistet. OpenAI gibt an, dass dies einer Reduzierung von 20% gegenüber den vorherigen Preisen von 2,50 USD/15 USD pro Million Token entspricht.
Nein. Der Standard-API-Preis für Sol bleibt bei 5 USD pro Million Eingabe-Token und 30 USD pro Million Ausgabe-Token. Die Hauptänderung ist die Einführung des Fast-Modus.
Der Fast-Modus ist die schnellere API-Verarbeitungsstufe von OpenAI, die den früheren Namen „Priority Processing“ (Prioritätsverarbeitung) ersetzt. Für GPT-5.6 Sol gibt OpenAI an, dass er bei der doppelten Standard-Token-Preis die Verarbeitungsgeschwindigkeit um bis zu das 2,5-fache des Standardmodus steigern kann, ohne das Intelligenzniveau des Modells zu verändern.
Ja. OpenAI gibt an, dass Anfragen, die die Service-Stufe priority verwenden, weiterhin abwärtskompatibel sind und automatisch den Fast-Modus verwenden. Entwickler können auch den Service-Stufenwert fast verwenden.
OpenAI gibt an, dass GPT-5.6 Sol, das über Codex in menschengeführten Engineering-Prozessen verwendet wurde, dabei half, Produktionsverkehr zu analysieren, GPU-Kerne neu zu schreiben, Hunderte von Experimenten zur spekulativen Dekodierung durchzuführen und den Trainingsprozess zu überwachen. OpenAI führt einen Teil der Senkung der Ende-zu-Ende-Servicekosten um 20% und der Steigerung der Token-Generierungseffizienz um über 15% auf diese Arbeit zurück.
Abonnementpreise und Quotenbudgets ändern sich nicht. OpenAI gibt an, dass Luna und Terra aufgrund der niedrigeren zugrunde liegenden Preise nun weniger Credits in Codex und ChatGPT Work verbrauchen.
Nein. Luna ist viel billiger, aber die Modellwahl hängt weiterhin von der Aufgabenschwierigkeit und der akzeptablen Fehlerrate ab. Eine gängige Strategie ist: Stärkere Modelle für mehrdeutige Planungsaufgaben, günstigere Modelle für klar definierte Ausführungsaufgaben.
ai/models/gpt-5-6-luna/):Lunas modellspezifische Methodik und Details zum Intelligenzindex.
OpenAI hat die API-Preise für GPT-5.6 Luna um 80 % gesenkt und für Terra um 20 %, während der Preis für Sol Standard unverändert bleibt. Stattdessen wurde für Sol ein neuer Fast-Modus eingeführt, der die API-Verarbeitungsgeschwindigkeit um bis zu das 2,5-fache erhöht, allerdings zum doppelten Preis des Standard-Modus.
Dieser Zeitpunkt steht in engem Zusammenhang mit den jüngsten technischen Arbeiten von OpenAI. Das Unternehmen gibt an, dass GPT-5.6 Sol zur Optimierung von GPU-Kernen, spekulativem Decoding, Lastverteilung und Agenten-Infrastruktur beigetragen hat, wodurch die End-to-End-Servicekosten um 20 % gesenkt und die Token-Erzeugungseffizienz in Teilen des Technologie-Stacks um über 15 % gesteigert werden konnten.
Für Entwickler ergibt sich daraus eine breitere Preisleistungsspanne: Sol für die anspruchsvollsten Aufgaben, Terra für ausgewogene professionelle Aufgaben und Luna zu einem niedrigeren Preis für groß angelegte Agentenausführung.
Das Update zu GPT-5.6 zeigt, dass der Wettbewerb bei Spitzenmodellen zunehmend auf die Kosten pro erfolgreichem Ergebnis fokussiert – und nicht nur auf den rohen Intelligenzwert in Benchmarks.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



