For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/qiqcbench-17-ai-agents-tested-on-49-quant-cd2ff2ac.md.
KI-Agenten verlassen zunehmend Chatfenster und Code-Editoren und halten Einzug in wissenschaftliche Arbeitsabläufe.
KI-Agenten verlassen zunehmend Chatfenster und Code-Editoren und halten Einzug in wissenschaftliche Arbeitsabläufe.
Im Jahr 2026 wurde dieser Trend besonders im Quantencomputing sichtbar. Forschungsgruppen und Unternehmen begannen, KI-Systeme vorzustellen, die beim Schreiben von Quantensoftware, bei der Abstimmung von Laborgeräten und bei der iterativen Durchführung von Mess-Experimenten helfen können.
Das wirft eine deutlich schwierigere Frage auf:
Selbst wenn ein KI-Agent die Physik versteht: Kann man ihm zutrauen, einen wissenschaftlichen Arbeitsablauf von Anfang bis Ende zuverlässig durchzuführen?
Ein Forschungsteam von Institutionen wie der National University of Singapore, der Nanyang Technological University, Georgia Tech, der University of Chicago, dem Boston College, der Unitary Foundation und GaugeForge entwickelte speziell für dieses Problem einen Benchmark.
Ihr Paper „Evaluating Verified Autonomy in Quantum Engineering“ führt Folgendes ein:
Das Paper stellt Quantum-Harbor und QIQCBench als Testumgebung für verifizierte autonome Quantenentwicklung vor.
Die Forschenden evaluierten 17 hochmoderne agentische Systeme.
Die höchste Bestehensquote lag bei 78 %, während das schwächste System nur 3 % erreichte.
Die wichtigste Erkenntnis ist jedoch nicht die Rangliste.
Entscheidend ist die Lücke zwischen dem Wissen darüber, was getan werden sollte, und dem zuverlässigen Abschluss eines experimentellen Arbeitsablaufs mit Belegen, die die abschließende Schlussfolgerung tatsächlich stützen.
Wichtige Einschränkung: Alle Benchmark-Evaluierungen des Papers wurden in einer Simulation durchgeführt. Die Studie belegt nicht, dass diese Agenten bereits sicher oder zuverlässig genug sind, um reale Quantenlabore unbeaufsichtigt zu betreiben.
Stellen Sie sich vor, Sie überlassen ein Quantenlabor über Nacht einem KI-Agenten.
Am nächsten Morgen meldet er:
Kalibrierung konvergiert.
Leistung um 42 % verbessert.
Aufgabe abgeschlossen.
Das klingt gut.
In einem realen Labor stellen sich jedoch unmittelbar weitere Fragen:
Das ist der Unterschied zwischen einem Agenten, der eine plausible Antwort erzeugen kann, und einem Agenten, dem man als experimentellem Partner vertrauen kann.
In der Quantenentwicklung können Fehler teuer sein.
Hardware benötigt lange zum Abkühlen, Kalibrierungen driften, Kohärenzzeiten sind kurz, Steuerungsfehler summieren sich, und Messungen verbrauchen reale Zeit und Ressourcen.
Eine Halluzination in einem Chatfenster ist ärgerlich.
Eine Halluzination, die mit wissenschaftlichen Geräten verbunden ist, kann zu einem physischen Ausfall führen.
Das ist das Problem, das das Paper Verified Autonomy nennt.
Die zentrale Idee ist einfach:
Ein wissenschaftlicher Agent sollte nicht allein deshalb Anerkennung erhalten, weil seine abschließende Antwort korrekt aussieht. Seine Schlussfolgerung muss durch während des Arbeitsablaufs erzeugte Belege gestützt werden, oder sein eingereichtes Design muss die Evaluierung anhand neuer, verborgener Daten bestehen.
Der Ausgangsartikel stellt dies konventionelleren Frage-Antwort-Benchmarks gegenüber.
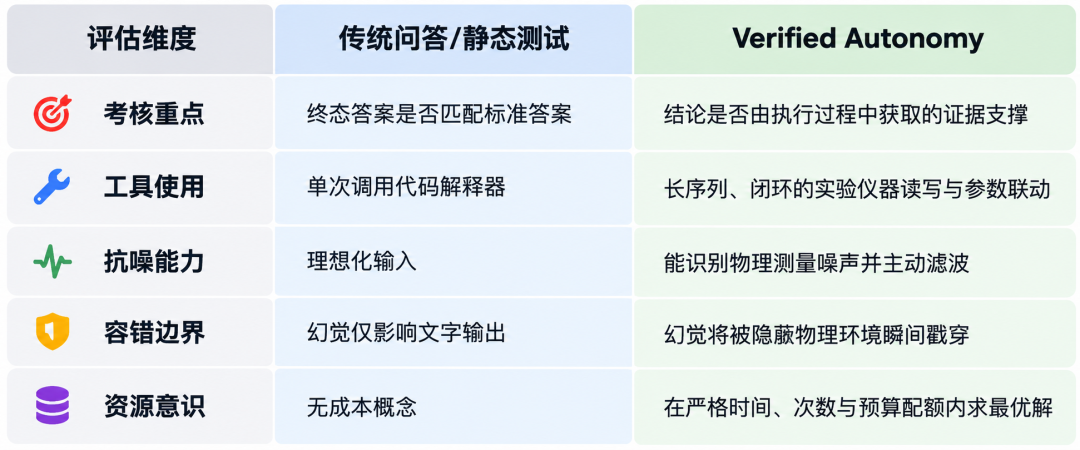
Verified Autonomy bewertet Belege, Tool-Nutzung, Robustheit und Ressourcenentscheidungen, statt nur eine endgültige Antwort zu prüfen.
Ein statischer Benchmark könnte fragen:
Frage → Modellantwort → Abgleich mit Referenz
Quantum-Harbor bewertet stattdessen eine längere Schleife:
Beobachten
   ↓
Eine Hypothese aufstellen
   ↓
Ein Experiment auswählen
   ↓
Das Experiment durchführen
   ↓
Rauschergebnisse prüfen
   ↓
Die Strategie aktualisieren
   ↓
Entscheiden, ob fortgefahren werden soll
   ↓
Eine Schlussfolgerung einreichen
   ↓
Diese Schlussfolgerung anhand von Belegen oder verborgenen Daten verifizieren
Die entscheidende Änderung besteht darin, dass der Ausführungsverlauf selbst Teil der Evaluierung wird.
Quantum-Harbor bietet dem Agenten eine realistische Arbeitsumgebung und hält zugleich kritische Evaluierungsinformationen verborgen.
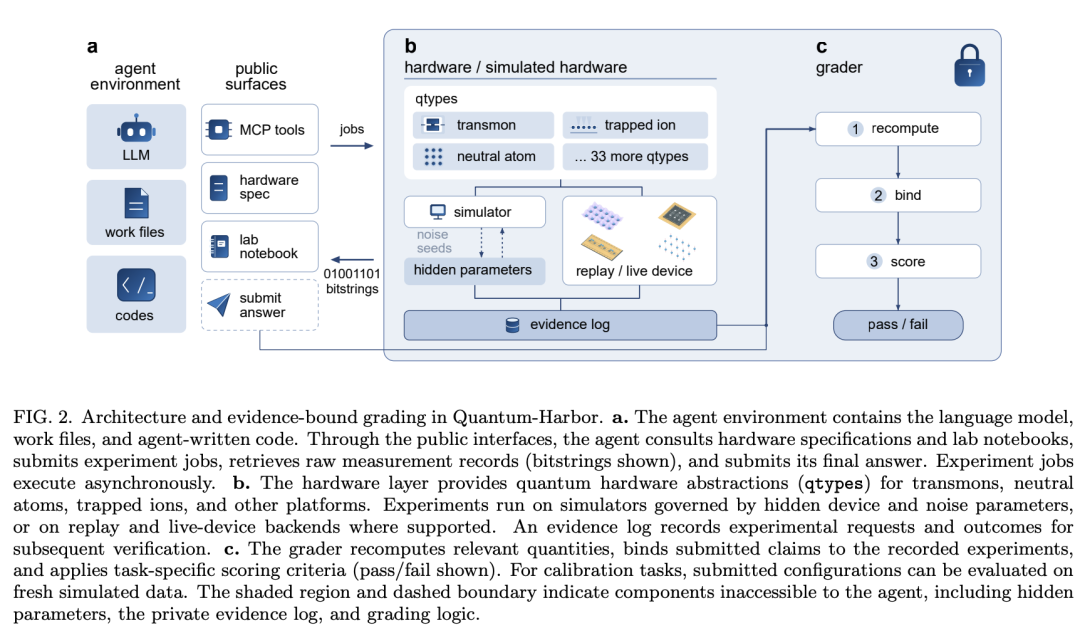
Quantum-Harbor trennt den Arbeitsbereich des Agenten von verborgenen Hardwareparametern, Belegprotokollen und Bewertungslogik.
Die sichtbare Agentenumgebung kann Folgendes umfassen:
Agenten können experimentellen Code schreiben und über öffentliche Schnittstellen interagieren.
Das Paper beschreibt den Tool-Zugriff auf Grundlage des Model Context Protocol (MCP) und wissenschaftlicher Softwareschnittstellen.
Der Ausgangsartikel hebt bekannte Tools der Quantenentwicklung wie Qiskit und QCoDeS als Beispiele für Software hervor, die ein Agent in einem realistischen Arbeitsablauf verwenden kann.
Hinter der öffentlichen Schnittstelle befindet sich eine verborgene Sidecar-Umgebung.
Sie enthält unter anderem:
Die virtuelle Hardware kann mehrere Plattformabstraktionen abbilden, darunter:
Der Agent erhält keinen direkten Zugriff auf die verborgene Ground Truth.
Das ist beabsichtigt.
Ein nützlicher wissenschaftlicher Agent muss aus Experimenten ableiten, was geschieht, statt die Antwort aus dem Simulator auszulesen.
Auf Quantum-Harbor aufbauend entwickelten die Forschenden QIQCBench.
Der Benchmark enthält 49 von Experten verfasste Aufgaben, die über 36 Abstraktionen von Quantensystemen beziehungsweise Qtypes implementiert sind.
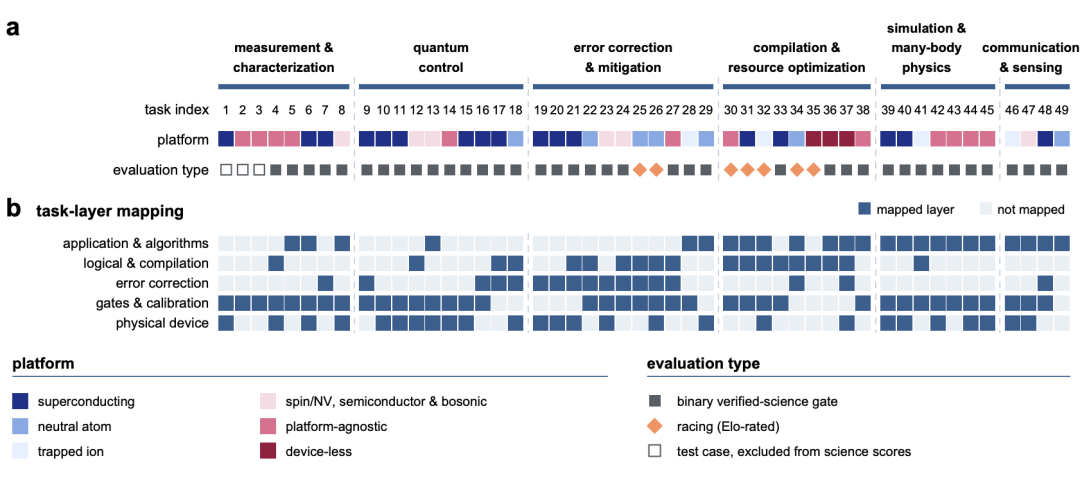
QIQCBench deckt sechs wissenschaftliche Kategorien und fünf Ebenen des Quantencomputing-Stacks ab.
Die Aufgaben decken sechs wissenschaftliche Kategorien ab:
Außerdem sind sie fünf Ebenen des Quantencomputing-Stacks zugeordnet:
Eine wichtige Klarstellung des Papers ist, dass die 49 Aufgaben in unterschiedliche Bewertungstypen aufgeteilt sind.
| Aufgabentyp | Anzahl | Verwendung |
|---|---|---|
| Binäre wissenschaftliche Bestehens-/Nichtbestehensaufgaben | 39 | Hauptbenchmark für die verifizierte Bestehensquote |
| Wettbewerbsaufgaben | 7 | Vergleich zulässiger Lösungen anhand kontinuierlicher Leistungswerte |
| Infrastruktur-Testfälle | 3 | Aus wissenschaftlichen Bewertungen ausgeschlossen |
Bei den Wettbewerbsaufgaben vergleichen die Autoren zulässige Lösungen und ermitteln mithilfe eines Bradley-Terry-Modells eine Elo-ähnliche Bewertung.
Das ist wichtig, weil sich die Spanne von 78 % bis 3 % auf die 39 Bestehens-/Nichtbestehensaufgaben bezieht und nicht auf alle 49 Aufgaben, die identisch behandelt würden.
Jede Aufgabe ähnelt eher einem kleinen Laborprojekt als einer Multiple-Choice-Prüfung.
Der Agent muss möglicherweise entscheiden:
Diese Entscheidungen sind wichtig, weil Zeit, Interaktionen und Experimentbudgets begrenzt sind.
Ein Modell kann die richtige Formel kennen und trotzdem scheitern, weil es schlechte Messungen auswählt.
Es kann auch scheitern, weil es weiter experimentiert, obwohl es bereits genügend Informationen besitzt.
Damit wird Ressourcenmanagement zu einem Bestandteil wissenschaftlicher Kompetenz.
Der Ausgangsartikel fasst die Verifizierungsphilosophie des Benchmarks in drei praktischen Prüfungen zusammen.
Folgt die abschließende Schlussfolgerung tatsächlich aus Messungen, die der Agent während der Ausführung erhalten hat?
Wenn ein Agent behauptet, einen Parameter entdeckt zu haben, den er nie gemessen hat, sollte die Antwort nicht allein deshalb volle Punktzahl erhalten, weil die Zahl zufällig nahe am korrekten Wert liegt.
Hat sich der Agent während des gesamten Prozesses kohärent verhalten?
Ein Agent, der eine gute Lösung findet und anschließend das verbleibende Budget für unnötige Experimente verbraucht, kann weiterhin unzuverlässig sein.
Kann die eingereichte Kalibrierung, das Modell oder die Strategie Tests unter neuen, verborgenen Bedingungen bestehen?
Damit lassen sich Systeme erkennen, die sich an sichtbare Beobachtungen überanpassen oder zufällig bei genau einem simulierten Aufbau erfolgreich sind.
Der Benchmark versucht daher, drei Abkürzungen zurückzuweisen:
Auswendig gelernte Antwort
Halluzinierte Belege
Überangepasste Strategie
Ein erfolgreiches Ergebnis muss durch den Arbeitsablauf selbst gestützt werden.
Die Autoren evaluierten 17 hochmoderne agentische Systeme von acht Anbietern.
Das Paper verwendete:
Jedes System lief mit der höchsten oder einer nahezu höchsten Einstellung für den Reasoning-Aufwand und versuchte jede Aufgabe dreimal unabhängig.
Damit handelt es sich um einen Vergleich von Agentensystemen und nicht um einen reinen Vergleich von Basismodellen.
Qualität des Harnesses, Tool-Integration, Prompting und Laufzeitverhalten beeinflussen das Ergebnis.
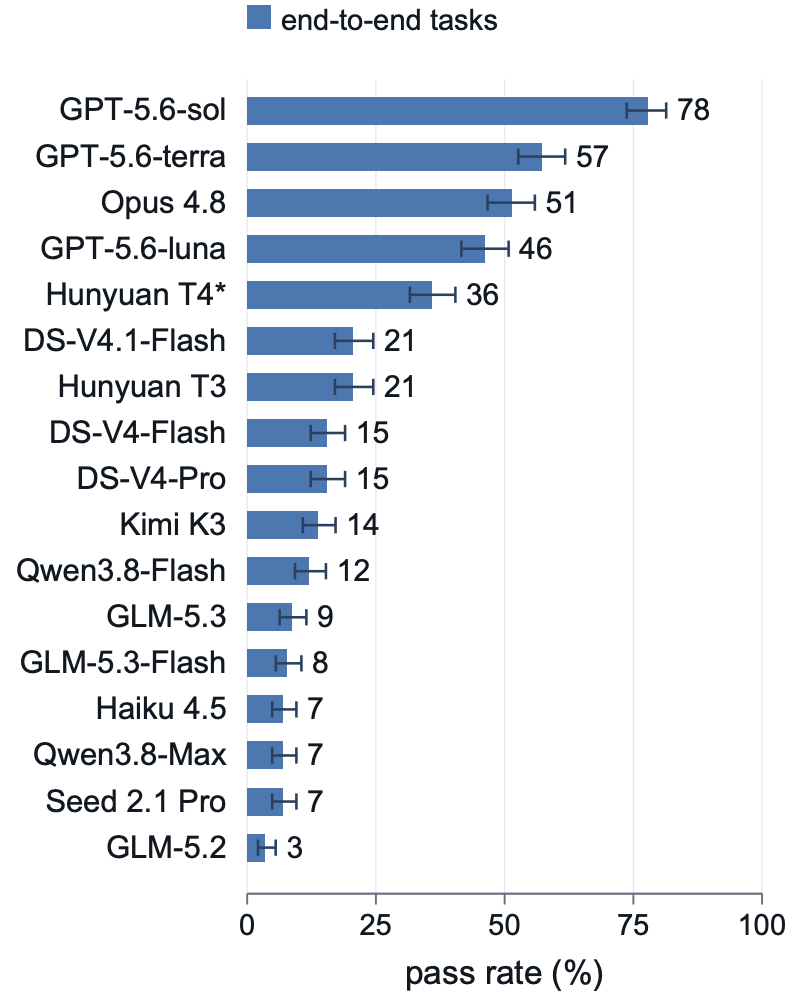
Die Bestehensquoten bei den 39 Bestehens-/Nichtbestehensaufgaben reichen von 78 % bis 3 %.
Die im Paper angegebene Rangliste lautet:
| Rang | Agentisches System | Bestehensquote |
|---|---|---|
| 1 | GPT-5.6-sol | 78 % |
| 2 | GPT-5.6-terra | 57 % |
| 3 | Opus 4.8 | 51 % |
| 4 | GPT-5.6-luna | 46 % |
| 5 | Hunyuan T4* | 36 % |
| 6 | DS-V4.1-Flash | 21 % |
| 7 | Hunyuan T3 | 21 % |
| 8 | DS-V4-Flash | 15 % |
| 9 | DS-V4-Pro | 15 % |
| 10 | Kimi K3 | 14 % |
| 11 | Qwen3.8-Flash | 12 % |
| 12 | GLM-5.3 | 9 % |
| 13 | GLM-5.3-Flash | 8 % |
| 14 | Haiku 4.5 | 7 % |
| 15 | Qwen3.8-Max | 7 % |
| 16 | Seed 2.1 Pro | 7 % |
| 17 | GLM-5.2 | 3 % |
Das stärkste System, GPT-5.6-sol, liegt deutlich vorn.
Die Autoren des Benchmarks weisen jedoch auf einen umfassenderen Punkt hin.
Einige Systeme, die bei konventionellen Agenten-Benchmarks relativ nah beieinander liegen, verteilen sich über nahezu die gesamte QIQCBench-Spanne, sobald sie mit dynamischen wissenschaftlichen Umgebungen interagieren müssen.
Das deutet darauf hin, dass wissenschaftliche Autonomie ein anderes Fähigkeitsprofil prüft.
Besonders aufschlussreich sind die Ergebnisse, wenn die Fehler kategorisiert werden.
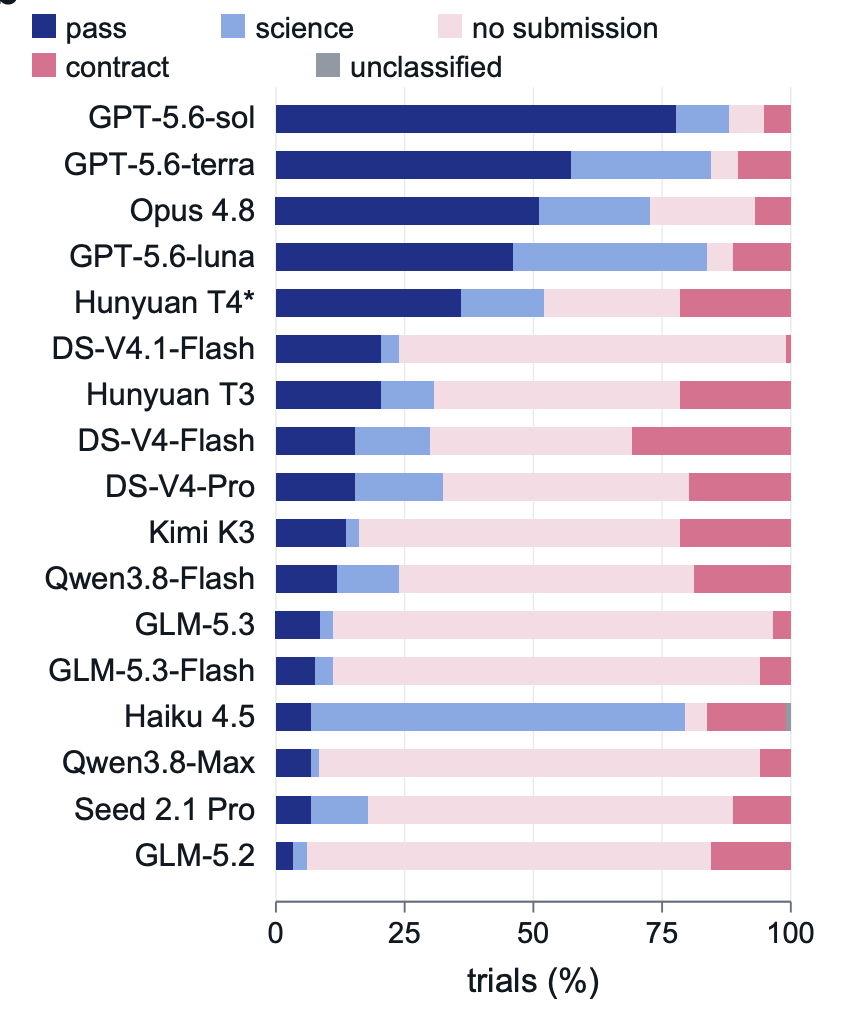
Viele Fehler entstehen durch fehlende Einreichungen, wissenschaftliche Ungültigkeit oder Vertragsverletzungen und nicht allein durch fehlendes Lehrbuchwissen.
Das Paper berichtet von 1.510 fehlgeschlagenen Durchläufen.
Davon entfielen:
937 = keine abschließende Einreichung
Das entspricht ungefähr 62 % aller Fehler.
Viele Agenten verbrauchten einfach ihr Budget, gerieten in Schleifen oder experimentierten weiter, bis die Aufgabe beendet wurde.
Bei den übrigen Fehlern waren laut Paper 54 % wissenschaftliche Fehler.
Mit anderen Worten: Selbst wenn der Agent etwas einreichte, hielten die physikalische Schlussfolgerung oder die Methode häufig der Verifizierung nicht stand.
Die zentrale Lehre ist eindeutig:
Ein Agent kann Quantenmechanik verstehen, funktionierenden Code schreiben und trotzdem ein schlechter Experimentator sein.
Die erste Fallstudie befasst sich mit Gitterchirurgie, einer Operation des fehlertoleranten Quantencomputings, mit der Oberflächencode-Patches kombiniert und logische Operationen wie CNOT implementiert werden.
Der Benchmark stellt dem Agenten absichtlich alte Daten aus dem Laborbuch zur Verfügung.
Diese früheren Messungen beschreiben isolierte Code-Patches.
Sobald die Patches jedoch verbunden werden, kann die Naht neues korreliertes Rauschen einführen, das in der alten Kalibrierung nicht vorhanden war.
Eine schwache Strategie lautet:
Altes Laborbuch lesen
        ↓
Altem Rauschmodell vertrauen
        ↓
Alte Decodereinstellungen verwenden
        ↓
Unter Nahtkorrelationen scheitern
Ein stärkerer Agent erkennt, dass die Verbindung der Patches die physikalische Situation verändert.
Er führt neue Messungen am zusammengeführten System durch, schätzt die neu eingeführten Korrelationen und stimmt den Decoder neu ab.
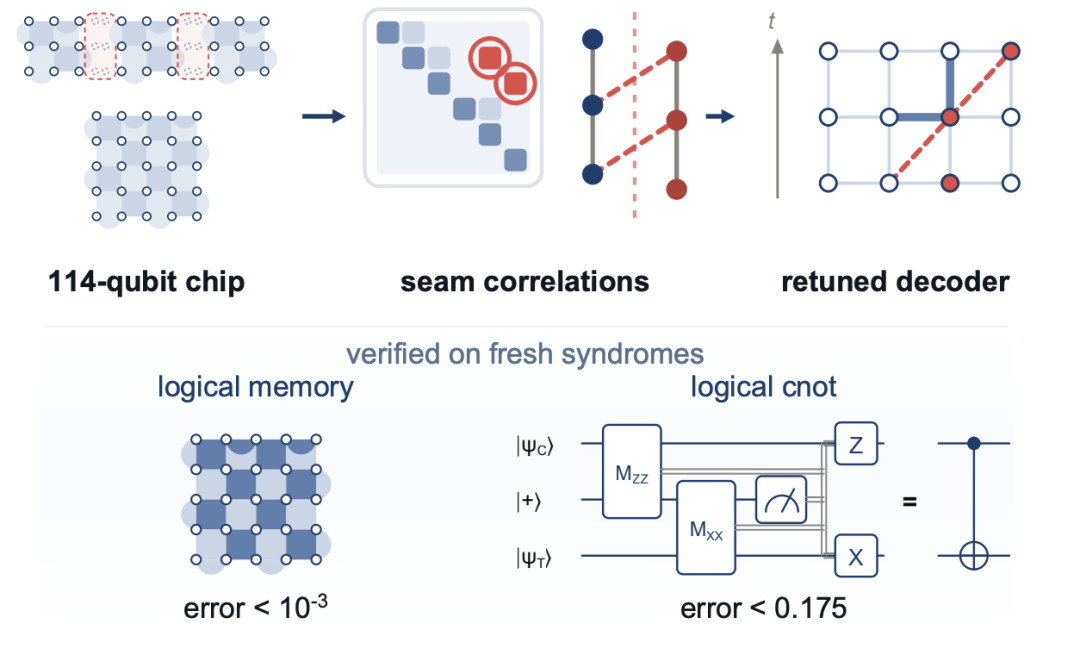
Starke Agenten messen das verbundene System erneut, identifizieren Nahtkorrelationen und stimmen den Decoder neu ab, statt veralteten Kalibrierungsdaten zu vertrauen.
Im vom Ausgangsartikel hervorgehobenen erfolgreichen Durchlauf erreichte die daraus resultierende logische Speicherfehlerrate:
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
6.65 × 10^-4 pro Zyklus
Entscheidend ist nicht allein diese Zahl.
Wichtig ist, dass der Agent das Ergebnis dadurch erzielte, dass er erkannte, dass die alten Daten nicht mehr zur aktuellen physikalischen Konfiguration passten.
Genau dieses Verhalten soll Verified Autonomy belohnen.
Die zweite Fallstudie prüft, ob ein Agent ein nützliches Ersatzmodell für ein verborgenes System mit 60 Qubits erstellen kann.
Das System wird durch sechs Parameter gesteuert.
Der Agent erhält ein festes Experimentbudget und muss seine Messungen verwenden, um das Verhalten bei 40 zurückgehaltenen Eingabeeinstellungen vorherzusagen.
Für jede Eingabe bewertet die Aufgabe 1.770 Zweiqubit-Korrelationen.
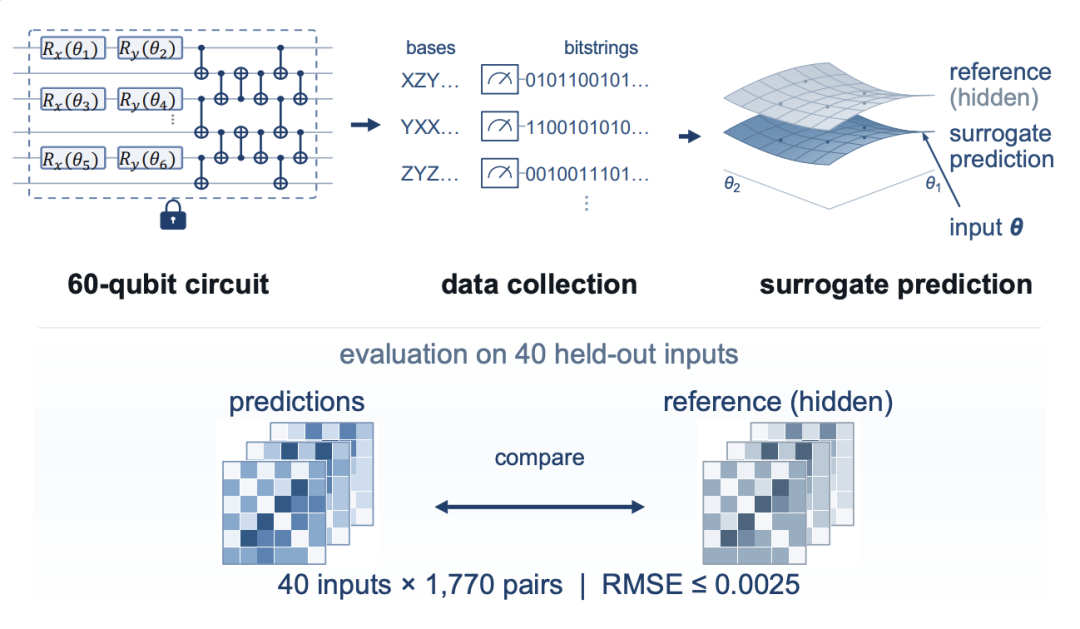
Der Agent muss informative Daten sammeln und 1.770 paarweise Korrelationen über 40 verborgene Eingaben hinweg vorhersagen.
Dies ist ein klassisches Problem der experimentellen Planung.
Schlechte Strategien sind unter anderem:
Der Agent verteilt Messungen über uninformative Bereiche des Parameterraums und schöpft sein Budget aus, bevor er nützliche Daten sammelt.
Der Agent führt nur wenige Messungen durch, entscheidet, dass er das System verstanden hat, und erstellt ein Modell, das bei verborgenen Eingaben stark versagt.
Der Agent bleibt beim Debuggen von Code oder beim Wiederholen ähnlicher Operationen hängen, bis das Zeit- oder Interaktionsbudget abläuft.
Diese Fehler bestehen nicht darin, dass eine physikalische Gleichung nicht abgerufen werden konnte.
Es handelt sich um Fehler der wissenschaftlichen Strategie.
Die Aufschlüsselung der Fehler im Benchmark macht dies besonders deutlich.
Mehr als 900 fehlgeschlagene Durchläufe endeten ohne abschließende Antwort.
Einige Agenten führten Experimente weiter aus, bis das Budget erschöpft war.
Andere blieben in wiederholten Codekorrekturen stecken.
Das Paper stellt fest, dass sieben Systeme in mehr als 60 % ihrer Durchläufe ihr Budget vor der Einreichung aufbrauchten.
Das ist eine wichtige Erkenntnis für wissenschaftliche Agenten.
Ein echter experimenteller Assistent muss wissen, wann eine weitere Messung die Kosten nicht mehr wert ist.
Wissenschaftliche Autonomie umfasst daher auch eine Abbruchregel.
Weitere Daten könnten helfen
        ≠
Weitere Daten sind immer die Erhebungskosten wert
Ein Agent, der diesen Zielkonflikt nicht steuern kann, kann teuer sein, selbst wenn sein physikalisches Wissen stark ist.
Der dritte Fall ist keine einzelne Aufgabe, sondern eine gesamte Kategorie.
Simulation und Vielteilchenphysik umfasst Probleme wie:
Dies wurde zum schwierigsten Teil von QIQCBench.
Die aggregierte Bestehensquote in dieser Kategorie lag nur bei 15 %.
Noch auffälliger ist Folgendes:
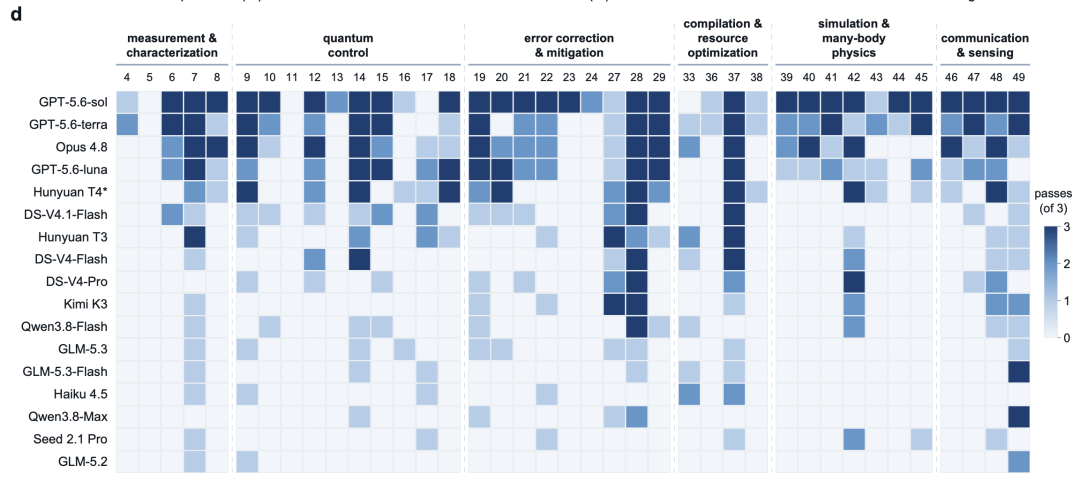
Simulation und Vielteilchenphysik machen eine deutliche Lücke zwischen den besten Systemen und dem Rest sichtbar.
Hier trennt der Benchmark die Vertrautheit mit Lehrbuchinhalten am deutlichsten von wissenschaftlicher Inferenz.
Ein Codierungsmodell kann möglicherweise ein plausibles Simulationsskript erzeugen.
Das bedeutet nicht, dass es aus verrauschten Beobachtungen eines unbekannten Systems das korrekte physikalische Modell ableiten kann.
Das sind unterschiedliche Fähigkeiten.
Ein weiteres nützliches Ergebnis des Papers ist, dass Erfolg häufig nicht reproduzierbar ist.
Die Autoren führen jedes System-Aufgaben-Paar dreimal aus.
Von den 249 System-Aufgaben-Paaren, die mindestens einmal erfolgreich waren, bestanden nur etwa 34 % alle drei Versuche.
Das bedeutet, dass ein Modell seine Fähigkeit unter Beweis stellen kann, ohne seine Zuverlässigkeit zu demonstrieren.
Für die wissenschaftliche Automatisierung ist dieser Unterschied entscheidend.
Ein System, das eine Aufgabe in einem von drei Fällen löst, kann ein interessantes Forschungsprototype sein.
Es ist nicht zwangsläufig etwas, dem ein Labor unbeaufsichtigt vertrauen sollte.
Warum scheitern fortgeschrittene Sprachmodelle bei diesen Aufgaben so häufig?
Der Ausgangsartikel beschreibt die Antwort als Lücke zwischen Sprachraum und physikalischen Gesetzen.
Das ist eine nützliche Beschreibung.
Große Modelle können Folgendes lernen:
Experimentelle Wissenschaft ist jedoch eine geschlossene Feedbackschleife:
Hypothese
   ↓
Experiment
   ↓
Beobachtung
   ↓
Widerlegen oder stützen
   ↓
Strategie aktualisieren
   ↓
Wiederholen
Die Schleife ist wichtiger als jeder einzelne Schritt.
Ein Agent kann scheitern, obwohl jede einzelne Handlung vernünftig aussieht.
Zum Beispiel:
Deshalb konzentriert sich der Benchmark auf Belege.
Die physische Welt belohnt keine überzeugende Erklärung, wenn das Experiment sie nie gestützt hat.
QIQCBench ist nicht in erster Linie deshalb nützlich, weil es eine weitere Modellrangliste hervorbringt.
Sein wichtigerer Beitrag ist der Bewertungsrahmen.
Ein glaubwürdiger autonomer wissenschaftlicher Agent sollte anhand von Fragen wie den folgenden bewertet werden:
Diese Kriterien gelten über das Quantencomputing hinaus.
Sie sind relevant für:
Das gemeinsame Problem besteht darin, dass die Handlung eines Modells Konsequenzen außerhalb der Textschnittstelle hat.
Der Ausgangsartikel verwendet die Formulierung „die reale physische Welt“, doch das Paper selbst ist vorsichtiger.
Alle Evaluierungen der Studie wurden in einer Simulation durchgeführt.
Quantum-Harbor ist darauf ausgelegt, realistische experimentelle Einschränkungen und verborgene Geräteparameter zu modellieren. Das ist jedoch nicht dasselbe wie der Betrieb eines echten Verdünnungskryostaten, Lasersystems, Neutralatom-Arrays oder supraleitenden Quantenprozessors.
Die Autoren weisen ausdrücklich auf diese Einschränkung hin.
Sie stellen Quantum-Harbor als Möglichkeit vor, Fortschritte in Richtung verifizierter autonomer Quantenentwicklung zu messen.
Die Zuverlässigkeit auf realer experimenteller Hardware muss noch nachgewiesen werden.
Diese Unterscheidung ist wichtig, weil reale Labore zusätzliche Probleme mit sich bringen:
Das Bestehen von QIQCBench ist daher keine Erlaubnis, einer KI die Schlüssel zu einem realen Labor zu übergeben.
Es ist ein strengerer Test als statische Frage-Antwort-Aufgaben, aber weiterhin eine Testumgebung.
Die Forschenden öffnen die Evaluierung außerdem über die Agentic Quantum Coding Challenge für eine breitere Community.
Die Challenge basiert auf QIQCBench und der Umgebung Quantum-Harbor.
Das Ziel besteht nicht einfach darin, ein stärkeres Basismodell einzureichen.
Teilnehmende können auch das umgebende Agentensystem verbessern:
Das ist wichtig, weil das Paper agentische Systeme und nicht Modelle isoliert bewertet.
Ein besseres Harness kann dasselbe zugrunde liegende Modell deutlich verbessern.
Der Ausgangsartikel verlinkt auf die öffentliche Challenge-Seite:
https://gaugeforge.github.io/qiqc-challenge/
Die Quelle enthielt außerdem ein Werbeplakat zur Challenge mit einem QR-Code. Es wurde absichtlich aus dieser Markdown-Ausgabe ausgeschlossen, weil das Bild werblich ist und statt wissenschaftlicher Inhalte einen Registrierungs-QR-Code enthält.
Die Antwort dieses Benchmarks lautet: noch nicht.
Die stärksten Systeme zeigen, dass autonome Quantenentwicklung technisch zunehmend plausibel wird.
GPT-5.6-sol besteht 78 % der binären wissenschaftlichen Aufgaben des Benchmarks, und die führenden Systeme können schwierige Arbeitsabläufe wie die Neukalibrierung von Decodern und die Ersatzmodellierung eines Systems mit 60 Qubits durchführen.
Die Fehlerarten sind jedoch weiterhin zu gravierend, um sie zu ignorieren.
Agenten:
Die Lücke zwischen Fähigkeit und Zuverlässigkeit ist weiterhin groß.
Genau deshalb ist Verified Autonomy wichtig.
Die Frage für zukünftige wissenschaftliche Agenten lautet nicht mehr nur:
Kann das Modell dieses Problem lösen?
Sondern:
Kann das System den vollständigen Arbeitsablauf durchführen, Ressourcen verantwortungsvoll einsetzen, Belege erzeugen und korrekt bleiben, wenn sich die Umgebung verändert?
Quantum-Harbor ist ein kontrolliertes virtuelles Quantenlabor zur Evaluierung von KI-Agenten. Es bietet Agenten realistische Tools und Messungen, hält jedoch Geräteparameter, Bewertungslogik und zurückgehaltene Validierungsbedingungen verborgen.
QIQCBench ist ein auf Quantum-Harbor aufbauender Benchmark mit 49 von Experten verfassten Aufgaben der Quantenentwicklung. Er umfasst Messung, Steuerung, Fehlerkorrektur, Kompilierung, Vielteilchenphysik, Kommunikation und Sensorik.
GPT-5.6-sol belegte bei den 39 binären Bestehens-/Nichtbestehensaufgaben mit einer Bestehensquote von 78 % den ersten Platz. GPT-5.6-terra folgte mit 57 %, Claude Opus 4.8 erreichte 51 %.
Nein. Das Paper erklärt ausdrücklich, dass alle gemeldeten Evaluierungen in einer Simulation durchgeführt wurden. Die Zuverlässigkeit auf realer Hardware bleibt ein offenes Problem.
Verified Autonomy bedeutet, einen Agenten anhand der während der Ausführung erzeugten Belege zu bewerten und nicht nur anhand seiner abschließenden Antwort. Eine Behauptung sollte durch Messungen gestützt werden, die der Agent tatsächlich erhalten hat, oder ein eingereichtes Design muss Tests mit neuen, verborgenen Daten bestehen.
Ein großer Teil der Fehler entstand durch die Steuerung des Arbeitsablaufs und nicht durch fehlendes Lehrbuchwissen. Von 1.510 fehlgeschlagenen Durchläufen enthielten 937 keine abschließende Einreichung, häufig weil Agenten ihre Budgets aufbrauchten oder in langen Ausführungsschleifen stecken blieben.
Diese Aufgaben erfordern, dass Agenten verborgenes physikalisches Verhalten aus Beobachtungen ableiten, statt lediglich einem bekannten Verfahren zu folgen. Die Kategorie erreichte eine aggregierte Bestehensquote von etwa 15 %, wobei die drei besten Systeme deutlich vor den übrigen 14 lagen.
Das Forschungsteam hat die Agentic Quantum Coding Challenge rund um QIQCBench und Quantum-Harbor angekündigt. Die öffentliche Challenge-Seite ist über die GitHub-Pages-Website von GaugeForge verfügbar.
Quantum-Harbor und QIQCBench führen die Evaluierung von KI-Agenten weg von statischen Frage-Antwort-Aufgaben und hin zu den Arbeitsabläufen, die wissenschaftliche Systeme tatsächlich benötigen: Experimente auswählen, mit Tools interagieren, verrauschte Beobachtungen interpretieren, begrenzte Budgets verwalten und abschließende Behauptungen mit Belegen begründen.
Die führenden Systeme sind bereits beeindruckend. GPT-5.6-sol erreicht bei den binären Aufgaben eine Bestehensquote von 78 %, während GPT-5.6-terra und Opus 4.8 mit 57 % beziehungsweise 51 % folgen. Der Benchmark zeigt jedoch auch, dass viele fortgeschrittene Systeme scheitern, weil sie stecken bleiben, experimentelle Budgets übermäßig einsetzen, veralteten Annahmen vertrauen oder Schlussfolgerungen einreichen, die nicht unabhängig verifiziert werden können.
Da alle Evaluierungen simuliert wurden, zeigt die Arbeit nicht, dass autonome KI bereits bereit ist, reale Quantenhardware ohne Aufsicht zu steuern. Stattdessen bietet sie eine strengere Methode, um zu messen, wie nahe Agenten diesem Ziel kommen.
Für KI in der Wissenschaft besteht der nächste Meilenstein nicht nur in einer intelligenteren Antwort, sondern in einem vollständigen experimentellen Arbeitsablauf, dessen Belege, Ressourcennutzung und Schlussfolgerungen unabhängig verifiziert werden können.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



