For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/recursive-self-improvement-what-ai-resear-557e0db8.md.
KI-Systeme übernehmen immer mehr Aufgaben beim Entwickeln von KI: Sie schreiben Software, debuggen Infrastruktur, führen Experimente durch u...
KI-Systeme übernehmen immer mehr Aufgaben beim Entwickeln von KI: Sie schreiben Software, debuggen Infrastruktur, führen Experimente durch und schlagen nächste Schritte vor. Dadurch wird die rekursive Selbstverbesserung, meist zu RSI abgekürzt, zu einer zunehmend praxisrelevanten Forschungsfrage.
Entscheidend ist die Unterscheidung, ob KI einen von Menschen gesteuerten Prozess beschleunigt oder eigenständig einen leistungsfähigeren Nachfolger entwerfen und entwickeln kann. Der vorliegende BAAI-Bericht beschreibt eine Branche, die sich in Richtung Letzteres bewegt. Öffentliche Forschung liefert konkrete Belege für Ersteres, während weiterhin erhebliche Unsicherheit darüber besteht, wie weit dieser Fortschritt reichen wird.
In der Forschungsdiskussion von Anthropic bedeutet vollständige RSI, dass ein System autonom dazu fähig wird, seinen Nachfolger zu entwerfen und zu entwickeln. Ein Coding-Agent, der ein Trainingsskript verbessert, kann zu diesem Prozess beitragen, ohne den gesamten Kreislauf zu schließen.
Daran sind mehrere unterschiedliche Fähigkeiten beteiligt:
Erfolg auf einer Stufe belegt keinen Erfolg auf jeder folgenden Stufe. Anthropic erklärt ausdrücklich, dass vollständige RSI nach seiner Darstellung bislang nicht erreicht wurde und nicht unvermeidlich ist.
Anthropic berichtet, dass Stand Mai 2026 Claude mehr als 80 % des in seine Codebasis gemergten Codes verfasst hat. Dabei handelt es sich um eine Zuordnung für gemergten Code und nicht um die Behauptung, KI habe mehr als 80 % aller Engineering-Entscheidungen getroffen.
Das Unternehmen berichtet außerdem, dass die typische Codeausgabe pro Ingenieur im zweiten Quartal 2026, gemessen an gemergten Codezeilen pro Tag, bei etwa dem Achtfachen des Niveaus von 2024 lag. Der eigene Vorbehalt ist wesentlich: Codezeilen messen Menge nur unvollkommen und sollten nicht als achtfacher Anstieg der nützlichen Produktivität verstanden werden.
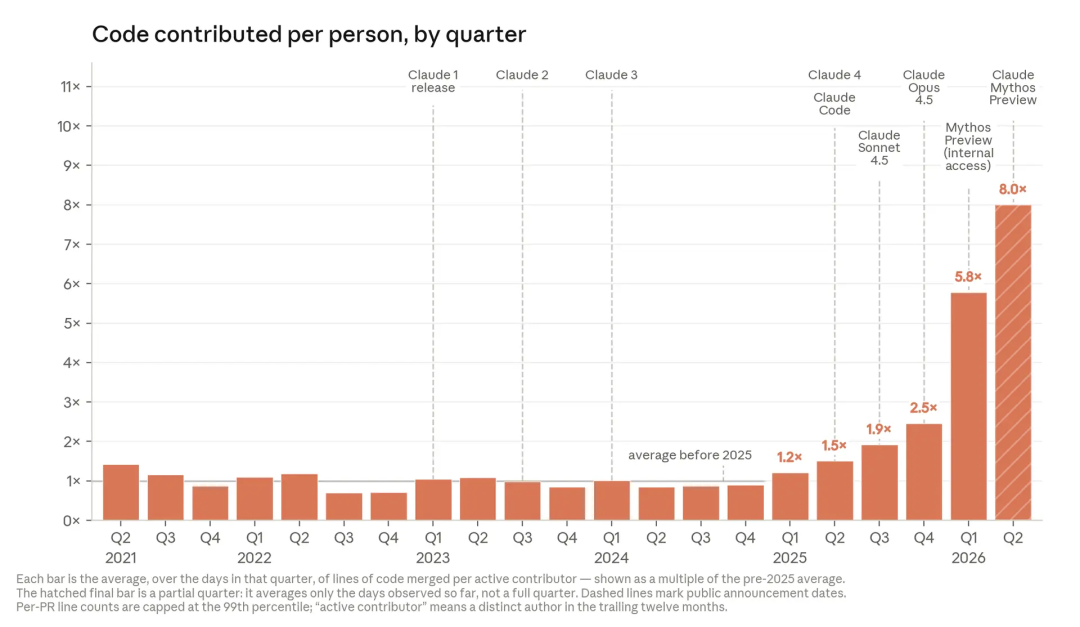
Anthropic-Diagramm, reproduziert im Xinzhiyuan-Artikel auf BAAI Hub.
Die praktische Veränderung besteht darin, dass ein Ingenieur mehr Arbeit anleiten und prüfen kann, ohne jede Implementierung selbst tippen zu müssen. Ziele, Codequalität, gemeinsame Infrastruktur und Prüfungskapazität bleiben jedoch einschränkende Faktoren. Dies belegt nicht, dass menschliche Überprüfung unnötig geworden ist.
Eine Implementierung zu schreiben, ist nur ein Teil der Forschung. Ein Agent muss außerdem Experimente durchführen, Ergebnisse untersuchen und entscheiden, ob eine Änderung tatsächlich geholfen hat.
Anthropic beschreibt einen wiederholten Optimierungstest, bei dem ein Modell Trainingscode erhält und versucht, ihn schneller zu machen, ohne Korrektheitsprüfungen zu beeinträchtigen. Die Ergebnisse verbesserten sich über Modellgenerationen hinweg deutlich. Das Unternehmen warnt, dass die absolute Beschleunigung davon abhängt, wie viel Optimierungspotenzial im Ausgangscode vorhanden ist; sie ist kein Maß für eine entsprechende Beschleunigung beim Training von Frontier-Modellen.
Das Projekt zur automatisierten Weak-to-Strong-Forschung liefert ein weiteres Beispiel. Agenten konnten innerhalb eines von Menschen ausgewählten Problems und Bewertungsrahmens Experimente vorschlagen und ausführen. Dies ist ein Beleg für Forschungsautomatisierung innerhalb vorgegebener Grenzen, nicht für den Nachweis, dass das System eigenständig die wertvollste Forschungsagenda ausgewählt hat.
SWE-bench bewertet Softwareänderungen anhand von Repository-Aufgaben und Tests. METRs Zeithorizonte für Aufgabenabschlüsse untersuchen die Länge von Aufgaben, die Modelle bei festgelegten Zuverlässigkeitsniveaus abschließen können.
Diese Messungen beantworten unterschiedliche Fragen. Ein System kann besser darin werden, Repository-Probleme zu beheben oder längere Aufgaben abzuschließen, ohne selbstständig ein erfolgreiches Programm zur Modellentwicklung planen zu können.
Ergebnisse zu Zeithorizonten sind zudem probabilistisch. Eine Aufgabendauer in einem Benchmark bedeutet nicht, dass der Agent an jedem Projekt zuverlässig über dieselbe reale Zeitspanne arbeiten wird. Menschliche Referenzwerte, Erfolgsschwellen, Tool-Zugriff und die Aufgabenverteilung sind jeweils relevant.
Der Quellartikel verweist auf Diskussionen in sozialen Medien über interne Agenten, kürzere Release-Zyklen, unveröffentlichte Modelle und umfangreiche wissenschaftliche Ergebnisse. Solche Berichte können auf Themen hinweisen, die einer Untersuchung wert sind, belegen aber nicht eigenständig einen autonomen Selbstverbesserungskreislauf.
Kürzere Veröffentlichungsintervalle können verschiedene Ursachen haben. Dass ein Modell schwierige Mathematik löst, demonstriert eine Fähigkeit bei diesen Problemen; es zeigt für sich genommen nicht, dass das Modell seinen eigenen Trainingsprozess verbessert hat. Ebenso ersetzt eine anonyme Behauptung über das interne Modell eines Labors keinen technischen Bericht mit reproduzierbaren Belegen.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Die belastbare Schlussfolgerung ist enger gefasst: Öffentliche Offenlegungen zeigen, dass KI einen wachsenden Anteil von Engineering und Teilen experimenteller Forschung übernimmt. Ob dieser Fortschritt zu vollständiger RSI wird, bleibt eine offene Frage.
Anthropic erörtert sowohl potenzielle Vorteile als auch Risiken einer zunehmend automatisierten Entwicklung. Leistungsfähigere Forschungsagenten könnten wissenschaftliche Arbeit beschleunigen, während sie Verifikation, Überwachung und Alignment anspruchsvoller machen.
Derselbe Prozess kann auch gewöhnliche operative Engpässe schaffen. Wenn Agenten Code schneller generieren, als Menschen ihn prüfen können, führt eine schnellere Generierung nicht unmittelbar zu einer schnelleren, zuverlässigen Bereitstellung. Verfügbarkeit von Rechenleistung, Qualität der Experimente und Entscheidungen darüber, was entwickelt werden soll, bleiben relevant, selbst wenn Implementierung günstiger wird.
Daher sollte eine Bewertung von RSI Belege für jede Phase verfolgen: Was der Agent getan hat, wer sein Ziel ausgewählt hat, welche Ressourcen er eingesetzt hat und wie das Ergebnis geprüft wurde.
RSI steht für rekursive Selbstverbesserung. In diesem Kontext bezeichnet es ein KI-System, das autonom einen leistungsfähigeren Nachfolger entwerfen und entwickeln kann, anstatt einem Menschen lediglich bei der Verbesserung von Software zu helfen.
Codegenerierung zeigt, dass ein Teil des Entwicklungsprozesses automatisiert werden kann. Vollständige RSI würde eine wesentlich breitere Kombination aus Forschungsrichtung, Implementierung, Training und Evaluierung erfordern. Ein hoher Anteil von KI-verfasstem Code ist daher kein hinreichender Beleg.
Sie bezieht sich auf Claude zugeschriebenen Code, der Stand Mai 2026 in Anthropics Codebasis gemergt wurde. Sie sollte nicht als Anteil aller autonom erledigten Unternehmensarbeit oder als Anteil strategischer Entscheidungen durch KI interpretiert werden.
Sie können eine Veränderung des Ausgabevolumens anzeigen, messen jedoch nicht unmittelbar Nutzen, Wartbarkeit oder Geschäftswert. Anthropic selbst weist darauf hin, dass sein achtfacher Anstieg der Codeausgabe den tatsächlichen Produktivitätsgewinn wahrscheinlich überschätzt.
Sie beschreiben die Leistung bei einer bestimmten Sammlung von Aufgaben unter angegebenen Erfolgsniveaus und verwenden menschliche Aufgabendauern als Referenz. Sie garantieren nicht, dass ein Agent jeden gleich langen Praxisauftrag erledigen kann.
Ja. Ein Agent kann Experimente innerhalb eines von Menschen vorgegebenen Problem- und Bewertungsrahmens entwerfen und durchführen. Das kann wertvolle Forschungsautomatisierung sein, während übergeordnete Entscheidungen bei Menschen bleiben.
Die zentrale Anthropic-Diskussion erklärt ausdrücklich, dass sie nicht unvermeidlich ist. Forschungsurteil, Rechenleistung, Infrastruktur, Evaluierung und andere Engpässe könnten die Entwicklung begrenzen oder verändern; Prognosen sollten von nachgewiesenen Ergebnissen getrennt bleiben.
Öffentliche Belege stützen einen erheblichen Anstieg von KI-gestütztem Coding und abgegrenzter Forschungsautomatisierung. Diese Fortschritte machen die Möglichkeit rekursiver Selbstverbesserung untersuchenswert, belegen jedoch nicht, dass ein vollständig autonomer Kreislauf zur Entwicklung eines Nachfolgemodells bereits existiert.
Die entscheidende Frage ist, welche Teile der KI-Entwicklung ein System unabhängig ausführen und überprüfen kann, und nicht, wie spektakulär sein Release-Zeitplan oder ein Benchmark in den Schlagzeilen wirkt.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



