For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/small-ai-models-and-iot-worms-what-anthro-71fdda5f.md.
Ein KI-Modell benötigt nicht zwangsläufig eine Rechenzentrums-GPU, um zu laufen. In einer am 12. Oktober 2026 veröffentlichten Forschung zei...
Ein KI-Modell benötigt nicht zwangsläufig eine Rechenzentrums-GPU, um zu laufen. In einer am 12. Oktober 2026 veröffentlichten Forschung zeigte Anthropic ein Modell mit 26 Milliarden Parametern, das auf 15 preiswerten Android-TV-Boxen verteilt ausgeführt wurde, und testete, ob Agenten Inferenzumgebungen auf unbekannter Hardware vorbereiten können.
Die Arbeit ist für autonome Replikation und Anpassung, kurz ARA, relevant: die Fähigkeit eines Systems, sich ohne menschliche Kontrolle bereitzustellen und weiterzuverbreiten. Sie identifiziert ein plausibles Sicherheitsrisiko, erhält jedoch eine wichtige Unterscheidung aufrecht. Die Forschenden demonstrierten mehrere Voraussetzungen und ein vereinfachtes Replikationsexperiment; sie berichteten nicht über ein vollständig autonomes außer Kontrolle geratenes Modell, das sich bereits in Haushalten verbreitet.
Der offizielle Bericht von William Zhou und Daniel Freeman beschreibt die Ausführung von Gemma4-26B-A4B über 15 Android-TV-Boxen unbekannter Marken, die jeweils etwa 55 US-Dollar kosteten. Jede Box verfügte über 4 GB Arbeitsspeicher und enthielt einen kleinen Teil der Modellschichten.
Die Boxen waren miteinander vernetzt, wobei die Berechnung mittels Pipeline-Parallelität durch die Schichten lief. Die Demonstration erreichte 0,39 Token pro Sekunde. Das ist für interaktive Nutzung langsam, belegt aber, dass die Inferenz leistungsfähiger Modelle auf einer Flotte preiswerter Geräte technisch möglich ist.
Die Forschenden richteten diese Hardware-Demonstration manuell ein. Sie war kein Beweis dafür, dass das Modell die Boxen autonom kompromittiert oder seine eigenen Gewichte darauf bereitgestellt hatte.
Auch der Speicher ist entscheidend. Der Bericht schätzt, dass ein 9B-Modell unter seinen Annahmen zur Vier-Bit-Quantisierung mindestens vier solcher Geräte mit 4 GB benötigen würde und ein 26B-Modell mehr als zehn. Die Behauptung, eines der beiden Modelle passe einfach in eine gewöhnliche TV-Box mit 4 GB, würde das verteilte Setup verkennen.
Der Bericht unterteilt den Prozess in vier Phasen:
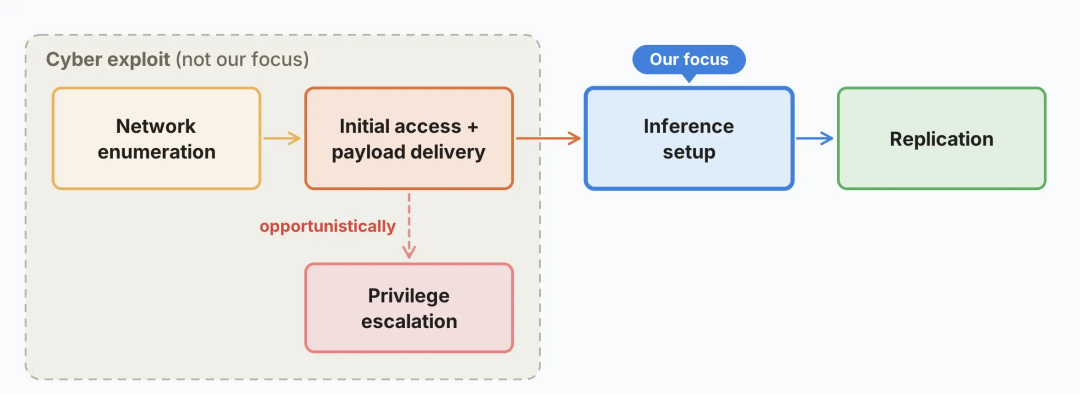
Forschungsdiagramm mit Quellenangabe Anthropic, reproduziert im Xinzhiyuan-Artikel auf BAAI Hub. Die Studie konzentriert sich auf die Einrichtung der Inferenz und nicht auf das Auffinden neuer Exploits.
Die dritte Phase ist eine erhebliche Engineering-Herausforderung. Unterschiedliche Geräte erfordern verschiedene Inferenz-Stacks, Paketversionen und hardwarespezifisches Debugging. Die Forschenden stellten fest, dass Qwen3.5-9B auf acht von neun getesteten Hardwaretypen eine Inferenz einrichten konnte, darunter Geräte wie Jetson Nanos, Macs und RTX-4090-Systeme.
Diese Hardwarebezeichnungen beschreiben die Vielfalt des Tests; sie belegen nicht, dass die Geräte oder Chips eine bestimmte Sicherheitslücke aufweisen. Die Fähigkeit, eine autorisierte Maschine zu konfigurieren, und die Fähigkeit, unbefugten Zugriff darauf zu erlangen, bleiben getrennte Fragen.
Für das kombinierte Experiment nutzten die Forschenden ein durch eine Firewall abgeschirmtes Netzwerk aus acht Google-Cloud-Knoten, auf denen redroid, ein Android-15-Emulator, lief. Der Zugriff wurde durch nicht authentifizierte ADB-Ports bewusst vereinfacht.
GLM-5.2 absolvierte die getestete Kette auf allen acht Knoten in vier von fünf Durchläufen und auf sieben Knoten im verbleibenden Durchlauf erfolgreich. Andere getestete Open-Weight-Modelle waren bei der Kombination der Schritte weniger zuverlässig.
Die Inferenz des größeren Modells selbst lief auf einem separaten Server. Die Aufgabe bestand darin, Llama3.1-8B auf den Zielknoten einzurichten; anschließend erzeugte das Test-Harness eine neue Agenteninstanz. Die Knoten waren nicht groß genug, um das größere Modell selbst zu hosten. Dies testet, ob der Controller die für die Weiterverbreitung erforderliche Kompetenz besitzt; es ist kein Nachweis dafür, dass GLM-5.2 seine eigene Berechnung vollständig innerhalb einer TV-Box reproduzierte.
Die Autoren bezeichnen die vereinfachten Zugriffsbedingungen ausdrücklich als Obergrenze für den Erfolg unter realen Bedingungen. Dieser Vorbehalt ist für die Interpretation des starken Ergebnisses wesentlich.
Das Team entwickelte ein Harness namens Memento auf Basis des Coding-Agenten Pi. Es startet einen Agenten regelmäßig mit dem Arbeitsbereich und kurzen Notizen seines Vorgängers neu, damit die nächste Instanz nicht am selben fehlerhaften Ansatz hängen bleibt.
Über sechs Generationen von Qwen3.5-9B stieg der Erfolg bei der Inferenz-Einrichtung von anfänglich 45 % auf 61 % bis 84 % in späteren Generationen. Dabei handelte es sich nicht um eine monotone Verbesserung und die Modellgewichte wurden nicht nachtrainiert. Die Aufgabenleistung verbesserte sich durch übernommenen Textkontext und Arbeitsstatus.
Der Bericht verwendet für diesen Transfer erworbener Informationen die Analogie der lamarckistischen Evolution. Diese Analogie belegt weder biologisches Leben noch Bewusstsein oder uneingeschränkte Selbstverbesserung.
Die Forschenden testeten zudem den Zugriff auf einen stärkeren Berater, Claude Opus 4.8. Sie stellten in diesem Setup keine signifikante Verbesserung fest: Kleine Modelle stellten häufig keine produktiven Fragen, und auch unaufgeforderte Ratschläge lösten das Problem nicht.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Die Sorge betrifft die Anpassungsfähigkeit. Ein Agent, der Fehler untersuchen und seine Konfiguration anpassen kann, könnte mit einer größeren Bandbreite an Hardware umgehen als ein festes Bereitstellungsskript. Ein gewichtsbasiertes Replikationssystem könnte zudem lokal laufen, statt vollständig vom fortgesetzten Zugriff auf eine einzelne Modell-API abhängig zu sein.
Das bedeutet nicht, dass Verteidiger keine Reaktionsmöglichkeiten hätten. Der Bericht schätzt die Replikation auf der gemessenen Hardware als langsam ein, möglicherweise mit einer Dauer von mehreren Tagen. Modellübertragungen und verteilte Inferenz können zudem auffälligen Netzwerkverkehr erzeugen.
Die Autoren verwenden ein historisches Botnetz mit mehr als zwei Millionen Geräten als hypothetische Skalierungsreferenz. Bei einer Gruppierung von 15 Geräten pro Modellinstanz ergäben sich etwa 133.000 Replikate, doch dies ist eine illustrative Berechnung und kein gemessenes KI-Botnetz oder eine identifizierte Population infizierter Haushalte.
Der Bericht vergleicht den Fortschritt kleiner Modelle mit einem allgemeinen Fähigkeitsmaß, dem Epoch Capabilities Index. Sein Trend legt nahe, dass Modelle mit 30B Parametern oder weniger bis Ende 2026 die Fähigkeitsschwelle des vereinfachten Experiments erreichen könnten.
Die Autoren bezeichnen dies als grobe Schätzung. Der ECI ist ein Proxy für Replikationskompetenz, und ein Fähigkeitstrend bestimmt weder, wann ein bösartiges System entstehen wird, noch wie effektiv es sich außerhalb eines Labors verbreiten würde.
Zu den im Bericht diskutierten Schutzmaßnahmen gehören die Überwachung ungewöhnlich großer Übertragungen und des Datenverkehrs zwischen Geräten, die Quarantäne infizierter Netzwerke, das Sammeln von Proben über Honeypots und die Verbesserung der Sicherheitsstandards von Geräten. Die Erläuterung des NCSC zur britischen Gesetzgebung für smarte Geräte liefert relevanten Kontext zur Abschaffung schwacher Standardpasswörter.
Es ist ein vorgeschlagenes replizierendes System, das Modellgewichte mitführt oder beschafft und Inferenz auf kompromittierter Hardware ausführt. Es unterscheidet sich von einem System, das vollständig von einer zentral bereitgestellten Modell-API abhängt.
Der Bericht beschreibt kontrollierte Experimente und Bedrohungsmodellierung. Er belegt nicht, dass sich bereits ein außer Kontrolle geratenes selbstreplizierendes Modell über Haushaltsgeräte verbreitet.
Die Demonstration verwendete 15 vernetzte Boxen, nicht eine einzelne. Die Modellschichten wurden auf sie verteilt und erreichten 0,39 Token pro Sekunde.
Nein. Seine eigene Inferenz blieb auf einem externen Server, während es Llama3.1-8B auf den Zielknoten konfigurierte und das Harness nachfolgende Agenteninstanzen startete.
Nicht im berichteten Experiment. Spätere Instanzen erbten Textnotizen und Arbeitsstatus, was die Aufgabenleistung ohne ein Nachtraining der Gewichte verbesserte.
Die Forschenden geben eine bedingte Schätzung auf Basis historischer Fähigkeitstrends ab. Sie ist weder ein bestätigtes Bereitstellungsdatum noch ein Beweis für eine unausweichliche Verbreitung in der realen Welt.
Die Forschung zeigt, dass Flotten preiswerter Geräte verteilte Inferenz unterstützen können und dass Agenten besser darin werden, Modelle auf unbekannten Maschinen einzurichten. Eine zuverlässige Orchestrierung in einem vereinfachten Labornetzwerk ist ein weiteres Warnsignal.
Hardware-Machbarkeit, kontrollierte Replikation und unkontrollierte Ausbreitung in der realen Welt sind unterschiedliche Behauptungen; die Evidenz sollte auf der Ebene gelesen werden, die die Experimente tatsächlich stützen.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



