Tencent Hunyuan hat die Vorschauversion von Hy ASR 3.0 veröffentlicht, ein neues Echtzeit-Spracherkennungsmodell, das auf den Sprachverständ...
Tencent Hunyuan hat die Hy ASR 3.0 Vorschauversion veröffentlicht, ein neues Echtzeit-Spracherkennungsmodell, das auf den Sprachverständnisfähigkeiten von Hy3 basiert.
Das Modell soll die automatische Spracherkennung über die isolierte akustische Dekodierung hinausführen.
Traditionelle ASR-Systeme beantworten hauptsächlich eine Frage:
Welche Wortfolge passt am besten zu diesem Audio?
Hy ASR 3.0 fügt eine zweite Frage hinzu:
Welche Transkription ist im Kontext am sinnvollsten?
Dieser Unterschied ist entscheidend, wenn das Audio Folgendes enthält:
Tencent gibt an, dass das Modell ein hochpräzises akustisches System mit Hy3s Kontextmodellierung und semantischen Schlussfolgerungsfähigkeiten kombiniert. Das Ziel ist nicht, das Gesagte kreativ umzuschreiben, sondern bei mehrdeutigem Audio den Sprachkontext zu nutzen, um die plausiblere Transkription auszuwählen.
Tencent berichtet eine Wortfehlerrate von 3,34 % für Mandarin, 2,62 % für Englisch und 3,12 % für Kantonesisch auf aggregierten öffentlichen Evaluierungssätzen.
Hy ASR 3.0 Vorschauversion ist nun als dokumentiertes Echtzeit-WebSocket-Engine von Tencent Cloud verfügbar und in den Tencent Yuanbao-Assistenten integriert. WorkBuddy und andere Tencent-Produkte werden schrittweise angebunden.
Die öffentliche Vorschauversion ist zwar verfügbar, hat jedoch noch nicht den endgültigen Produktumfang erreicht, der in der breiteren Ankündigung beschrieben wurde. Die aktuellen API-Einschränkungen sind für Teams mit Produktionsintegration von Bedeutung.
Tencent hat Hy ASR 3.0 Vorschauversion auf mehreren öffentlichen Sprachdatensätzen evaluiert und mit anderen ASR-Systemen verglichen.
Die vom Unternehmen berichteten aggregierten Wortfehlerraten:
| Sprache oder Sprachvariante | Hy ASR 3.0 Vorschauversion WER |
|---|---|
| Mandarin | 3,34 % |
| Englisch | 2,62 % |
| Kantonesisch | 3,12 % |
Je niedriger der WER, desto besser.
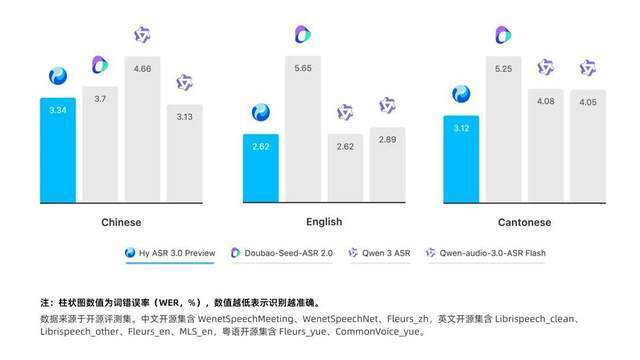
Die Diagrammanmerkung zeigt, dass die aggregierte Auswertung folgende Datensätze verwendet:
Aggregierte Daten ermöglichen grobe Vergleiche, können aber auch wichtige Unterschiede verschleiern.
Die Leistung des Modells kann je nach Szenario variieren:
Produktionsteams sollten daher mit eigenen Audiodaten testen.
Statt den ASR-Anbieter allein anhand einer einzelnen WER-Zahl auszuwählen.
Die Wortfehlerrate wird üblicherweise definiert als:
WER = (Substitutionen + Löschungen + Einfügungen) / Anzahl der Referenzwörter
Die drei Fehlertypen sind:
Ein niedrigerer WER bedeutet in der Regel eine genauere Transkription.
Der WER deckt jedoch nicht alle Fehlerfälle in realen Szenarien ab.
Betrachten wir zwei Ein-Wort-Fehler:
„Versand der Bestellung morgen“
→ „Versand der Bestellung heute“
Und:
„Die Farbe ist marineblau“
→ „Die Farbe ist marineblau“ (mit anderer Schreibweise)
Beide können ähnliche Fehlerzahlen erzeugen, aber der erste könnte eine geschäftliche Aktion ändern, während der zweite möglicherweise keinerlei geschäftliche Auswirkung hat.
Für Bereiche wie Kundenservice, Gesundheitswesen, Finanzen, Fertigung und Befehlschnittstellen sollten Teams sowohl die semantische Auswirkung als auch den WER bewerten.
Tencent hat außerdem Ergebnisse interner Evaluierungssätze veröffentlicht, die vier praktische Kategorien abdecken:
Die berichteten Ergebnisse:
| Interne Evaluierungskategorie | Hy ASR 3.0 Preview WER |
|---|---|
| Allgemeine Erkennung | 4,95 % |
| Dialekterkennung | 9,31 % |
| Kontextauswertung | 4,76 % |
| Komplexe akustische Bedingungen | 6,36 % |
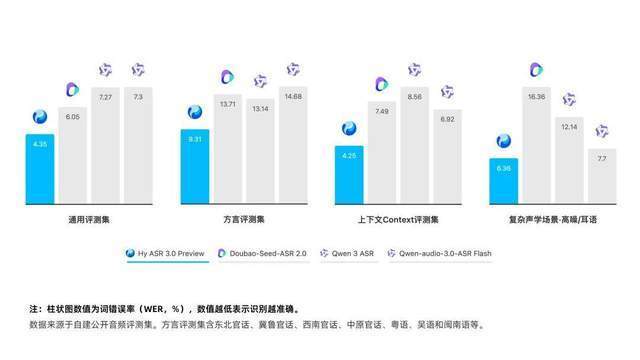
Tencent gibt an, dass Hy ASR 3.0 Preview in allen vier internen Kategorien den niedrigsten WER unter den Vergleichssystemen erzielt hat.
Diese Ergebnisse sind als vom Unternehmen berichtete Produktbelege nützlich, aber interne Testsätze sind keine neutralen öffentlichen Benchmarks.
Vor der Einführung sollten Organisationen fragen:
Tencent fasst die praktischen Verbesserungen in vier Bereichen zusammen.
Das Modell soll die Erkennung in folgenden Szenarien verbessern:
Tencent gibt außerdem an, dass das Modell kumulative Fehler in längeren Äußerungen reduziert.
Diese Aussage beschreibt die zugrunde liegende Fähigkeit des Modells. Die aktuelle Tencent-Cloud-Vorschauversion begrenzt jedoch weiterhin einzelne öffentliche API-Eingaben auf 60 Sekunden. Anwendungen, die Besprechungen oder Aufnahmen verarbeiten, müssen daher derzeit segmentieren.
Das Audio muss segmentiert und der kontextübergreifende Kontext selbst verwaltet werden.
Eine schlechte Segmentierung kann die Probleme, die das Modell lösen soll, wieder einführen.
Beispielsweise kann das Schneiden von Audio an beliebigen 60-Sekunden-Grenzen Folgendes unterbrechen:
Daher sollte die Segmentierungslogik Satzgrenzen und Sprachaktivitätsgrenzen so weit wie möglich beibehalten.
Sprache enthält viele mehrdeutige Laute.
Im Hochchinesischen gibt es zahlreiche Homophone. Im Englischen gibt es ähnlich klingende Wörter und Namen. Dialektale Aussprache kann dazu führen, dass mehrere Kandidatentranskripte akustisch plausibel erscheinen.
Herkömmliche Decoder wählen möglicherweise das Wort mit der höchsten lokalen Wahrscheinlichkeit.
Ein kontextbewusstes System kann die gesamte Äußerung bewerten.
Ein Nutzer könnte beispielsweise eine Phrase aussprechen, die als zwei verschiedene Homophone transkribiert werden kann. Themenwörter aus Finanz, Gaming, Medizin oder Reisen in der Nähe können darauf hindeuten, welche Bedeutung wahrscheinlicher ist.
Der beabsichtigte Verarbeitungsablauf lässt sich wie folgt vereinfachen:
Audiofeatures
→ Kandidatenwörter
→ Satzkontext
→ Semantische Konsistenzprüfung
→ Endgültige Transkription
Dies bedeutet nicht, dass das Modell Sprache auf die gleiche Weise wirklich versteht wie ein Mensch.
Vielmehr nutzen die Sprachkomponenten ein breiteres Kontextfenster und semantische Wahrscheinlichkeiten, um Transkriptionsentscheidungen zu verbessern.
Kontextbewusste ASR-Systeme bringen auch neue Risiken mit sich: semantische Überkorrektur.
Das Modell könnte gelegentlich eine ungewöhnliche, aber korrekt ausgesprochene Phrase durch eine häufiger vorkommende Phrase ersetzen, die plausibler erscheint.
Daher sollten Produktionsumgebungsbewertungen Folgendes umfassen:
Das Ziel ist es, den Kontext zu nutzen, ohne Sprachinhalte zu erfinden, die nie vorkamen.
In den Veröffentlichungsmaterialien wird die Hotword-Verstärkung hervorgehoben, anwendbar auf:
Wenn ein allgemeines Modell ein seltenes Wort nicht häufig genug sieht, können Hotwords einen erheblichen Wert bieten.
Beispiele umfassen:
Proprietäre Medikamentennamen
Fabrikanlagenmodellbezeichnungen
Kundenkontonummern
Neu eingeführte Marken
Technische Abkürzungen
Das Tencent Cloud ASR-Produkt bietet bereits eine Hotword-Listen-API und den Parameter hotword_id.
Die aktuelle Dokumentation zur Hy ASR 3.0-Vorschau stellt jedoch ausdrücklich klar, dass die Hotword-Verstärkung für dieses Vorschau-Engine noch nicht freigeschaltet ist.
Daher müssen öffentliche Produktwerbung und der tatsächlich zugängliche API-Status unterschieden werden:
| Fähigkeit | Modellveröffentlichungshinweise | Aktueller Vorschau-API-Status |
|---|---|---|
| Hotword-Verstärkung | Als unterstützte Fähigkeit beschrieben | Als in Kürze verfügbar aufgeführt |
| Kontexteingabe | Als Kernfähigkeit beschrieben | Als in Kürze verfügbar aufgeführt |
| Interne Kontext-Sprachmodellierung | Kernmodellmerkmal | Über das Modellverhalten verfügbar |
Bis Tencent Cloud die Unterstützung in der offiziellen API-Dokumentation bestätigt, sollten Unternehmen keine Veröffentlichungspläne erstellen, die von externer Kontextinjektion oder Hotword-Listen abhängen.
Tencent gibt an, dass das Modell für die folgenden Situationen optimiert wurde:
Rauschrobustheit ist wichtig, da echte Sprache selten wie saubere Laboraufnahmen klingt.
Kundendienstmikrofone können Tastaturgeräusche und Stimmen von Kollegen in der Nähe aufnehmen.
Mobile Assistenten können Verkehrslärm, Wind, Musik oder andere sprechende Personen hören.
Konferenzanwendungen können komprimiertes Audio von entfernten Laptop-Mikrofonen empfangen.
Das Modell kann die Robustheit verbessern, aber nicht Informationen wiederherstellen, die nie erfasst wurden.
Teams sollten weiterhin Folgendes verwenden:
ASR-Qualität ist eine Systemeigenschaft, nicht nur eine Modelleigenschaft.
Tencent gibt an, dass die Hyuan Hy ASR 3.0 Vorschau drei Hauptkomponenten kombiniert:
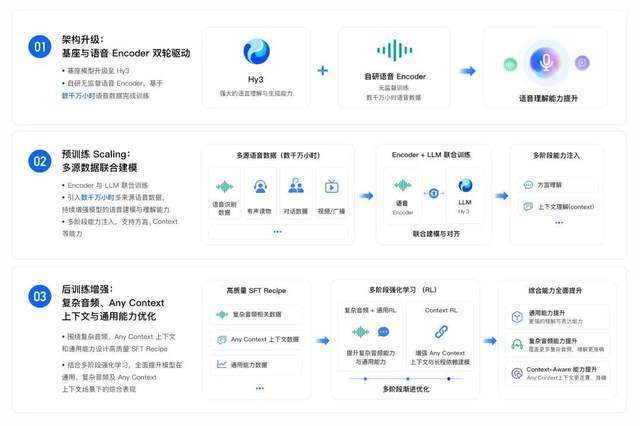
Hy3 stellt die Sprachverständniskomponente bereit.
Seine Funktionen umfassen:
Tencent beschreibt die Architektur als ein Mixture-of-Experts-Design, das Fähigkeiten und Effizienz ausbalanciert.
Die öffentliche ASR-Dokumentation legt die vollständige Parameteranzahl, die Anzahl der aktiven Parameter, das Latenzprofil oder die vollständige Inferenzarchitektur der Hy ASR 3.0 Vorschau nicht offen.
Der Sprach-Encoder wandelt rohes Audio in akustische Darstellungen um, die das Sprachmodell verarbeiten kann.
Tencent gibt an, dass der Encoder mit mehreren zehn Millionen Stunden unbeschrifteter Sprache trainiert wurde.
Unüberwachtes oder selbstüberwachtes Audiotraining ist wertvoll, da die manuelle Transkription von Sprachdaten in diesem Umfang prohibitativ teuer wäre.
Der Encoder kann wiederkehrende Strukturen aus rohem Audio lernen, wie zum Beispiel:
Die Qualität dieser Darstellung beeinflusst alle nachfolgenden Stufen.
Wenn zwei Stimmen auf Encoder-Ebene verwechselt werden, muss das Sprachmodell stärker auf den Kontext zurückgreifen, um die korrekten Wörter wiederherzustellen.
Tencent gibt an, dass der Sprach-Encoder und das Sprachmodell mit einem groß angelegten Multi-Quellen-Sprachdatensatz gemeinsam trainiert wurden, der Folgendes abdeckt:
Statt Spracherkennung zu behandeln als:
Audiomodell fertig
→ Sprachmodell bereinigt danach die Transkription
wird Hy ASR 3.0 als ein stärker integrierter Prozess präsentiert:
Sprachdarstellung und Sprachmodellierung
→ arbeiten im Training zusammen
→ geben eine kontextualisierte Transkription aus.

Die genauen internen Grenzen zwischen Encoder, Decoder, Sprachmodell und Reinforcement-Learning-Phasen sind nicht vollständig offengelegt.

## SFT und mehrstufiges Reinforcement Learning

Tencent beschreibt ein überwachtes Feinabstimmungsschema, das Folgendes abdeckt:

- Allgemeine Transkription.
- Beliebige Kontextaufgaben.
- Fachterminologie.
- Unterschiedliche akustische Umgebungen.
- Verschiedene Sprechergruppen.
- Zehn große Dialektregionen.
- Mehr als 20 kleinere Dialektregionen.

Das Unternehmen berichtet auch über mehrstufiges Reinforcement Learning für:

- Allgemeine Transkriptionsgenauigkeit.
- Kontextverhalten.
- Komplexe Long-Tail-Fälle.
- Reduzierung von Substitutions- und Löschfehlern.

Derzeit gibt es kein öffentliches technisches Paper, das das vollständige Belohnungsdesign, die Datenzusammensetzung, die Trainingsrechenleistung oder Ablationsstudien bereitstellt.

Daher sollten Architekturbehauptungen als produktbezogene technische Beschreibungen betrachtet werden, nicht als reproduzierbare Forschungsspezifikationen.

## Aktuell unterstützte Sprachen und Dialekte der Tencent Cloud Engine

Die Tencent Cloud-Dokumentation beschreibt die aktuelle `Hy-ASR-3.0-preview`-Engine als Unterstützung für:

- Hochchinesisch (Mandarin).
- Englisch.
- 20 chinesische Dialekte oder regionale Varianten.

Die von der Dokumentation aufgeführte Dialektliste lautet wie folgt:

| Nr. | Dialekt oder regionale Variante |
|-|-|
| 1 | Kantonesisch |
| 2 | Nordost-Mandarin |
| 3 | Henan-Dialekt |
| 4 | Shaanxi-Dialekt |
| 5 | Chengdu-Dialekt |
| 6 | Chongqing-Dialekt |
| 7 | Wuhan-Dialekt |
| 8 | Guiyang-Dialekt |
| 9 | Qingdao-Dialekt |
| 10 | Jinan-Dialekt |
| 11 | Changsha-Dialekt |
| 12 | Hefei-Dialekt |
| 13 | Hebei-Dialekt |
| 14 | Kunming-Dialekt |
| 15 | Lanzhou-Dialekt |
| 16 | Yinchuan-Dialekt |
| 17 | Nanchang-Dialekt |
| 18 | Peking-Dialekt |
| 19 | Sichuan-Dialekt |
| 20 | Tianjin-Dialekt |

Dialektbezeichnungen in kommerziellen ASR-Dokumenten sind grobe Produktkategorien.

Die tatsächliche Sprache in jeder Kategorie variiert je nach Stadt, Alter, sozialem Hintergrund, Code-Switching, Wortschatz und Sprecher.

Die Behauptung, eine bestimmte Dialektvariante zu unterstützen, sollte nicht so verstanden werden, dass die Genauigkeit für jeden Sprecher in der Region identisch ist.

## Aktuelle Verfügbarkeit der Vorschauversion

Tencent Cloud hat am **4. August 2026** die Hy-ASR-3.0-Vorschauversion-Engine zum Echtzeit-WebSocket-Produkt hinzugefügt.

Dieser öffentliche Dienst wird derzeit als interne Test- oder Vorschauversion beschrieben.

| Element | Aktueller dokumentierter Status |
|-|-|
| Produkttyp | Echtzeit-Spracherkennung |
| Integrationsmethode | Tencent Cloud WebSocket-API |
| Engine-Name | `Hy-ASR-3.0-preview` |
| Audiodauer | Maximal 60 Sekunden pro Eingabe |
| Audioformat | 16-kHz-Mono-PCM |
| Inkludierte parallele Verbindungen | 20 parallele Verbindungen |
| Mandarin | Unterstützt |
| Englisch | Unterstützt |
| 20 Dialekte | Unterstützt |
| Sprechertrennung | In der Vorschauversion nicht unterstützt |
| VAD-Parameterunterstützung | In der Vorschauversion als nicht unterstützt aufgeführt |
| Wortersetzung | In der Vorschauversion nicht unterstützt |

| Rauschschwellenparameter | In der Vorschauversion nicht unterstützt |
| Externe Kontexteingabe | In Kürze verfügbar |
| Wake-Word-Verbesserung | In Kürze verfügbar |

Die allgemeine WebSocket-API-Referenz enthält Parameter, die von anderen Engines verwendet werden, einschließlich VAD- und Wake-Word-IDs.

Für Hy ASR 3.0 gelten die engine-spezifischen Vorschauhinweise.

Parameter, die im gemeinsamen API-Schema erscheinen, garantieren nicht, dass die Vorschauversion-Engine den Parameter derzeit implementiert hat.

## Grundlegender Ablauf der Tencent-Cloud-Integration

Das offizielle Setup besteht aus drei Hauptphasen.

## Schritt 1: Tencent Cloud Spracherkennungsdienst aktivieren

Öffnen Sie den Tencent Cloud Spracherkennungsdienst und schließen Sie die Kontoaktivierung ab.

Die offizielle Schnellstart-Dokumentation finden Sie unter:

```Plaintext
https://cloud.tencent.com/document/product/1093/54362
Bitte lesen Sie die Abrechnungshinweise, bevor Sie die nutzungsbasierte Abrechnung aktivieren.
Tencent Cloud weist darauf hin, dass die nutzungsbasierte Abrechnung für neue Konten standardmäßig deaktiviert ist und manuell aktiviert werden muss.
Erstellen oder abrufen:
AppIDSecretIDSecretKeyDiese Anmeldeinformationen werden zum Signieren von WebSocket-Verbindungsanfragen verwendet.
Speichern Sie sie in einem Schlüsselverwaltungssystem oder in geschützten Umgebungsvariablen.
Platzieren Sie langfristig gültige Anmeldeinformationen nicht in:
Für Browser- oder mobile Produkte erstellen Sie signierte Verbindungsinformationen in einem vertrauenswürdigen Backend.
Der in der Tencent-Cloud-Dokumentation dokumentierte Endpunkt hat das Format:
wss://asr.cloud.tencent.com/asr/v2/?{request_parameters}
Ersetzen Sie `` durch Ihre Tencent-Cloud-AppID.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Die Anfrage enthält Signaturparameter wie:
secretidtimestampexpirednoncevoice_idengine_model_typeFür die Hy-ASR-3.0-Vorschauversion setzen Sie:
engine_model_type=Hy-ASR-3.0-preview
Jede WebSocket-Verbindung benötigt eine eindeutige voice_id.
Wenn die Verbindung endet oder fehlschlägt, wird die alte voice_id ungültig und eine neue voice_id muss generiert werden.
Die aktuelle Vorschauversion erfordert:
Abtastrate: 16 kHz
Kanäle: Mono
Format: PCM
Maximale Eingabedauer: 60 Sekunden
Testen Sie die gesamte Audiokette, nicht nur die Rohdatei.
Mikrofon-SDKs, Browser-Web-Audio-APIs, Telefonsysteme und Konferenzplattformen können Audio vor dem Erreichen des Servers neu abtasten oder komprimieren.
Der Dienst unterstützt Echtzeit-Transkription und gibt Text zurück, während Audio übertragen wird.
Anwendungen sollten Folgendes verarbeiten:
Gehen Sie nicht davon aus, dass jedes partielle Erkennungsergebnis endgültig ist.
Die Echtzeit-ASR-Schnittstelle kann zuvor ausgegebene Wörter und Sätze überarbeiten, sobald mehr Kontext verfügbar ist.
Die Benutzeroberfläche sollte zwischen vorläufigem und bestätigtem Text unterscheiden.
Erstellen Sie einen repräsentativen Bewertungssatz, der Folgendes enthält:
Echte Kundenaufnahmen.
Häufige Akzente.
Dialekte.
Chinesisch-Englisch gemischt.
Personennamen und Produktterminologie.
Hintergrundgeräusche.
Leises Sprechen.
Schlechte Mikrofonqualität.
Kurze Befehle.
Vollständige Sätze.
Messen Sie sowohl Erkennungsqualität als auch Systemverhalten.
Tencent Cloud klassifiziert Hy ASR 3.0 Vorschauversion als Large Model 2.0 Echtzeit-Spracherkennungsengine.
Die aktuelle Abrechnungsseite listet:
| Abrechnungsoption | Aktueller Listenpreis |
|---|---|
| Vorausbezahltes 60-Stunden-Paket | Insgesamt 60 Yuan, also 1,00 Yuan/Stunde |
| Vorausbezahltes 1.000-Stunden-Paket | Insgesamt 950 Yuan, also 0,95 Yuan/Stunde |
| Vorausbezahltes 10.000-Stunden-Paket | Insgesamt 9.000 Yuan, also 0,90 Yuan/Stunde |
| Vorausbezahltes 100.000-Stunden-Paket | Insgesamt 88.000 Yuan, also 0,88 Yuan/Stunde |
| Vorausbezahltes 300.000-Stunden-Paket | Insgesamt 255.000 Yuan, also 0,85 Yuan/Stunde |
| Nutzungsbasiert | 1,00 Yuan/Stunde, täglich abgerechnet |
Die aktuelle Abrechnungstabelle von Tencent zeigt, dass die Large-Model-2.0-Erkennung kein kostenloses Audio-Kontingent bietet.
Die inkludierten 20 parallelen Verbindungen sind ein Parallelitätskontingent, keine kostenlose Erkennungszeit.
Die Preise können sich ändern. Prüfen Sie die aktuelle Abrechnungsseite, bevor Sie kommerzielle Angebote veröffentlichen oder langfristige Budgets schätzen.
Bei einem nutzungsbasierten Preis von 1,00 Yuan/Stunde zum aktuellen Listenpreis:
100 Stunden erfolgreiche Erkennung
× 1,00 Yuan/Stunde
= 100 Yuan
Das Produktionsbudget sollte außerdem Folgendes umfassen:
Die ASR-Gebühren sind nur ein Teil des vollständigen Transkriptionssystems.
Tencent gibt an, dass Yuanbao an der Entwicklung des Modells beteiligt war und das erste Tencent-Produkt ist, das das Modell integriert.
Benutzer können die Funktion über die Spracheingabe in Yuanbao erleben; das Modell soll verbessern:
Tencent gibt an, dass andere Produkte wie WorkBuddy schrittweise angebunden werden.
Die Integration in Verbraucherprodukte kann sich von der öffentlichen API der Tencent-Cloud-Vorschauversion unterscheiden.
Zum Beispiel kann Yuanbao interne Dienste, produktspezifische Kontexte oder Deployment-Konfigurationen verwenden, die externen Entwicklern noch nicht zugänglich sind.
Es sollte nicht angenommen werden, dass das Erlebnis in Yuanbao eins zu eins mit den öffentlichen API-Parametern übereinstimmt.
Die Hy-ASR-3.0-Vorschauversion ist für kurze, latenzarme Sprachinteraktionen positioniert.
Mögliche Verwendungen umfassen:
Der Vorschauversion fehlt derzeit die Sprechertrennung, was Mehrparteien-Gesprächstranskriptionen einschränken kann, sofern keine anderen Komponenten eine Kanal- oder Sprechertrennung durchführen.
Die Engine kann kurze Echtzeit-Untertitel in folgenden Szenarien unterstützen:
Anwendungen sollten die Stabilität von Teilergebnissen und das Interpunktionsverhalten testen.
Kontextsensitive Erkennung kann die Suche nach Folgendem verbessern:
Solange die Vorschauversion keine Hotword-Injektion erlaubt, kann seltene Fachterminologie weiterhin eine Nachbearbeitung oder eine separate Fehlerkorrekturebene erfordern.
Die Engine kann gesprochene Anweisungen für Folgendes in Text umwandeln:
Steuerung intelligenter Geräte.
Das Befehlssystem sollte niemals Aktionen mit hoher Wirkung nur deshalb ausführen, weil ein Transkriptionsergebnis mit hoher Konfidenz erscheint.
Bei destruktiven oder finanziellen Vorgängen sollte die erkannte Absicht bestätigt und die ausdrückliche Genehmigung des Benutzers eingeholt werden.
Kurze Audioausschnitte können vor der Weiterleitung an die folgenden Prozesse transkribiert werden:
Die Qualität jeder nachgelagerten KI-Verarbeitung hängt vom Transkriptionsergebnis ab.
Sofern die Richtlinien dies erlauben, sollten das ursprüngliche Audio oder Konfidenzbelege gespeichert werden, damit unsichere Ausgaben überprüft werden können.
Das Produkt ist weiterhin als Vorschau- oder interne Testversion gekennzeichnet.
Benutzeroberfläche, Preisgestaltung, Einschränkungen und unterstützte Funktionen können sich ändern.
Die aktuelle öffentliche API kann die Batch-Transkription langer Aufnahmen nicht direkt ersetzen.
Lange Audiodateien müssen segmentiert verarbeitet werden und benötigen möglicherweise eine kontextuelle Ebene auf Anwendungsebene.
Die Vorschauversion erfordert derzeit 16-kHz-Mono-PCM.
Viele Produktionsumgebungen verwenden MP3, AAC, Opus oder Telefon-Codecs, die eine Konvertierung erfordern.
Die exklusive Dokumentation der aktuellen Engine gibt an, dass eine Sprechertrennung nicht unterstützt wird.
Die Transkription mehrerer Sprecher erfordert möglicherweise separate Audiokanäle oder andere Dienste zur Sprechertrennung.
Gemäß der offiziellen Dokumentation sind die angekündigten Funktionen noch nicht als verfügbare Vorschau-API-Funktionen öffentlich zugänglich.
Die Benchmark-Diagramme stammen von Tencent.
Eine unabhängige Bewertung unter vergleichbaren Bedingungen würde die Glaubwürdigkeit des Vergleichs erhöhen.
Tencent hat eine Beschreibung auf hoher Ebene der Architektur und des Trainingsprozesses der Hy ASR 3.0 Vorschauversion bereitgestellt, aber noch keine vollständig reproduzierbaren Details veröffentlicht.
Der sprachbewusste Decoder bevorzugt möglicherweise häufige Sätze und ignoriert ungewöhnliche, aber tatsächlich korrekt gesprochene Inhalte.
Die Tests müssen seltene und unerwartete Phrasen enthalten.
Mindestens mehrere hundert repräsentative Äußerungen, nicht nur eine kleine Anzahl sauberer Demo-Beispiele.
Erstellen Sie mit einer klaren Normalisierungsstrategie manuell überprüfte Referenztranskriptionen.
Entscheiden Sie, wie mit Folgendem umgegangen wird:
Verwenden Sie:
Fassen Sie nicht alle Dialektsprecher in einem Durchschnittswert zusammen.
Berichten Sie Ergebnisse getrennt nach Region und Aufnahmebedingungen.
Erstellen Sie paarweise Beispiele mit ähnlichem akustischem Inhalt, bei denen der Satzkontext das korrekte Transkriptionsergebnis verändert.
Bewerten Sie Produktnamen und Fachbegriffe.
Behandeln Sie die Terminologie zunächst separat und wiederholen Sie die Tests, sobald Tencent die Hotword-Unterstützung freigibt.
Verwenden Sie reale Umgebungsaufnahmen, nicht nur digital überlagerte Geräusche.
Bestätigen Sie, dass die 60-Sekunden-Segmentierung keine wichtigen Aussagen abschneidet und keine doppelten Texte erzeugt.
Fügen Sie Folgendes ein:
Erfassung
+ Upload
+ Erkennung
+ Ergebnisfinalisierung
+ Nachgelagerte Verarbeitung
Sprachaufnahmen können personenbezogene oder sensible Informationen enthalten.
Vor der Bereitstellung sollten Richtlinien zu Datenaufbewahrung, Zugriffsrechten, Verschlüsselung, Benutzereinwilligung und Löschung festgelegt werden.
| Bereich | Traditionelle Pipeline | Hy ASR 3.0 Ausrichtung |
|---|---|---|
| Hauptfokus | Genauigkeit von Akustik zu Text | Akustische Erkennung plus kontextuelle Sprachmodellierung |
| Verwechslungsgefahr bei Homophonen | Verlässt sich normalerweise auf lokale Wahrscheinlichkeiten | Verwendet breiteren Satzkontext |
| Dialekte | Separate Modelle oder begrenzte Abdeckung | Ein einziges dokumentiertes Hybrid-Engine mit 20 Dialekten |
| Fachvokabular | Externe Hotwords oder benutzerdefinierte Modelle | Angekündigte Hotword-Fähigkeit; Vorschau-Support ausstehend |
| Komplexe Sprache | Akustisches Modell plus Nachbearbeitung | Gemeinsames Training von Sprache und Sprachmodell plus Post-Training |
| Ausgabe | Transkribierter Text | Kontextuell kohärenterer transkribierter Text |
| Hauptrisiko | Akustische Ersetzungen und fehlende Zeichen | Akustische Fehler plus mögliche semantische Überkorrektur |
Der neue Ansatz beseitigt nicht den Bedarf an traditioneller ASR-Technik.
Er fügt demselben End-to-End-System eine stärkere Sprachebene hinzu.
Die Hy ASR 3.0 Vorschauversion ist ein Echtzeit-Spracherkennungsmodell von Tencent Hunyuan, das auf dem Hy3-Sprachfundament und einem eigenen Sprachcodierer basiert. Das Designziel ist die Kombination von akustischer Erkennung mit kontextuellem Sprachverständnis.
Die Tencent-Cloud-Dokumentation zeigt Unterstützung für Mandarin-Chinesisch, Englisch sowie 20 chinesische Dialekte oder regionale Varianten, darunter Kantonesisch, Nordost-Dialekt, Henan-Dialekt, Shaanxi-Dialekt, Chengdu-Dialekt, Chongqing-Dialekt, Wuhan-Dialekt und andere. Die Genauigkeit kann je nach Sprecher und Region variieren.
Tencent gibt aggregierte WER-Ergebnisse öffentlicher Benchmarks an: Mandarin 3,34 %, Englisch 2,62 %, Kantonesisch 3,12 %. Dies sind vom Unternehmen über mehrere Datensätze aggregierte Ergebnisse, keine unabhängig reproduzierten einheitlichen Testergebnisse.
Die aktuelle öffentliche Vorschauversion akzeptiert maximal 60 Sekunden Audio pro Eingabe. Längere Aufnahmen erfordern eine Segmentierung, und die Anwendung muss den Kontext zwischen den Segmenten sinnvoll aufrechterhalten.
Gemäß der Vorschaudokumentation von Tencent Cloud vom 4. August 2026 derzeit nicht. Diese Funktionen werden in den Veröffentlichungsmaterialien beschrieben, aber die offizielle API-Seite zeigt, dass Kontexteingabe und Hotword-Verbesserung später verfügbar sein werden.
Die aktuelle Dokumentation der Hy ASR 3.0 Vorschauversion spezifiziert 16-kHz-Mono-PCM-Eingabe. Anwendungen, die MP3, AAC, Opus oder andere Formate verwenden, müssen das Audio vor dem Aufruf konvertieren.
Senden Sie es an diese Engine.
Entwickler verwenden die Echtzeit-Spracherkennungs-WebSocket-API von Tencent Cloud und setzen engine_model_type auf Hy-ASR-3.0-preview. Die Verbindung muss mit Tencent-Cloud-Anmeldeinformationen signiert werden.
Die aktuelle Abrechnungsseite von Tencent Cloud listet kein kostenloses Audio-Kontingent für die Erkennung mit dem großen Modell 2.0 auf. Die Seite zeigt Prepaid-Pakete ab 60 Stunden für 1 RMB/Stunde und Postpaid zu 1 RMB/Stunde, einschließlich 20 paralleler Verbindungen.
[Hunyuan ASR Vorschaudokumentation](https://cloud.tencent.
Dokumentation zur Echtzeit-Spracherkennung: Aktueller offizieller Status, unterstützte Dialekte, Einschränkungen und Grundeinstellungen.
API für Echtzeit-Spracherkennung: WebSocket-Endpunktformat und Referenz zu Anfrageparametern.
Schnellstart für die Server-API in einer Minute: Offizieller Leitfaden von Tencent Cloud zur Diensteinrichtung und Anmeldeinformationen.
Abrechnung von Tencent Cloud ASR: Aktuelle Informationen zu Vorauszahlung, Nachzahlung, Nebenläufigkeit und kostenlosem Kontingent.
Produktupdates von Tencent Cloud ASR: Offizielles Versionsprotokoll, das die Aufnahme der Hy ASR 3.0-Engine als Vorschauversion am 4. August 2026 zeigt.
API für benutzerdefinierte Hotwords von Tencent Cloud: Offizielle API für die allgemeine Hotword-Liste von ASR; Unterstützung für die Hy ASR 3.0-Vorschauversion ist weiterhin als „in Kürze verfügbar" gekennzeichnet.
Tencent Hunyuan: Offizielles Portal für Hunyuan-Modelle und -Produkte.
Die Vorschauversion von Hy ASR 3.0 von Tencent Hunyuan kombiniert den Sprachencoder mit den Sprachmodellfähigkeiten von Hy3, um die Transkription in Mandarin, Englisch, Dialekten, gemischten Sprachen, lauten Umgebungen und kontextabhängigen Anwendungsfällen zu verbessern.
Tencent berichtet auf aggregierten öffentlichen Datensätzen eine Wortfehlerrate (WER) von 3,34 % für Mandarin, 2,62 % für Englisch und 3,12 % für Kantonesisch und erzielte daneben führende Ergebnisse in internen Tests. Diese Zahlen sind vielversprechend, müssen aber noch anhand der eigenen Audioinhalte der jeweiligen Institutionen verifiziert werden.
Die aktuelle Vorschauversion von Tencent Cloud ist hinsichtlich des Umfangs enger gefasst als die vollständige Release-Vision.
Sie unterstützt Echtzeit-Erkennung über WebSocket, 16-kHz-Mono-PCM und Audiosignale mit einer maximalen Länge von 60 Sekunden. Externe Kontextinjektion, Hotword-Verstärkung, Sprechertrennung und mehrere andere Funktionen sind bei dieser Engine noch nicht verfügbar.
Der entscheidende Unterschied besteht nicht darin, dass die Spracherkennung nicht mehr auf die Stimme hört, sondern dass das Sprachmodell nun dabei hilft, die wahrscheinlichste Bedeutung der gehörten Äußerung zu bestimmen.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



