For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/theophyseval-results-gpt-6-astra-scores-9-f858557c.md.
Eine neue Evaluation berichtet, dass GPT-6 Astra, ausgeführt über Codex, bei 49 von 50 Problemen der theoretischen Physik korrekte Endergebn...
Eine neue Evaluation berichtet, dass GPT-6 Astra, ausgeführt über Codex, bei 49 von 50 Problemen der theoretischen Physik korrekte Endergebnisse geliefert hat. Das Ergebnis von 98 % stammt aus dem werkzeuggestützten „Realistic“-Track von TheoPhysEval. Die geschätzten API-Kosten des Modells lagen im Durchschnitt bei weniger als 3 US-Dollar pro Problem.
Das Ergebnis ist bemerkenswert, aber sein Geltungsbereich ist entscheidend. Die Autoren schließen große offene Probleme ausdrücklich aus und beschreiben die Sammlung als konkrete Forschungsrechnungen, bei denen etablierte Methoden angepasst werden. Sie liefert keinen Beleg dafür, dass KI 98 % der Physik gelöst hat oder eigenständig ein umfangreiches Forschungsprogramm auswählen und abschließen kann.
TheoPhysEval vereint Beiträge von Forschenden aus Institutionen wie ICTS, TIFR, der University of Texas at Austin, der University of Tokyo, Harvard, der University of Pennsylvania, Duke und Google DeepMind. Die Sammlung umfasst 50 unveröffentlichte Probleme aus 11 Themenbereichen – von klassischer Physik und elektronischer Struktur bis zu Holografie und Kosmologie.
Die Autoren schätzen, dass eine Fachperson im jeweiligen Spezialgebiet ein Problem typischerweise an einem Tag oder schneller lösen könnte. Eine Fachperson aus einem benachbarten Gebiet könnte deutlich länger benötigen. Dabei handelt es sich um eine Schwierigkeitsschätzung und nicht um einen kontrollierten Zeitvergleich zwischen Mensch und Agent.
Einige Fragen verändern die Parameter einer aktuellen Berechnung, sodass ein Modell die Methode rekonstruieren und anpassen muss. Die Forschenden verwarfen eine Frage nicht allein deshalb, weil ein Agent sie lösen konnte. Sie räumen außerdem ein, dass einige Mitwirkende KI-Unterstützung verwendet haben. Daher bedeutet „unveröffentlicht“ nicht, dass eine Datenkontamination definitiv ausgeschlossen ist.
Während der Überprüfung bewertete das Team zunächst mehrere Antworten von Astra als falsch. Die Rücksprache mit den Personen, die die Aufgaben erstellt hatten, offenbarte subtile Fehler in den Referenzlösungen; die korrigierten Referenzen stimmten mit Astras Ergebnissen überein. Der BAAI-Bericht beschreibt eine erste Bewertung von 88 %, während das veröffentlichte Ergebnis des Papers bei 98 % liegt.
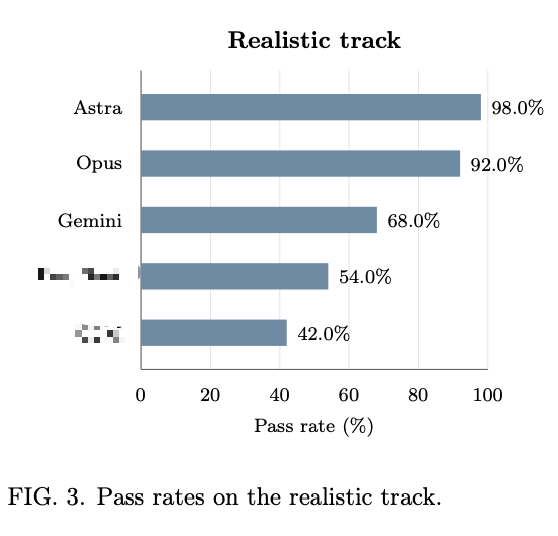
| Agent und Harness | Realistic-Track | Isolated-Track |
|---|---|---|
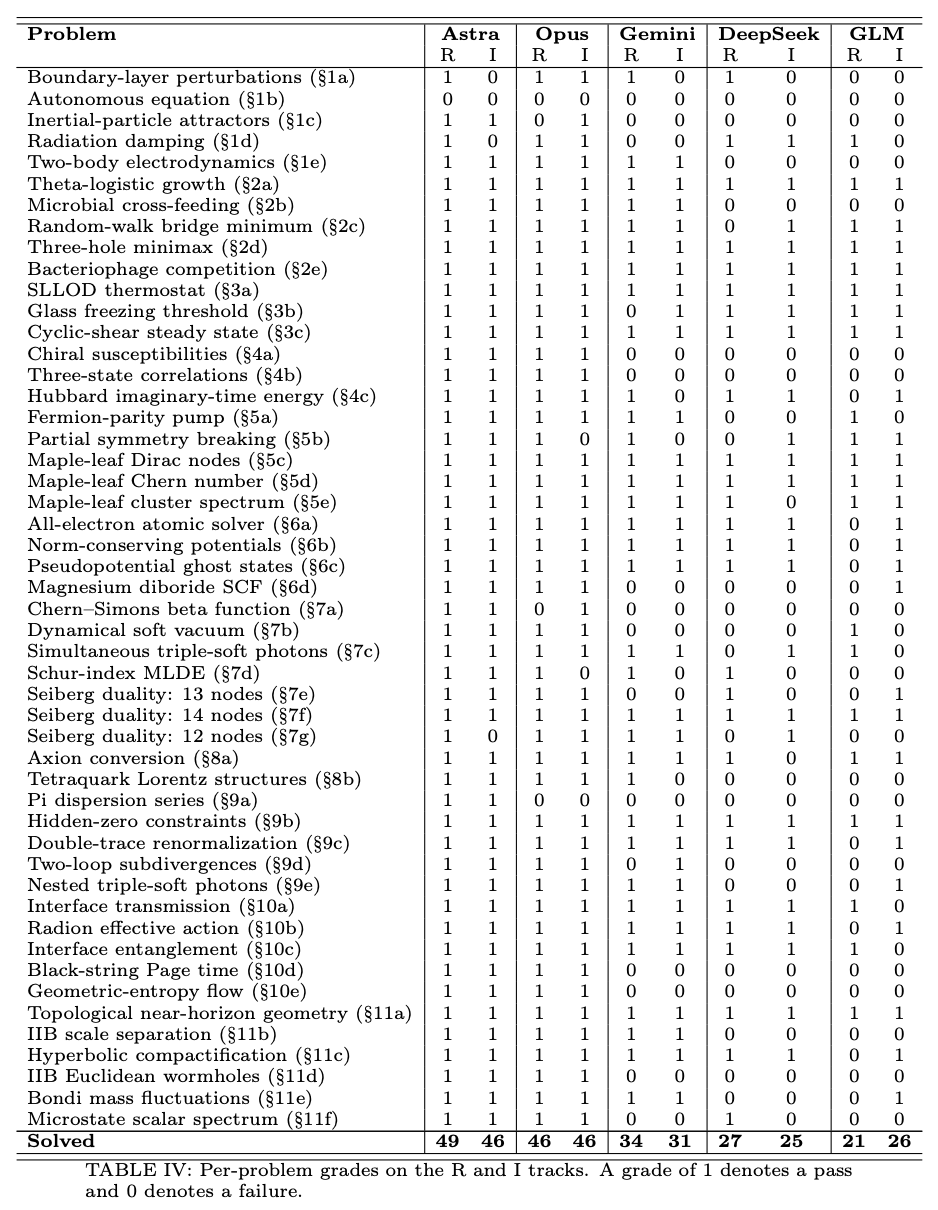
| GPT-6 Astra mit Codex | 49/50, 98 % | 46/50, 92 % |
| Opus 5.5 mit Claude Code CLI | 46/50, 92 % | 46/50, 92 % |
| Gemini 3.8 Flash mit Antigravity | 34/50, 68 % | 31/50, 62 % |
| DeepSeek-V4.1-Flash mit Codex | 27/50, 54 % | 25/50, 50 % |
| GLM 5.3 mit Claude Code CLI | 21/50, 42 % | 26/50, 52 % |
Gemeldete Ergebnisse aus dem Preprint. Verglichen werden vollständige Modell-und-Harness-Konfigurationen, nicht isolierte Modellgewichte.
Die vollständige Testsuite wurde pro Agent und Track jeweils einmal ausgeführt. Stichprobenvariabilität, mehrdeutige Prompts und Entscheidungen beim Harness sind daher wichtig, wenn Unterschiede von nur wenigen Aufgaben interpretiert werden.
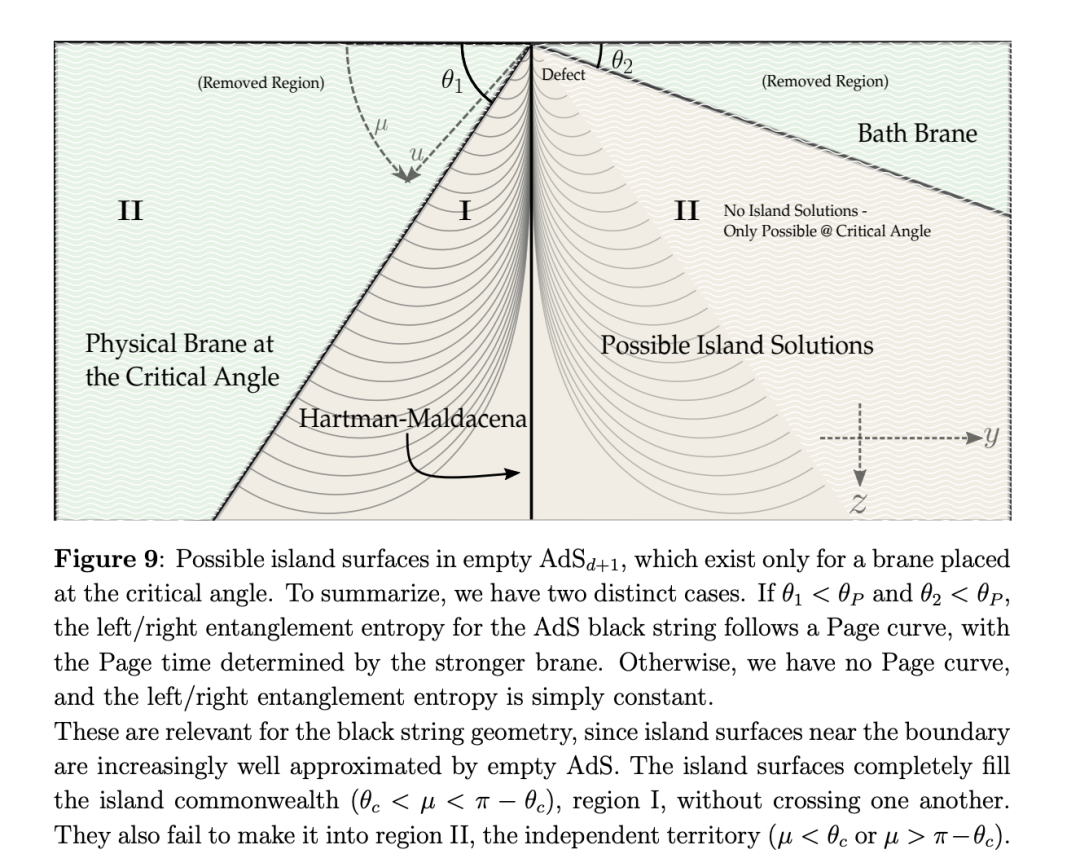
Bei diesem Holografieproblem soll eine Page-Zeit bestimmt werden, indem die Flächeninhalte minimaler Flächen in einer AdS4-Geometrie einer schwarzen Saite mit zwei Branen verglichen werden. Das Paper gibt folgenden erwarteten Lösungsweg vor:
d = 3 entspricht.Dies verbindet die Interpretation von Fachliteratur, eine Dimensionsanpassung und numerische Arbeit. Die unveränderte Wiederverwendung einer Formel aus fünf Dimensionen kann zu einem falschen Ergebnis führen.
Eine weitere Aufgabe verlangt eine selbstkonsistente Atomrechnung für Bor und Magnesium. Die vorgegebene Konfiguration verwendet die Local-Density-Approximation, den Dirac-Slater-Austausch und die VWN5-Korrelationsparametrisierung.
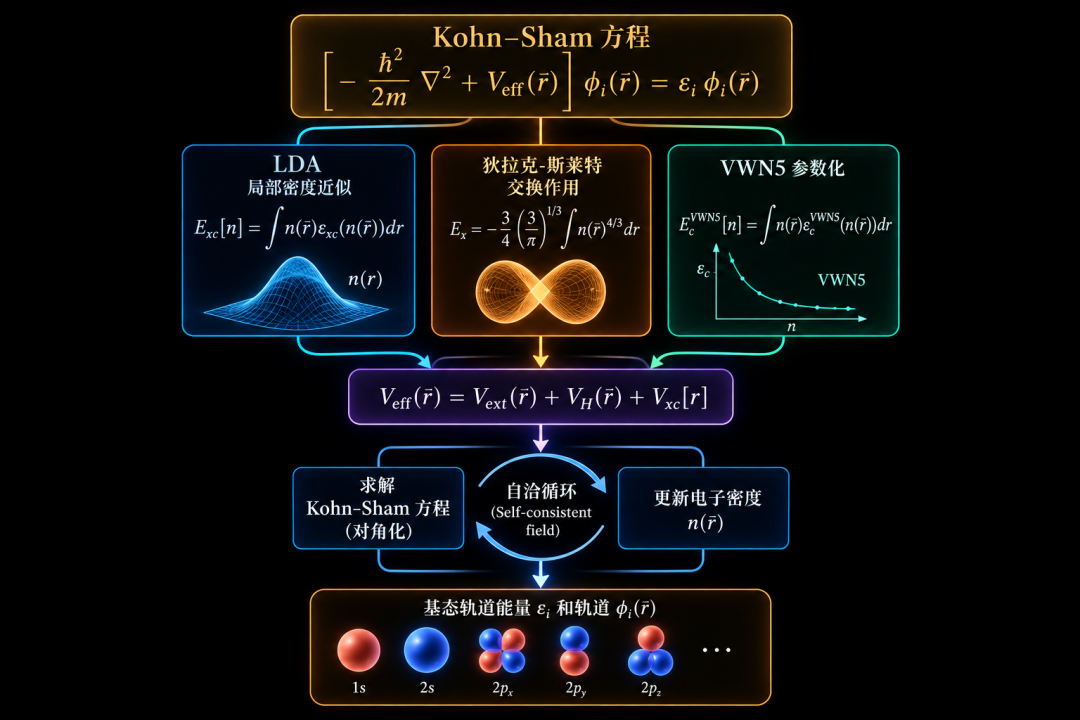
Die Frage verweist auf NIST-Daten, die auf Mikrohартree-Genauigkeit konvergiert wurden, verlangt für die relevanten Werte jedoch eine Übereinstimmung innerhalb von 1e-4 Hartree. Die Genauigkeit der Referenzdaten und die Akzeptanztoleranz sind unterschiedliche Größen. Das Ergebnis sollte daher nicht als Beleg für eine universelle Übereinstimmung auf Mikrohartree-Niveau beworben werden.
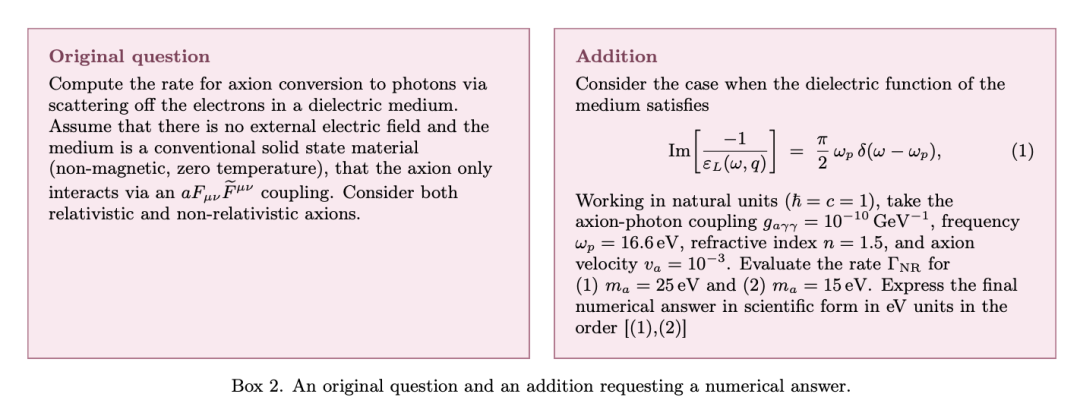
Bei diesem Problem geht es um die Umwandlung von Axionen in Photonen durch Elektronenstreuung in einem dielektrischen Medium ohne externes elektrisches Feld. Die Evaluation ergänzt festgelegte numerische Parameter und fragt nach den Raten für zwei Axionenmassen.
Dadurch werden Einheiten, Annahmen zur Kopplung und die Reaktion des Mediums besonders wichtig. Getestet wird eine Berechnung unter expliziten Bedingungen – keine neue Entdeckung über die Identität der Dunklen Materie.
Der Bericht hebt außerdem eine Beta-Funktionsberechnung in einer dreidimensionalen Chern-Simons-Materietheorie hervor. Weitere Aufgaben betreffen Grenzschichtstörungen, fermionische Phasen, Schleifenberechnungen in höheren Dimensionen, supersymmetrische Quiver-Theorien und Wurmlöcher in kompaktifizierter Supergravitation.
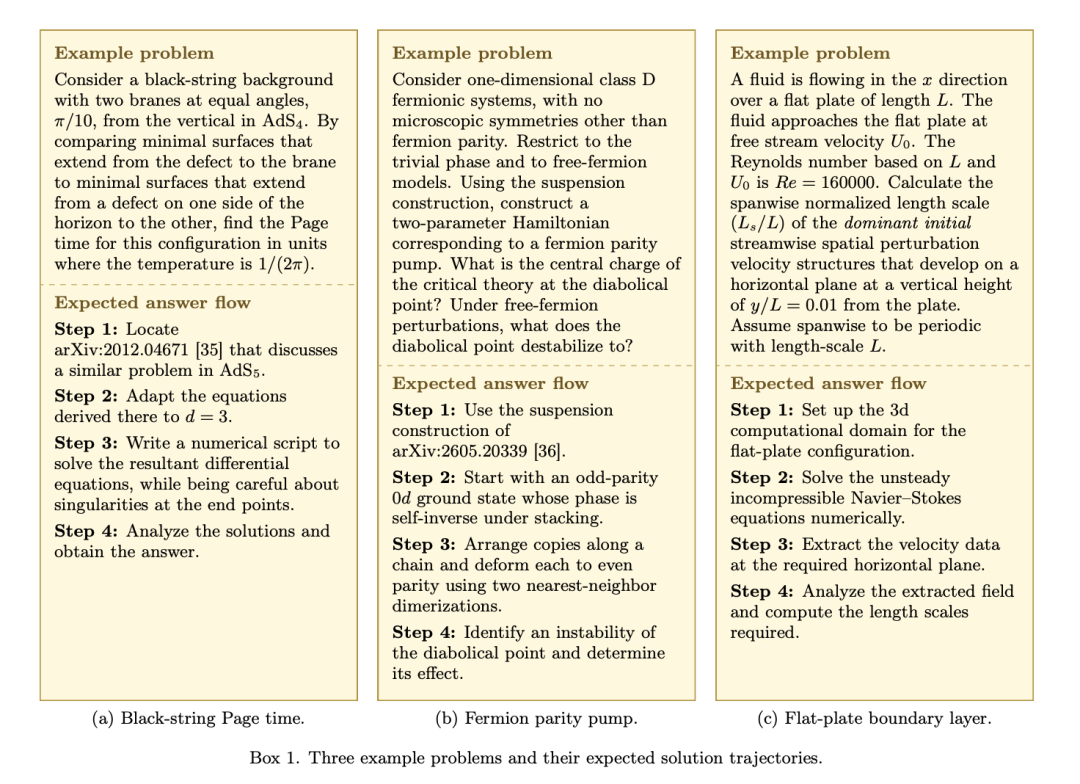
Die thematische Breite ist beachtlich: Eine einzelne menschliche Forschende oder ein einzelner menschlicher Forschender wäre nur selten auf all diese Methoden spezialisiert. Dennoch wird die Sammlung dadurch nicht zu einer vollständigen Untersuchung der theoretischen Physik.
Die Forschenden verwenden Harbor, um die Umgebungen der Agenten zu kontrollieren. Beide Tracks erlauben lokale Werkzeuge einschließlich Codeausführung. Der Realistic-Track erlaubt zusätzlich Webzugriff; im Isolated-Track ist der Internetzugriff mit Ausnahme der Kommunikation mit dem Modellanbieter deaktiviert.
Um die Bewertung symbolischer Antworten zu vereinfachen, geben viele Prompts numerische Werte vor und verlangen ein numerisches Endergebnis. Dadurch wird die Mehrdeutigkeit zwischen gleichwertigen Ausdrücken reduziert und Raten erschwert.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Eine Übereinstimmung mit einer Endzahl beweist jedoch nicht, dass jeder Zwischenschritt korrekt ist. Das Paper räumt ein, dass bei einigen Fragen Konventionen nicht vollständig spezifiziert sind und dass ein inverses Problem schwer numerisch zu formulieren ist. Bewertet werden Endergebnisse, nicht die formale Überprüfung jeder Herleitung.
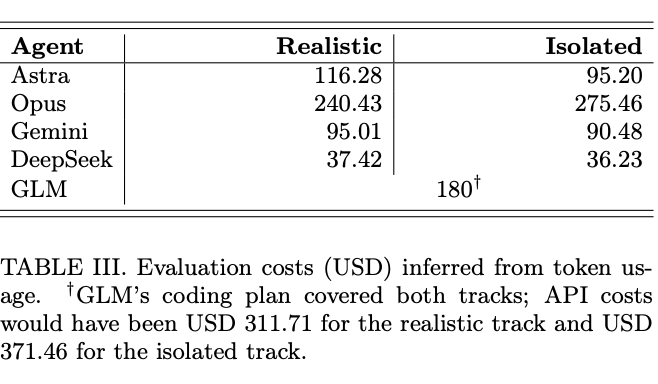
| Agent | Geschätzte API-Kosten im Realistic-Track | Geschätzte API-Kosten im Isolated-Track |
|---|---|---|
| Astra | $116.28 | $95.20 |
| Opus | $240.43 | $275.46 |
| Gemini | $95.01 | $90.48 |
| DeepSeek | $37.42 | $36.23 |
| GLM | $311.71 zu API-Tarifen | $371.46 zu API-Tarifen |
GLM wurde tatsächlich mit einem Coding-Tarif von 180 US-Dollar ausgeführt, der beide Tracks abdeckte. Die API-Äquivalenzwerte entsprechen nicht dem Betrag, der für diese Durchläufe bezahlt wurde.
Die Gesamtkosten von Astra im Realistic-Track geteilt durch 50 ergeben etwa 2,33 US-Dollar pro Problem. Dabei handelt es sich um eine auf den Tokenkosten zu den Tarifen der Evaluation basierende Schätzung, nicht um die Gesamtkosten für den Betrieb einer Forschungsorganisation, den Erwerb von Fachwissen oder die Validierung wissenschaftlicher Arbeit.
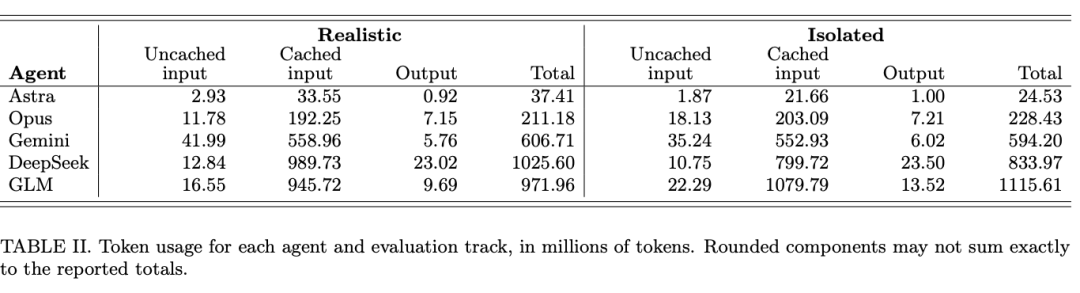
Die Evaluation legte kein allgemeines Token-Budget fest, verhängte aber Zeitlimits für Aufgaben: normalerweise acht Stunden, mit einer längeren Frist für verknüpfte Aufgaben zur elektronischen Struktur. Niedrige durchschnittliche Tokenkosten sollten nicht mit garantiert niedriger Latenz verwechselt werden.
Die Quelle verweist anschließend auf die Berichterstattung über eine Studie unter Beteiligung von Neil Thompson vom MIT, Gabriel Manso und Claudio Mayrink Verdun. Superpower Daily beschreibt unter Berufung auf WIRED, dass der Erfolg bei ausgewählten Theorieproblemen von etwa 2 % bei den besten Systemen Mitte 2024 auf etwa 35 % Mitte 2026 gestiegen sei.
Das entspricht einem Verhältnis von 17,5 zu 1 und einem Anstieg um 33 Prozentpunkte. Die Zahlen beziehen sich auf eine separate Sammlung aus Wahrscheinlichkeit, Statistik, Wirtschaftstheorie und mehreren Bereichen der Physik, die mit aufeinanderfolgenden OpenAI-Systemen ohne Internetzugang getestet wurde.
Diese Prozentsätze sollten nicht mit dem Ergebnis von TheoPhysEval zusammengeführt werden. Aufgaben, Modellzusammenstellung, Bewertung und Umfang unterscheiden sich. Der geprüfte Sekundärbericht schließt außerdem experimentelle und simulationsbasierte Arbeiten aus diesem speziellen Vergleich aus.
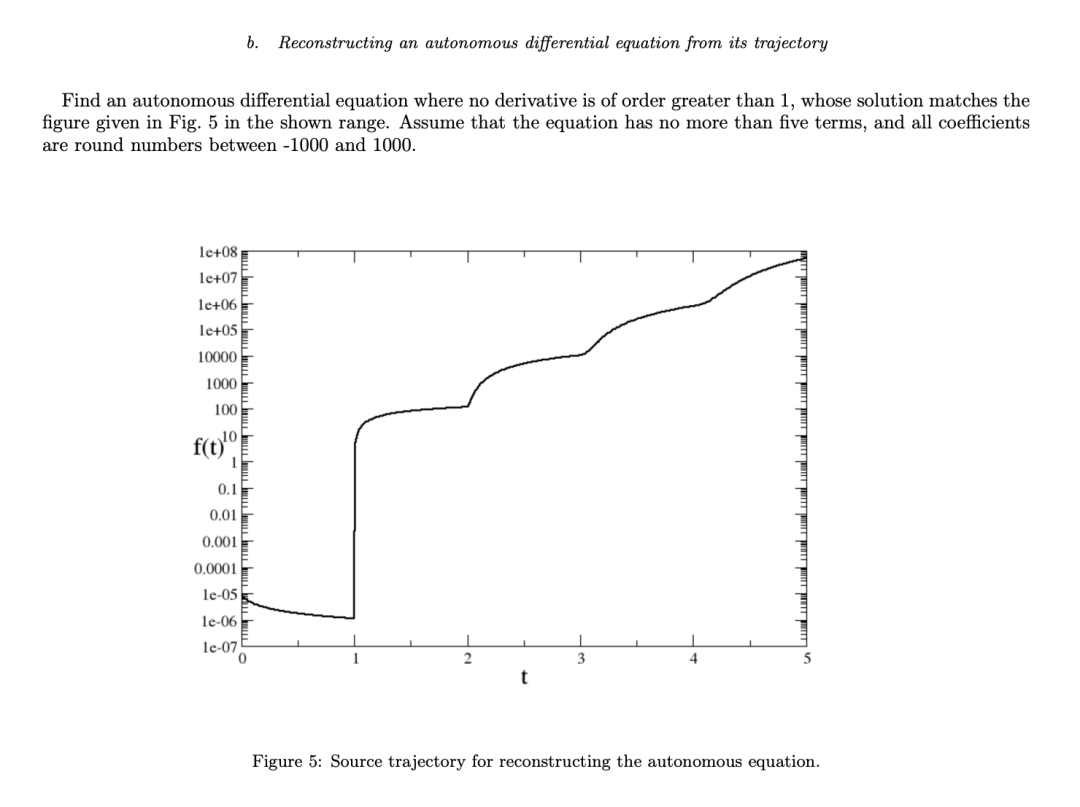
Ein inverses Problem von TheoPhysEval konnte kein getesteter Agent lösen. Gefragt ist eine autonome Differentialgleichung, die mit einer vorgegebenen Trajektorie vereinbar ist. Das Paper diskutiert Informationsasymmetrie und den Interpretationsspielraum der Aufgabenstellung; es belegt nicht, dass eine universelle Abwesenheit von „physikalischer Intuition“ vorliegt.
Die Autoren unterscheiden zwischen konkreten Berechnungen, dem Aufbau von Theorien, der Auswahl wichtiger Fragen und einer Kursänderung, wenn ein Ansatz scheitert. Ihr Fazit spricht für einen von Fachleuten angeleiteten Einsatz von Agenten und wirft zugleich Fragen dazu auf, wie Forschende am Anfang ihrer Karriere Rechenfertigkeiten erlernen sollten.
Eine Übungsaufgabe kann weiterhin wertvoll sein, selbst wenn ein Agent ihr Endergebnis günstig ermitteln kann. Ihr Zweck muss dann im Lernen und Verstehen liegen, statt die Antwort allein als Forschungsbeitrag zu betrachten.
Es handelt sich um eine Sammlung von 50 unveröffentlichten, überprüfbaren Forschungsproblemen auf dem Niveau theoretischer Physik. Die Autoren entwickelten sie, um autonome Berechnungen mit üblichen Agentenwerkzeugen zu bewerten, nicht um die Lösung großer offener Probleme zu untersuchen.
Astra lieferte im Realistic-Track bei 49 von 50 Problemen akzeptierte Endergebnisse. Das Ergebnis gilt für das evaluierte Modell, das Codex-Harness und die verwendete Umgebung – nicht für alle Fragen der Physik.
Nein. Sie konnten weiterhin lokale Rechenwerkzeuge ausführen. Die zentrale Einschränkung betraf den Internetzugang und nicht die Codeausführung.
Das Paper berichtet, dass mehrere ursprünglich abgelehnte Antworten mit korrigierten Referenzlösungen von Fachleuten übereinstimmten. Das spricht dafür, Referenzen sorgfältig zu prüfen, und nicht automatisch davon auszugehen, dass eine Antwort eines Modells oder eines Menschen korrekt ist.
Nein. Unveröffentlichte Antworten reduzieren eine Quelle möglicher Kontamination, aber einige Mitwirkende verwendeten KI-Unterstützung. Die Autoren erkennen ausdrücklich an, dass ein Datenleck nicht ausgeschlossen werden kann.
Die Autoren verlinken den Datensatz und die Evaluationsressourcen auf Hugging Face. Bei einer Reproduktion sollten Modellversionen, Harness-Einstellungen, Tracks, numerische Konventionen und Bewertungsregeln beibehalten werden. Außerdem muss die Variabilität zwischen einzelnen Durchläufen berücksichtigt werden.
TheoPhysEval berichtet über eine außergewöhnliche Leistung bei einer definierten Auswahl fortgeschrittener, überprüfbarer Berechnungen. Die beiden Tracks zeigen, dass nützliche Arbeit von Physik-Agenten erlerntes Wissen, Zugriff auf Fachliteratur und ausführbare Berechnungen miteinander verbinden kann.
Das Ergebnis macht außerdem Fehler in Referenzen, Mehrdeutigkeiten bei der Bewertung und die Grenzen einer Bewertung von Endergebnissen sichtbar. Eine starke Rechenleistung unterstützt fachlich angeleitete Forschung; sie belegt keine autonome Beherrschung wissenschaftlicher Entdeckungen.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



