For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/typesafe-jev-vs-openai-decisions-api-fast-7c48d620.md.
Ein neues KI-Unternehmen hat nur wenige Wochen nach dem Start eines Modells, das keine Essays, keinen Code und keine freundlichen Chat-Antwo...
Ein neues KI-Unternehmen hat nur wenige Wochen nach dem Start eines Modells, das keine Essays, keinen Code und keine freundlichen Chat-Antworten schreiben will, 870 Millionen US-Dollar eingesammelt.
Das Unternehmen heißt TypeSafe AI.
Sein Modell heißt Jev.
TypeSafe gab die Series-A-Finanzierungsrunde am 9. Oktober 2026 mit einer Bewertung von 7,5 Milliarden US-Dollar bekannt. Andreessen Horowitz führte die Runde an. Sequoia Capital, der bestehende Investor DCVC und weitere Investoren beteiligten sich ebenfalls.
Auch das Gründungsteam des Unternehmens sorgte für Aufmerksamkeit.
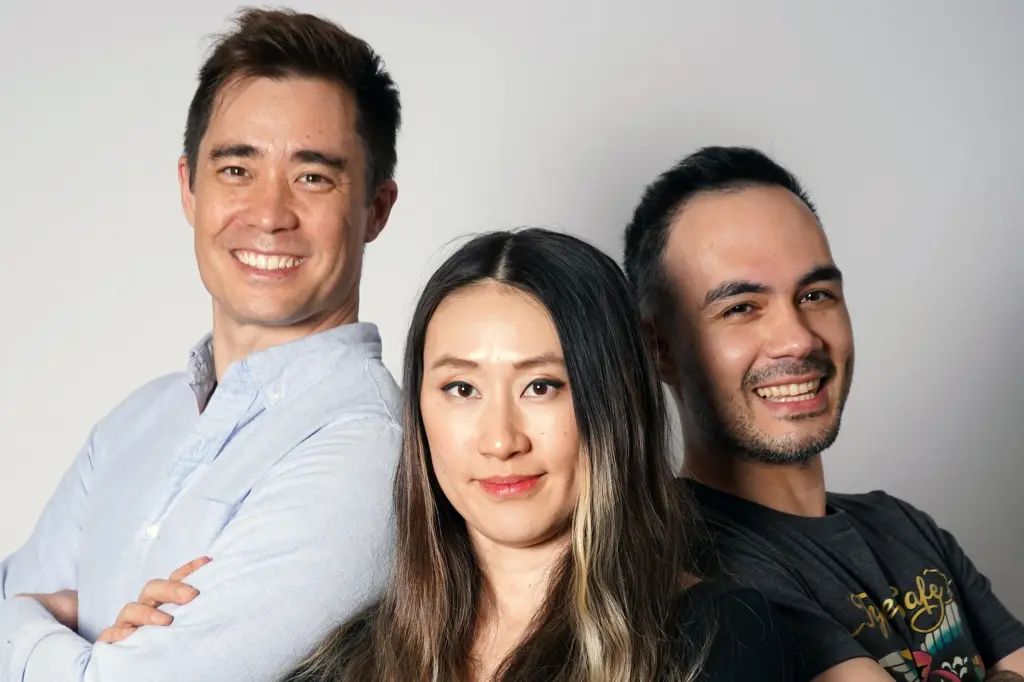
TypeSafe wurde von Erik Gafni, Sasha Sheng und Diogo Almeida gegründet. Almeida arbeitete zuvor bei OpenAI und war an der Entwicklung von Forschungsarbeiten hinter den Instruction-Following-Systemen der ChatGPT-Ära beteiligt. Sheng arbeitete zuvor bei Meta/FAIR, während Gafni einen Hintergrund in Engineering und Start-ups hat.
Jev wurde am 15. September öffentlich gestartet.
Nur zwei Wochen später kündigte OpenAI eine begrenzte Vorschau auf eine auffallend ähnliche Produktrichtung an: eine schnelle API, die Wahrscheinlichkeiten, Auswahlmöglichkeiten und Bewertungen zurückgibt, anstatt lange generierte Texte zu erzeugen. OpenAI überführte dieses Produkt, die Decisions API, am 6. Oktober in die öffentliche Beta.
Der OpenAI-API-Produktleiter Nikunj Handa schrieb Jev später offen die Inspiration für diese Produktkategorie zu.
Das macht Jev aus zwei Gründen interessant.
Erstens schlägt das Modell eine andere Art vor, KI in Software einzusetzen.
Zweitens zwang es ein führendes KI-Labor zu einer ungewöhnlich schnellen Reaktion.
Jev versucht nicht, die KI zu sein, mit der man spricht.
Jev versucht, die KI zu sein, die eine Software tausende oder Millionen Male aufruft, ohne dass man die Antwort jemals zu Gesicht bekommt.
Öffnet man einen E-Mail-Posteingang, warten dort Hunderte kleiner Beurteilungen darauf, getroffen zu werden.
Ist diese Nachricht wichtig?
Enthält sie eine Rechnung, deren Frist bald abläuft?
Erfordert sie eine dringende Antwort?
Hat sich die Besprechungszeit geändert?
Soll die Nachricht archiviert, eskaliert oder ignoriert werden?
Ein Large Language Model für allgemeine Zwecke kann solche Fragen bereits beantworten.
Das Problem ist, dass ein herkömmliches LLM häufig darauf ausgelegt ist, Sprache zu erzeugen.
Bei einer einzelnen E-Mail fällt dieser zusätzliche Aufwand möglicherweise nicht ins Gewicht.
In großem Maßstab schon.
Wenn eine Anwendung dieselbe Art von Entscheidung tausende oder Millionen Male pro Tag trifft, werden kleine Unterschiede bei Latenz und Kosten zu großen Betriebsausgaben.
Jev wurde speziell für diese wiederholten Beurteilungen entwickelt.
TypeSafe beschreibt Jev als ein System-One-Modell.
Die Bezeichnung bezieht sich auf die schnelle, intuitive Denkweise von „System 1“, die durch Daniel Kahneman bekannt wurde.
Statt Jev aufzufordern, einen Absatz zu erzeugen, übergibt eine Anwendung dem Modell einen bestimmten Zustand und eine Reihe vordefinierter Fragen.
Jev gibt typisierte Werte zurück, zum Beispiel:
Die Anwendung kann das Ergebnis direkt verwenden.
Ein vereinfachtes Muster sieht so aus:
Eingehende E-Mail
      ↓
Jev bewertet mehrere Fragen
      ↓
dringende_antwort = 0,91
abrechnungsbezogen = 0,74
besprechungsänderung = 0,03
      ↓
Anwendung wendet ihre eigenen Regeln an
      ↓
Warnung / Archivierung / Weiterleitung / Prüfung
Der wichtige Unterschied liegt in der Schnittstelle.
Bei einem allgemeinen Sprachmodell fordern Entwickler häufig JSON oder ein anderes strukturiertes Format an und validieren anschließend die generierte Antwort.
Bei Jev bilden typisierte Entscheidungsausgaben das zentrale Produktdesign.
Die API von TypeSafe stellt einen systemone-Endpunkt bereit und ermöglicht es Entwicklern, mehrere Fragen zu demselben gemeinsamen Zustand zu übermitteln.
TypeSafe betont die parallele Entscheidungsfindung.
Wenn eine Anwendung dieselbe Eingabe anhand mehrerer unabhängiger Kriterien bewerten möchte, können diese Fragen gemeinsam übermittelt werden, anstatt jede Frage in eine separate Gesprächsrunde zu verwandeln.
Das ist nützlich für Software, die Fragen beantworten muss wie:
Die Anwendung kombiniert diese Ausgaben anschließend mit gewöhnlichem Code.
Das ist ein Grund dafür, dass sich Jev weniger wie ein Chatbot und mehr wie eine intelligente bedingte Anweisung anfühlt.
TypeSafe listet Jev derzeit zu folgendem Preis:
| Nutzung | Jev-Preis |
|---|---|
| Input | 0,042 $ / 1 Mio. Token |
| Output | Kostenlos |
TypeSafe erklärt, dass der Output zu günstig für eine Abrechnung sei, weil Jev keine langen Textsequenzen autoregressiv erzeugt.
Der Preis ist relevant, weil Jev auf Entscheidungen abzielt, die sehr häufig getroffen werden können.
Eine Entscheidung, deren Automatisierung bei einem einzelnen Nutzerereignis zu teuer wäre, kann praktikabel werden, wenn die Kosten um eine Größenordnung sinken.
Dadurch entsteht eine andere Einsatzfrage.
Statt zu fragen:
Ist das wichtig genug, um ein KI-Modell aufzurufen?
können Softwareteams beginnen zu fragen:
Warum sollte die KI nicht auch diesen kleinen Schritt bewerten?
Das ist das wirtschaftliche Argument hinter dem Produkt.
Der hervorgehobene Token-Preis ist nur ein Teil der Produktionskosten.
Teams müssen weiterhin Folgendes messen:
Eine günstige Entscheidung, die zu häufig falsch ist, kann weiterhin teuer sein.
Dieser Punkt wird später bei der unabhängigen Jev-Evaluation wichtig.
Vercel fügte Jev nahezu unmittelbar nach dem Start zu AI Gateway hinzu.
Die Reaktion am ersten Tag war ungewöhnlich stark.
Laut Vercel wurde Jev innerhalb von 24 Stunden von fast 13 % der zahlenden AI-Gateway-Teams verwendet.
Das war mehr als doppelt so viel wie die Reichweite am ersten Tag bei jedem zuvor auf der Plattform gestarteten Modell.
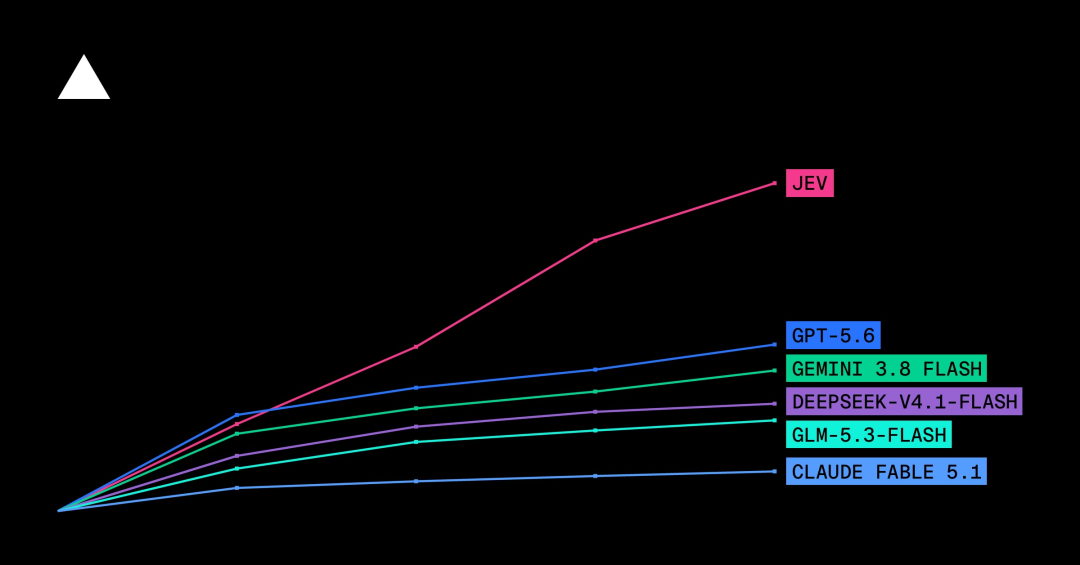
Vercel bezeichnete Jev später als das am schnellsten angenommene Modell in der Geschichte von AI Gateway.
Dieser Anstieg am ersten Tag beweist keine langfristige Bindung.
Er zeigt jedoch, dass Entwickler unmittelbar eine Klasse von Aufgaben erkannten, bei denen ein eng fokussiertes Entscheidungsmodell nützlich sein könnte.
Vercel nennt unter anderem folgende Beispiele:
Das sind keine besonders glamourösen Aufgaben.
Es sind genau die Aufgaben, die Produktionssoftware ständig ausführt.
Die Idee hinter Jev entstand nicht über Nacht.
Diogo Almeida sagte, dass er sich während seiner Arbeit bei OpenAI zunehmend für eine grundlegende Frage interessierte:
Wenn KI die Wirtschaft verändert, wer wird in Zukunft die meisten Modellaufrufe auslösen?
Menschen, die manuell Chatfenster öffnen?
Oder Software, die im Hintergrund automatisch Intelligenz aufruft?
Seine Antwort lautete: Letzteres.
Das verändert, worauf eine KI-Schnittstelle optimieren sollte.
Modelle für menschliche Nutzer profitieren von natürlicher Konversation, flexiblem Fließtext, Erklärungen und Kreativität.
Modelle für Software profitieren von:
Almeida beschrieb Jev als Antwort auf die Lücke zwischen Modellen, die in Gesprächen beeindruckend sind, und Modellen, die sich einfach als zuverlässige Softwarebausteine verwenden lassen.
TypeSafe zufolge entwickelte das Unternehmen das System vor dem öffentlichen Start ungefähr zwei Jahre lang.
Der Start von Jev blieb bei OpenAI nicht unbemerkt.
In einem Interview mit Latent Space, das im Umfeld des OpenAI DevDay aufgezeichnet wurde, schrieb der API-Produktleiter Nikunj Handa Jev direkt die Inspiration für die Initiative rund um die Decisions API zu.
Er erklärte, dass Nutzer und interne Teams nach einem deutlich schnelleren Klassifizierungssystem gefragt hätten.
Außerdem bestätigte er, dass das Projekt nur wenige Wochen zuvor noch nicht auf der Roadmap gestanden hatte.
OpenAI trainierte für die erste Version kein völlig neues Basismodell.
Stattdessen nutzte das Unternehmen GPT-6 Luna und entwickelte darum eine dedizierte Entscheidungsschnittstelle sowie einen eigenen Inferenzpfad.
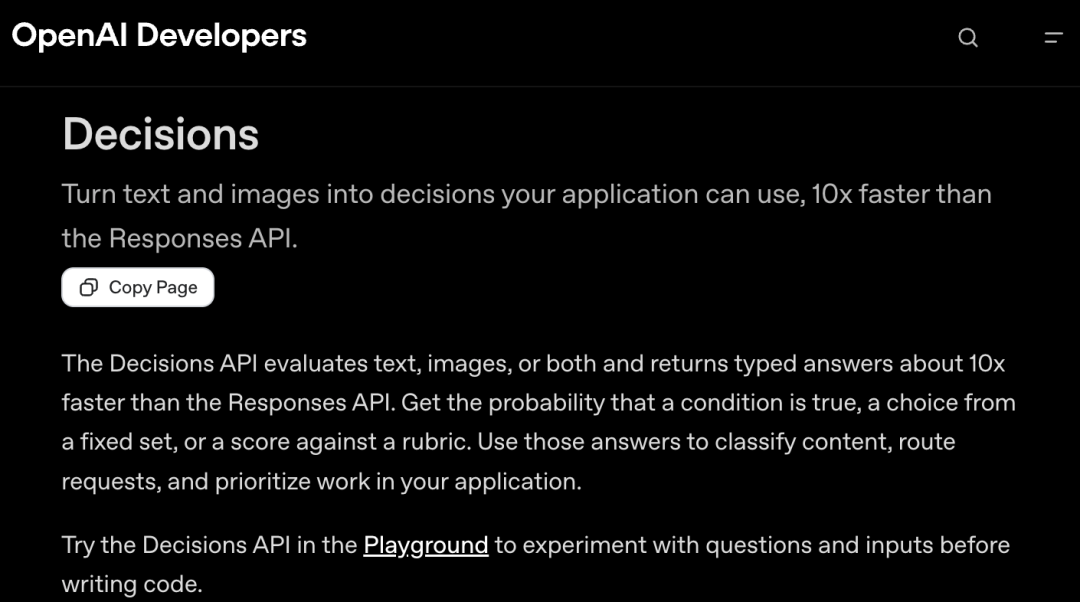
Das Ergebnis ist jetzt als öffentliche Beta verfügbar über:
POST /v1/decisions
Die Decisions API akzeptiert gemeinsame Belege sowie eine oder mehrere Fragen und gibt typisierte Antworten zurück.
OpenAI unterstützt derzeit drei Fragetypen:
| Fragetyp | Ergebnis |
|---|---|
predicate | Wahrscheinlichkeit, dass eine Bedingung wahr ist |
choice | Eine ausgewählte Option sowie Wahrscheinlichkeiten/Konfidenz |
score | Eine Bewertung über geordnete Stufen hinweg |
Das überschneidet sich stark mit den Anwendungsfällen, auf die Jev abzielt.
Dies ist heute der größte architektonische Unterschied zwischen den öffentlich verfügbaren Produkten.
TypeSafe zufolge verwendet Jev eine spezialisierte Modellarchitektur sowie eine Trainingsmethode, die das Unternehmen Reinforcement Learning for Calibrated Decisions (RLCD) nennt.
Die erste Version der OpenAI Decisions API nutzt dagegen bestehende GPT-6-Luna-Gewichte und eine dedizierte Schnittstelle für die Bereitstellung von Entscheidungen.
Konzeptionell:
TypeSafe:
Spezialisiertes Entscheidungsmodell
→ typisierte probabilistische Ausgabe

OpenAI:
GPT-6 Luna
→ spezialisierter Pfad der Decisions API
→ typisierte probabilistische Ausgabe
Das bedeutet, dass die beiden Produkte für Entwickler ähnlich aussehen können, während sie im Hintergrund unterschiedliche Ansätze verfolgen.
Ein praktischer Unterschied betrifft die Eingabemodalität.
Die aktuelle OpenAI Decisions API akzeptiert Text, Bilder oder beides.
Der öffentliche Jev-Start von TypeSafe konzentrierte sich auf Text- und Zustandseingaben.
Die Dokumentation von OpenAI enthält ein Beispiel, in dem die API ein Produktfoto untersucht und schätzt, ob sichtbare Schäden wie ein Riss, ein Riss im Material oder eine Delle vorhanden sind.
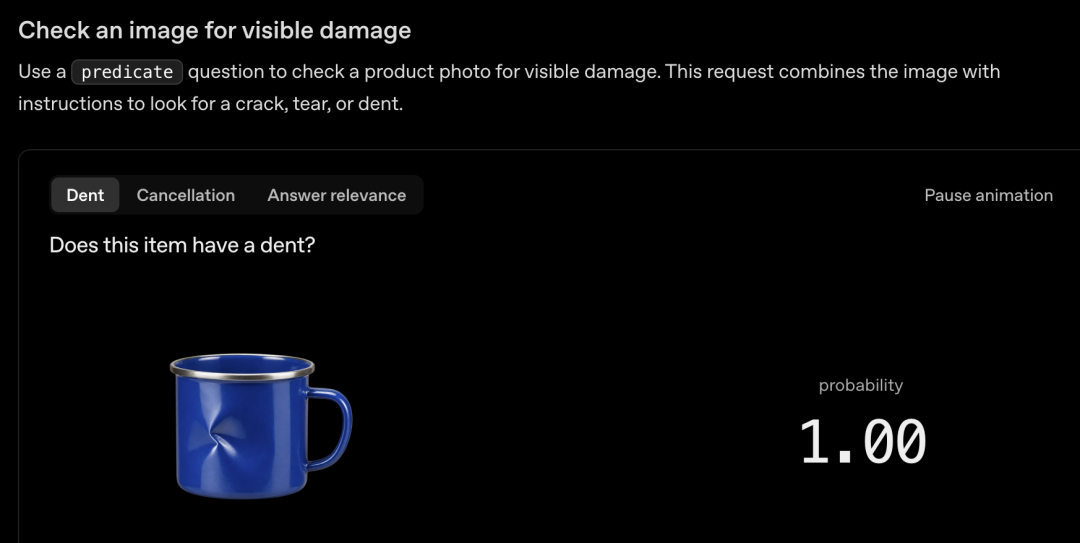
Eine E-Commerce-Anwendung könnte dieses Muster verwenden, um Bilder automatisch zur Prüfung weiterzuleiten.
Zum Beispiel:
Produktfoto
→ Decisions API prüft sichtbare Schäden
→ Wahrscheinlichkeit = hoch
→ Weiterleitung zur manuellen Prüfung
Das ist ein gutes Beispiel dafür, warum Entscheidungs-APIs in gewöhnlicher Software eingesetzt werden können, ohne überhaupt eine Antwort für Nutzer zu erzeugen.
Der Nutzer erfährt möglicherweise nie, welches Modell das Foto bewertet hat.
Er erlebt nur den daraus resultierenden Workflow.
Die derzeit öffentlich verfügbaren Preise sind unkompliziert.
| Produkt | Input-Preis | Output-Preis |
|---|---|---|
| TypeSafe Jev | 0,042 $ / 1 Mio. Token | Kostenlos |
| OpenAI Decisions API mit GPT-6 Luna | 0,10 $ / 1 Mio. Token | Kostenlos |
Beim reinen Preis für Input-Token ist Jev günstiger.
In der Dokumentation der Decisions API erklärt OpenAI, dass die API typisierte Antworten etwa zehnmal schneller als die Responses API zurückgibt.
Diese Zehnfach-Angabe bezieht sich ausdrücklich auf einen Vergleich mit dem eigenen Responses-API-Pfad von OpenAI.
Sie ist kein veröffentlichter direkter Geschwindigkeitsvergleich zwischen Jev und der Decisions API.
Diese Unterscheidung ist wichtig.
Auch TypeSafe veröffentlicht in seinen eigenen Workflow-Evaluationen deutlich größere Geschwindigkeits- und Kostenmultiplikatoren, weist jedoch ausdrücklich darauf hin, dass diese Tests auf der eigenen Methodik beruhen und am oberen Ende der realen Vorteile liegen können.
Für die Auswahl im Produktionsbetrieb sollten Teams ihren tatsächlichen Workload benchmarken.
Das Ungewöhnliche an dieser Produktgeschichte ist, wie direkt OpenAI die Inspiration anerkannte.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Im Latent-Space-Interview sagte Handa, Jev habe die Kategorie inspiriert und Nutzer sowie interne Teams von OpenAI hätten schnell nach einer ähnlichen schnellen Klassifizierungsfunktion gefragt.
Er beschrieb eine kleine interne Gruppe, die zügig einen Prototyp entwickelte und anschließend die Latenz optimierte.
Das bedeutet nicht, dass Jev und die Decisions API identisch sind.
Es zeigt jedoch, dass TypeSafe eine reale Produktlücke gefunden hat.
Der Wettbewerb verlagerte sich von:
Wer hat das leistungsfähigste allgemeine Modell?
zu einer anderen Frage:
Was ist der günstigste und schnellste Modellbaustein
für eine bestimmte wiederholte Entscheidung in Software?
Das ist ein anderer Markt als das traditionelle Benchmarking von Chatbots.
Jeves niedriger Preis wurde kurz nach dem Start einer nützlichen unabhängigen Prüfung unterzogen.
Am 29. September reichten Forscher der Universität Bonn und des Lamarr-Instituts ein Preprint ein, in dem sie Jev 1.13.0 bewerteten.
Die Studie umfasste:
Die gesamten Jev-API-Kosten lagen bei unter 10 US-Dollar.
Das ist eine bemerkenswerte Zahl.
Wichtiger ist jedoch, was die Studie über die Zuverlässigkeit aussagt.
Die Forscher stellten fest, dass Jevs Auswahlwahrscheinlichkeiten für selektive Vorhersagen nützlich sein konnten.
In einfacher Sprache:
Wenn das System nur Fälle beantwortet, bei denen es am sichersten ist, kann die Genauigkeit höher sein.
Je mehr Fälle mit geringer Konfidenz die Anwendung akzeptiert, desto stärker sinkt die Genauigkeit.
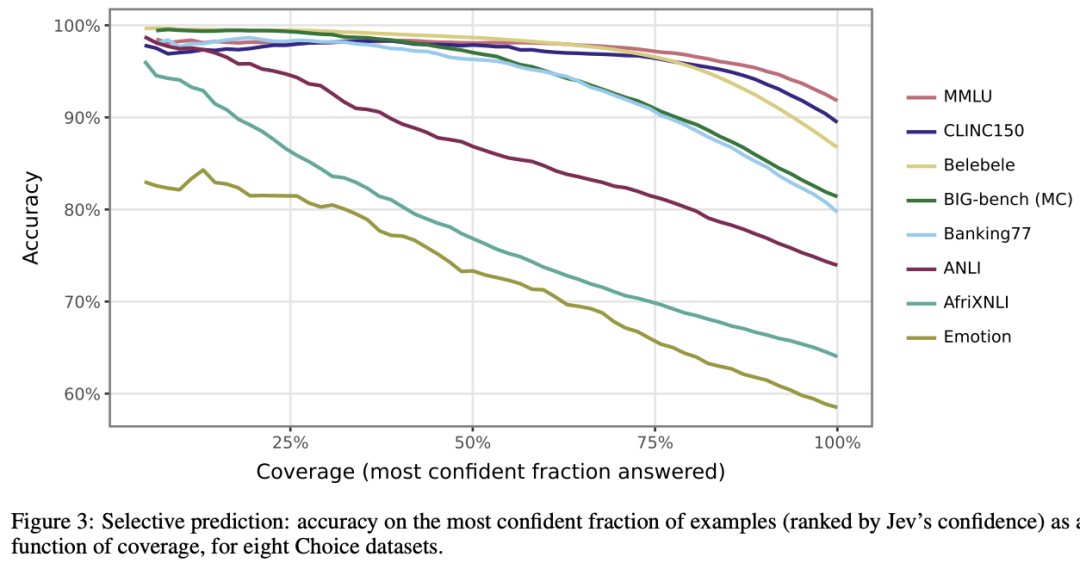
Genau deshalb sind Wahrscheinlichkeiten für die Automatisierung nützlich.
Ein Produktionsworkflow kann für verschiedene Konfidenzstufen ein unterschiedliches Verhalten definieren.
Zum Beispiel:
Konfidenz >= 0,95
→ automatisieren

0,70 <= Konfidenz < 0,95
→ sekundäre Prüfung anfordern

Konfidenz < 0,70
→ manuelle Prüfung
Die genauen Schwellenwerte sollten aus Evaluationsdaten und nicht aus Intuition abgeleitet werden.
Die Studie stellte bei binären Entscheidungen einen wichtigen Vorbehalt fest.
Jevs Wahrscheinlichkeiten konnten Beispiele zwar gut ordnen, lagen jedoch möglicherweise schlecht im Bereich eines festen 0,5-Schwellenwerts.
Das bedeutet, dass folgende Regel:
wenn Wahrscheinlichkeit >= 0,5:
    handeln
nicht automatisch für jede Aufgabe optimal ist.
Bei einer UNFAIR-ToS-Evaluation berichteten die Forscher, dass die Anpassung von Schwellenwerten anhand von Trainingsdaten den Micro-F1-Wert von 0,50 auf 0,75 verbesserte.
Die allgemeine Lehre ist einfach:
Eine Wahrscheinlichkeit ist nützlich, aber die Anwendung muss weiterhin entscheiden, ab welcher Wahrscheinlichkeit gehandelt werden soll.
Das ist nicht spezifisch für Jev.
Es ist eine grundlegende Voraussetzung für den verantwortungsvollen Einsatz probabilistischer Klassifikatoren.
Kehren wir zum Beispiel mit der E-Mail zurück.
Nehmen wir an, ein Modell markiert eine Werbe-E-Mail fälschlicherweise als wichtig.
Die Kosten bestehen in einer kleinen Unannehmlichkeit.
Nehmen wir nun an, es übersieht eine E-Mail, die vor dem Ende des Tages beantwortet werden muss.
Die Kosten können deutlich höher sein.
Der richtige Schwellenwert hängt daher vom Ungleichgewicht zwischen falsch positiven und falsch negativen Ergebnissen ab.
Ein praktisches System kann für unterschiedliche Entscheidungen verschiedene Regeln verwenden:
| Entscheidung | Sicherere Standardeinstellung |
|---|---|
| Erkennung von Werbe-E-Mails | Großzügig automatisieren |
| Erkennung von Abrechnungsfristen | Für Warnungen einen niedrigeren Schwellenwert verwenden |
| Klassifizierung in Recht und Compliance | Unsicherheit eskalieren |
| Aktion bei einem Konto mit hohem Risiko | Menschliche Bestätigung verlangen |
| Tagging von Inhalten mit geringem Wert | Die meisten Fälle automatisieren |
Ein leistungsfähiges Entscheidungsmodell beseitigt keine Produktregeln.
Es macht Produktregeln leichter in Software ausdrückbar.
TypeSafe betont, dass Jevs Ausgabe typsicher ist.
Das ist eine echte technische Eigenschaft.
Wenn der Entwickler eine zulässige Menge von Ausgaben definiert, muss das Modell keine beliebige Zeichenfolge außerhalb dieses Schemas erfinden.
Es gibt jedoch zwei unterschiedliche Arten von Korrektheit:
Die Ausgabe entspricht dem zulässigen Typ.
Die ausgewählte Antwort ist tatsächlich richtig.
Ein Entscheidungsmodell kann die erste Art deutlich stärker gewährleisten als die zweite.
Der unabhängige Benchmark macht diese Unterscheidung deutlich: Jev kann weiterhin die falsche Antwort auswählen, obwohl seine Antwort als typisierter Wert vollkommen gültig ist.
Deshalb lautet die sicherste Interpretation für den Produktionseinsatz:
Jev beseitigt eine große Klasse von Formatierungs- und Parsing-Fehlern, aber nicht Modellfehler.
Die ursprüngliche Quelle hebt zu Recht hervor, dass nicht jede Beurteilung an Jev übergeben werden sollte.
Auch die eigenen Materialien von TypeSafe erkennen an, dass spezialisierte System-One-Modelle eine engere Rolle haben als allgemeine Sprachmodelle.
Eine sinnvolle Arbeitsteilung sieht so aus:
Beispiele:
Beispiele:
Beispiele:
Beispiele:
Das günstige Modell sollte keine neuen Kosten verursachen, weil Menschen die von ihm erzeugten Entscheidungen ständig nachbearbeiten müssen.
Der Name Jev ist eine Anspielung auf den Ökonomen William Stanley Jevons.
Jevons wird mit der heute als Jevons-Paradoxon bezeichneten Idee in Verbindung gebracht.
Die vereinfachte Version lautet:
Ressource wird effizienter
→ Kosten pro Nutzung sinken
→ Nachfrage steigt
→ Gesamter Ressourcenverbrauch kann zunehmen
TypeSafe überträgt diese Logik auf maschinelle Intelligenz.
Wenn jeder KI-Aufruf deutlich günstiger wird, gibt Software möglicherweise nicht einfach weniger für dieselben Workloads aus.
Entwickler könnten völlig neue Workloads erstellen, deren Kosten zuvor eine Umsetzung nicht rechtfertigten.
Das zeigt sich bereits in Beispielen wie:
Das Ergebnis kann ein geringerer Preis pro Entscheidung sein, aber insgesamt eine deutlich höhere Zahl an Entscheidungen.
Das ist die Wette auf das Jevons-Paradoxon hinter Jev.
Der wichtigste Teil dieses Trends könnte für Nutzer unsichtbar sein.
Heute interagieren Menschen häufig ausdrücklich mit KI:
Chatbot öffnen
→ Kontext einfügen
→ Prompt schreiben
→ Antwort lesen
→ Ergebnis in ein anderes Tool zurückkopieren
Maschinenorientierte Entscheidungsmodelle legen ein anderes Muster nahe:
Nutzer verwendet normale Software
→ KI bewertet kleine Entscheidungen im Hintergrund
→ Software leitet weiter, bewertet, prüft oder filtert automatisch
→ Mensch sieht nur die Fälle, die relevant sind
Ein Posteingang kann nur dringende E-Mails anzeigen.
Ein Schreibprogramm kann nur Sätze markieren, die geprüft werden müssen.
Ein Agent kann automatisch das nächste Tool auswählen.
Ein Supportsystem kann Tickets weiterleiten, bevor sie ein Mensch sieht.
Ein Marktplatz kann Kandidaten unmittelbar nach der Registrierung bewerten.
An diesem Punkt ist es dem Nutzer möglicherweise egal, ob das zugrunde liegende System Jev, GPT-6 Luna oder ein anderes Entscheidungsmodell verwendet.
Dem Nutzer ist wichtig, dass sich die Software schneller anfühlt und weniger manuelle Schritte erfordert.
Die Finanzierung von TypeSafe ergibt aus dieser Perspektive mehr Sinn.
Das Unternehmen setzt nicht darauf, dass Menschen einen weiteren Chatbot-Tab wollen.
Es setzt darauf, dass Software selbst eine enorme Zahl von Modellaufrufen ausführen wird.
TypeSafe zufolge nutzt bereits ein Drittel der Fortune 500 Jev. Dabei handelt es sich um eine vom Unternehmen gemeldete Adoptionszahl, und TypeSafe hat bislang nicht alle dieser Kunden öffentlich genannt.
Die Series-A-Finanzierung über 870 Millionen US-Dollar gibt TypeSafe erhebliches Kapital, um diese Strategie auszubauen.
In der Finanzierungsankündigung erklärt das Unternehmen, dass es Folgendes entwickeln will:
Die schnelle Reaktion von OpenAI mit der Decisions API deutet darauf hin, dass große KI-Labore dieselbe Chance sehen.
Die nächste Wettbewerbsfrage lautet nicht einfach, welches System am günstigsten ist.
Entscheidend ist, welches System zuverlässig genug entscheidet, damit Entwickler bereit sind, Software diese Entscheidungen automatisch ausführen zu lassen.
Jev ist das erste „System-One-Modell“ von TypeSafe AI. Es wurde für schnelle, maschinenlesbare Entscheidungen statt für die freie Erzeugung von Text entwickelt. Das Modell akzeptiert einen gemeinsamen Zustand sowie typisierte Fragen und gibt Auswahlmöglichkeiten, Bewertungen oder Wahrscheinlichkeiten zurück, die Software direkt verwenden kann.
TypeSafe listet Jev derzeit mit 0,042 US-Dollar pro einer Million Input-Token, während der Output kostenlos ist. Die tatsächlichen Anwendungskosten hängen vom Anfragevolumen, der Eingabegröße, Wiederholungsversuchen, dem Evaluationsaufwand und der Zahl der Fälle ab, die an größere Modelle oder Menschen eskaliert werden.
TypeSafe beschreibt Jev als transformerbasiertes System-One-Modell und nicht als herkömmliches Large Language Model zur Textgenerierung. Sein prägendes Produktverhalten besteht darin, keinen beliebigen Fließtext zu erzeugen, sondern typisierte probabilistische Entscheidungen zurückzugeben.
Ja. Typsichere Ausgaben verhindern bestimmte Formatierungs- und Schemafehler, aber die ausgewählte Entscheidung kann semantisch weiterhin falsch sein. Eine unabhängige Evaluation zeigt starke Ergebnisse bei vielen Datensätzen, stellt aber auch aufgabenabhängige Fehler und Probleme bei der Schwellenwertkalibrierung fest.
Die OpenAI Decisions API ist ein Endpunkt in der öffentlichen Beta, der von GPT-6 Luna betrieben wird und Text oder Bilder in typisierte Prädikate, Auswahlmöglichkeiten oder Bewertungen umwandelt. OpenAI bewirbt sie als ungefähr zehnmal schneller als die Ausführung derselben Aufgabenkategorie über die Responses API.
Der aktuelle Preis der Decisions API beträgt 0,10 US-Dollar pro einer Million Input-Token, ohne Gebühr für Output-Token. Jevs veröffentlichter Grundpreis für Input liegt mit 0,042 US-Dollar pro einer Million Token niedriger; auch der Output ist kostenlos.
Eine Wahrscheinlichkeit sagt einer Anwendung allein noch nicht, welche Aktion sie ausführen soll. Teams sollten Schwellenwerte anhand gelabelter Evaluationsdaten und der realen Kosten von falsch positiven Ergebnissen, falsch negativen Ergebnissen und manueller Prüfung festlegen, statt automatisch anzunehmen, dass 0,5 immer der richtige Grenzwert ist.
Entscheidungsmodelle eignen sich am besten für hochvolumige Klassifizierung, Weiterleitung, Bewertung, Verifizierung und Verzweigung, wenn die möglichen Ausgaben im Voraus definiert werden können. Allgemeine Modelle sollten eingesetzt werden, wenn eine Aufgabe offene Schlussfolgerungen, Erklärungen, Inhaltserstellung oder komplexe Planung erfordert.
TypeSafe Jev verfolgt einen bewusst eng gefassten Ansatz für KI: Statt Sprache für Menschen zu erzeugen, produziert das Modell typisierte Entscheidungen für Software. Dadurch werden hochvolumige Klassifizierung, Weiterleitung, Bewertung und Verifizierung günstiger und leichter in Code integrierbar.
Die frühe Akzeptanz war so stark, dass OpenAI mit der GPT-6-Luna-basierten Decisions API schnell in dieselbe Produktkategorie eintrat. Jev bleibt beim veröffentlichten Grundpreis für Input günstiger, während OpenAI Bildunterstützung und die Reichweite einer bestehenden Plattform für allgemeine Modelle bietet.
Die zentrale technische Herausforderung ist die Zuverlässigkeit, nicht die Formatierung. Typisierte Ausgaben beseitigen eine Fehlerklasse, aber die Entscheidungsgenauigkeit hängt weiterhin vom Datensatz, vom Schwellenwert, von den Fehlerkosten und von der Eskalationsstrategie ab. Die unabhängige Jev-Studie macht das besonders deutlich.
Die größere Veränderung besteht darin, dass KI möglicherweise aufhört, etwas zu sein, mit dem Nutzer ausdrücklich „sprechen“, und stattdessen zu einer kostengünstigen Entscheidungsebene wird, die unauffällig in gewöhnlicher Software arbeitet.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



