El volumen de búsqueda responde a "cuántas personas buscan con este conjunto de palabras", pero no responde a "qué más preguntará esta persona antes de tomar una decisión". La búsqueda con IA convierte esto último en una variable decisiva: cuando un usuario plantea una pregunta con condiciones restrictivas en ChatGPT, Perplexity, Gemini o Google AI Mode, el motor genera por sí mismo múltiples subconsultas para recuperar información y luego ensambla los párrafos recuperados en una respuesta con citas. Lo que determina si puedes ser citado ya no es solo si te posicionas para una palabra, sino si la página contiene párrafos que puedan extraerse de forma independiente y que respondan exactamente a alguna subconsulta.
Por eso, una formulación más precisa es: el volumen de búsqueda sigue siendo una señal útil del tamaño de la demanda, pero es un indicador de punto de partida, no de punto final. La investigación de palabras clave debe añadir tres cosas: la cadena completa de preguntas detrás de esa demanda, el formato de recuperación correspondiente a cada pregunta y si la página cuenta con bloques de respuesta extraíbles.
Por qué fijarse solo en el volumen de búsqueda hace perder la intención real de compra
El proceso tradicional es "palabra clave principal → palabras relacionadas → contenido", y asume que cada búsqueda es una necesidad independiente con una forma léxica fija. El comportamiento del usuario ya ha cambiado: una pregunta real a menudo incluye simultáneamente presupuesto, escenario, compatibilidad y forma de uso, por ejemplo, "un portátil de menos de quince mil, que pueda editar vídeo, con buena autonomía y fácil de llevar de viaje". En la búsqueda con IA, estas condiciones se dividen en distintas ramas y se recuperan por separado.
Tomemos como ejemplo la compra B2B: detrás de "best CRM software" suele haber una cadena de preguntas consecutivas: ¿cuál es adecuado para pequeñas empresas? ¿Admite automatización de correo? ¿Se integra con Shopify? ¿Cuál tiene la cuota mensual más baja? El valor de recuperación de estas cuatro preguntas puede ser superior al de la palabra original, pero el volumen de búsqueda mensual suele ser cercano a cero: pocas personas escriben la pregunta completa en la caja de búsqueda, pero sí se la preguntan a la IA.
De ahí surgen dos lagunas. Primera, un volumen de búsqueda bajo no equivale a un valor comercial bajo. Segunda, el volumen de búsqueda no ofrece ninguna pista sobre el formato de respuesta: no te dice que una necesidad comparativa requiere una tabla, que una necesidad de proceso requiere pasos numerados o que una necesidad de definición requiere una explicación de treinta o cincuenta palabras que se sostenga por sí sola. Y son precisamente estos formatos los que determinan si el contenido puede recuperarse.
¿Qué es Query Fan-Out (expansión de consultas)?
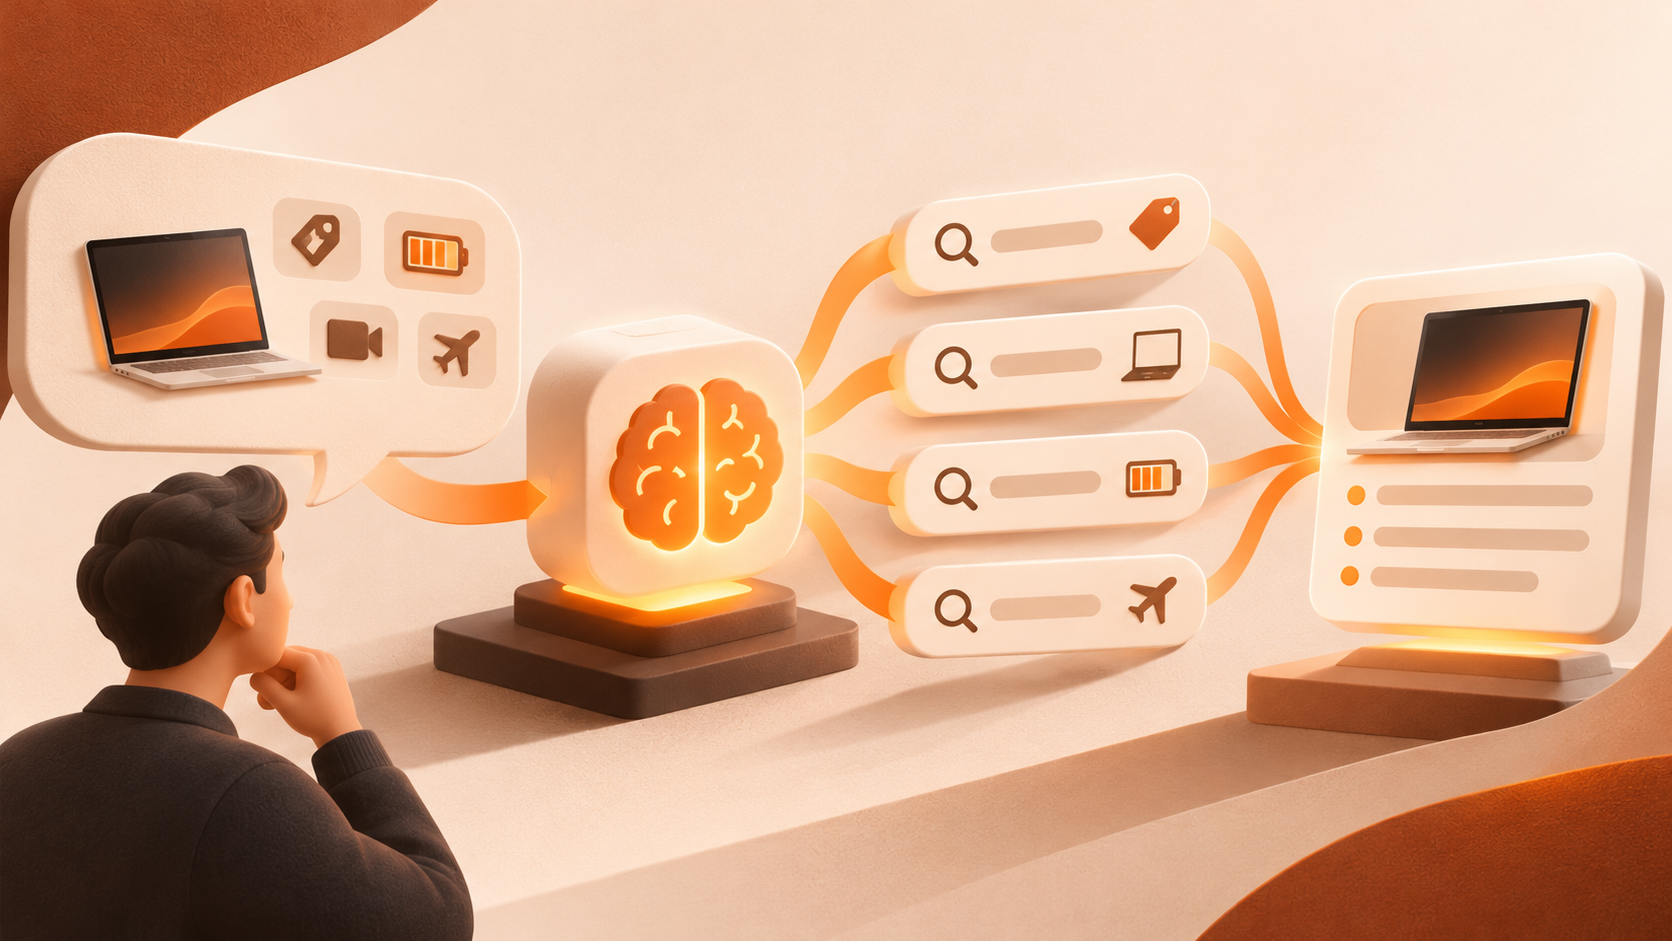
Query Fan-Out se refiere a que los motores de búsqueda con IA dividen una pregunta en varias subconsultas generadas por el propio modelo, recuperan en paralelo, puntúan los párrafos devueltos y luego sintetizan una respuesta con citas. Google explica en su documentación sobre funciones de IA que experiencias como AI Mode y AI Overviews pueden utilizar esta técnica para presentar "un conjunto más amplio y variado de enlaces útiles" que la página de resultados convencional (Google Search Central).
A nivel de ingeniería, suele dividirse en cinco pasos: identificar intención y complejidad, generar subconsultas, filtrar subconsultas altamente duplicadas, recuperar en paralelo y sintetizar la respuesta con citas. El tercer paso es el que más se pasa por alto: el sistema prefiere la cobertura a la repetición, y dos páginas con contenido similar generalmente no entran simultáneamente en la recuperación.
En cuanto a escala, la observación pública indica aproximadamente lo siguiente: una sola pregunta en AI Mode genera alrededor de 8–12 subconsultas paralelas (en la práctica, comúnmente 3–8); ChatGPT realiza en promedio 4,7 subconsultas por búsqueda en línea; "cientos de búsquedas" solo se aplica a canalizaciones de múltiples rondas como Deep Search, con un límite de unas 20 rondas. Lo más importante es la forma de las subconsultas: el análisis inverso muestra que tienen en promedio 70–80 palabras, una complejidad aproximadamente 17–26 veces mayor que las palabras clave tradicionales de tres o cuatro palabras (MaximusLabs). El motor no busca con tu palabra clave, sino con una descripción completa que incluye contexto y escenario de uso.
La expansión tampoco ocurre de forma incondicional. Las patentes relacionadas vinculan la generación de subconsultas con la longitud de la entrada, la frecuencia de la consulta, la calidad de los resultados, el número de tokens y la carga del servidor. Las preguntas cortas de navegación o de datos simples a menudo solo ejecutan una recuperación cercana a la pregunta original; las preguntas largas de comparación o evaluación son las que despliegan el árbol de ramificaciones más grande. Por eso, el presupuesto debe priorizar las preguntas comerciales complejas.
La intención de búsqueda pasa de "una palabra" a "una cadena de preguntas"
Las cuatro categorías de intención (navegacional, informativa, de investigación comercial y transaccional) siguen vigentes, pero en la búsqueda con IA una intención principal se ramifica en múltiples niveles de subintención. Tomemos como ejemplo "How do I choose the best SEO tool for my business?": la intención principal es elegir herramienta, pero las subintenciones incluyen: ¿qué tipo de herramienta necesito? ¿Cuál es mi presupuesto? ¿Qué funciones son clave? ¿Necesito capacidades de SEO técnico? ¿Qué es adecuado para principiantes y qué para agencias?
Aquí conviene distinguir dos conceptos que a menudo se confunden: el clustering de palabras clave agrupa palabras similares por intención, semántica y solapamiento de SERP, y resuelve cómo organizar el contenido; Query Fan-Out describe cómo una pregunta se fragmenta en múltiples rutas de recuperación, incluidos temas que el usuario nunca mencionó, y resuelve cómo ocurre la recuperación (SEO for Today). El primero es un método editorial; el segundo, un mecanismo de ingeniería. No pueden sustituirse mutuamente.
Tabla: ocho tipos de subconsultas y el formato de contenido que necesitan
Tras clasificar las ramas de expansión, una pregunta suele generar ocho tipos de subconsultas, y cada tipo requiere un formato de párrafo diferente. Esta tabla puede usarse directamente como lista de autoevaluación de contenido:
| Tipo de subconsulta | Ejemplo | Formato de contenido necesario |
|---|---|---|
| Coincidencia exacta | best CRM software | Bloque de respuesta que enumera opciones directamente |
| Variante semántica | top CRM platforms | Reformular la misma respuesta con otra expresión del comprador |
| Navegacional | Página de precios de un proveedor | Página de producto o precios rastreable y con estructura clara |
| Comparativa | A vs B for small business | Filas de tabla con atributos explícitos |
| Definición | what is pipeline attribution | Definición breve de treinta o cincuenta palabras que se sostenga por sí sola |
| Proceso | how to migrate CRM data | Pasos numerados, una acción por paso |
| Lista | CRM tools for agencies | Lista escaneable con criterios de filtrado |
| Escenario | CRM for a 3-person team | Frase limitativa que nombre el tamaño del equipo y el escenario de uso |
Las páginas de prosa pura suelen cubrir solo dos o tres de estos tipos: sin tabla, la rama comparativa no tiene contenido que extraer; sin pasos numerados, la rama de proceso queda vacía; si nunca se ha escrito el tamaño del equipo, la rama de escenario no coincide. El formato aquí no es una preferencia de maquetación, sino la capacidad de recuperación en sí misma.
De una palabra clave a una cadena completa de preguntas: método de cinco pasos
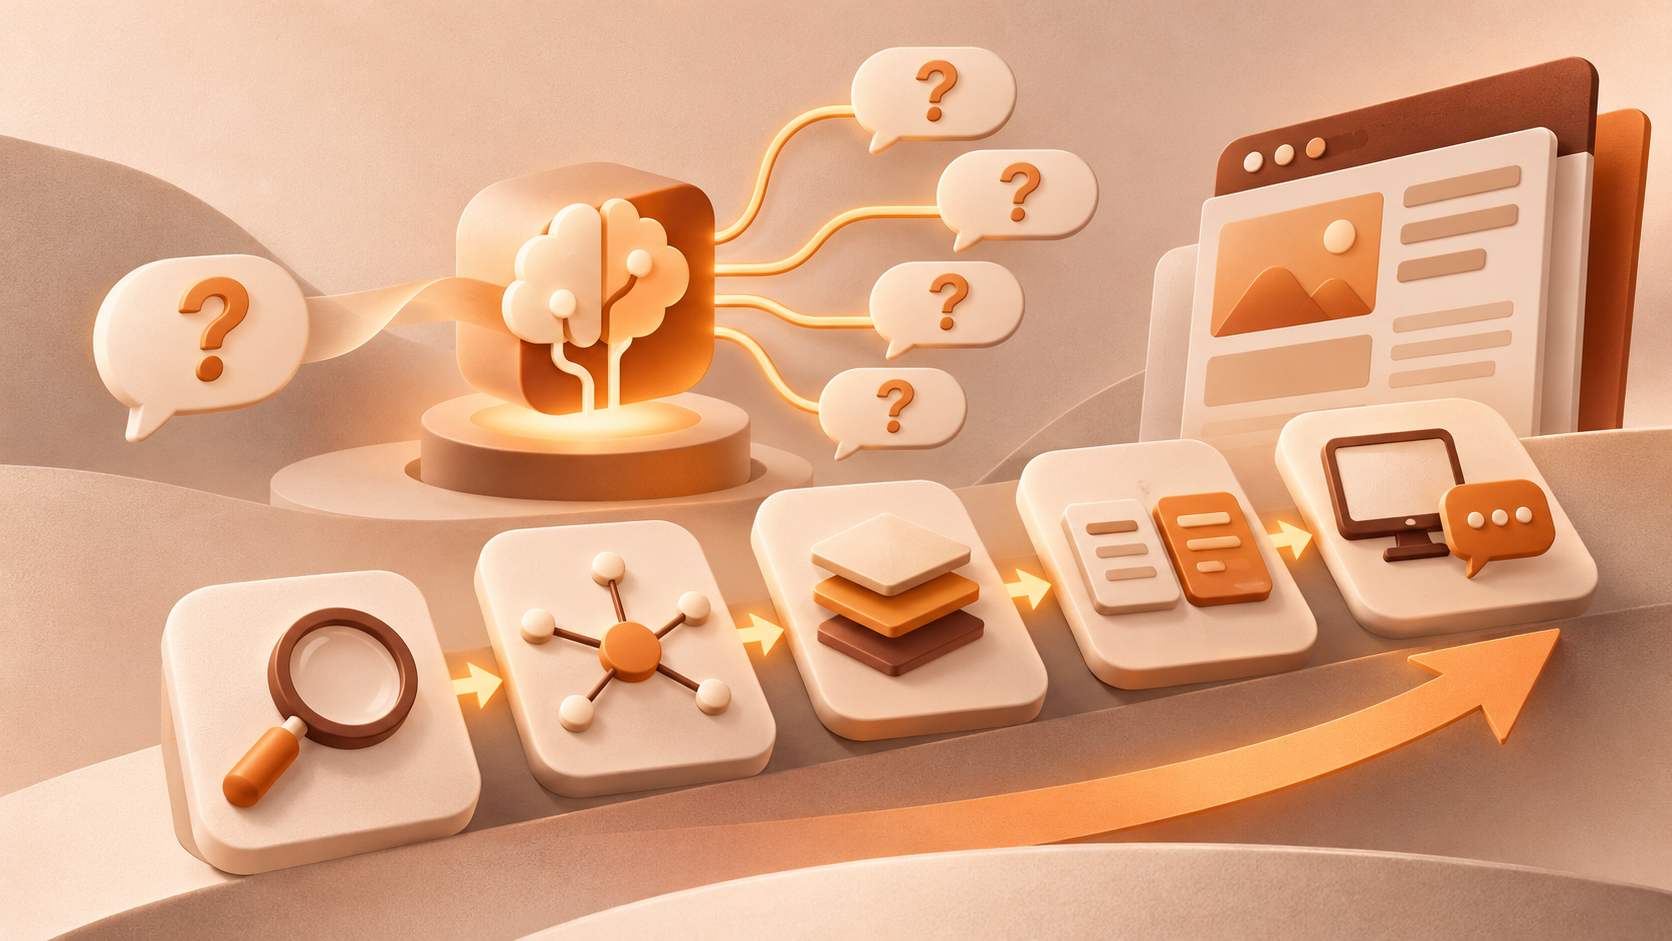
Primer paso: enumerar indicaciones semilla en lugar de palabras clave. Reúne 10–20 preguntas que un cliente ideal realmente formularía antes de reservar una demostración, cuanto más coloquiales, mejor.
Segundo paso: ejecutar cada semilla en Perplexity. Su interfaz muestra la recuperación realmente ejecutada y es uno de los pocos lugares donde hoy puede observarse el comportamiento de expansión.
Tercer paso: registrar una a una las 5–8 preguntas relacionadas que genera, manteniendo el enunciado original, sin reescribirlo como palabra clave.
Cuarto paso: cruzar la misma serie de semillas con herramientas de preguntas y respuestas como AlsoAsked para completar las ramas omitidas.
Quinto paso: mapear las subpreguntas supervivientes a los H2 y H3 de las páginas existentes. El principio es "un grupo de preguntas, una página", no "una subconsulta, una página": crear páginas delgadas separadas para cada subconsulta diluye la autoridad y roza el límite de las políticas de Google sobre abuso de contenido a escala (MaximusLabs).
Hay que aclarar que el árbol de ramificaciones real es conversacional y personalizado, y no puede replicarse por completo desde fuera. La cadena de preguntas es un valor aproximado reconstruido, adecuado para planificar la cobertura, pero no para presentarlo externamente como datos precisos.
Crea un sitio de presentacion y capta leads en minutos
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Clústeres de contenido: convertir la cadena de preguntas en una estructura de tres niveles
En la implementación puede dividirse en tres niveles: la página pilar responde al "marco completo de cómo tomar esta decisión"; las subpáginas asumen subpreguntas con demanda de búsqueda independiente, como la comparación de un tipo de solución o la estructura de precios de un sector; el bloque de FAQ asume preguntas secundarias, como compatibilidad, reembolsos o configuración mínima.
Para decidir si una subpregunta debe tener página propia, usa tres comprobaciones: ¿se plantearía por separado en una conversación real? ¿Su tarea de respuesta no puede asumirla la página pilar sin salirse del tema? ¿Puedes explicar en una frase en qué no se solapa con las páginas del mismo nivel? Solo si las tres respuestas son afirmativas se crea una página nueva.
Al mismo tiempo, hay que ser consciente de las diferencias de prioridad en el fondo del embudo. La expansión de las preguntas de compra suele concentrarse en precio, plan, cuota gratuita, política de reembolso y comparación con competidores; por eso las páginas comparativas y de precios entran más fácilmente en la ruta de compra que las páginas de definición; las preguntas de definición a menudo las responde el propio motor, y ganarlas solo supone obtener una mención.
¿Cómo deben repartirse las tareas el FAQ y la página de producto?
Ambos asumen tareas de recuperación diferentes; mezclarlos empeora a los dos. El objetivo de la página de producto es dejar claro "si soy adecuado para esto": quién es el público, qué capacidades incluye, dónde están los límites, cuál es la estructura de precios y cómo empezar. Debe indicar explícitamente el tamaño del equipo, los escenarios de uso, las integraciones y las limitaciones, porque son precisamente la información limitativa que las subconsultas de escenario usan para coincidir.
El objetivo del FAQ es eliminar la fricción en la decisión, respondiendo esas preguntas secundarias que no entran en el tronco pero que el usuario seguro hará. Cada respuesta debe sostenerse de forma independiente fuera de contexto: sustituir pronombres por nombres de entidades, dar primero la conclusión y luego las condiciones, y mantener una extensión de decenas de palabras.
El orden estructural dentro de la página también es una decisión de recuperación. En observaciones de patrones de citación, alrededor del 44 % de la cuota de citas se concentra en el primer 30 % del cuerpo, y luego disminuye gradualmente (MaximusLabs). Por eso, la respuesta más comercial debe aparecer en el primer tercio de la página, no dejarse para el final.
¿Se pueden cubrir al mismo tiempo los motores de búsqueda y la búsqueda conversacional?
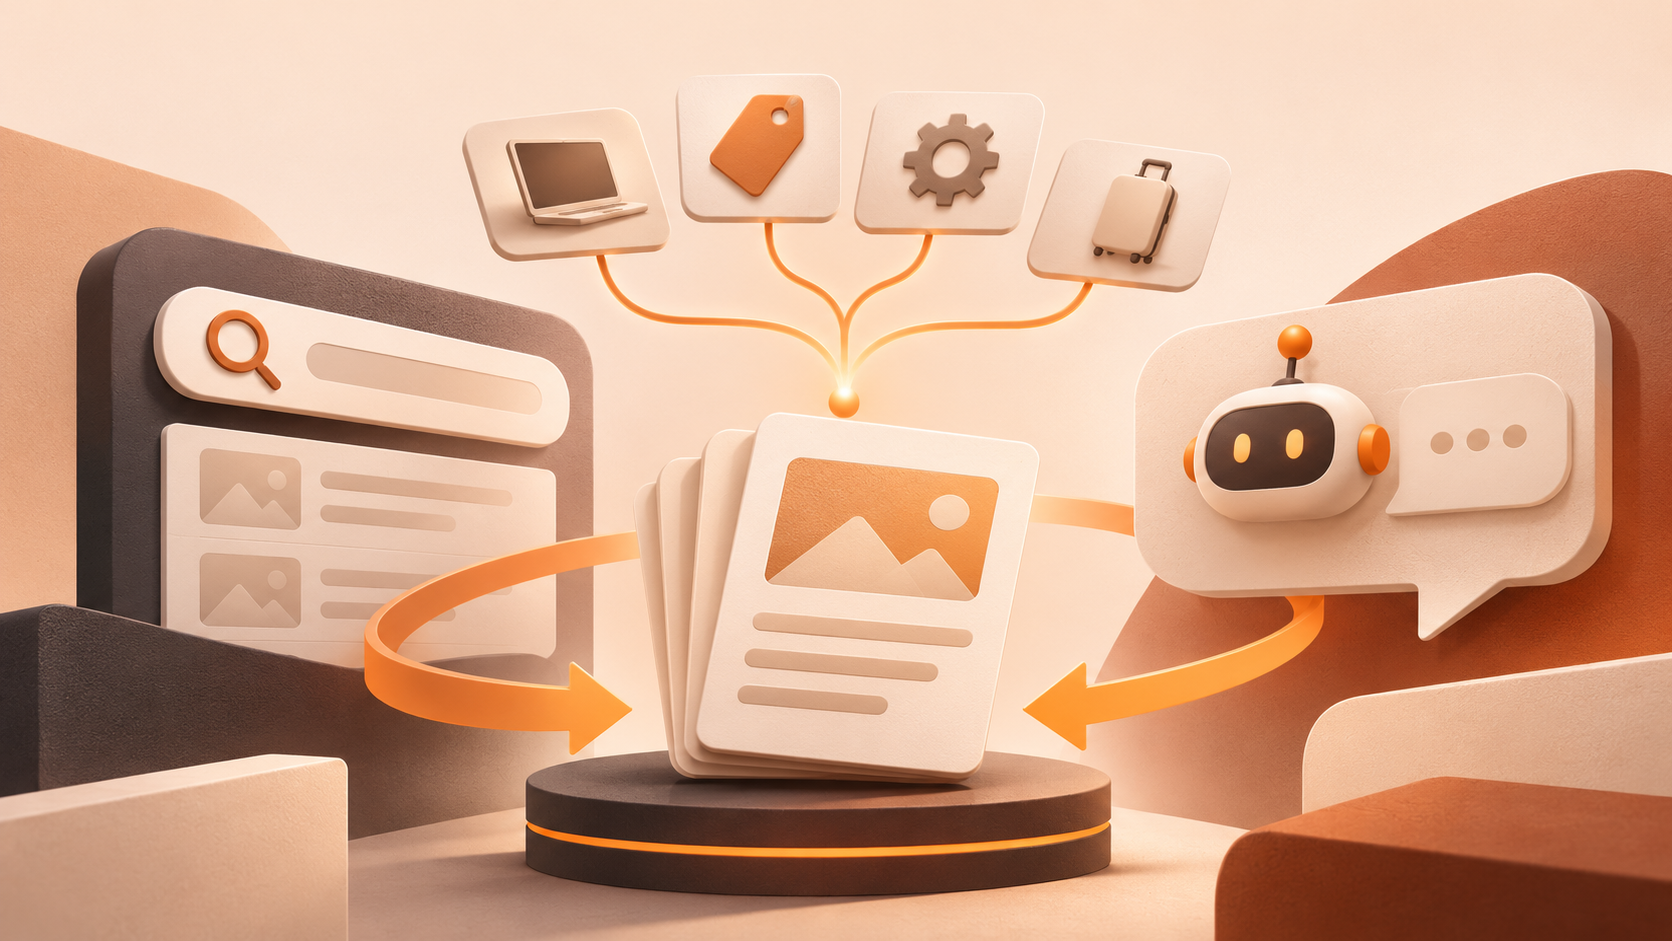
En la mayoría de los casos sí, y el solapamiento es mayor de lo que se cree. Las preferencias de varias entradas principales no entran en conflicto: AI Mode valora la cobertura de subtemas y la claridad de los párrafos; ChatGPT valora los bloques de preguntas y respuestas autocontenidos y las señales de profesionalidad; Perplexity valora la actualidad y la transparencia de las fuentes; el modo de investigación de Claude valora la profundidad y el método. Su intersección es: respuesta al principio, fuentes visibles, lenguaje sencillo y profundidad real en el cuerpo.
Un cambio de dirección digno de mención: en observaciones públicas, la dependencia de las citas de AI Overview respecto a los 10 primeros resultados orgánicos cayó de alrededor del 76 % a alrededor del 38 %, y una proporción considerable de citas proviene de posiciones fuera del top 100 (MaximusLabs). Su significado no es "el ranking es inútil", sino "el ranking ya no es la única puerta de entrada a la citación": el peso de que un párrafo pueda extraerse y responda directamente a la pregunta aumenta claramente.
Lo básico sigue siendo necesario: la rastreabilidad técnica, la estructura del contenido, los enlaces internos y los datos estructurados siguen siendo el requisito previo para entrar en las experiencias de búsqueda con IA (Google Search Central).
Qué deben hacer ahora las empresas: lista de verificación de seis puntos
| Prioridad | Acción | Criterio de finalización |
|---|---|---|
| 1 | Sustituir la lista de palabras clave por 10–20 preguntas reales de clientes | Cada una es una pregunta completa en lenguaje coloquial |
| 2 | Ejecutarlas en Perplexity y registrar las preguntas posteriores | Al menos 5 ramas registradas por semilla |
| 3 | Autoevaluar la cobertura de los ocho tipos de subconsulta en las páginas comerciales clave | Cubrir al menos seis de los ocho tipos |
| 4 | Añadir un bloque de respuesta independiente bajo cada H2 | Sustituir pronombres por nombres de entidades, conclusión primero y condiciones después |
| 5 | Adelantar los bloques más comerciales al primer tercio | Que aparezcan dentro de una pantalla después de la primera |
| 6 | Asignar una única página de destino a cada grupo de preguntas | Que no haya dos páginas que respondan a la misma pregunta |
Al mismo tiempo, conserva parte del juicio basado en el volumen de búsqueda: sigue siendo una señal de bajo coste para estimar el tamaño de la demanda, establecer prioridades y determinar la estacionalidad. Lo que realmente hay que abandonar es la regla lineal de "si el volumen de búsqueda es alto, se escribe; si es bajo, no se escribe".
Cómo we0 conecta esta cadena
Para que la cadena de preguntas se convierta en un activo de contenido, al final debe aterrizar en el sitio web: estructura de páginas, bloques de FAQ, tablas comparativas, datos estructurados, versiones multilingües y ritmo de actualización posterior. La ruta que ofrece we0.ai consiste en colocar la creación del sitio y el crecimiento de contenido en un mismo espacio de trabajo: describir los requisitos en lenguaje natural, generar páginas funcionales mediante la colaboración de múltiples agentes, ajustarlas en un lienzo visual y desplegarlas en un dominio propio, mantener el contenido de forma continua con el CMS y gestionar en el sitio la configuración relacionada con SEO y GEO (we0.ai).
Para los equipos que necesitan validar rápidamente grupos de preguntas, el valor de esta integración no está en "lo rápido que genera", sino en que, desde una frase de requisitos hasta la publicación de la página y la comprobación de cobertura según la cadena de preguntas, no hay que mover contenido y textos entre tres o cuatro herramientas.
FAQ
P: ¿Sigue siendo necesario mirar el volumen de búsqueda de palabras clave?
Sí, pero para juzgar el tamaño de la demanda y la prioridad, no como única base para elegir temas. El volumen de búsqueda no refleja las ramas de subconsultas, los formatos de respuesta ni los niveles de intención; estas tres cosas deben completarse con la investigación de la cadena de preguntas.
P: ¿Query Fan-Out y el clustering de palabras clave son lo mismo?
No. El clustering de palabras clave agrupa palabras similares por intención y semántica, y sirve para organizar el contenido; la expansión de consultas es el mecanismo por el que el motor divide una pregunta en múltiples subconsultas y las recupera en paralelo, y sirve para explicar el comportamiento de recuperación.
P: ¿Cómo saber si mi página puede ser citada?
Empieza por la extraibilidad: si cada subsección tiene un bloque de respuesta que se sostiene por sí solo, si nombra entidades y escenarios de uso, si hay tablas o pasos y si las fuentes son visibles. Todo esto puede verificarse manualmente, sin depender de puntuaciones de terceros.
P: ¿Qué hacer si un equipo pequeño no tiene presupuesto para una investigación completa?
Empieza con el circuito mínimo: elige 10 preguntas reales de clientes, ejecuta una búsqueda conversacional y registra las ramas, completa las tablas, pasos y bloques de respuesta en las páginas comerciales clave, y vuelve a ejecutarlo trimestralmente anotando la fecha, para distinguir si los cambios en los resultados provienen de ajustes de contenido o de actualizaciones del motor.
Related Tools
- Documentación de funciones de IA de Google Search Central: confirma el criterio oficial y los requisitos básicos.
- Perplexity: la interfaz muestra el proceso de recuperación, útil para observar el comportamiento de expansión.
- AlsoAsked: obtiene grupos de preguntas por palabra clave y completa las ramas omitidas.
- we0.ai: espacio de trabajo integrado desde la creación del sitio hasta la operación de contenido y la configuración de SEO/GEO.
Related Links
- Google Search Central — AI features and your website
- MaximusLabs — What is Query Fan-Out?
- SEO for Today — Query Fan-Out: How AI Search Is Changing Keyword Research
- we0.ai — AI 智能建站与获客工作台
Summary
El volumen de búsqueda no ha dejado de ser útil; simplemente pasa de ser la "base para elegir temas" a una "referencia del tamaño de la demanda". El nuevo trabajo de la investigación de palabras clave consiste en ampliar una palabra a una cadena completa de preguntas, preparar para cada pregunta un formato de respuesta extraíble y asignar páginas por grupos de preguntas en lugar de por palabras sueltas. Esto sirve tanto a los resultados de búsqueda tradicionales como a la búsqueda conversacional que reescribe sus propias consultas. El criterio de juicio también cambia: no es cuánto volumen de búsqueda tiene la palabra, sino si, cuando el usuario encadena la cuarta o quinta pregunta, tu sitio puede seguir siendo la respuesta citada.