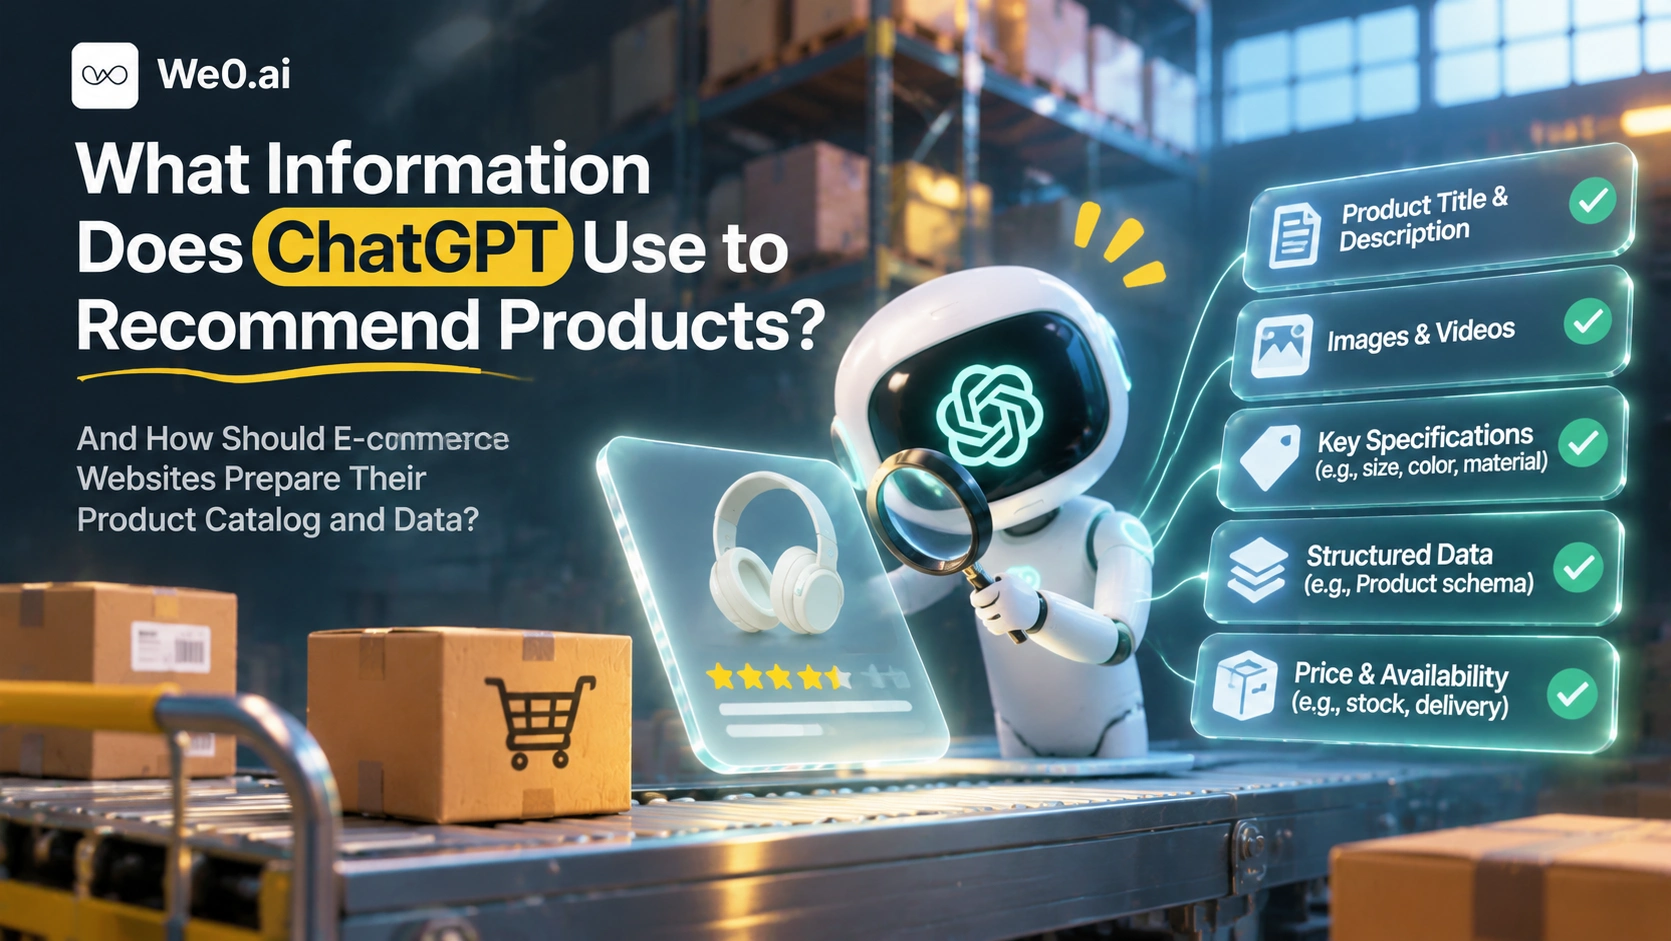
Respuesta directa a la pregunta del título: cuando ChatGPT recomienda productos, lee principalmente dos tipos de entradas.
La primera es el feed estructurado de producto que envía activamente el comerciante. Según la especificación del feed de producto de OpenAI, el feed es la única fuente de verdad de los datos de producto, cubre título, precio, stock, material multimedia e información logística, y sirve para sustentar la búsqueda de productos, el descubrimiento de productos y, cuando se cumplen las condiciones, el pago inmediato; estos datos no se obtienen mediante rastreo, sino que el comerciante envía archivos estructurados a un endpoint seguro y los actualiza con alta frecuencia para garantizar su exactitud (Especificación del feed de producto de ChatGPT).
La segunda es la información de la página de producto que puede analizar en la web pública: nombre del producto, precio actual, especificaciones, escenarios de uso, políticas de envío y devolución. Las guías de compra que obtienen los usuarios en escenarios de investigación de compras suelen incluir recomendaciones de productos populares, comparación de diferencias clave, análisis de ventajas y desventajas y enlaces a minoristas (Reportaje sobre la función de investigación de compras de ChatGPT).
Por lo tanto, lo que realmente determina el resultado son dos capas: el feed determina si tu producto puede entrar en el grupo de candidatos, y la página de producto determina si lo que se dice es correcto cuando te citan. Cuando ambos no coinciden, es la fuente más habitual de problemas.
Las tres vías por las que ChatGPT obtiene información de producto
- Investigación de compras: investigación conversacional orientada a la decisión de compra, que primero pregunta por presupuesto, usuario y funciones de interés, y después ofrece comparativas y recomendaciones; en los resultados se incluyen enlaces clicables a minoristas.
- Feed de producto: el comerciante estructura su catálogo y lo envía, formando entradas de producto que se pueden buscar, comparar y recomendar; la completitud de los campos determina directamente si el producto puede ser filtrado.
- Anuncios en feeds de producto: el 12 de mayo de 2026, OpenAI lanzó en ChatGPT el formato publicitario product feed ads, en el que el comerciante conecta su catálogo, define condiciones de filtrado y el sistema genera automáticamente anuncios con nombre, imagen, precio y atributos del producto; según los reportes, un solo anunciante puede cubrir hasta 1 millón de SKU, los nuevos socios de ecommerce deben enviar primero 100 muestras de productos, y el archivo de feed utilizado es básicamente el mismo archivo estructurado que se envía a Google Shopping (Reportaje sobre el lanzamiento de product feed ads).
El punto en común de las tres vías es claro: las entradas son campos estructurados, son sensibles a la exactitud de los datos y no dependen de la densidad de palabras clave.
Qué es un feed de producto
Un feed es un archivo de listado de productos legible por máquina: una línea por producto o variante, campos fijos, formato fijo y actualización periódica. Es algo distinto de «hacer que la página de producto se vea bien». La página de producto sirve a la lectura y conversión de las personas; el feed sirve al emparejamiento y la comparación entre máquinas.
Hay un detalle fácil de pasar por alto en la especificación: el feed se define como la única fuente de verdad de los datos de producto. Esto significa que el título, el precio y el stock de un mismo producto en el feed deben coincidir con lo que muestra la página de destino; de lo contrario, la plataforma y los usuarios verán dos conjuntos de hechos.
Una tabla para ver qué campos hay que preparar

| Campo | Contenido recomendado | Por qué es importante | Problemas habituales |
|---|---|---|---|
| Nombre del producto | Marca + serie + modelo + atributos principales | Es la primera señal para emparejar la intención de la conversación | Acumular palabras clave, falta de modelo, nombres inconsistentes para el mismo producto |
| Descripción | Funciones principales, escenarios de uso, público objetivo | Determina si se considera «adecuado para esta necesidad» | Copiar el mismo texto en todo el sitio |
| Precio | Precio de venta actual y moneda | Se usa para comparar precios y filtrar | Ofertas no sincronizadas, criterio de impuestos poco claro |
| Disponibilidad | En stock / preventa / agotado | Afecta a si se recomienda y a si se puede comprar | Permanecer durante mucho tiempo en «disponible» |
| Variantes | Color, tamaño, capacidad, modelo | Determina si cada variante puede emparejarse por separado | Mezclar producto padre y SKU hijo |
| Especificaciones | Parámetros técnicos en formato clave-valor | Sustenta preguntas de comparación de parámetros | Descripciones en frases largas, unidades inconsistentes |
| Políticas | Condiciones de devolución, envío y garantía | Afecta a la confianza y a la decisión final | Políticas inconsistentes entre página y feed |
| Imágenes | Imagen principal, imágenes desde varios ángulos, imágenes de contexto | Afecta a la visualización y al clic | Imagen principal con texto promocional |
Nombre, precio y stock deben coincidir
Con el caso de una tienda de electrónica. El mismo modelo «AuraSound NC-700, auriculares inalámbricos con cancelación de ruido» aparece en tres lugares: en el sitio oficial tiene un precio de 1299 yuanes y se muestra disponible, en el feed de producto sigue a 1499 yuanes y marcado como agotado, y en una plataforma de terceros aparece a 1199 yuanes. Cuando un usuario pregunta por «auriculares con cancelación de ruido por menos de 1500 yuanes», el sistema puede omitirlo porque el precio del feed supera el presupuesto, o puede recomendarlo porque leyó 1299 yuanes en la página oficial y luego mostrar otra información al llegar a la página de destino.
Hay tres formas de resolverlo: concentrar precio y stock en una única fuente maestra de datos; añadir a precio y stock una marca de tiempo de actualización y decidir qué dato es válido según la marca temporal; y ejecutar una validación de coherencia entre canales antes del lanzamiento, comparando uno a uno los cuatro tipos de campos: nombre, precio, stock y enlace.
Cómo organizar variantes y especificaciones
Primero hay que definir claramente qué es «un producto» y después hablar de datos. Para productos con múltiples especificaciones se recomienda una estructura padre-hijo: el producto padre representa el estilo o la serie, el SKU hijo representa el color, la capacidad o el modelo concretos, y el precio y el stock se asignan al SKU hijo. Los nombres de atributos y las unidades deben ser uniformes; por ejemplo, la autonomía de la batería debe expresarse siempre en «horas» y el peso siempre en «gramos», evitando que un mismo parámetro aparezca mezclado como «aprox. 30 h», «alrededor de 30 horas» o «1,2 kg/1200 g» en distintos productos. Las especificaciones deben usar pares clave-valor, no meterse en una frase larga.
Función de las imágenes y la descripción del producto

Las tres primeras líneas de la descripción deben responder qué es, para quién es y qué problema resuelve; después se desarrollan los detalles. La forma realmente eficaz de escribirlo es dejar claros los escenarios de uso, el público y las limitaciones; por ejemplo: «Adecuado para desplazamientos y vuelos largos; la cancelación activa de ruido es claramente eficaz contra el ruido de baja frecuencia; no es adecuado para escenarios de ciclismo en los que se necesita percibir el sonido ambiente». Acumular palabras clave apenas aporta beneficios en el emparejamiento de modelos grandes y, además, reduce la legibilidad. En cuanto a las imágenes, la principal debe mantenerse limpia y sin texto promocional; las imágenes desde varios ángulos y las imágenes de contexto con referencias de escala ayudan a juzgar tamaño y forma.
¿Conviene usar datos estructurados en la página de producto?
Sí, pero no basta con eso. La página de producto debe emitir Product y Offer de schema.org y, cuando sea necesario, complementar con valoraciones y anotaciones de preguntas frecuentes, asegurando que el precio y el stock de la página correspondan exactamente con el feed. También hay que confirmar que esta información se puede obtener en el HTML inicial y no solo aparece después de que el frontend la renderice con scripts; cada producto debe tener una URL independiente, estable y accesible a largo plazo, y las variantes deben distinguirse con enlaces canónicos en lugar de apuntar todas a la misma dirección.
Crea un sitio de presentacion y capta leads en minutos
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Cómo hacer que la IA entienda con más precisión las diferencias entre productos
Los productos similares son los que más fácilmente se confunden. La forma de evitarlo es convertir las diferencias en escalas comparables y atributos booleanos: situar tres auriculares en el mismo conjunto de dimensiones de parámetros (profundidad de cancelación de ruido, autonomía, peso, versión de Bluetooth, compatibilidad con conexión multipunto) y añadir a cada uno una frase sobre «para quién no es adecuado». En productos de distintas generaciones hay que indicar explícitamente la diferencia con la generación anterior; por ejemplo: «En comparación con el NC-600, el NC-700 aumenta la autonomía y reduce el peso». Para modelos con el mismo nombre pero distinta configuración, hay que incluir siempre un identificador de distinción en el título y no permitir que dos SKU diferentes compartan el mismo nombre.
Cómo sincronizar los cambios de precio y stock
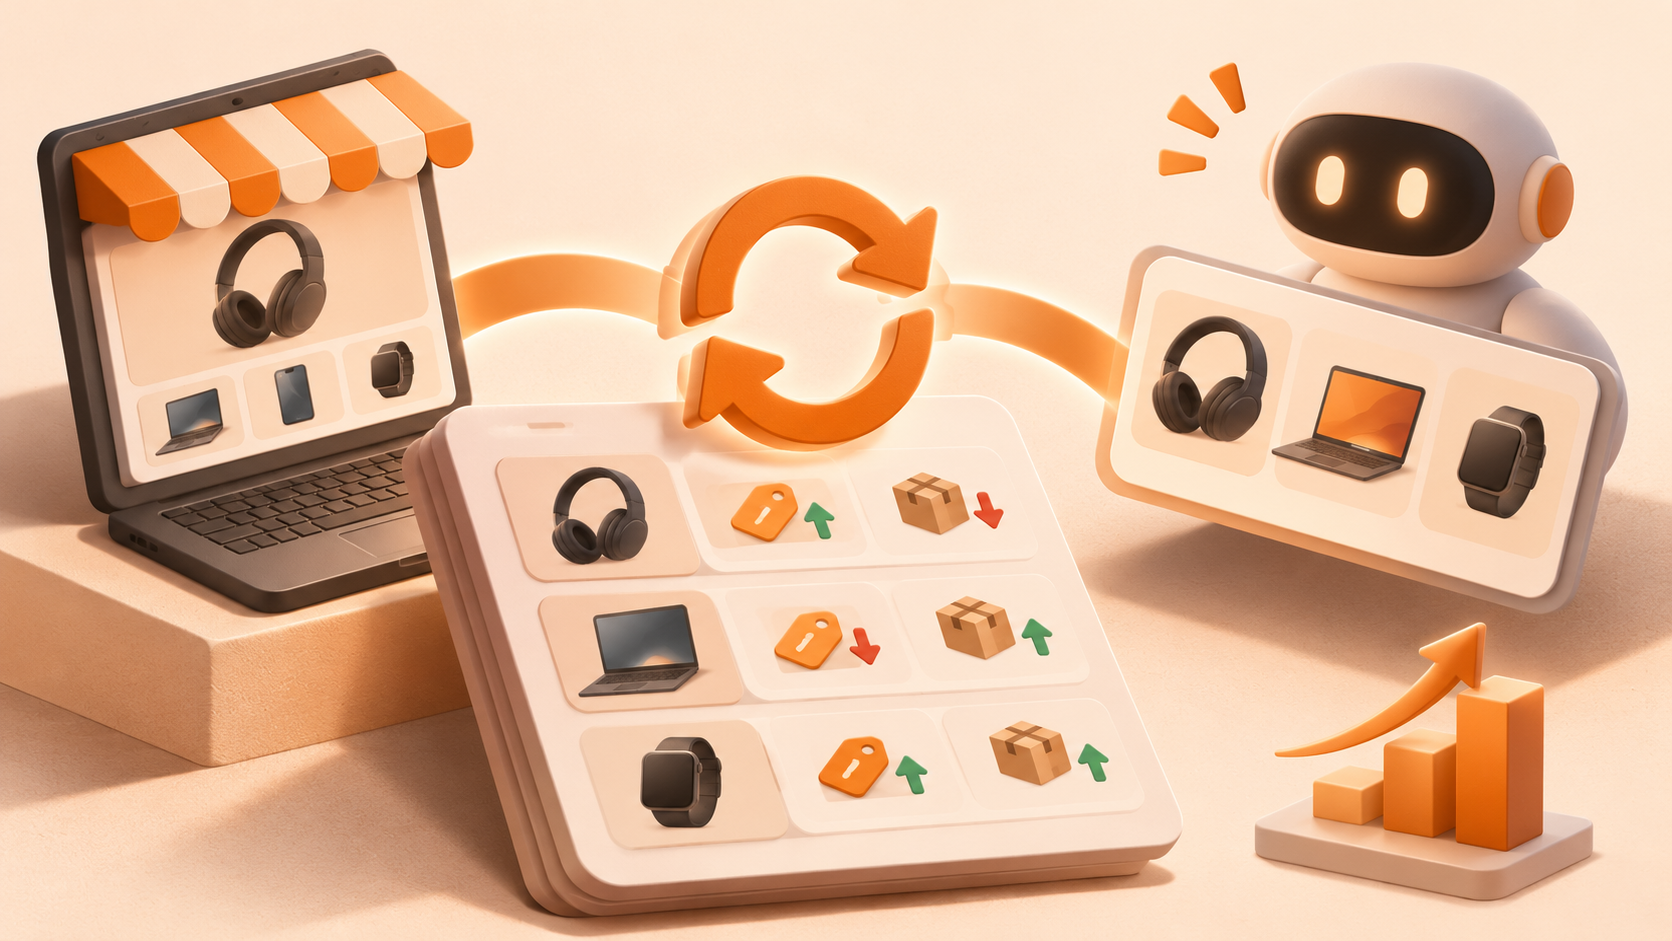
La sincronización debe basarse en el flujo de datos, no en cambios manuales. Primero, los cambios de precio y stock deben escribirse siempre en el maestro de datos de producto desde el backend, y no se debe modificar directamente el archivo exportado. Segundo, el feed de producto externo y la visualización de la página deben generarse a partir del maestro de datos, ambos desde la misma escritura. Tercero, hay que distinguir la frecuencia de actualización: precio y stock se actualizan con alta frecuencia; descripción y especificaciones, con baja frecuencia, para evitar temblores causados por reenvíos completos. Cuarto, hay que conservar registros de cambios y capacidad de reversión, de modo que ante una anomalía se pueda volver a la última versión estable. Quinto, hay que establecer métricas de monitorización, como la tasa de campos faltantes, el número de diferencias de precio entre canales y el tiempo transcurrido desde la última actualización.
Crear una fuente única de datos de producto: implementación en cinco pasos
- Inventario: enumerar en qué lugares existen actualmente los datos de producto (backend del sitio oficial, ERP, hojas de cálculo, centros de vendedores de cada plataforma) e indicar cuál es el correcto.
- Modelado: definir un diccionario de campos, especificando campos obligatorios, tipos, unidades y enumeraciones de valores.
- Convergencia de escritura: conservar una sola entrada de escritura; los demás sistemas obtienen los datos mediante interfaces, en lugar de mantener cada uno su propia copia.
- Exportación multicanal: usar el mismo maestro de datos para generar la visualización de la página de producto, el archivo de feed y los datos para plataformas de terceros, manteniendo centralizado el mapeo de campos.
- Validación y monitorización: comparar antes del lanzamiento y monitorizar después; tratar las inconsistencias como defectos, no como algo que operaciones corrige de forma temporal.
La lista de decisiones que la acompaña puede definirse así: si se permite que operaciones cambie precios directamente, hasta qué nivel se dividen las variantes, si los productos agotados se mantienen en el feed, quién mantiene las condiciones de las políticas y cuál es el plan de reversión si falla el envío del feed.
Qué deberían hacer las empresas ahora
- Primero corregir los datos y después hablar de canales. Mejorar la completitud de títulos, categorías, imágenes, precios y stock de producto es el requisito previo para cualquier escenario de recomendación automática.
- Tratar los datos de producto como entradas que leen las máquinas, no como un conjunto de palabras clave para el motor de búsqueda: escenarios, público y etiquetas de atributos son más útiles que acumular sinónimos.
- Establecer métricas de las fuentes de referencia y observar por separado el rendimiento de las visitas procedentes de entradas conversacionales en tasa de conversión y valor medio del pedido antes de decidir la inversión.
- Hacer que la página de producto y el feed compartan el mismo maestro de datos, convirtiendo la coherencia en una restricción del proceso.
La tienda independiente de ecommerce de We0 mantiene productos, categorías, especificaciones y stock en un mismo backend; el panel CMS permite actualizar de forma continua el contenido de producto; la generación de código full-stack puede personalizar las interfaces de datos de producto y la lógica de sincronización según necesidad; y la optimización SEO y GEO sirve para ordenar la estructura de información y los párrafos citables de la página de producto (Tienda independiente de ecommerce de We0). Cabe señalar que la conexión directa con el feed de producto de OpenAI implica requisitos de cualificación, endpoints y mapeo de campos, y todavía requiere validación y desarrollo independientes; no debe considerarse una capacidad ya integrada.
Preguntas frecuentes
¿ChatGPT rastrea de forma activa mi sitio de ecommerce?
En la vía del feed de producto, es el comerciante quien envía activamente archivos estructurados; no se basa en rastreo (especificación). La información de producto de las páginas web públicas sí puede ser recuperada y citada, así que la página de producto sigue necesitando describir los hechos con claridad.
¿El nombre, el precio y el stock del producto deben coincidir exactamente con el feed?
Sí. El feed se define como la única fuente de verdad de los datos de producto; si el precio, el stock y la página de destino no coinciden, se afecta directamente la recomendación y la experiencia de compra.
¿En qué formato deberían organizarse las especificaciones del producto?
Con parámetros técnicos en pares clave-valor, nombres de atributos y unidades uniformes; no hay que meter los parámetros en párrafos largos ni inventar un conjunto de campos distinto para cada color.
¿Basta con implementar datos estructurados?
No. Los datos estructurados ayudan a que la máquina analice correctamente la página de producto, pero que el producto pueda entrar en el grupo de candidatos también depende de que se haya enviado un feed de producto completo; ambos deben compartir el mismo maestro de datos.
¿Cómo se sincroniza un cambio de precio?
Escribiendo en el maestro de datos de producto desde el backend, generando al mismo tiempo desde el maestro la visualización de la página y el archivo de feed, y conservando marcas de tiempo de actualización, registros de cambios y un plan de reversión para evitar modificar manualmente los archivos exportados.
Herramientas relacionadas
- Backend de tienda independiente de ecommerce: mantenimiento unificado de productos, categorías, variantes y stock
- Panel CMS: actualización continua de descripciones de producto, políticas y páginas de contenido
- Generación de código full-stack: interfaces de datos de producto y lógica de sincronización personalizadas
- Optimización SEO y GEO: ordenar la estructura de información y los párrafos citables de la página de producto
- Validación de datos estructurados: comprobar que las anotaciones Product y Offer coinciden con la página
Enlaces relacionados
- Especificación del feed de producto de ChatGPT (Lengow)
- Reportaje sobre la función de investigación de compras de ChatGPT (software de China.com)
- Reportaje sobre el lanzamiento del formato product feed ads de OpenAI (Stellagent)
- Tienda independiente de ecommerce de We0
Resumen
Cuando ChatGPT recomienda productos, lee hechos estructurados de producto: el feed de producto que envía el comerciante determina si el producto puede entrar en el grupo de candidatos, y la información analizable de la página pública del producto determina si es precisa cuando se cita. Lo que deben hacer las tiendas online no es optimizar la densidad de palabras clave, sino concentrar nombre, precio, stock, variantes, especificaciones, imágenes y políticas en un único maestro de datos, generar de forma sincronizada la visualización de la página y el feed, y usar validación y monitorización para garantizar la coherencia entre canales. La conexión directa con feeds y la integración publicitaria son tareas independientes que deben validarse por separado según los requisitos de cada plataforma.