For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/claude-haiku-5-pricing-benchmarks-gpt-6-l-8951f544.md.
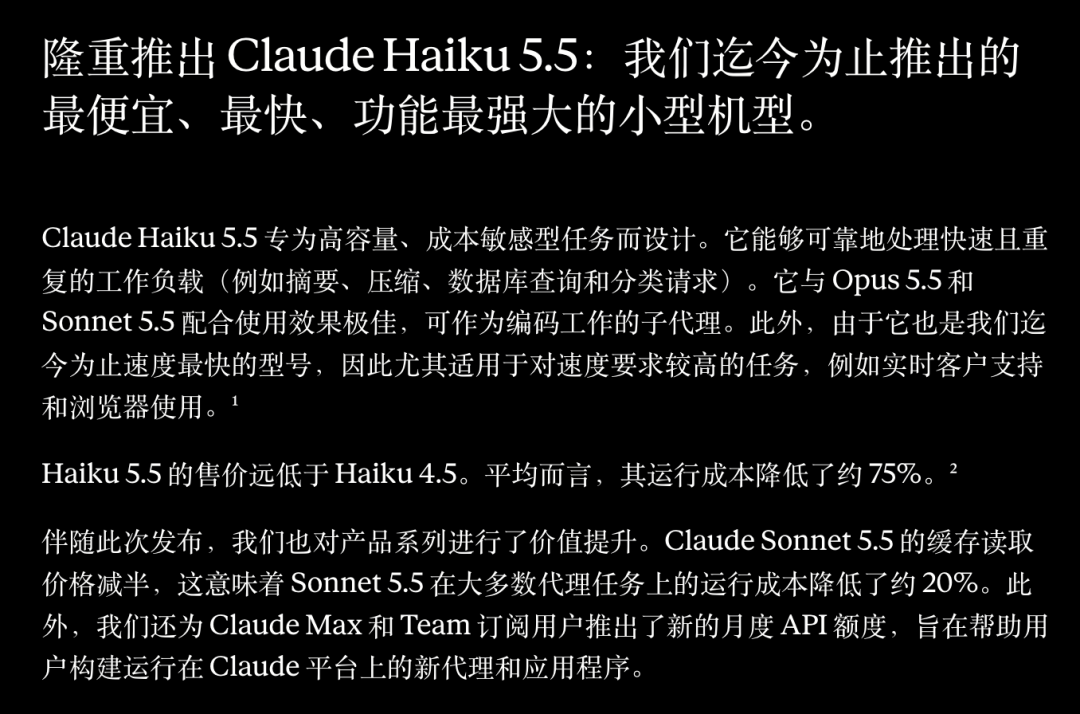
Anthropic ha lanzado **Claude Haiku 5.5**, su modelo pequeño más rápido y de menor coste hasta la fecha.

Anthropic ha lanzado Claude Haiku 5.5, su modelo pequeño más rápido y de menor coste hasta la fecha.
El modelo se lanzó oficialmente el 7 de octubre de 2026 y está diseñado para trabajos en los que la velocidad, el volumen y el coste importan más que utilizar el modelo más potente posible en cada solicitud.
Anthropic posiciona Haiku 5.5 para tareas como:
La cifra que más llama la atención es su precio para prompts cortos:
Entrada:
$0.10 / 1 millón de tokens

Salida:
$0.50 / 1 millón de tokens
para prompts de hasta 100.000 tokens.
Eso equivale a una décima parte del precio indicado para la entrada y la salida de Haiku 4.5, y a una vigésima parte del precio estándar de entrada y salida de Sonnet 5.5.
La reducción del precio no significa que todos los flujos de trabajo reales sean un 90 % más baratos.
La estimación de Anthropic es más prudente: después de tener en cuenta los precios para contextos largos y el nuevo tokenizador, afirma que ejecutar Haiku 5.5 cuesta alrededor de un 75 % menos de media que ejecutar Haiku 4.5.
La parte más sorprendente es que el modelo no solo es más barato.
En varias evaluaciones publicadas por Anthropic, Haiku 5.5 supera ampliamente a Haiku 4.5 e incluso supera al GPT-6 Luna de OpenAI, de precio similar, en todos los benchmarks en los que Anthropic publicó un resultado de Luna.
Esto no convierte a Haiku 5.5 en un reemplazo de Sonnet 5.5 u Opus 5.5 para tareas difíciles de programación y trabajos abiertos con agentes.
Anthropic recomienda explícitamente sus modelos más grandes para esas tareas.
La mejor forma de entender Haiku 5.5 es como un trabajador de alto volumen que por fin tiene la capacidad suficiente para asumir tareas de agentes mucho más serias que los modelos Haiku anteriores.
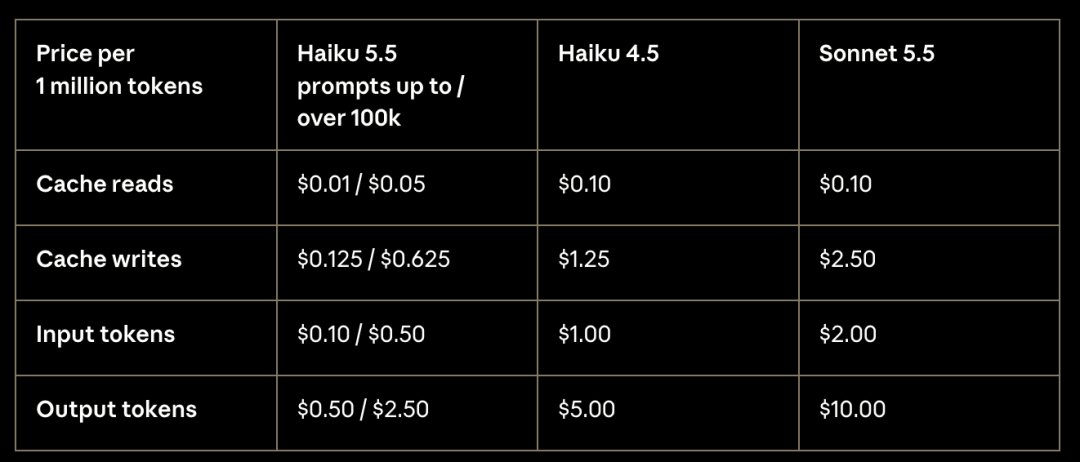
La estructura de precios tiene dos niveles.
Para prompts de hasta 100.000 tokens de entrada:
| Tipo de token | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| Lectura de caché | $0.01 / 1 millón | $0.10 / 1 millón | $0.10 / 1 millón |
| Escritura en caché | $0.125 / 1 millón | $1.25 / 1 millón | $2.50 / 1 millón |
| Entrada | $0.10 / 1 millón | $1.00 / 1 millón | $2.00 / 1 millón |
| Salida | $0.50 / 1 millón | $5.00 / 1 millón | $10.00 / 1 millón |
Para prompts de más de 100.000 tokens de entrada, Haiku 5.5 cambia a:
Lectura de caché:
$0.05 / 1 millón

Escritura en caché:
$0.625 / 1 millón

Entrada:
$0.50 / 1 millón

Salida:
$2.50 / 1 millón
El procesamiento por lotes aplica un descuento del 50 % a los tokens de entrada y salida.
Anthropic también afirma que alrededor del 90 % de las solicitudes al modelo Haiku anterior estaban por debajo del umbral de 100.000 tokens del prompt, por lo que el nivel inferior es tan importante para las implementaciones habituales de alto volumen.
Las tarifas anunciadas para prompts cortos son un 90 % inferiores a las de Haiku 4.5.
Sin embargo, Anthropic estima que la reducción media real es de aproximadamente un 75 %.
Hay dos motivos principales.
Cuando un prompt supera los 100.000 tokens de entrada, las tarifas de Haiku 5.5 se multiplican por cinco.
El modelo sigue siendo más barato que Haiku 4.5 en ese punto, pero la reducción es del 50 % en lugar del 90 %.
Haiku 5.5 utiliza el nuevo tokenizador empleado por Claude 4.7 y los modelos posteriores.
La guía de migración de Anthropic indica que el mismo texto de entrada produce aproximadamente:
30 % más de tokens
en Haiku 5.5 que en Haiku 4.5.
El aumento exacto depende del contenido.
Esto afecta a:
max_tokensPor tanto, los desarrolladores no deberían tomar el recuento de tokens de Haiku 4.5 y multiplicarlo simplemente por el nuevo precio por token de Haiku 5.5.
Es necesario volver a contar el texto con el nuevo modelo.
Para las solicitudes estándar con contexto corto, los dos modelos son directamente comparables por precio de token.
OpenAI indica actualmente para GPT-6 Luna:
Entrada:
$0.10 / 1 millón

Entrada en caché:
$0.01 / 1 millón

Escrituras en caché:
$0.125 / 1 millón

Salida:
$0.50 / 1 millón
Estas tarifas coinciden con las de Haiku 5.5 para prompts cortos.
Sin embargo, los umbrales de precios para contextos largos son muy diferentes.
El nivel superior comienza cuando el prompt supera:
100.000 tokens de entrada
Después, las tarifas cambian a:
Entrada:
$0.50 / 1 millón

Lectura de caché:
$0.05 / 1 millón

Salida:
$2.50 / 1 millón
Los precios de contexto largo de OpenAI comienzan por encima de:
272.000 tokens de entrada
y después cambian a:
Entrada:
$0.20 / 1 millón

Entrada en caché:
$0.02 / 1 millón

Salida:
$0.75 / 1 millón
Por tanto, el artículo de origen tiene razón al distinguir entre contextos cortos y largos.
Para prompts de menos de 100.000 tokens, los precios estándar están muy alineados.
Para prompts muy largos, Luna tiene actualmente una tarifa de contexto largo considerablemente menor y no activa ese nivel hasta alcanzar un prompt mucho más grande.
Esto puede cambiar de forma material las decisiones de enrutamiento del modelo para documentos extensos o historiales grandes de agentes.
Anthropic aprovechó el lanzamiento de Haiku 5.5 para reducir otro coste importante.
Las lecturas de caché de Claude Sonnet 5.5 bajaron de:
$0.20 / 1 millón de tokens
a:
$0.10 / 1 millón de tokens
Anthropic estima que esto reduce el coste de Sonnet 5.5 aproximadamente un 20 % en la mayoría de los flujos de trabajo con agentes, porque las lecturas de caché pueden representar una parte importante de los tokens en agentes de larga duración.
Esto hace que la familia de modelos tenga una segmentación más clara:
Haiku 5.5
→ trabajo más barato, rápido y de mayor volumen

Sonnet 5.5
→ trabajo sólido y bien delimitado, además de programación

Opus 5.5
→ trabajo abierto más difícil y agentes complejos
La tabla de benchmarks es donde la mejora generacional resulta más evidente.
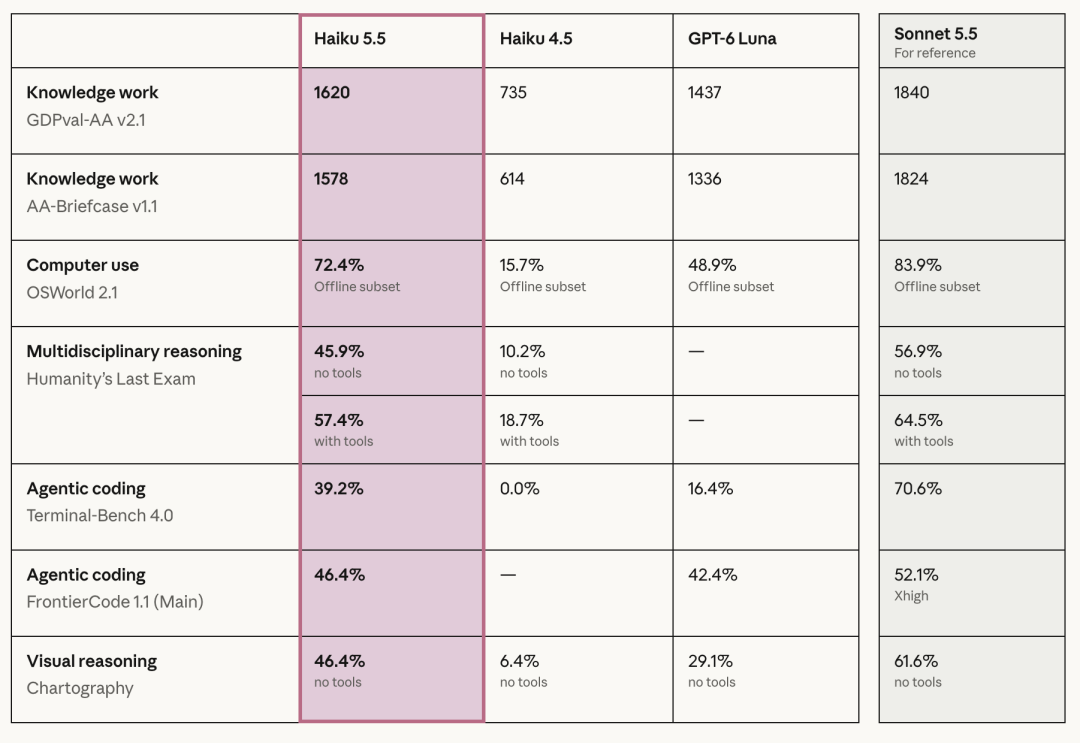
Anthropic informa de los siguientes resultados:
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 sin conexión | 72.4 % | 15.7 % | 48.9 % | 83.9 % |
| HLE, sin herramientas | 45.9 % | 10.2 % | — | 56.9 % |
| HLE, con herramientas | 57.4 % | 18.7 % | — | 64.5 % |
| Terminal-Bench 4.0 | 39.2 % | 0.0 % | 16.4 % | 70.6 % |
| FrontierCode 1.1 Main | 46.4 % | — | 42.4 % | 52.1 % Xhigh |
| Chartography | 46.4 % | 6.4 % | 29.1 % | 61.6 % |
En la tabla publicada por Anthropic, Haiku 5.5 supera a GPT-6 Luna en todas las filas en las que se incluye una puntuación de Luna.
Es un resultado destacable, dado que los dos modelos comparten los mismos precios de entrada y salida para contextos cortos.
Aun así, estas son comparaciones de benchmarks publicadas por Anthropic.
No deberían convertirse en una afirmación universal de que Haiku 5.5 es mejor que Luna para cualquier carga de trabajo.
Los resultados en producción dependen de:
La mejora más fuerte entre generaciones aparece en OSWorld 2.1, una evaluación de agentes que utilizan ordenadores.
Haiku 4.5 obtuvo:
15.7 %
Haiku 5.5 alcanza:
72.4 %
Sonnet 5.5 sigue por encima, con:
83.9 %
mientras que GPT-6 Luna figura con:
48.9 %
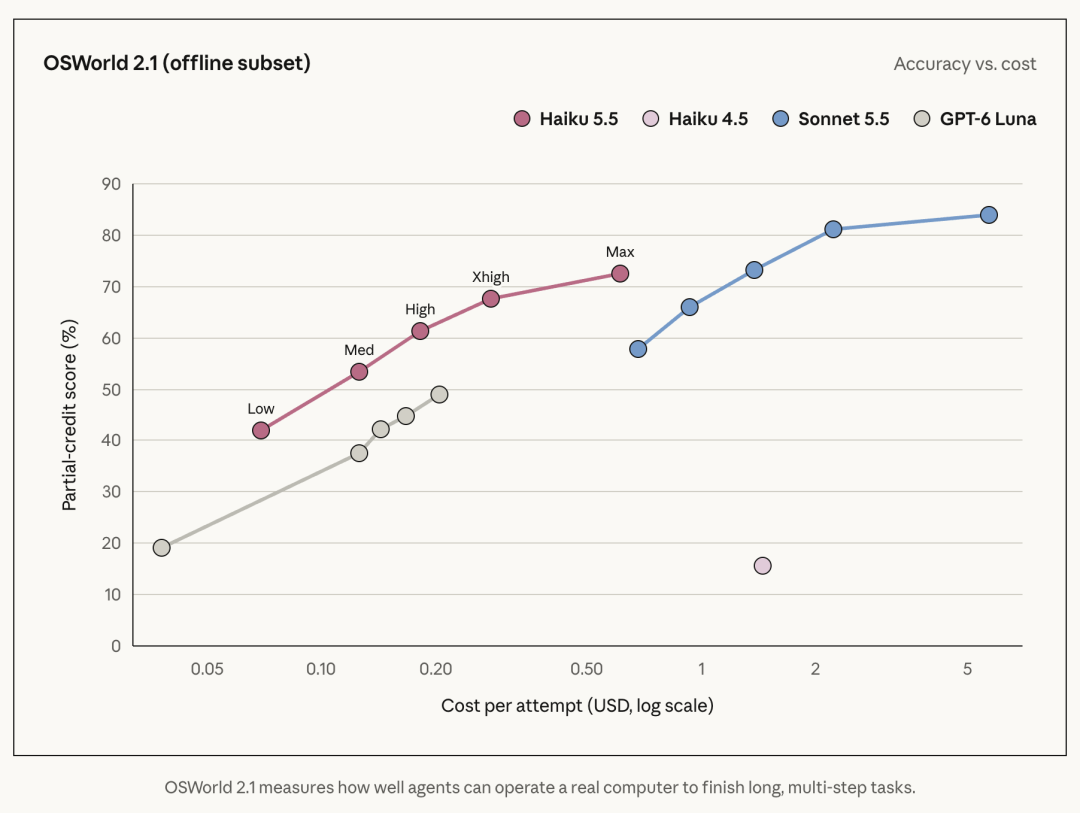
La curva de rendimiento frente al coste es especialmente interesante.
El gráfico de Anthropic muestra que una configuración de Haiku con esfuerzo medio ya puede superar el mejor punto de Luna mostrado en esa evaluación, con un coste medido por intento inferior.
Esto no hace que ambos modelos sean idénticos en capacidades o precios.
Sí demuestra por qué Anthropic está posicionando Haiku 5.5 para el uso del navegador y otras tareas de agentes sensibles a la latencia.
En GDPval-AA v2.1, Haiku 5.5 alcanza:
1620 Elo
frente a:
Haiku 4.5:
735

GPT-6 Luna:
1437

Sonnet 5.5:
1840
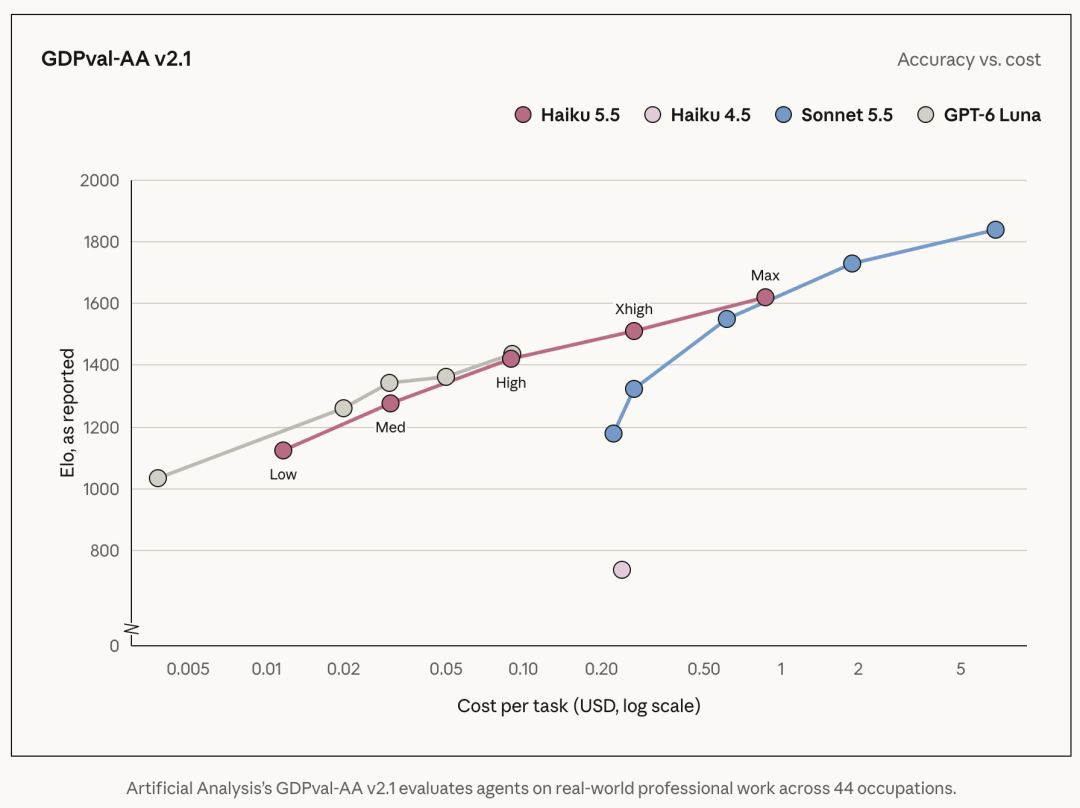
Con el nivel de esfuerzo medio predeterminado, la puntuación es inferior al resultado máximo de Haiku, pero el coste también disminuye considerablemente.
Esta flexibilidad es nueva para la familia Haiku.
Claude Haiku 5.5 es el primer modelo de la clase Haiku con un nivel de esfuerzo ajustable.
Los niveles disponibles son:
low
medium
high
xhigh
max
La API de Claude utiliza de forma predeterminada:
medium
Esto permite a los desarrolladores intercambiar profundidad de razonamiento por coste y latencia.
Para una tarea de enrutamiento o clasificación, low puede ser suficiente.
Para una tarea de extracción o de agentes más difícil, un nivel de esfuerzo superior puede dedicar más capacidad de cómputo.
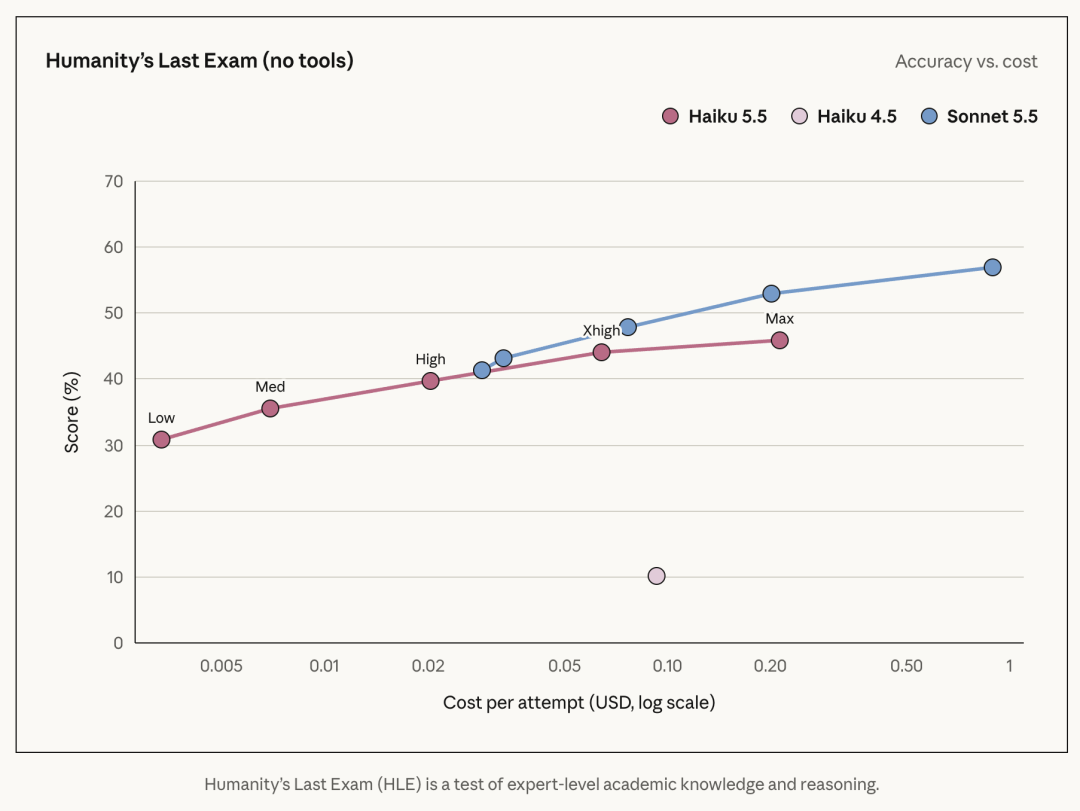
Esto también explica por qué una única cifra de benchmark no siempre cuenta toda la historia.
La puntuación de Haiku 5.5 depende del nivel de esfuerzo seleccionado para la tarea.
El artículo de origen es cuidadoso en este punto, y los datos oficiales lo respaldan.
En Terminal-Bench 4.0:
Haiku 5.5:
39.2 %

GPT-6 Luna:
16.4 %

Sonnet 5.5:
70.6 %
En FrontierCode 1.1 Main:
Haiku 5.5:
46.4 %

GPT-6 Luna:
42.4 %

Sonnet 5.5:
52.1 % con Xhigh
La mejora de Haiku es sustancial, especialmente en comparación con el resultado del 0.0 % de Haiku 4.5 mostrado en Terminal-Bench.
Sin embargo, Anthropic afirma explícitamente que Sonnet 5.5 y Opus 5.5 siguen siendo mejores opciones para la programación compleja con agentes.
Esto da a Haiku un papel más claro:
Haiku:
ejecución de subtareas concretas

Sonnet:
programación compleja y bien delimitada

Opus:
planificación más difícil y trabajo abierto con agentes
Anthropic recomienda Haiku 5.5 para trabajos como:
Anthropic lo denomina el modelo Claude más rápido a velocidad estándar.
Solo funciona más lentamente que Opus cuando Opus se coloca en el modo rápido, con un precio independiente.
Esto hace que Haiku 5.5 sea útil allí donde la latencia tiene un valor directo para el producto.
Anthropic publicó varias evaluaciones de clientes junto con el lanzamiento.
Son pruebas comunicadas por clientes, no garantías universales de rendimiento.
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
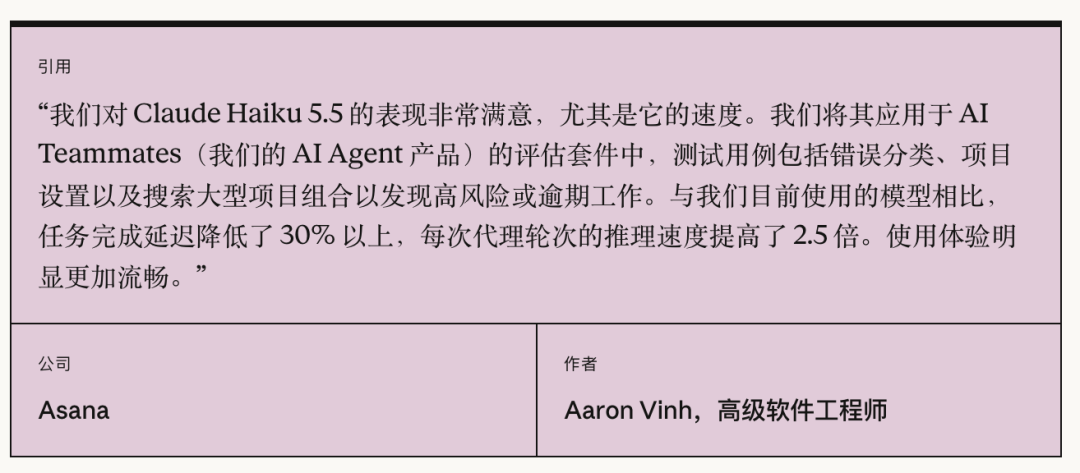
Asana evaluó Haiku 5.5 en su conjunto de pruebas AI Teammates.
Sus tareas incluían:
Asana informó de una reducción superior al 30 % en la latencia de finalización de tareas y de una inferencia de hasta 2,5 veces más rápida por turno del agente frente al modelo que utilizaba.
Box informó de que Haiku 5.5 obtuvo 11 puntos más que Haiku 4.5 en las primeras pruebas, con aproximadamente la mitad de latencia.
La empresa destacó cargas de trabajo analíticas como:
AlphaSense probó 400 consultas de preguntas sobre documentos.
Comunicó una puntuación de evaluación de:
Haiku 5.5:
0.84

Haiku 4.5:
0.76
La relevancia está en la escala.
AlphaSense afirma que este tipo de carga de trabajo de «Preguntar en el documento» gestiona alrededor de 8 millones de llamadas semanales en producción, por lo que pequeños cambios en coste y latencia son importantes desde el punto de vista operativo.
Uno de los casos de uso más claros no consiste en reemplazar a un modelo más grande, sino en trabajar por debajo de él.
Un modelo más grande puede:
comprender la tarea general
→ dividirla en subproblemas
→ asignar trabajos concretos
Después, Haiku 5.5 puede ejecutar esos trabajos en paralelo.
Este patrón permite que el sistema utilice la capacidad costosa del modelo solo donde sea necesaria.
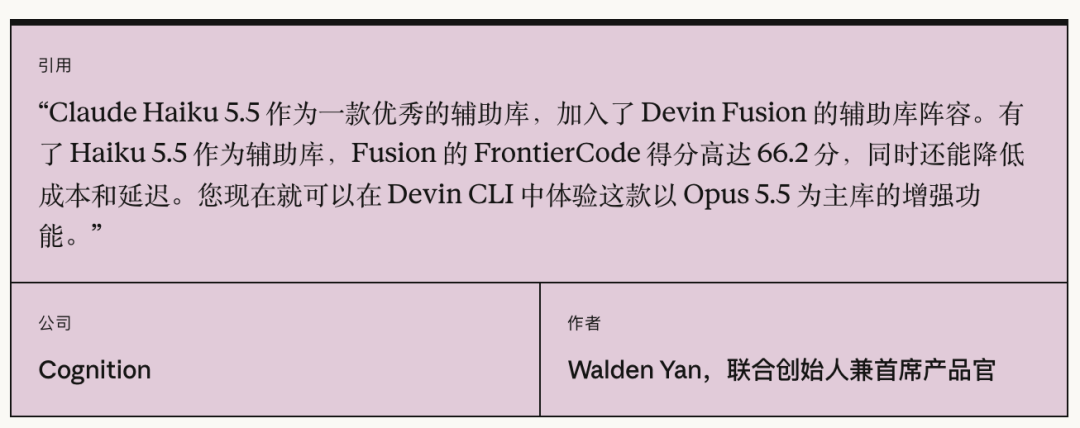
Cognition afirma que Haiku 5.5 ya está disponible como modelo asistente dentro de Devin Fusion.
Con Opus 5.5 como modelo líder y Haiku 5.5 como asistente, Cognition informa de una puntuación de 66.2 en FrontierCode, al tiempo que reduce el coste y la latencia.
Este es un buen ejemplo de enrutamiento jerárquico de modelos:
Opus 5.5
→ planificación
→ decisiones difíciles
→ integración

Haiku 5.5
→ subtareas en paralelo
→ recuperación de información
→ implementación delimitada
→ trabajo repetitivo
El resultado no consiste simplemente en «utilizar un modelo más barato».
Consiste en «utilizar el modelo caro solo para el trabajo que lo necesita».
La empresa de inteligencia financiera Rogo describe un patrón similar.
Un modelo más grande puede crear una presentación mientras un subagente Haiku 5.5 busca en un informe 10-K y extrae la cifra de ingresos por segmento necesaria para una diapositiva.
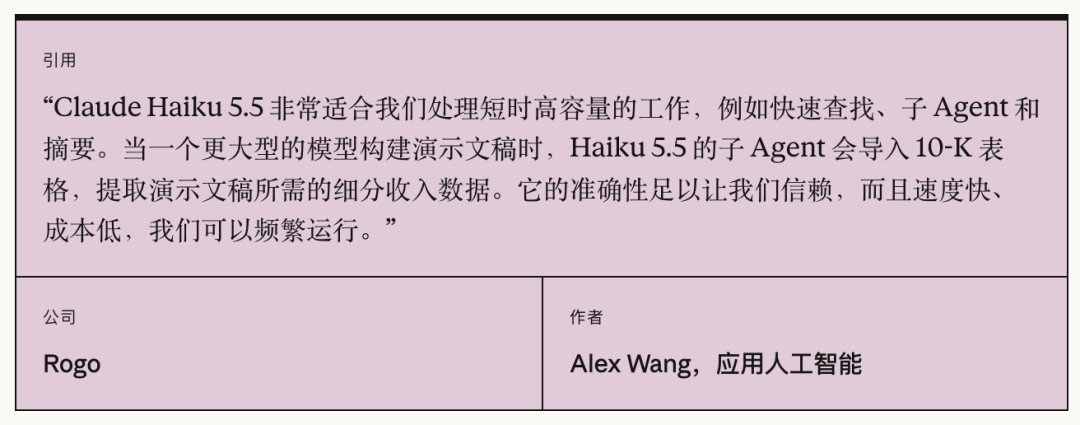
Este es exactamente el tipo de trabajo concreto y repetible para el que está diseñado Haiku:
pregunta específica
+
fuente conocida
+
alto volumen
+
requisito de baja latencia
El artículo de origen incluye una demostración de desarrolladores de Anthropic sobre una tarea de diseño para dejar caer un huevo.
Según el artículo, Opus 5.5 trabajando solo:
tardó 3 minutos y 37 segundos
probó 25 diseños
costó $0.47
Cuando Opus utilizó diez subagentes Haiku 5.5, el artículo informa de:
58 segundos
86 diseños probados
$0.14 de coste total
La imagen original de BAAI correspondiente a este resultado no se cargó de forma fiable durante la preparación, por lo que no se reproduce aquí.
Este ejemplo debe considerarse una demostración de Anthropic sobre una arquitectura concreta de agentes, no una garantía general de una mejora de cuatro veces en velocidad o coste.
Su propósito es ilustrar el paralelismo.
Cuando una tarea se puede descomponer claramente, muchos agentes pequeños y rápidos pueden explorar más posibilidades de forma simultánea que un único modelo costoso trabajando secuencialmente.
La documentación actual de modelos de Anthropic indica:
| Especificación | Claude Haiku 5.5 |
|---|---|
| ID del modelo | claude-haiku-5-5 |
| Ventana de contexto | 1.000.000 de tokens |
| Salida máxima | 128.000 tokens |
| Salida máxima de la API por lotes, beta | 300.000 tokens |
| Entrada | Texto, imágenes |
| Salida | Texto |
| Razonamiento | Adaptativo |
| Esfuerzo predeterminado | medium |
| Fecha de corte de conocimiento fiable | Junio de 2026 |
| Fecha de lanzamiento | 7 de octubre de 2026 |
La ventana de contexto de 1 millón de tokens es la configuración predeterminada.
No se requiere ningún encabezado beta especial para utilizar la ventana de contexto completa.
Esta es una de las secciones prácticas más importantes del artículo de origen.
La guía oficial de migración de Anthropic confirma varias diferencias que modifican el comportamiento o pueden romper integraciones existentes.
Para la API de Claude:
claude-haiku-4-5
→
claude-haiku-5-5
El ID de Haiku 5.5 es fijo y no utiliza un sufijo de fecha.
El mismo texto contiene aproximadamente un 30 % más de tokens con el nuevo tokenizador.
Los desarrolladores deberían volver a calcular:
max_tokensHaiku 4.5 podía utilizar:
{
  "thinking": {
    "type": "enabled",
    "budget_tokens": 8000
  }
}
Haiku 5.5 utiliza en su lugar razonamiento adaptativo.
Una solicitud que envíe la configuración antigua de budget_tokens devuelve un error 400.
Los desarrolladores deberían utilizar el razonamiento adaptativo y controlar la profundidad mediante el parámetro effort.
Anthropic recomienda omitir:
temperature
top_p
top_k
de las solicitudes a Haiku 5.5.
Los valores que no sean los predeterminados pueden devolver errores 400.
En su lugar, se deben utilizar los prompts y el esfuerzo para controlar el comportamiento.
Haiku 5.5 no admite el patrón antiguo en el que el último mensaje es un turno del asistente que el modelo continúa.
Para formatos estructurados, Anthropic recomienda utilizar salidas estructuradas o esquemas de herramientas.
Para las integraciones de uso del ordenador de la API de Claude y Google Cloud, la guía de migración indica que se debe pasar a:
computer_toolset_20260801
El conjunto de herramientas actual expone acciones como:
como herramientas miembro de un único conjunto de herramientas del ordenador.
Anthropic recomienda un aislamiento sólido y controles de acceso para los entornos de uso del ordenador.
Las aplicaciones deberían gestionar:
refusal
model_context_window_exceeded
como estados explícitos.
Un rechazo de seguridad no equivale a un fallo ordinario de infraestructura que se pueda reintentar.
La guía de migración de Haiku 5.5 de Anthropic indica que el nivel de prioridad no es compatible con el nuevo modelo.
Los equipos con compromisos existentes de nivel de prioridad para Haiku 4.5 deberían planificar la capacidad por separado.
Anthropic proporciona una skill integrada para migrar la API de Claude.
En Claude Code, el comando del artículo de origen es válido:
/claude-api migrate this project to claude-haiku-5-5
La guía oficial de migración indica que la skill puede:
Solicita al usuario que confirme el alcance de la migración antes de editar archivos.
Esto la hace útil para repositorios grandes en los que la llamada a la API está distribuida entre varios archivos.
Anthropic afirma que sus SDK de Python y TypeScript incluyen ahora clases beta para:
La interfaz actual de uso del ordenador emplea:
computer_toolset_20260801
En las plataformas compatibles, el conjunto de herramientas proporciona 17 acciones miembro, como:
screenshot
left_click
type
scroll
zoom
Para flujos de trabajo exclusivamente web, Anthropic recomienda utilizar la herramienta de uso del navegador cuando sea apropiado, en lugar de exponer un entorno de escritorio completo.
Esto es importante porque la combinación de velocidad y bajo precio de Haiku lo hace especialmente adecuado para interacciones repetitivas con navegadores y agentes de escritorio.
Anthropic afirma que Haiku 5.5 está disponible a través de:
El artículo de origen también señala la disponibilidad a través de plataformas de terceros como Cursor y OpenRouter.
Estas son integraciones externas y pueden tener sus propios precios, límites de uso y comportamientos de enrutamiento de modelos.
Para el desarrollo directo con Anthropic, el ID oficial del modelo es:
claude-haiku-5-5
Claude Haiku 5.5 es el modelo pequeño más rápido y de menor coste de Anthropic dentro de la familia Claude 5.5. Está diseñado para trabajos de alto volumen y sensibles a la latencia, como resúmenes, clasificación, enrutamiento, extracción, uso del navegador y tareas de subagentes.
Para prompts de hasta 100.000 tokens, cuesta $0.10 por millón de tokens de entrada y $0.50 por millón de tokens de salida. Los prompts de más de 100.000 tokens utilizan tarifas superiores de $0.50 para la entrada y $2.50 para la salida por millón de tokens.
Las tarifas por token para prompts cortos son un 90 % inferiores. Anthropic estima que el coste medio de las cargas de trabajo reales es aproximadamente un 75 % menor, porque las solicitudes de más de 100.000 tokens solo reciben una reducción de precio del 50 % y el nuevo tokenizador produce aproximadamente un 30 % más de tokens para el mismo texto.
Para contextos cortos, sus precios estándar de entrada, entrada en caché y salida son iguales. Para contextos largos, GPT-6 Luna resulta actualmente más favorable porque su umbral de tarifa superior comienza por encima de 272.000 tokens en lugar de 100.000, y sus precios para contexto largo son inferiores.
Sí. Anthropic indica una ventana de contexto de 1.000.000 de tokens y hasta 128.000 tokens de salida para las solicitudes normales. Una opción beta de lotes de mensajes puede admitir hasta 300.000 tokens de salida.
Es mucho más potente que Haiku 4.5 y supera a GPT-6 Luna en los resultados publicados por Anthropic para Terminal-Bench y FrontierCode. Anthropic sigue recomendando Sonnet 5.5 u Opus 5.5 para la programación compleja con agentes.
Los cambios principales incluyen el nuevo ID del modelo, un aumento aproximado del 30 % en el número de tokens para el mismo texto, razonamiento adaptativo en lugar de budget_tokens, eliminación de las antiguas opciones de muestreo, ausencia de prefills del asistente, herramientas de uso del ordenador actualizadas y nuevos motivos de detención.
El ID del modelo para la API de Claude es:
claude-haiku-5-5
Anthropic también documenta identificadores específicos de plataforma para Amazon Bedrock, Google Cloud, Microsoft Foundry y Claude Platform en AWS.
/claude-api migrate.computer_toolset_20260801 y la integración de agentes de escritorio.computer_toolset_20260801 y de las recomendaciones de seguridad.Claude Haiku 5.5 es una actualización mucho mayor de lo que podría sugerir su posición en la parte inferior de la escala de precios de Claude. Anthropic redujo el precio para prompts cortos a $0.10 por millón de tokens de entrada y $0.50 por millón de tokens de salida, al tiempo que trasladó el modelo a una ventana de contexto de 1 millón de tokens, razonamiento adaptativo y un rendimiento considerablemente superior en uso del ordenador, programación, trabajo de conocimiento y razonamiento.
El papel del modelo sigue estando claro. Sonnet 5.5 y Opus 5.5 continúan siendo mejores opciones para la programación difícil con agentes y el trabajo abierto, mientras que Haiku 5.5 está optimizado para trabajos rápidos, concretos y repetibles que se pueden ejecutar a escala o delegar en un modelo líder más grande.
Los desarrolladores que migren desde Haiku 4.5 no deberían limitarse a cambiar el ID del modelo. El nuevo tokenizador, el razonamiento adaptativo, las restricciones de muestreo, los cambios en los prefills, el conjunto de herramientas de uso del ordenador y el umbral de precios para contextos largos afectan a las integraciones existentes.
Haiku 5.5 resulta más atractivo no como reemplazo barato de todos los modelos más grandes, sino como una capa de ejecución rápida que hace que los sistemas de alto volumen y multiagente sean considerablemente más económicos.
Empieza con una sola frase y obtén un sitio completo en minutos.