For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/es/articles/openai-s-gpt-7-and-gpt-8-research-focus-w-75b1c0ac.md.
GPT-6 todavía es nuevo, pero OpenAI ya está pensando mucho más allá de él.
GPT-6 todavía es nuevo, pero OpenAI ya está pensando mucho más allá de él.
En la Cumbre de IA Fellows Forum del 23 de septiembre de 2026, Boris Power, responsable de Investigación Aplicada de OpenAI, estimó que aproximadamente entre el 80 % y el 90 % de la investigación de la empresa ya está centrada en:
GPT-7
GPT-8
y generaciones posteriores
La observación surgió durante una conversación pública con Zachary Lipton sobre cómo los modelos de frontera pasan de la investigación a los agentes y a los sistemas del mundo real.
El punto de Power no era que GPT-6 haya dejado de importar.
OpenAI sigue mejorando activamente la generación actual. A principios de septiembre, la empresa lanzó GPT-6 Astra, su modelo GPT-6 de mayor capacidad. El 22 de septiembre, amplió la familia con los más rápidos y menos costosos GPT-6 Sol y GPT-6 Luna.
Esto crea una aparente contradicción:
La explicación de Power conecta ambos aspectos.
OpenAI puede seguir mejorando los modelos actuales porque estas correcciones mejoran los productos de hoy y aportan lecciones útiles al equipo de investigación. Al mismo tiempo, los mayores avances a largo plazo pueden provenir de construir un modelo de próxima generación mucho más potente y, después, usar ese modelo para ayudar a entrenar sistemas más económicos.
El resultado es una estrategia de dos vías:
impulsar la frontera de capacidad
+
llevar capacidades útiles a una curva de costes más baja
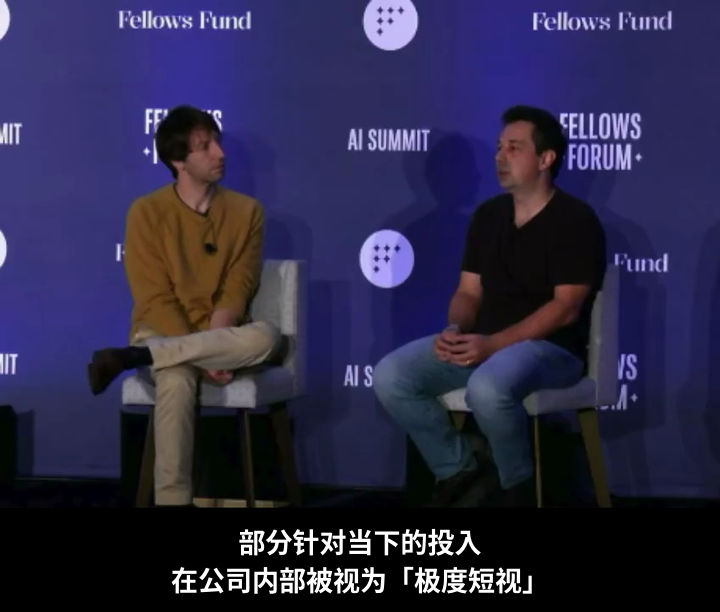
Power empleó un lenguaje inusualmente contundente para describir parte del trabajo en los sistemas de la generación actual.
Dijo que ciertas inversiones destinadas a los modelos actuales se consideran internamente «extremadamente cortoplacistas».
Esto no significa que ese trabajo sea inútil.
Supongamos que un modelo actual tiene dificultades para utilizar herramientas.
Un equipo podría:
Esto puede mejorar el producto de inmediato.
También puede enseñar a los investigadores por qué falló el modelo y qué intervenciones ayudaron.
La advertencia de Power se refiere a la vida útil de la corrección.
Un problema que requiere una intervención cuidadosa en GPT-6 podría desaparecer de forma natural en GPT-7 porque la siguiente generación del modelo simplemente es mejor en la capacidad subyacente.
En otras palabras:
el parche de hoy
puede convertirse en
la solución alternativa obsoleta de mañana
Por eso las organizaciones de investigación deben decidir constantemente qué problemas merecen una inversión profunda.
El hecho de que una corrección pueda quedar obsoleta no significa que los usuarios puedan esperar.
Las personas utilizan productos actuales hoy.
Si un modelo pierde repetidamente de vista un objetivo, no utiliza correctamente una herramienta o necesita demasiada supervisión manual, ese problema sigue siendo importante.
Por lo tanto, la distinción de Power es entre:
lo que mejora el producto ahora
y:
lo que crea el mayor valor de investigación a largo plazo
El lanzamiento de GPT-6 Astra de OpenAI muestra que la empresa sigue realizando un trabajo sustancial en la primera categoría.
En el anuncio oficial de Astra, OpenAI describe mejoras orientadas al trabajo práctico, incluido un uso más rápido del ordenador y una mejor colaboración dentro de Codex.
Astra puede hacer al usuario una pregunta concreta mientras continúa con el trabajo que no depende de la respuesta. Si la decisión tiene consecuencias importantes, espera. Si el detalle que falta es rutinario, puede continuar con una suposición razonable.
OpenAI también afirma que Astra es mejor manteniendo el objetivo y las restricciones originales cuando el usuario añade nuevos requisitos durante una tarea.
Estos detalles pueden parecer menos espectaculares que una puntuación de benchmark, pero afectan directamente a si un sistema de IA se comporta más como una herramienta o como un colega capaz.
La segunda parte del argumento de Power trata sobre el tamaño de los modelos.
¿Por qué invertir tan intensamente en un modelo de frontera costoso si muchos usuarios finalmente quieren algo más rápido y económico?
Porque el modelo más potente puede convertirse en el profesor.
Power describió un patrón como este:
entrenar un modelo general de alta capacidad
→ usarlo para generar ejemplos de alta calidad
→ seleccionar o filtrar resultados útiles
→ entrenar un modelo más pequeño con esos ejemplos
→ desplegar el modelo más pequeño a menor coste
Esta es una forma de destilación de modelos.
El modelo alumno no necesita reproducir todas las capacidades del profesor.
Solo necesita heredar suficiente comportamiento útil del profesor para la tarea objetivo.
Por eso, el trabajo en un modelo de frontera puede seguir siendo relevante incluso para clientes que nunca utilizan el modelo de frontera directamente.
OpenAI ha descrito públicamente la destilación en generaciones de productos anteriores.
En marzo de 2025, cuando presentó una nueva generación de modelos de audio, la empresa dijo que había utilizado métodos avanzados de destilación para transferir conocimiento de modelos de audio más grandes a sistemas más pequeños y eficientes.
La empresa también describió el uso de datos de autojuego para captar dinámicas conversacionales más realistas, de modo que los modelos más pequeños siguieran siendo útiles y receptivos.
Un ejemplo independiente de OpenAI Cookbook hace que la idea de profesor-alumno sea más fácil de observar.
El ejemplo utiliza GPT-4o como profesor de GPT-4o mini en una tarea de clasificación de variedades de uva para vino.
En un conjunto de validación de 300 ejemplos, las precisiones informadas fueron:
GPT-4o:
79,67 %

GPT-4o mini:
64,67 %

GPT-4o mini destilado:
79,33 %
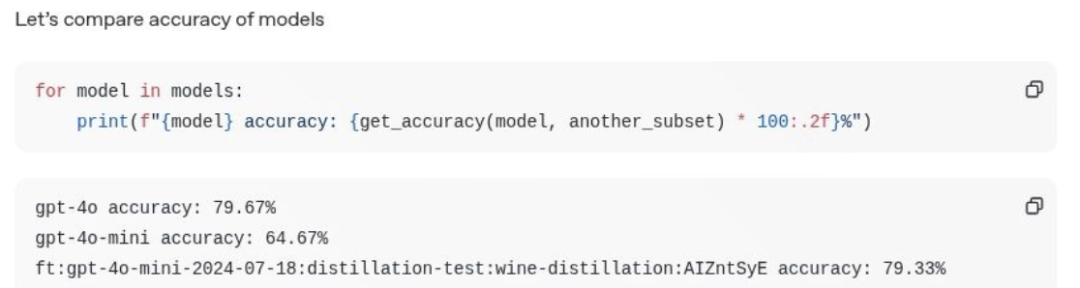
El alumno destilado casi igualó al profesor en esa tarea específica.
Esto no significa que el modelo más pequeño se volviera equivalente a GPT-4o en términos generales.
Significa que un profesor capaz puede transferir un comportamiento específico con eficacia suficiente para que un modelo más pequeño sea mucho más útil en una carga de trabajo acotada.
La familia GPT-6 aplica una idea similar a escala de producto, aunque OpenAI no ha publicado una receta de entrenamiento completa que justifique llamar a Luna simplemente una «Astra destilada».
OpenAI afirma que GPT-6 Sol y GPT-6 Luna fueron entrenados con métodos similares a los utilizados para GPT-6 Astra, llevando avances de la generación Astra a modelos más rápidos y asequibles.
La empresa posiciona la familia de esta manera:
GPT-6 Astra
máxima capacidad

GPT-6 Sol
alto rendimiento de propósito general a menor coste

GPT-6 Luna
modelo de coste mucho más bajo para trabajo de gran volumen
Los precios oficiales de OpenAI para GPT-6 en el lanzamiento del 22 de septiembre fueron:
| Transición de modelo | Entrada | Salida | Reducción |
|---|---|---|---|
| GPT-5.6 Sol → GPT-6 Sol | 4 $ → 2 $ / 1 millón de tokens | 20 $ → 10 $ / 1 millón de tokens | 50 % |
| GPT-5.6 Luna → GPT-6 Luna | 0,20 $ → 0,10 $ / 1 millón de tokens | 1,20 $ → 0,50 $ / 1 millón de tokens | 50 % |
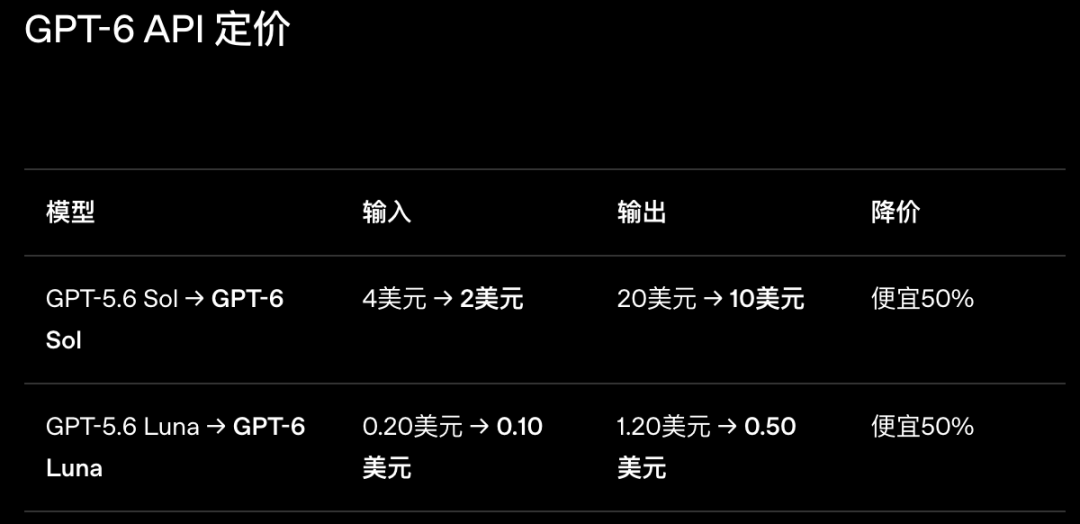
OpenAI describe explícitamente el objetivo como distribuir inteligencia de frontera entre distintos presupuestos y cargas de trabajo.
Un modelo más grande eleva el techo.
Los modelos más pequeños trasladan una mayor parte de esa capacidad al uso cotidiano.
Porque la mayoría de los flujos de trabajo no tienen la misma dificultad de principio a fin.
Un informe de proyecto es un ejemplo útil.
Imagina varios documentos fuente que:
La primera parte del trabajo requiere un juicio más sólido.
Un modelo capaz puede:
Describe tu idea una vez y We0 AI puede generar un sitio de presentacion, paginas y CMS, y ayudarte a atraer clientes y trafico tras el lanzamiento.
Una generación completa de proyectos para registro gratuito
Lo mejor para probar un flujo de generación completo y ver rápidamente el primer borrador del proyecto.
Una vez establecida la dirección, muchos de los pasos restantes se vuelven más rutinarios.
Un modelo más pequeño puede ser perfectamente adecuado para:
Si aparece una nueva ambigüedad, la tarea puede escalarse de nuevo al modelo más potente.
Por tanto, un flujo de trabajo práctico podría ser así:
modelo potente
→ juicio difícil

modelo pequeño
→ ejecución repetitiva

modelo potente
→ gestión de excepciones
Los tokens más baratos no implican automáticamente un trabajo más barato.
Un modelo pequeño puede costar menos por solicitud, pero generar más trabajo para el usuario si exige:
Por tanto, la pregunta útil no es:
¿Qué modelo tiene el precio por token más bajo?
Es:
¿Cuánto cuesta todo el resultado aceptado?
Ese total incluye tanto el coste de máquina como el tiempo humano.
Una factura de API menor no es una gran ventaja si el usuario tiene que convertirse en un gestor de proyectos de IA a tiempo completo para que el modelo económico tenga éxito.
Por lo tanto, la mejor división del trabajo depende de la tarea.
Un modelo más pequeño es valioso cuando puede completar de forma fiable un trabajo bien definido a bajo coste.
Un modelo más grande justifica su mayor precio cuando la tarea realmente exige un juicio más sólido.
Power también describió un cambio en la forma en que las personas interactúan con generaciones sucesivas de modelos.
El artículo fuente resume la progresión aproximadamente así:
GPT-4:
los humanos diseñan cuidadosamente los pasos

GPT-5:
los humanos guían el proceso y corrigen continuamente

GPT-6:
los humanos definen cada vez más el objetivo y supervisan las decisiones clave
Esta es una simplificación, no una garantía para todas las tareas.
Pero la propia documentación de Astra de OpenAI describe la misma dirección general.
Astra puede:
Esto cambia el papel humano.
En lugar de especificar manualmente cada paso, el usuario hace cada vez más algo parecido a:
definir el objetivo
→ establecer restricciones
→ revisar decisiones relevantes
→ inspeccionar el resultado
La pregunta clave para GPT-7 y GPT-8 es hasta dónde puede llegar este cambio.
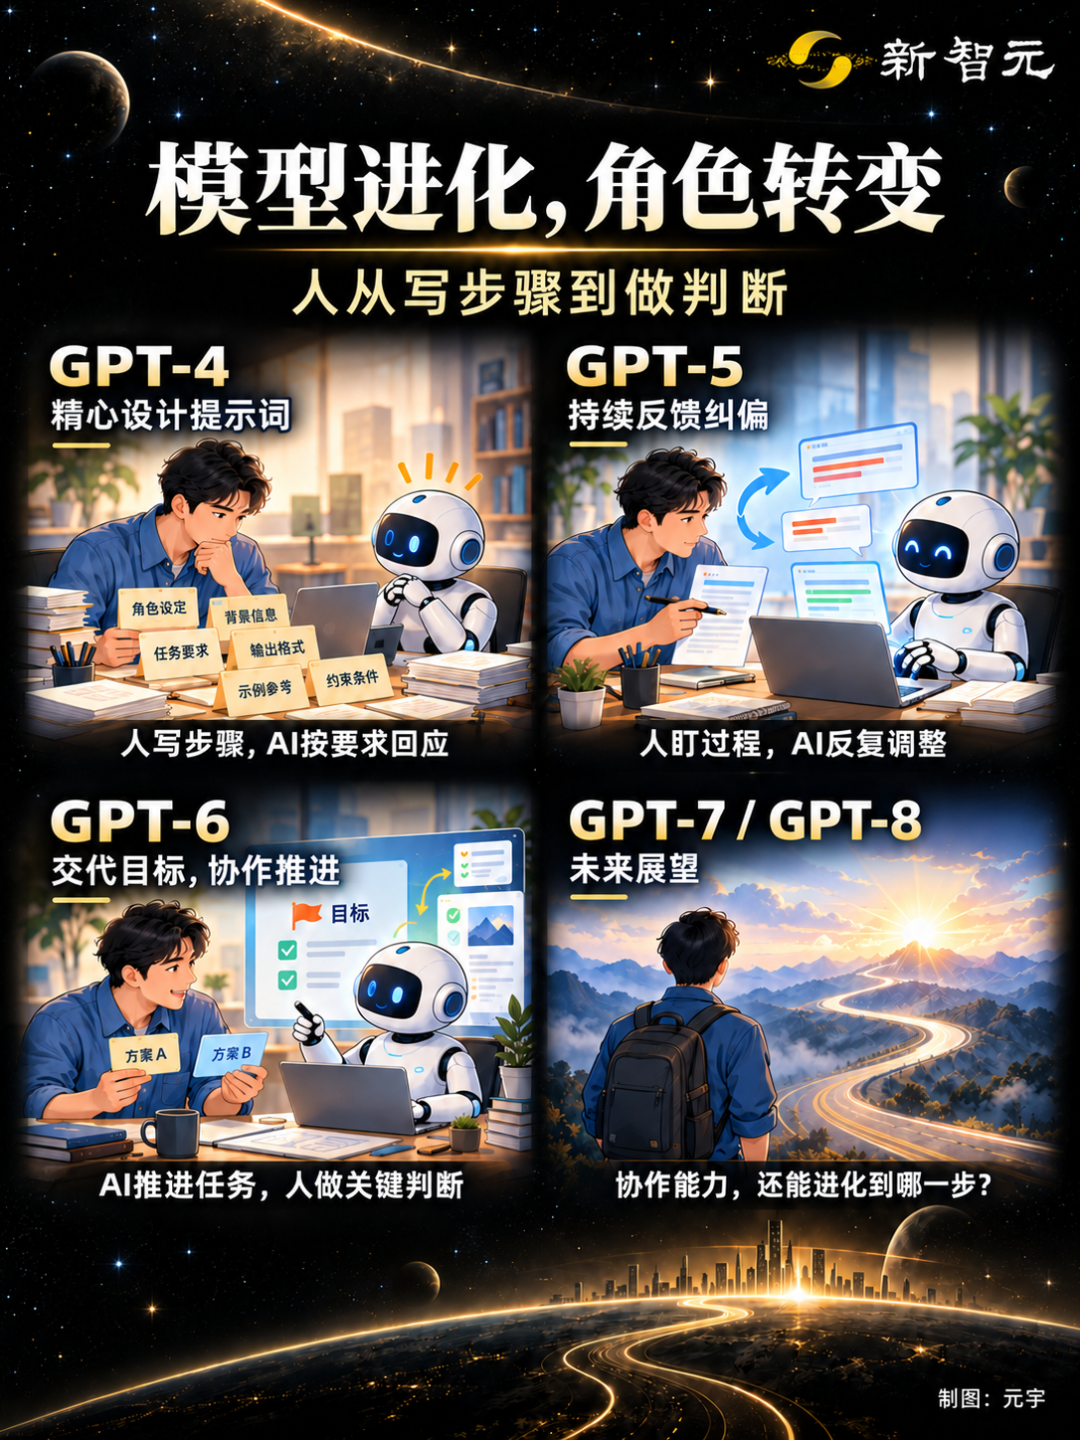
El progreso de los modelos suele presentarse mediante puntuaciones de benchmark.
Para el trabajo cotidiano, otra métrica puede importar más:
¿Cuánta supervisión debe seguir proporcionando el usuario?
Después de dar un objetivo al modelo:
Si GPT-7 o GPT-8 reduce estas cargas, puede ser más valioso que una pequeña mejora en un benchmark.
Esta es también la razón por la que la investigación sobre modelos grandes y el trabajo sobre modelos pequeños se refuerzan mutuamente.
El modelo de frontera intenta descubrir comportamientos más capaces.
El modelo económico intenta hacer que una parte suficiente de ese comportamiento sea asequible a escala.
La cifra principal requiere una precisión importante.
La declaración de Power de «80 % a 90 %» fue una estimación realizada durante una conversación pública.
No fue:
La agenda de Fellows Forum confirma que Power intervenía como responsable de Investigación Aplicada de OpenAI en una charla informal del 23 de septiembre titulada «Where Models Meet Reality».
La cobertura independiente de la grabación sitúa la observación del 80–90 % aproximadamente en el minuto 1:32:52 de la grabación completa del evento.
Por tanto, la interpretación más prudente es:
Power considera que la gran mayoría de la atención de investigación de OpenAI se dirige a generaciones de modelos posteriores a GPT-6 porque espera que ahí se produzcan los mayores avances fundamentales.
No debe leerse como una declaración contable literal.
Power realizó sus comentarios el 23 de septiembre.
Seis días después, el 29 de septiembre, OpenAI lanzó GPT-6.1 Sol.
Este modelo no es central para el argumento del artículo original, porque el debate se centra en la lógica profesor-alumno de Astra → Sol/Luna que Power describió en el evento.
Aun así, es un contexto útil para quienes publiquen el artículo ahora.
OpenAI describe GPT-6.1 Sol como la familia de modelos más reciente de la serie GPT-6, con capacidades cercanas a Astra para programación, uso de ordenadores y trabajo profesional a un precio estándar de API mucho más bajo.
Su existencia refuerza el mismo patrón analizado en la entrevista:
la capacidad de frontera mejora
→ los modelos de menor coste absorben más de ella
→ los usuarios obtienen un rendimiento más sólido a menor coste
También muestra por qué los nombres de los lanzamientos intermedios individuales importan menos que la estrategia de investigación general.
Boris Power, responsable de Investigación Aplicada de OpenAI, estimó en Fellows Forum 2026 que aproximadamente entre el 80 % y el 90 % de la investigación de OpenAI se centra en GPT-7, GPT-8 y generaciones posteriores. La cifra fue su estimación pública, no un informe auditado de asignación de recursos de la empresa.
No se anunció ninguna fecha pública de lanzamiento ni una hoja de ruta detallada de producto para GPT-7 o GPT-8 en los comentarios de Power. Utilizó esos nombres para describir las generaciones posteriores a GPT-6 que, según él, reciben la mayor parte de la atención de investigación a largo plazo.
El trabajo en la generación actual mejora los productos de hoy y ofrece a los investigadores una retroalimentación más rápida. El punto de Power es que algunas correcciones pueden tener una vida corta, porque un modelo de próxima generación más capaz puede hacer que el problema subyacente sea más fácil o eliminarlo por completo.
La destilación de modelos es una familia de técnicas en la que un modelo profesor más potente ayuda a entrenar un modelo alumno más pequeño. Un flujo de trabajo habitual utiliza el profesor para generar ejemplos de alta calidad, filtra esos ejemplos y entrena al modelo más pequeño para reproducir el comportamiento necesario para una tarea objetivo.
OpenAI afirma que Sol y Luna fueron entrenados con métodos similares a Astra y heredan avances de la misma generación, pero no ha publicado suficiente detalle para describir Luna o Sol simplemente como copias comprimidas de Astra. Es más preciso decir que trasladan avances de capacidades relacionadas a niveles de coste inferiores.
En su lanzamiento del 22 de septiembre, OpenAI fijó el precio de GPT-6 Sol en 2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida, y el de GPT-6 Luna en 0,10 $ de entrada y 0,50 $ de salida por millón de tokens. OpenAI describió ambos como un 50 % más baratos que los precios promocionales de sus equivalentes GPT-5.6.
Utiliza el modelo más potente cuando la tarea exige juicio difícil, razonamiento ambiguo, gestión de excepciones o decisiones importantes. Los modelos más pequeños suelen ser más adecuados para trabajo repetitivo, de gran volumen y claramente especificado una vez que se ha definido la dirección principal.
La tendencia pasa de redactar cada paso a establecer objetivos, definir restricciones y revisar las decisiones importantes. La documentación de Astra de OpenAI describe específicamente preguntas asíncronas, trabajo continuado mientras se espera una respuesta y una mejor conservación del objetivo original durante tareas largas.
La estimación de Boris Power del 80–90 % facilita la comprensión de la estrategia de investigación de OpenAI. La empresa puede seguir mejorando los productos GPT-6 actuales mientras dirige la mayor parte de su atención de investigación a largo plazo hacia generaciones futuras, donde espera lograr avances de capacidad mayores.
La segunda mitad de esa estrategia es igualmente importante. Los modelos de frontera más potentes no solo son valiosos como productos prémium; también pueden servir como profesores y plataformas de investigación que ayudan a trasladar capacidades útiles a sistemas más rápidos y económicos, como Sol y Luna.
Para los usuarios, la pregunta práctica no es qué modelo es el más grande. Es cómo distribuir el trabajo para que el juicio difícil vaya al modelo capaz de gestionarlo, mientras que la ejecución rutinaria se asigna al modelo de menor coste que pueda completarla de forma fiable.
La apuesta de largo plazo de OpenAI parece sencilla: seguir elevando el techo de capacidad y, después, hacer que una mayor parte de esa capacidad sea lo bastante asequible para utilizarse todos los días.
Empieza con una sola frase y obtén un sitio completo en minutos.



