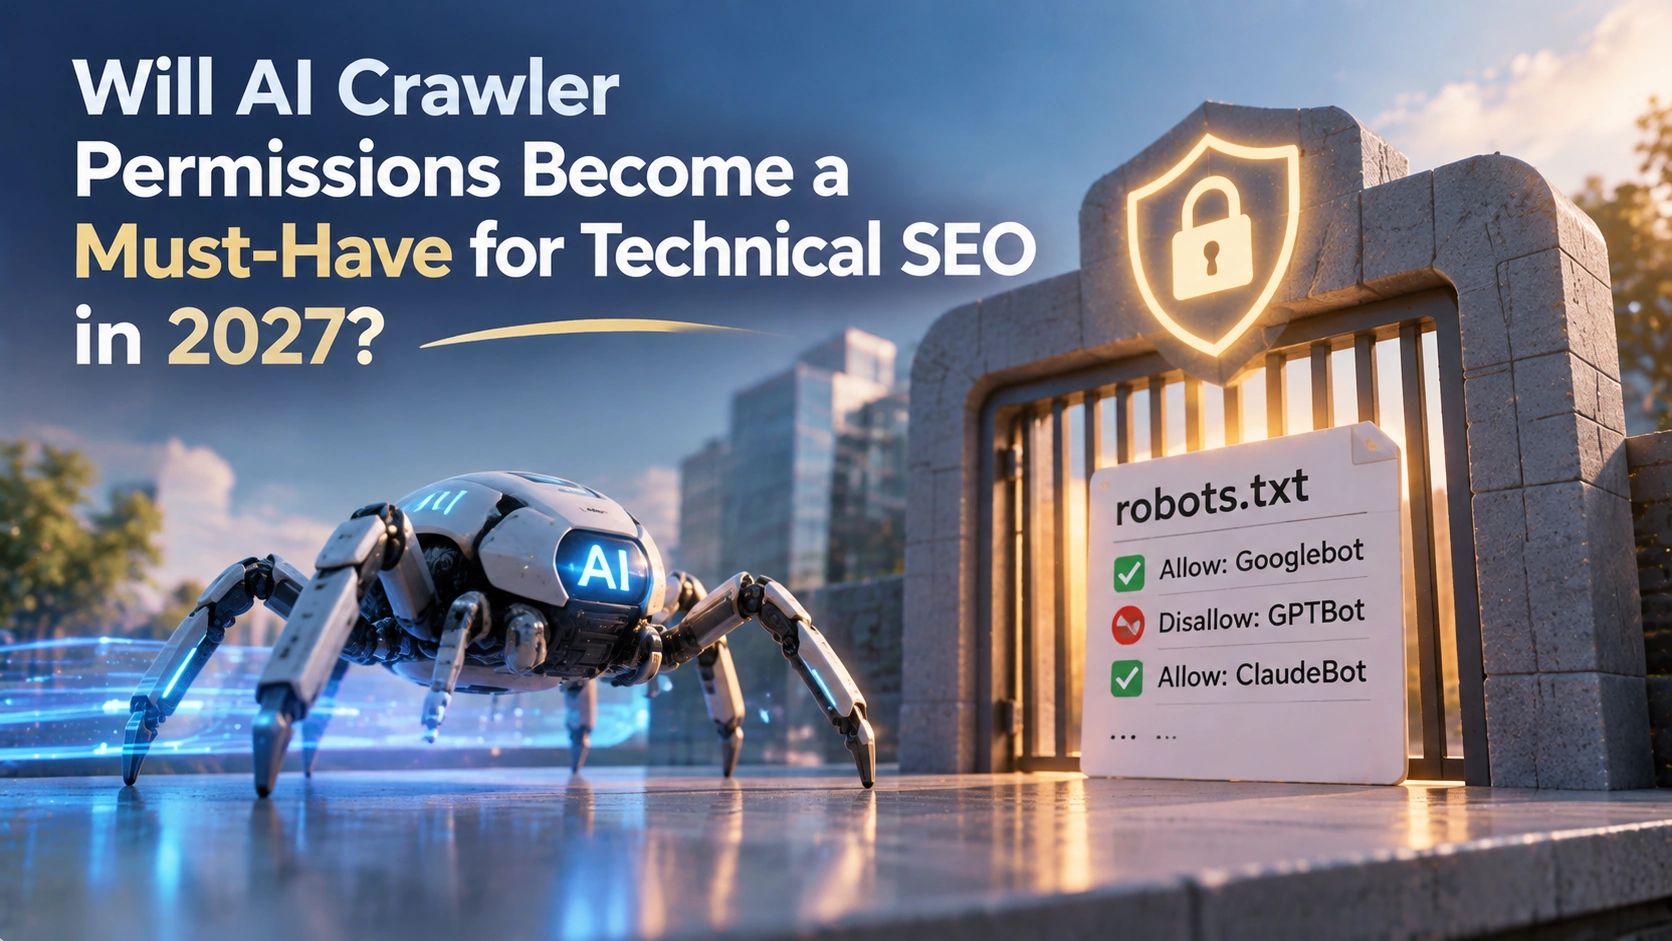
User-agent: Googlebot
Allow: /
User-agent: Google-Extended
Disallow: /
Futur signal partagé de préférences d’entraînement (Google prévoit de le prendre en charge début 2027)
User-agent: __usage_ai-training
Disallow: /
Attention en particulier : le `Disallow` de `Google-Extended` ne fait pas disparaître une page des résultats de Google Search. La documentation officielle précise qu’il n’affecte pas l’inclusion du site dans les résultats de Google Search et qu’il n’est pas utilisé comme facteur de classement dans Google Search. À l’inverse, une interdiction de tout le site sous `User-agent: *` affecte aussi Googlebot ; ce type de « blocage réflexe » est l’auto-sabotage le plus fréquent en SEO technique.
## Pourquoi faut-il distinguer l’entraînement IA et l’ancrage IA ?
C’est l’ensemble de notions le plus facile à mal rédiger en 2027.
**Entraînement IA** désigne le fait que le contenu d’une page est ou non utilisé pour entraîner les futures versions d’un modèle ; cela influe sur les paramètres du modèle. **Ancrage IA (grounding)** désigne le fait qu’un modèle utilise ou non, en temps réel, le contenu web récupéré par recherche comme base factuelle au moment de répondre ; cela influe sur la présence ou non de vos informations dans une réponse donnée. Le premier point concerne l’utilisation gratuite d’un actif de contenu ; le second concerne votre capacité à apparaître dans les réponses d’IA. Les conséquences commerciales sont totalement différentes.
Selon l’explication officielle de Google à propos de `Google-Extended`, ce jeton gère la possibilité d’utiliser ou non le contenu récupéré par Google sur un site pour entraîner les futures versions des modèles Gemini, lesquels alimentent l’application Gemini et Gemini sur Vertex AI ; il sert aussi, dans l’application Gemini, à fournir au modèle le contenu de l’index Google Search afin d’améliorer la véracité et la pertinence, ainsi qu’au grounding lors de l’utilisation de Google Search sur Vertex AI. Autrement dit, dans cette implémentation de Google, la licence d’entraînement et la licence d’ancrage sont couvertes par un même jeton. Les opérateurs qui souhaitent « interdire l’entraînement tout en conservant les citations » doivent vérifier, plateforme par plateforme, si celle-ci propose une telle capacité de séparation ; ils ne peuvent pas supposer que toutes les plateformes l’ont déjà fait.
## Le blocage de l’entraînement peut-il affecter les citations dans la recherche IA ?

La réponse dépend du contexte ; on ne peut pas la résumer en une phrase.
**Dans Google Search, non.** Les fonctionnalités d’IA reposent sur l’index de recherche ; bloquer l’entraînement ne fait pas perdre aux pages leur chance d’être indexées. C’est le résultat direct de la séparation entre `Google-Extended` et `Googlebot`.
**Dans le cas d’assistants IA externes, souvent oui.** Ces systèmes utilisent leurs propres robots d’exploration ; l’exécution ou non de JavaScript, l’application ou non de robots.txt, la priorité ou non donnée aux pages bien structurées varient selon les règles de chaque plateforme. Bloquer l’entraînement équivaut souvent à bloquer l’exploration, et si l’exploration est bloquée, toute chance d’être cité disparaît. L’entretien de Moz contient un rappel pratique : pour les contenus que l’on souhaite voir par l’IA, les informations clés doivent apparaître directement dans le HTML brut ; à l’inverse, le rendu JavaScript peut servir de moyen de protection, en rendant plus difficile la lecture massive des actifs que l’on ne souhaite pas exposer. C’est un arbitrage, pas un interrupteur gratuit.
**Au niveau de la surveillance, on devient facilement aveugle.** Le vrai risque est de ne pas voir les effets après le blocage. Si les journaux ne contiennent même pas d’enregistrement correspondant, il est impossible de savoir si l’impact vient de « personne ne vient explorer » ou de « l’exploration a eu lieu mais aucune citation n’en a résulté ».
## Où se situent les différences de règles de contrôle entre Google et les autres plateformes ?
D’après les sources publiques vérifiables, les différences se concentrent sur trois points : la granularité du contrôle, la convention de nommage et le calendrier d’application.
| Dimension | Google | Autres plateformes (selon la documentation officielle de chacune) |
| --- | --- | --- |
| Emplacement d’expression | Jeton d’agent utilisateur dans robots.txt + signal de préférences partagé prévu | Champs de préférence définis par chaque documentation, avec des noms et emplacements non uniformes |
| Contrôle de l’entraînement | Jeton produit distinct `Google-Extended` | La plupart s’expriment par une déclaration de préférence séparée, avec des champs variables |
| Relation avec l’indexation dans la recherche | Google indique officiellement que l’indexation et le classement ne sont pas affectés | À vérifier plateforme par plateforme ; aucune analogie n’est possible |
| Calendrier d’application | Prise en charge du signal partagé d’entraînement prévue début 2027 | En phase de déploiement progressif |
| Mise en œuvre complète | Le signal partagé est encore en cours | Ne peut pas être considéré comme achevé |
Un même fichier robots.txt n’a pas la même signification sur différentes plateformes ; l’analogie entre plateformes est l’erreur factuelle la plus fréquente.
## Les limites de cinq moyens de contrôle des autorisations
| Moyen | Portée | Effet sur l’indexation Google | Effet sur les IA tierces | Réversibilité |
| --- | --- | --- | --- | --- |
| Jeton `Google-Extended` | Usages d’entraînement et d’ancrage chez Google | Aucun effet | Aucun effet | Élevée, il suffit de modifier le fichier |
| Jeton `Googlebot` | Google Search, ainsi que Images, Vidéos, Actualités, etc. | Effet direct | Aucun effet | Élevée |
| `X-Robots-Tag` / meta robots | Contrôle de l’exploration et de l’indexation au niveau de la page | Effet direct | Variable selon la plateforme | Moyenne, nécessite une nouvelle exploration |
| Rendu côté client du contenu clé | Visibilité du contenu | Généralement rendu possible | Souvent invisible | Moyenne, nécessite un changement d’architecture |
| WAF / blocage par IP | Blocage au niveau de la requête | Peut bloquer par ricochet | Efficace mais brutal | Faible, risque élevé de dommages collatéraux |
La liste de décision peut se réduire à trois questions : ce contenu doit-il être entraîné ? doit-il être cité ? en cas de problème, peut-on revenir en arrière en dix minutes ? Si une seule question reste sans réponse, il ne faut pas modifier la configuration.
## Les cinq étapes de mise en œuvre pour les exploitants de sites
**Première étape : auditer avant d’agir.** Utilisez les journaux pour confirmer quels agents utilisateurs visitent réellement le site ; un point de départ suffisant consiste à compter les requêtes par UA :
```bash
awk -F'"' '{print $6}' access.log \
| sort | uniq -c | sort -rn | head -30
Examinez d’abord la liste, puis définissez la stratégie ; n’ajoutez pas une interdiction pour un UA donné en vous fondant sur une impression.
Deuxième étape : définir une stratégie par niveaux. Distinguez au moins trois catégories de pages : les pages marketing qui doivent être explorées par la recherche et citées par l’IA, les contenus sensibles destinés uniquement à la lecture humaine, et les ressources publiques que l’on ne souhaite pas voir utilisées pour l’entraînement. Ces trois catégories ne doivent pas partager la même règle.
Troisième étape : rédiger la configuration et annoter l’intention. Dans robots.txt, utilisez des commentaires pour expliquer la raison métier de chaque règle, afin de faciliter les transmissions et les audits futurs.
Quatrième étape : vérifier. Utilisez l’outil de test robots.txt de la plateforme pour contrôler le résultat d’analyse pour l’UA ciblé, puis relisez les journaux pour confirmer l’évolution de l’exploration.
Cinquième étape : instaurer un rythme de revue. Le signal partagé de préférences d’entraînement est encore en cours de déploiement ; il est recommandé de faire une revue trimestrielle plutôt que de configurer une fois pour toutes et de ne plus y toucher.
Erreurs fréquentes et limites
Considérer robots.txt comme une barrière juridique. Il exprime une volonté, il n’offre pas de force contraignante ; une véritable protection doit associer stratification du contenu, contrôle d’accès et clauses contractuelles.
Croire que bloquer l’entraînement rend le contenu invisible. Cela ne se vérifie pas du côté de Google Search, mais souvent du côté des assistants externes ; les deux conclusions sont opposées.
Traiter uniquement l’entraînement sans gérer l’ancrage. Si une plateforme lie l’entraînement et le grounding à un même jeton, bloquer l’entraînement réduit aussi les chances d’être cité.
Creez un site vitrine et genere des leads en quelques minutes
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Prendre la gestion des autorisations pour un interrupteur de trafic. Elle détermine « qui peut lire et ce qui peut être fait après lecture » ; elle ne garantit ni classement, ni trafic, ni résultat commercial.
Ignorer les différences de rendu. Un contenu qui n’existe que dans JavaScript revient à rester silencieux pour une catégorie de robots d’exploration ; ce type de problème dépasse le cadre de la configuration des autorisations et nécessite une modification conjointe du front-end et de l’architecture.
Le travail quotidien du SEO technique passe de « faire comprendre le site aux moteurs de recherche » à « expliquer clairement qui peut lire, et ce qui peut être fait après lecture ». Si la structure des pages, les informations structurées et la mise à jour du contenu du site sont déjà chaotiques, la configuration des autorisations ne fera qu’enregistrer ce chaos. Faire avancer la création du site et l’exploitation du contenu dans un même système coûte généralement moins cher que d’ajouter des règles après coup — par exemple, lorsque we0 génère un site, il place l’optimisation SEO et GEO, le back-office CMS et le déploiement du nom de domaine dans une même chaîne : la structure des pages, les blocs d’informations citables et le processus de mise en ligne se forment ensemble, ce qui permet ensuite de faire correspondre plus facilement la stratégie d’autorisations à des types de pages concrets.
FAQ
Faut-il avoir terminé la gestion des autorisations des robots d’IA avant 2027 ?
Il n’est pas nécessaire de modifier immédiatement la configuration, mais il est recommandé d’avoir fixé l’audit et la stratégie avant 2027. Le signal partagé de préférences d’entraînement est encore en cours de déploiement ; Google prévoit de le prendre en charge début 2027. Les équipes qui auront clarifié à l’avance la stratification des pages n’auront plus qu’à modifier quelques lignes de configuration lorsque les champs seront officiellement applicables.
Si l’on interdit Google-Extended dans robots.txt, le site disparaîtra-t-il de Google Search ?
Non. Selon la documentation officielle de Google, Google-Extended n’affecte pas l’inclusion du site dans les résultats de Google Search et n’est pas utilisé comme facteur de classement. Ce sont les règles liées à Googlebot qui affectent l’indexation dans la recherche.
L’entraînement IA et l’ancrage IA sont-ils la même chose ?
Non. L’entraînement détermine si le contenu entre dans les paramètres des futurs modèles ; le grounding détermine si le modèle utilise ou non votre contenu en temps réel comme base au moment de répondre. Certaines implémentations couvrent les deux sous un même jeton ; il faut vérifier au cas par cas.
Quel est l’impact du fait que les robots d’IA n’exécutent pas JavaScript sur la configuration des autorisations ?
L’impact est important. Si les informations clés n’existent que dans le résultat du rendu côté client, la configuration des autorisations a beau être correcte, l’autre partie ne pourra pas lire le contenu. Il faut soit placer les informations essentielles dans le HTML brut, soit accepter que ce type de robot ne les voie pas.
Comment savoir si la configuration est réellement effective ?
Trois choses : vérifier avec l’outil de test officiel le résultat d’analyse pour l’agent utilisateur ciblé, relire les journaux d’accès pour confirmer l’évolution de l’exploration, et suivre régulièrement un ensemble fixe de questions réelles pour vérifier si vos informations de marque et vos sources apparaissent encore dans les réponses d’IA.
Outils associés
- Google Search Console (diagnostic d’indexation et d’exploration)
- Outil de test robots.txt (vérification du résultat d’analyse pour l’agent utilisateur ciblé)
- Analyse des journaux d’accès serveur (statistiques de répartition de l’exploration par UA)
- we0 (espace de travail de création de sites et de croissance par l’IA, couvrant l’optimisation SEO et GEO, le back-office CMS et le déploiement du nom de domaine)
Liens associés
- Liste des robots d’exploration courants de Google (documentation officielle)
- Proposer aux sites un choix partagé de contrôle de l’entraînement par l’IA (blog Google Search Central)
- Stop Calling It SEO: 12 Strategies To Dominate AI Search in 2026 (Moz)
- Mise en œuvre de l’optimisation pour les moteurs génératifs (GEO) (communauté des développeurs Tencent Cloud)
- Site officiel de We0
Résumé
La gestion des autorisations des robots d’IA en 2027 deviendra très probablement un livrable courant du SEO technique, mais l’essentiel n’est pas de « bloquer l’IA » : il s’agit de distinguer trois usages — l’exploration pour la recherche, l’entraînement des modèles et l’ancrage du contenu (grounding) — et de conserver une trace vérifiable. Trois éléments justifient ce constat : les préférences d’entraînement évoluent vers un signal lisible par machine et partagé, que Google prévoit de prendre en charge début 2027 ; les objets de contrôle passent d’un unique Googlebot à des jetons produits distincts ; et les citations par l’IA restent conditionnées à la possibilité d’exploration. Sur le plan opérationnel, il est plus efficace d’auditer d’abord les journaux, de définir une stratégie par niveau de page, d’annoter l’intention, de vérifier le résultat d’analyse puis d’instaurer un rythme de revue trimestrielle, plutôt que de bloquer une fois pour toutes. Les limites sont tout aussi claires : robots.txt est une convention et non une contrainte technique, Google-Extended n’affecte ni l’indexation ni le classement dans Google Search, et la licence d’entraînement et la licence d’ancrage ne sont pas encore séparées dans certaines implémentations. Bien expliciter ces distinctions évite que la gestion des autorisations ne se transforme en une erreur irréversible.