Ce qui change, c’est l’entrée et la méthode de filtrage. Lorsqu’un assistant navigue à la place de l’utilisateur, votre site est d’abord « lu » : le titre est-il précis, les spécifications sont-elles structurées en champs, le prix indique-t-il la devise, le stock est-il explicite, les règles de livraison et de retour sont-elles lisibles. Les informations ambiguës n’entrent pas dans la sélection ; un beau design ne sert à rien.
Ce qui ne change pas, c’est la responsabilité de la transaction. Une fois le paiement effectué, l’exécution de la commande, le service client, les remboursements et la détection de fraude restent à la charge du marchand ; même si l’utilisateur autorise et paie dans ChatGPT, le paiement a toujours lieu sur votre caisse, et la commande ainsi que le service après-vente sont traités par vous (Accept payments). L’agent est le dernier kilomètre qui amène le client jusqu’à vous, pas un sous-traitant qui gère votre boutique à votre place.
Pour un site indépendant, c’est une fenêtre relativement équitable : les boutiques sur plateforme dépendent de la distribution de trafic interne, tandis que dans le scénario des agents, ce qui détermine la recommandation, ce sont la qualité des données et l’accessibilité ; ces deux éléments sont contrôlables par le marchand lui-même.
II. Comment un agent IA comprend les informations de votre produit
Deux voies complémentaires : des données de catalogue structurées, et la lecture directe de la page.
La voie catalogue correspond au flux produit. La documentation définit le flux comme des « données de catalogue structurées », destinées à la découverte des produits ; il peut être téléversé manuellement depuis le back-office marchand, hébergé à une adresse HTTPS ou livré par SFTP sous forme d’instantané complet, chaque enregistrement devant contenir les champs obligatoires, conserver un item_id stable et choisir les pays de vente et la devise (Submit product feeds).
La voie page repose sur le navigateur cloud : il ouvre la page comme un humain, clique sur les boutons et interagit avec les éléments du site, sans que vous ayez besoin d’ouvrir une interface supplémentaire (Agent access).
Les deux voies n’autorisent aucune contradiction d’information. Si le même produit affiche un prix promotionnel dans le flux, un prix d’origine sur la page de liste et un prix membre sur la page de détail, l’assistant ne peut que conclure à une « incertitude », et l’utilisateur part.
Exigence minimale : le titre indique clairement la catégorie, le modèle et les attributs clés ; les spécifications utilisent des champs distincts plutôt que d’être enfouies dans une longue image ; le prix inclut la devise et le traitement fiscal ; le stock utilise des termes explicites comme « en stock / en précommande / en rupture » ; les délais de livraison et les règles de retour apparaissent dans la couche texte. En cas de balisage schema.org, le balisage doit correspondre à la page :
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "Chaussures de randonnée mi-hautes légères A2",
  "sku": "TRAIL-A2-42",
  "offers": {
    "@type": "Offer",
    "price": "799.00",
    "priceCurrency": "CNY",
    "availability": "https://schema.org/InStock"
  }
}
III. La structure de livraison à trois niveaux des prix et des stocks
Considérer « les prix et stocks destinés à l’IA » comme une interface n’est pas exact ; c’est plutôt trois niveaux :
- Instantané de catalogue : le flux indique à l’assistant quels produits existent, les ordres de prix et les régions de vente.
- Page en temps réel : lorsque l’utilisateur continue à poser des questions, l’assistant revient sur la page produit pour confirmer l’offre et les spécifications actuelles.
- Validation finale au moment de la commande : les données en temps réel de votre système font foi. La documentation précise que le flux ne met pas à jour le panier et ne confirme pas l’achat ; lorsque l’utilisateur exécute réellement l’action, l’état de disponibilité actuel est toujours vérifié par le site en temps réel ou le plugin (Submit product feeds).
En une phrase : le flux est responsable d’« être trouvé », le site est responsable d’« être confirmé ». Beaucoup d’équipes concentrent tous leurs efforts sur le flux, mais laissent le prix de la page de détail dépendre d’un rendu asynchrone côté front-end ; l’assistant lit alors une page vide. L’auto-vérification la plus rapide consiste à récupérer directement le code source de la page pour voir si les champs clés sont dans le HTML :
curl -s "$SITE/products/trail-a2" | grep -o '"availability":"[^"]*"'
curl -s "$SITE/products/trail-a2" | grep -o '"priceCurrency":"[^"]*"'
Si les deux commandes renvoient un résultat vide, cela signifie que le prix et le stock n’apparaissent qu’après l’exécution du script ; il faut ajouter un rendu côté serveur ou une sortie structurée.
IV. Un site indépendant doit-il créer un flux produit séparé ?
À décider selon la catégorie et la structure d’activité, et non selon le principe « tous les concurrents le font ».
| Critère d’évaluation | Priorité au flux | Peut être différé, commencer par soigner la page |
|---|---|---|
| Nombre de produits | Plusieurs centaines de SKU ou plus, catalogue stable | Produit unique, sur mesure, service par projet |
| Structure de prix | Prix affiché clair, peu de négociation | Demande de devis, tarification à la demande |
| Forme du stock | Stock disponible, quantifiable | Précommande, production à la commande |
| Zones de vente | Plusieurs pays, plusieurs devises | Marché régional unique |
| Système existant | PIM/ERP existant permettant l’export | Informations produit dispersées dans des tableurs |
Pour la colonne de droite, il est plus direct de consacrer le budget à la structuration des pages, à l’accessibilité et à la stabilité du paiement ; pour la colonne de gauche, il est préférable d’unifier tôt les normes de champs afin de réduire les coûts de migration futurs. Dans la zone intermédiaire, on peut commencer par un pilote sur les 50 SKU les plus vendus, valider le cycle « téléversement—vérification—mise à jour », puis élargir.
V. Un agent peut-il appeler directement une interface de requête produit ?
Oui, mais le coût et le niveau de contrôle diffèrent.
L’automatisation par navigateur réutilise votre parcours de page existant ; la documentation la décrit comme ne nécessitant « pas d’investissement d’ingénierie majeur ». L’avantage est l’absence de refonte ; l’inconvénient est que vous ne contrôlez pas ce qu’elle fait à chaque étape, et ne pouvez guider que par la conception de la page.
Un plugin expose des actions telles que « rechercher un produit, créer un panier, préparer une commande, consulter l’historique des commandes » sous forme d’outils structurés, que votre back-end valide et exécute. Les avantages officiels cités sont la fiabilité (indépendance vis-à-vis de la mise en page), une connexion autorisée durable et une latence aller-retour plus faible ; il est recommandé aux équipes disposant de ressources d’ingénierie de le construire et de le publier (Build a plugin).
Ordre de mise en œuvre : si vous disposez déjà d’une API produit interne, commencez par l’organiser en capacité externe idempotente, authentifiable et dotée de codes d’erreur explicites, puis décidez s’il faut brancher un plugin ou laisser l’agent passer par le navigateur ; si vous n’avez pas encore d’API, commencez par rendre la page « cliquable, remplissable et à l’état explicite ». La documentation recommande également que la recherche de produits et le panier soient utilisables sans connexion, et que la connexion ne soit exigée qu’au moment où le client est prêt à acheter — il faut donc anticiper dès maintenant la logique de fusion entre panier invité et panier connecté.
VI. Panier et paiement : séparer les actions réversibles des actions irréversibles
Les actions réversibles (recherche, filtrage, consultation des spécifications, ajout au panier, modification de quantité, suppression de produit) doivent être aussi fluides que possible ; n’ajoutez pas de CAPTCHA, de slider ou de menus qui ne s’ouvrent qu’au survol pour bloquer les machines. Les actions irréversibles (confirmation du paiement, utilisation d’un coupon, soumission d’une adresse, création d’un abonnement) doivent conserver une confirmation humaine.
Creez un site vitrine et genere des leads en quelques minutes
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
La documentation indique qu’il n’existe pas encore, pour un propriétaire de site individuel, de fonction permettant de contrôler lui-même les actions que les utilisateurs peuvent exécuter ; mais pour tous les utilisateurs, toute action ayant des conséquences doit passer par une validation humaine (Agent access). Sur le plan technique, faire trois choses :
- Gérer l’état du panier côté serveur, et non uniquement dans le stockage local du navigateur, sinon le panier est perdu dès qu’une session change.
- Les actions clés doivent renvoyer un résultat explicite : succès, stock insuffisant, dépassement de la limite d’achat, connexion requise, plutôt qu’un chargement sans fin.
- Mettre en place une page de confirmation explicite avant le paiement, affichant le produit, le montant, l’adresse et la date de livraison estimée, pour faire de la « confirmation humaine » une étape du processus et non une option.
VII. Paiement, gestion des risques et accessibilité
Bonne nouvelle côté paiement : ChatGPT Wallet est utilisable immédiatement avec les pages de paiement et formulaires de paiement existants, sans intégration spécifique (Accept payments).
Le côté gestion des risques est plus fragile. Les modèles antifraude s’appuient sur l’IP, l’empreinte du navigateur et les traces comportementales ; le navigateur cloud ne « ressemble » naturellement pas à un humain et peut donc être mal évalué. OpenAI transmet des signaux côté utilisateur via l’en-tête Forwarded, pouvant inclure asn, for, ip-country, ip-prefix, locale, tz, user-agent, pour la conformité géographique, l’affichage localisé et le scoring de risque ; ceux qui utilisent un prestataire de gestion des risques tiers doivent vérifier que celui-ci sait consommer ces signaux (Accept payments).
L’autorisation et la confidentialité comportent trois contraintes strictes : l’utilisateur n’autorise que la transaction en cours, et les identifiants de paiement ne doivent pas être conservés pour un usage ultérieur ; le marchand reçoit un jeton réseau et non le numéro de carte complet, et doit associer le compte sous-jacent via une référence de compte de paiement (PAR) ; dans le cas d’un abonnement, il faut obtenir le consentement explicite de l’utilisateur au prélèvement périodique, sous réserve que le paiement existant prenne en charge les débits récurrents.
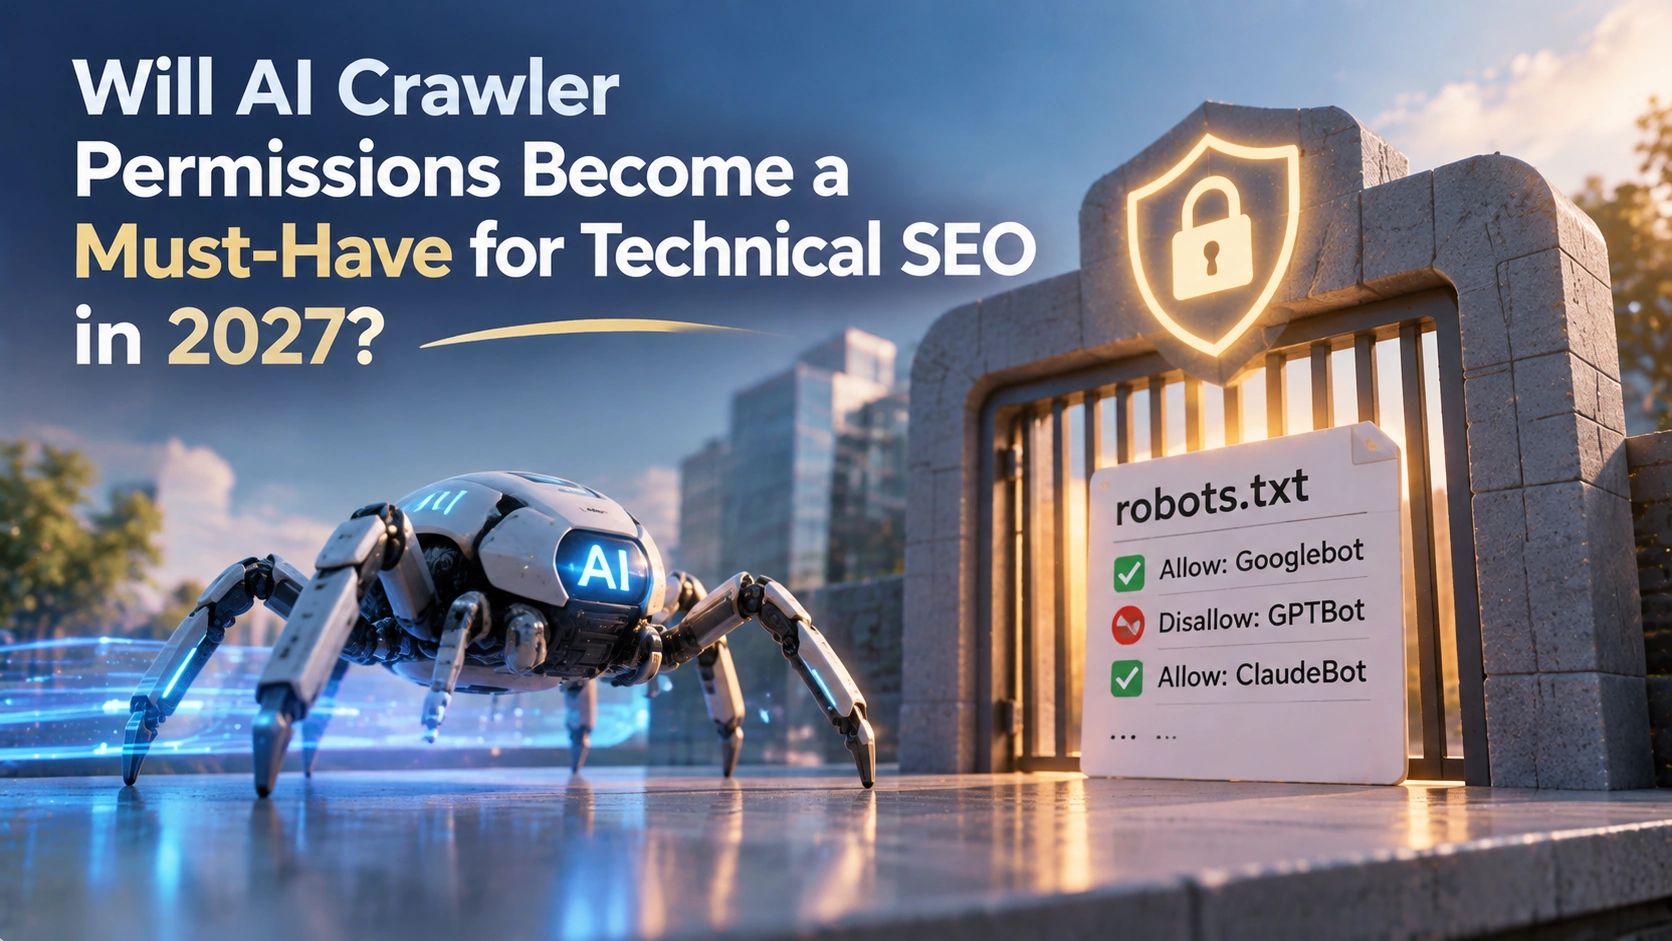
L’accessibilité est tout aussi essentielle. Le navigateur cloud peut accéder à votre site sans ajout à une liste blanche, mais les politiques anti-robots du CDN et du WAF peuvent causer des blocages accidentels ; la bonne pratique consiste à configurer une autorisation pour les accès vérifiés plutôt qu’à désactiver entièrement la protection (cloud browser access). La vérification repose sur Web Bot Auth : les requêtes portent les en-têtes Signature, Signature-Input et Signature-Agent, et la source peut être vérifiée selon la RFC 9421 à l’aide de la clé publique figurant dans un répertoire public (Agent access).
VIII. Différences entre achat traditionnel et achat par agent
| Étape | Achat traditionnel | Achat par agent | Ce que le site indépendant doit préparer |
|---|---|---|---|
| Expression du besoin | L’utilisateur saisit lui-même des mots-clés | L’utilisateur décrit son besoin et ses contraintes | Le titre couvre les véritables scénarios d’usage |
| Comparaison des produits | L’utilisateur ouvre les pages une à une | L’IA aide à comparer les paramètres et les prix | Spécifications en champs, alignables entre produits |
| Confirmation du stock | L’utilisateur regarde lui-même l’étiquette de stock | L’agent peut interroger le stock | État du stock explicite et lisible en temps réel |
| Ajout au panier | L’utilisateur clique manuellement | L’agent agit via les interfaces prises en charge | Panier côté serveur, opérations idempotentes |
| Paiement | L’utilisateur effectue lui-même le paiement | L’agent peut faciliter l’autorisation d’achat | Page de confirmation explicite, accès légitime autorisé |
| Service après-vente | L’utilisateur contacte lui-même le service client | Le marchand reste responsable de l’exécution | Texte des politiques lisible, frontières de responsabilité claires |
IX. Préparations possibles dès maintenant : liste par étapes
Cette semaine : prélevez les 20 SKU les plus vendus et vérifiez que le prix, la devise, le stock, la livraison et les informations de retour figurent dans la couche texte HTML ; vérifiez les politiques anti-robots du CDN et du WAF, et assurez-vous que les accès d’assistants vérifiés ne sont pas bloqués en même temps.
Dans le mois : unifiez les conventions de champs produit, y compris les règles de titre, la nomenclature des spécifications, la devise et le traitement fiscal, le vocabulaire des états de stock, et garantissez que item_id reste stable ; organisez la recherche produit, la vérification du stock et les opérations de panier en capacités serveur idempotentes et authentifiables.
Dans le trimestre : décidez par catégorie s’il faut créer et maintenir un flux produit, et validez la boucle téléversement, vérification, mise à jour ; mettez à jour les règles de gestion des risques pour lire les signaux utilisateur dans l’en-tête Forwarded et distinguer les comportements légitimes de proxy d’assistant des automatisations malveillantes.
X. Base technique : les sites capables de modifier le code résistent mieux au changement
Les exigences de l’achat par agent évolueront de façon répétée — aujourd’hui un flux, demain un plugin, après-demain de nouveaux signaux de risque. Si le site est enfermé dans un modèle dont on ne peut pas toucher le code source, chaque ajustement doit attendre que l’écosystème des plugins suive, et le rythme devient subi.
C’est aussi pourquoi certaines équipes choisissent un mode de création de site doté de capacités de génération de code full-stack. Avec we0, par exemple, son site e-commerce indépendant réunit la présentation des produits, la sélection des spécifications, le panier, le paiement, les commandes et les membres dans un même back-office, tout en fournissant la génération de code full-stack, le back-office CMS, l’optimisation SEO et GEO, le déploiement de domaine, etc. (we0.ai). Pour les équipes qui se préparent à accueillir le trafic des agents, la valeur ne réside pas dans la « rapidité de génération », mais dans le fait que la structure des données produit, le processus de paiement et les politiques d’accès peuvent être modifiés selon leurs propres règles métier — la liste ci-dessus consiste essentiellement en ajustements de la structure du site et des interfaces.
Questions fréquentes
Les agents IA remplaceront-ils complètement le commerce en ligne traditionnel ?
À court terme, non ; il s’agira plutôt d’une stratification : les produits aux paramètres clairs et au degré de standardisation élevé seront largement achetés par des assistants, tandis que les achats nécessitant expérience et jugement émotionnel resteront dominés par l’humain. Le changement réel perçu par les commerçants est que « le seuil pour entrer dans la sélection » a augmenté.
Pour un petit site sans équipe technique, quelle est la première chose à faire ?
Commencez par rédiger clairement les informations de la page produit et les placer dans le HTML. Si le prix, la devise, l’état du stock, le délai de livraison et les règles de retour peuvent être lus directement, la majeure partie du problème de découvrabilité est déjà résolue ; cette étape ne nécessite pas de ressources de développement.
Sans flux produit, est-on certain de ne pas être recommandé ?
Pas nécessairement. Le navigateur cloud peut accéder au site comme un humain ; la documentation officielle indique que les commerçants n’ont pas besoin de créer d’abord un flux, et que les utilisateurs ChatGPT vérifiés peuvent également parcourir leur site via le navigateur (Agent access). Le flux améliore la précision de correspondance au niveau du catalogue ; la qualité de la page détermine la fluidité de l’étape de confirmation.
Outils associés
- Auto-vérification du code source : utilisez
curlpour récupérer le code source de la page produit et vérifier que les champs de prix et de stock apparaissent dans le HTML. - Outil de validation des données structurées : vérifiez la cohérence entre le balisage schema.org Product et le contenu de la page.
- Panneau de politiques anti-robots WAF/CDN : autorisez les accès d’assistants vérifiés tout en conservant les autres règles de protection.
- Rendu côté serveur et back-office CMS : faites apparaître les informations produit dans le HTML du premier écran, plutôt que de dépendre de scripts front-end.
Liens associés
- Partner Playbook : le parcours commerce dans ChatGPT
- Submit product feeds : champs, modes de livraison et limites des flux
- Help ensure cloud browser access : vérifier si le CDN ou le pare-feu bloque à tort
- Agent access : autoriser les accès vérifiés et la validation Web Bot Auth
- Accept payments : paiement, tokenisation et transmission des signaux de risque
- Build a plugin : exposer les actions de recherche, panier et paiement via des outils structurés
- we0.ai : site e-commerce indépendant et flux de travail de la création de site à l’acquisition
Résumé
Le premier changement réel apporté par les agents IA n’est pas la « manière d’acheter », mais la « manière d’être lu » : les informations produit doivent être structurées, les prix et les stocks doivent pouvoir être confirmés en temps réel, l’accès au site ne doit pas être bloqué à tort par les politiques de sécurité, et le paiement et l’autorisation doivent laisser une place à une confirmation humaine. La différence entre l’achat traditionnel et l’achat par agent peut se résumer en une phrase : auparavant, l’utilisateur cherchait des réponses sur votre page ; désormais, l’assistant pose des questions à votre système à la place de l’utilisateur.
Les entreprises n’ont pas besoin de refaire leur site en une seule fois, mais elles doivent accomplir trois choses dans l’ordre : rendre les pages lisibles, rendre les interfaces utilisables, rendre les règles de risque identifiables. Une fois cette base en place, quel que soit le prochain assistant ou protocole qui deviendra dominant, le site indépendant n’aura pas à repartir de zéro.