La logique d’une page FAQ classique est celle de « l’humain qui cherche la réponse » : l’utilisateur décide lui-même quel élément ouvrir, lit le paragraphe entier, puis le compare à sa situation. Or les questions que reçoit réellement une entreprise sont souvent des formulations composites du type « notre version prend-elle en charge le déploiement privé, car les données ne peuvent pas sortir du réseau interne ? » ; la FAQ ne contient qu’une ligne « prise en charge du déploiement privé », et l’utilisateur reste incertain après lecture.
La différence du service client IA tient à ce que la réponse est organisée en direct en fonction de la question. Il utilise le contenu du site officiel, la documentation produit et la liste des FAQ comme base de connaissances ; lorsque l’utilisateur pose une question, il commence par rechercher les informations pertinentes, puis un grand modèle organise une réponse qui répond directement à la question (documentation AI Customer Service d’Alibaba Cloud). Pour les scénarios à forte fréquence et répétitifs comme les demandes avant-vente, le guidage fonctionnel ou l’information sur le site web, cette différence détermine si l’utilisateur continue à lire ou ferme directement la page pour interroger un concurrent.
Il ne s’agit donc pas de livrer une fenêtre de chat, mais un actif de connaissances qui puisse être retrouvé et suffisamment précis. Le style de la fenêtre est la dernière étape ; les deux premières déterminent son utilité réelle.
L’ossature technique pour que le service client IA « comprenne vos produits » : le RAG
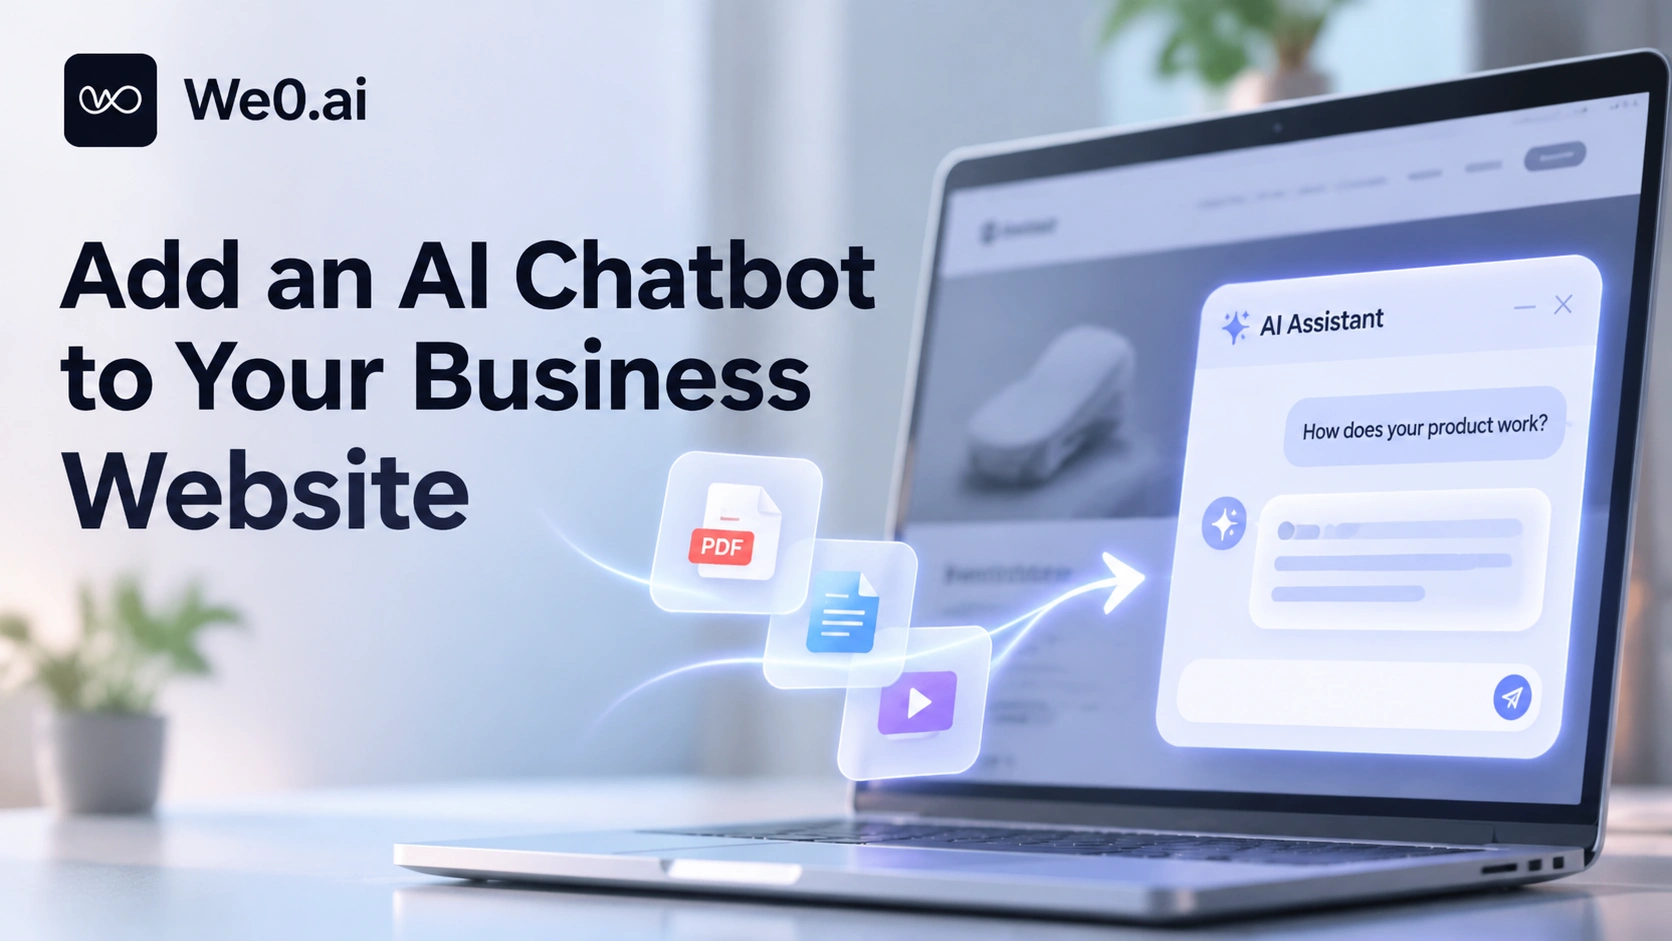
Pour qu’un chatbot réponde à partir des documents de l’entreprise, l’approche dominante est la génération augmentée par récupération (RAG). Son principe n’est pas de faire « mémoriser » vos produits au modèle, mais de rechercher d’abord dans la base de connaissances les extraits pertinents avant chaque réponse, puis de rédiger la réponse à partir de ces extraits. La documentation RAG Studio de Cloudera décrit ce type de système ainsi : le chatbot accède à une base de connaissances, récupère le contenu lié à la question de l’utilisateur, puis génère une réponse adaptée à cette question (cas d’usage RAG Studio).
Une chaîne minimale exploitable comporte cinq étapes :
- Découpage : diviser manuels, clauses, pages produit en petits blocs interrogeables ;
- Indexation : créer un index vectoriel ou par mots-clés pour chaque bloc ;
- Récupération : lorsqu’un utilisateur pose une question, remonter les blocs les plus pertinents ;
- Génération : transmettre le contenu récupéré avec la question de l’utilisateur au modèle pour qu’il organise la réponse ;
- Citation : afficher la source à côté de la réponse pour que l’utilisateur puisse cliquer et vérifier.
L’étape 5 est souvent négligée, mais elle résout deux problèmes à la fois : la confiance de l’utilisateur et votre capacité à retracer ensuite « de quel document provient cette phrase ». Après une mise à jour des documents, le modèle n’a pas besoin d’être réentraîné : il suffit de modifier la base de connaissances. C’est aussi pourquoi le RAG est plus adapté que le fine-tuning lorsque la documentation produit évolue fréquemment.
Première étape : inventorier les sources de connaissances et distinguer ce qui doit entrer dans la base
Avant l’intégration, étalez les documents et classez-les. Tout contenu n’est pas nécessairement adapté à une ingestion directe, et tout contenu ne doit pas être rendu public.
| Source de connaissances | Contenu adapté | Points d’attention lors de l’intégration |
|---|---|---|
| Pages du site web | Présentation produit, pages fonctionnelles, page tarifs, articles du centre d’aide | Peut être capturé automatiquement, mais assurez-vous que les pages en ligne sont bien la version la plus récente |
| Documents PDF / Word | Manuels produit, fiches techniques, documentation d’interface, conditions de service | Les documents numérisés doivent d’abord faire l’objet d’une reconnaissance de texte, sinon ils ne seront pas retrouvés |
| FAQ standard | Politiques, délais, retours, facturation, processus après-vente | Priorité de correspondance la plus élevée, réponses les plus maîtrisées |
| Documents internes | Règles de tarification, SOP commerciales, manuels de traitement des incidents | Soumis à des permissions ; ne pas les mélanger avec les connaissances publiques dans la même portée de recherche |
Une erreur fréquente consiste à téléverser tous les documents sans distinction : le modèle retrouve alors trois fiches techniques de périodes différentes et les réponses se contredisent. Commencer par dédupliquer et consolider les versions est bien plus efficace que de peaufiner les prompts.
Deuxième étape : construire la base de connaissances et la rendre interrogeable
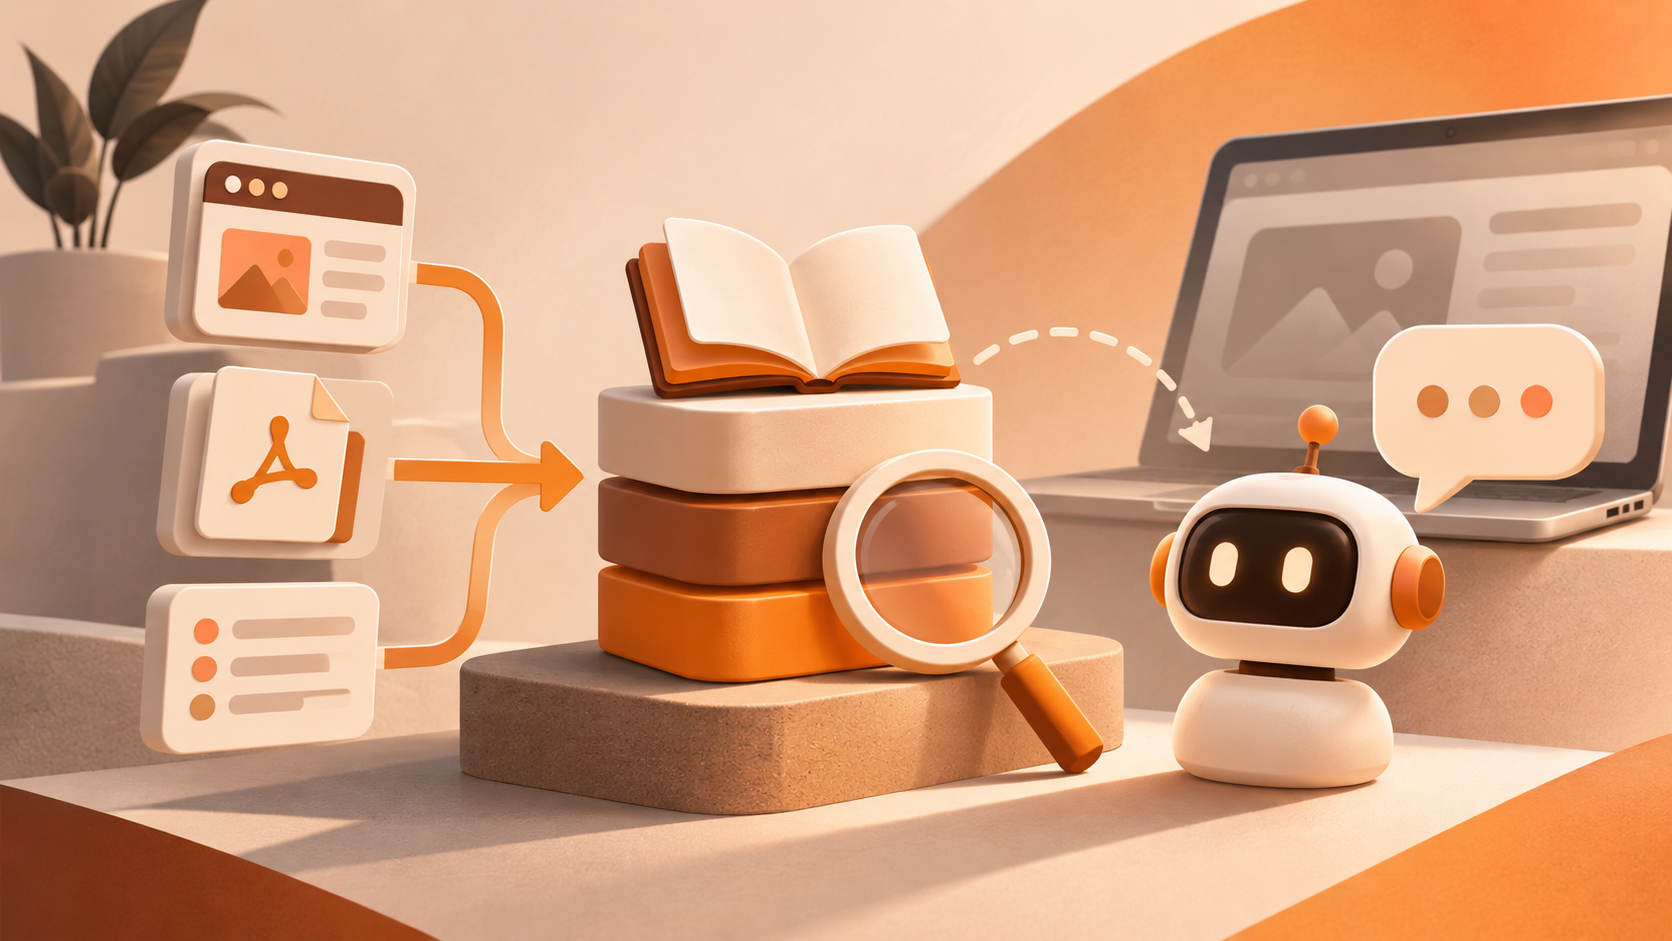
La construction de la base de connaissances se fait généralement selon trois modalités : import de site web, téléversement de fichiers et saisie de FAQ. Dans l’implémentation du service client IA d’Alibaba Cloud, par exemple, après activation du service, le système analyse automatiquement le contenu public du site web pour constituer la base de connaissances initiale ; la durée de capture dépend du volume de contenu du site. Le téléversement de fichiers prend en charge six formats : pdf, doc, docx, txt, markdown et excel. Les FAQ servent à saisir des paires de questions-réponses standard ; lorsque la question de l’utilisateur correspond simultanément à plusieurs sources de connaissances, le système privilégie la réponse standard de la FAQ (documentation AI Customer Service d’Alibaba Cloud).
Au niveau opérationnel, plusieurs actions méritent d’être formalisées comme processus :
- après l’import du site, parcourir la liste des pages capturées et supprimer les pages d’événements expirées et les pages brouillon ;
- lors d’une mise à jour de contenu, cliquer manuellement une fois sur la nouvelle capture, ou activer une synchronisation automatique planifiée, pour éviter que la base de connaissances reste bloquée trois mois en arrière ;
- rédiger en FAQ les dix groupes de questions les plus susceptibles d’être mal répondues, afin que les réponses standard encadrent l’espace d’improvisation du modèle ;
- attribuer un responsable à chaque entrée de connaissance, sinon personne n’osera supprimer un ancien document six mois plus tard.
Troisième étape : installer la fenêtre de service client sur le site web
Une fois la base de connaissances opérationnelle, vient la configuration périphérique. Les champs comme la couleur de la fenêtre, le nom du service, la présentation du service et les questions d’ouverture semblent décoratifs, mais ils influencent en réalité la qualité du premier échange : si la présentation du service indique clairement les limites de ses capacités, l’utilisateur ne posera pas de questions hors périmètre comme « rédige-moi un contrat » ; les questions d’ouverture fournissent des entrées à forte fréquence et réduisent nettement le coût d’hésitation de la première phrase de l’utilisateur (documentation AI Customer Service d’Alibaba Cloud).
Il existe aussi un paramètre facile à oublier : les coordonnées. Lorsque l’IA ne peut pas résoudre le problème de l’utilisateur, l’interface doit proposer un téléphone, un e-mail ou un autre canal de substitution ; sinon, après avoir été bloqué par un « je ne sais pas », l’utilisateur part réellement.
Si le site web dispose déjà d’un système de connexion, séparer les connaissances publiques des connaissances visibles après connexion revient à définir deux périmètres de connaissances distincts. Pour faciliter cette stratification, le site sous-jacent a intérêt à disposer de capacités de compte — par exemple, les capacités de site de we0 incluent un système de comptes de base avec vérification par e-mail, connexion Google et GitHub, ainsi qu’un back-office CMS allant de la gestion des utilisateurs à la maintenance du contenu (vue d’ensemble des fonctionnalités we0) ; ce type de socle évite d’assembler soi-même l’authentification et la maintenance du contenu.
Comment éviter que l’IA invente des informations produit inexistantes
C’est le risque le plus concret du processus d’intégration : un client demande « prenez-vous en charge le SSO SAML ? » et le modèle, pour maintenir la conversation, risque fort de répondre « oui » de manière plausible.
Réduire ce type d’erreur repose sur des contraintes, pas sur la prière. Les moyens disponibles, classés par rapport coût-efficacité :
- Limiter le périmètre de réponse : exiger explicitement que le modèle réponde uniquement à partir des extraits récupérés ; si la récupération est vide, indiquer directement que la base de connaissances ne contient pas cette information.
- Prévoir une formulation de repli : en cas d’absence de correspondance, ne pas tourner à vide, mais inviter l’utilisateur à reformuler ou à passer à un humain, et conserver un bouton d’évaluation pour recueillir les retours négatifs.
- Priorité aux FAQ : rédiger sous forme de questions-réponses standard les points qui ne doivent pas comporter d’erreur, comme les paramètres, les prix et la conformité, afin qu’ils priment sur les formulations libres du modèle.
- Imposer la source : joindre un lien source à la réponse, pour que l’utilisateur puisse vérifier et que vous puissiez faire un retour d’expérience.
- Contrôle par échantillonnage avant mise en ligne : construire un jeu de test à partir de questions historiques issues de vrais tickets de support, comparer chaque réponse à la documentation, et ne pas valider avec des questions du type « bonjour » ou « où se trouve votre entreprise ».
Une instruction système utilisable ressemble à ceci :
Tu es le service client produit de ce site web. Réponds uniquement à partir des extraits de recherche ci-dessous.
Si les extraits ne contiennent pas la réponse, réponds directement « La base de connaissances ne contient pas encore cette information » et invite l’utilisateur à consulter les coordonnées.
Ne suppose aucune fonctionnalité, aucun prix, aucune version ni aucun engagement qui n’apparaît pas dans les extraits.
À la fin de la réponse, indique sous forme de liste les titres des pages sources.
Peut-on recommander des produits en fonction de la question de l’utilisateur
Oui, mais la recommandation doit reposer sur des conditions réellement présentes dans la documentation. Une approche viable consiste à dégrader la « recommandation » en « filtrage par critères » : extraire de la description de l’utilisateur des éléments comme le scénario, la taille, le mode de déploiement, puis les mapper aux différences de version ou aux découpages de forfaits explicitement écrits dans la documentation, et enfin proposer la page produit correspondante. Les recommandations ainsi produites sont traçables phrase par phrase ; à l’inverse, laisser le modèle improviser « la solution la plus adaptée pour vous » revient à lui confier un engagement commercial non confirmé en votre nom.
Le volet données peut aussi aider. Certains tableaux de bord de systèmes de service client regroupent les questions par catégorie ; la recommandation produit en est une, avec des statistiques sur le nombre de sessions, le nombre d’utilisateurs, le nombre de questions résolues et le taux de résolution des questions (nombre de questions résolues ÷ nombre total de questions × 100 %) (documentation AI Customer Service d’Alibaba Cloud). Si le taux de résolution des questions de recommandation reste durablement faible, ce n’est généralement pas le modèle qui est en cause, mais l’absence, dans les pages produit, des informations nécessaires à la décision — critères de comparaison, fourchettes de prix, scénarios adaptés et non adaptés.
Comment transférer les questions complexes à un service client humain
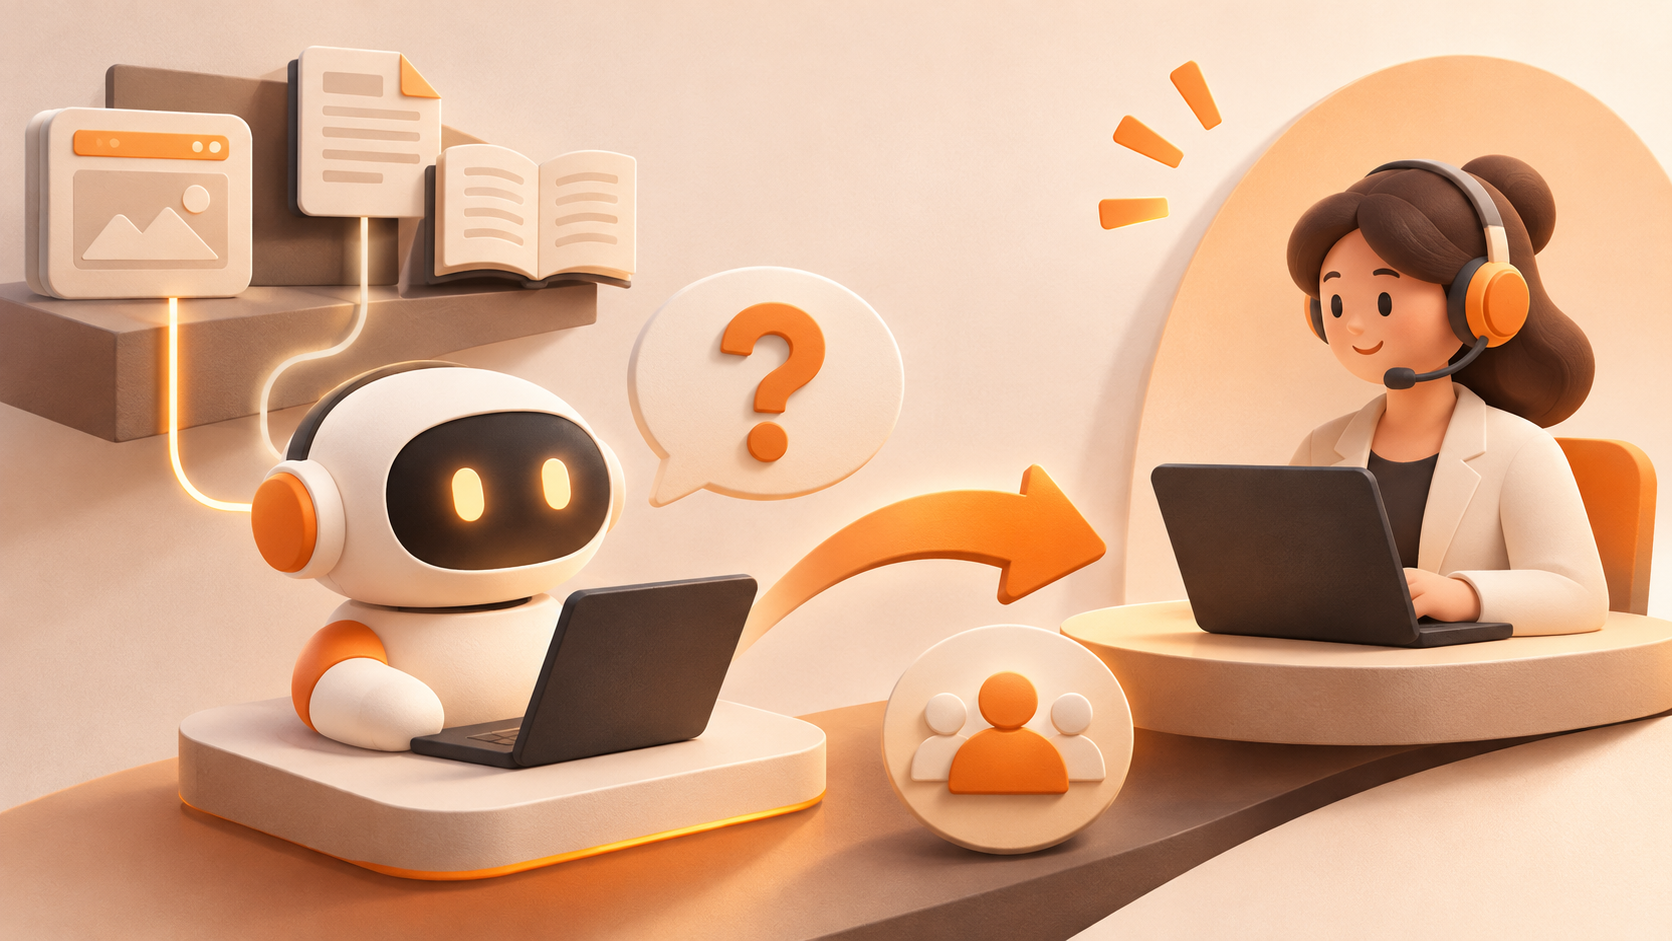
La valeur du service client IA n’est pas de tenir les gens à distance, mais d’absorber les questions simples et de transmettre les questions complexes avec leur contexte. Il est recommandé de rédiger sous forme de liste les conditions de transfert à un humain, afin d’éviter le « cela dépend » :
Creez un site vitrine et genere des leads en quelques minutes
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
- le sujet correspond à des mots-clés à forte valeur ou à haut risque : devis, clauses contractuelles, développement sur mesure, incidents et sécurité des données, réclamations ;
- deux échanges consécutifs sans résolution, ou demande explicite d’un humain par l’utilisateur ;
- émotion de l’utilisateur manifestement négative, avec expression claire d’insatisfaction ;
- taux de correspondance dans la base de connaissances vide et question portant sur des éléments nécessitant un accès au back-office, comme le compte ou les commandes.
Lors du transfert, transmettez à l’humain le résumé de la conversation, les sources déjà récupérées et la page où se trouve l’utilisateur, afin que le client n’ait pas à tout répéter depuis le début. Cette étape n’est pas techniquement très difficile, mais c’est celle où l’écart d’expérience est le plus grand — beaucoup d’entreprises déploient un service client IA mais transforment le transfert à un humain en « veuillez redécrire votre problème ».
Enregistrer les conversations pour en faire une base de mise à jour de la base de connaissances
Les conversations du service client sont l’étude de besoins la moins chère. Le système conserve généralement l’historique des sessions, avec la question de l’utilisateur, la réponse de l’IA et la source de connaissances sur laquelle repose cette réponse, et permet de filtrer par statut (par exemple répondu, partiellement répondu) (documentation AI Customer Service d’Alibaba Cloud). En consacrant vingt minutes par semaine à parcourir ces données, on obtient trois types de signaux :
- questions récurrentes mal répondues : il manque une entrée dans la base de connaissances, ajouter une FAQ ;
- questions dont la réponse est vague : la documentation est trop abstraite, il faut ajouter des paramètres concrets ou des exemples ;
- questions posées spontanément par les clients mais non anticipées : signal de besoin avant-vente, à remonter au produit et au marketing.
Certains systèmes proposent une entrée « optimisation des questions » qui transforme en un clic les questions non résolues en nouvelles entrées de FAQ, en ajoutant simplement la réponse standard. Intégrer cela au processus de réunion hebdomadaire permet à la base de connaissances de grandir d’elle-même.
Après la mise en ligne : rythme de mise à jour de la base de connaissances et responsables
Si le service client IA commence à répondre faux trois mois après la mise en ligne, c’est presque toujours parce que personne ne gère la base de connaissances. Il est recommandé de la maintenir selon un rythme fixe :
- Chaque semaine : nettoyer la liste des questions non résolues, ajouter 3 à 5 FAQ ;
- Chaque mois : vérifier la cohérence entre la page tarifs, la page des forfaits et la documentation, retirer les contenus d’événements expirés ;
- À chaque version : mettre à jour le jour même la documentation fonctionnelle et le journal des modifications, pour que l’IA ne devienne pas la porte-parole d’une ancienne version ;
- Chaque trimestre : prélever 30 conversations réelles, relancer le jeu de test et consigner l’évolution du taux de résolution.
Le responsable n’est pas nécessairement le responsable du service client, mais ce doit être une personne, pas « l’équipe ». Une gestion à plusieurs équivaut à une absence de responsabilité.
Exemple de chaîne complète pour une entreprise SaaS
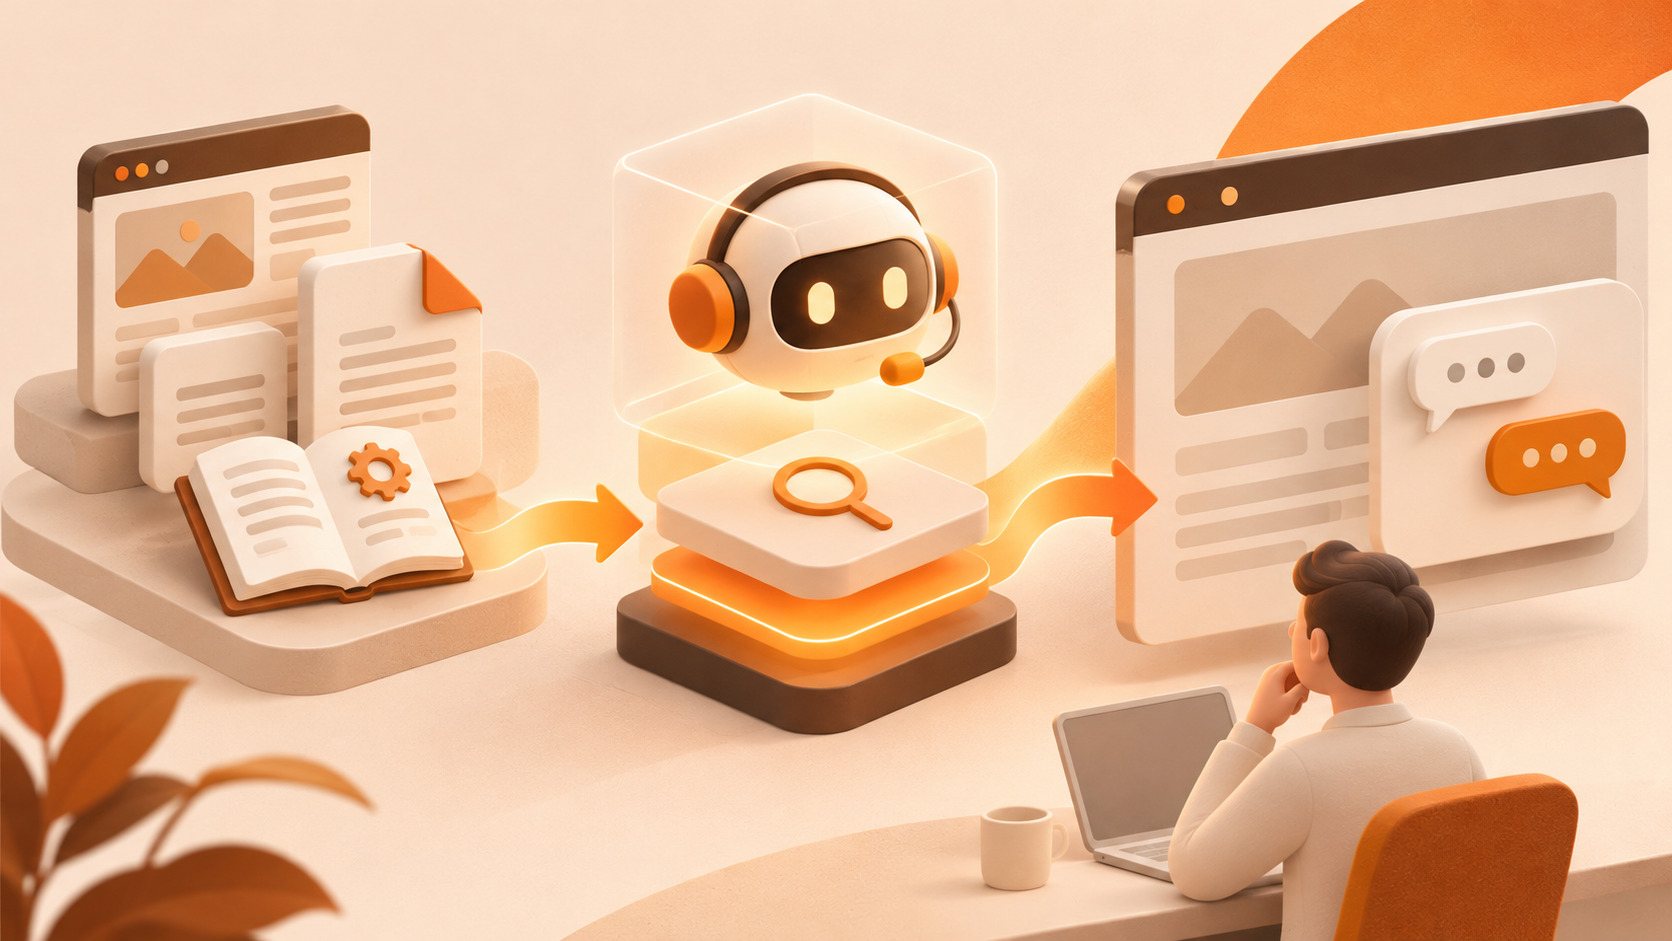
Imaginons une entreprise SaaS qui édite un tableau de bord de données et vient de mettre en ligne son nouveau site web. Son produit existe en trois formes : version gratuite, version équipe et déploiement privé ; la documentation est dispersée entre le centre d’aide et un manuel PDF.
- Question de l’utilisateur : un visiteur saisit dans la fenêtre en bas à droite de la page tarifs : « Notre équipe d’analyse compte 80 personnes, les données ne peuvent pas sortir du réseau interne, comment facturez-vous ? »
- Récupération : le système remonte le contenu pertinent dans le centre d’aide, la description du déploiement privé et le manuel de tarification PDF.
- Organisation de la réponse : il répond d’abord sur la capacité de la forme de déploiement à satisfaire l’exigence « les données ne sortent pas du réseau interne », puis explique les dimensions de tarification de la solution privée, avec un ton mesuré, sans promettre de montant précis.
- Fourniture des pages associées : il joint la page de description du déploiement privé et l’entrée pour contacter les ventes.
- Transfert à un humain en cas de non-résolution : l’utilisateur pose ensuite des questions sur les clauses contractuelles et le délai de mise en œuvre ; des mots-clés à haut risque sont détectés, le transfert à un humain se fait directement avec le résumé de la conversation.
- Capitalisation : cette question entre dans la liste des questions non résolues ; l’équipe opérationnelle ajoute une FAQ « Comment est calculée la tarification du déploiement privé ? ».
Dans toute cette chaîne, l’IA n’a pas « deviné » : chaque étape peut être rattachée à un document.
Ce que we0 peut assumer dans cette chaîne, et ce qui doit être développé en interne
Si le site web de l’entreprise est encore en cours de construction, il est plus économique de planifier la capacité de service client en même temps. we0 se positionne comme un ensemble de capacités de site web destiné à une livraison formelle ; sa liste officielle de capacités inclut l’intégration de capacités IA (génération de texte, d’images, de vidéos, d’audio, etc., adaptée à l’extension vers des produits conversationnels), le CMS et le back-office d’administration, le système d’authentification, l’organisation multilingue et la mise en ligne ; les scénarios d’usage mentionnent explicitement les applications de type service client intelligent et base de connaissances (vue d’ensemble des fonctionnalités we0).
Il faut préciser les limites : ce sont des capacités de socle pour la création de sites et l’intégration d’IA, et non un service client avec base de connaissances d’entreprise prêt à l’emploi. Le découpage et l’indexation des documents, la stratégie de récupération, le filtrage des connaissances selon les permissions utilisateur, le transfert vers un service client humain et l’interconnexion avec les tickets nécessitent généralement encore un développement propre à partir de sa capacité de génération de code full-stack, ou l’intégration de systèmes tiers de RAG et de service client. Lors de l’évaluation, traitez « pouvoir générer un site web » et « pouvoir exploiter un service client avec base de connaissances » comme deux sujets distincts, afin d’éviter de découvrir après la mise en ligne qu’il manque la moitié de la chaîne.
Conformité et périmètre des contenus : quels documents ne pas capturer
Plus les sources de connaissances sont larges, plus il faut prêter attention à la manière dont les contenus entrent. N’importez que des contenus publics, capturables et dont vous êtes propriétaire, ainsi que des documents autorisés ; ne contournez pas les paywalls, les restrictions de connexion ou les mécanismes anti-scraping pour obtenir des contenus tiers. Un avis d’avocat général de la Cour de justice de l’Union européenne donne une référence en la matière : un chatbot qui recherche et réutilise en temps réel des contenus de presse dans ses réponses peut porter atteinte aux droits des éditeurs lorsque les contenus ont été obtenus illégalement ou que la formulation de la réponse peut se substituer à l’article original ; en revanche, un résumé factuel dans ses propres mots avec un lien vers l’original présente un risque nettement plus faible (analyse de l’affaire).
Pour le service client d’un site d’entreprise, ce principe se traduit simplement : la base de connaissances contient des documents propres et des contenus autorisés ; les réponses privilégient les résumés et les sources, sans reproduire intégralement le contenu d’autrui.
Questions fréquentes
Le service client IA peut-il lire directement des PDF et des Word ?
Oui. Dans les plateformes courantes de création de sites et de service client, le téléversement de fichiers prend en charge des formats comme pdf, doc, docx, txt, markdown et excel ; après le téléversement, un processus d’analyse est lancé et, une fois l’analyse réussie, le fichier peut participer à la récupération (documentation AI Customer Service d’Alibaba Cloud). Les PDF numérisés doivent d’abord être convertis en texte interrogeable.
Les prix dans la base de connaissances changent souvent ; comment garantir des réponses exactes ?
Les informations à forte fréquence de changement, comme les prix et les forfaits, doivent être transformées en réponses standard FAQ distinctes et faire l’objet d’une vérification mensuelle ; ne dispersez pas les prix dans plusieurs PDF, sinon le modèle récupérera différentes versions.
Le service client IA risque-t-il de divulguer des documents internes aux clients ?
Cela dépend de la manière dont le périmètre de connaissances est délimité. Les connaissances publiques et les documents internes doivent être placés dans des ensembles de connaissances différents ; les documents internes ne doivent être ouverts qu’à des rôles spécifiques connectés, et non reposer sur un prompt demandant au modèle de « ne pas les révéler ».
Faut-il joindre des liens sources aux réponses ?
C’est recommandé. Cela améliore la crédibilité et vous permet, lors du retour d’expérience, de confirmer sur quelle version du document la réponse s’appuie.
Combien de temps faut-il pour la mise en ligne ?
L’essentiel du temps est consacré à la préparation des documents et au contrôle par échantillonnage du jeu de test, plutôt qu’à l’intégration technique. Il est plus réaliste de mettre en ligne d’abord une version couvrant 70 % des cas, puis d’ajouter des FAQ chaque semaine, que de viser une couverture totale dès le départ.
Outils associés
- Base de connaissances et console de service client : gérer l’import du site, le téléversement de fichiers, les FAQ et l’optimisation des questions
- CMS et back-office de contenu : maintenir les versions du centre d’aide, de la documentation produit et de la page tarifs
- Outils d’analyse du site : observer les clics et le parcours de conversion depuis l’entrée de conversation
- Système de tickets / IM : prendre en charge les conversations humaines transférées par l’IA et les résumés de conversation
- Services de RAG et de recherche vectorielle : à utiliser lors de la construction d’une couche de récupération interne
Liens associés
- Documentation AI Customer Service d’Alibaba Cloud
- Cas d’usage RAG Studio de Cloudera
- Vue d’ensemble des fonctionnalités we0
- Analyse de l’affaire sur les chatbots IA et le droit d’auteur des médias
Résumé
Pour intégrer un service client IA sur le site web d’une entreprise, le véritable travail d’ingénierie ne se situe pas dans la fenêtre de chat, mais dans la base de connaissances : commencez par inventorier les documents produit en trois catégories — pages web, documents, FAQ — et consolidez les versions, puis utilisez le RAG pour établir une chaîne « récupération—génération—citation » ; installer la fenêtre n’est que la dernière étape. Après la mise en ligne, maîtrisez le risque d’invention en limitant le périmètre de réponse, en donnant la priorité aux FAQ, en imposant les sources et en contrôlant par échantillonnage un jeu de test ; protégez les questions complexes avec une liste de transfert à un humain ; et faites grandir la base de connaissances en continu grâce à une liste hebdomadaire des questions non résolues. Faites de ces actions un rythme fixe avec des responsables désignés : c’est à cette condition que le service client IA réduira réellement les demandes répétitives, au lieu de formuler plus couramment des réponses erronées.