
OpenAI a présenté GPT-6 Astra le 3 septembre 2026, soit déjà le 4 septembre à Pékin. OpenAI le décrit comme son modèle le plus intelligent et le mieux aligné à ce jour, conçu pour les tâches complexes de bout en bout dans l’utilisation d’ordinateurs, la navigation web, le génie logiciel, la cybersécurité, les sciences et les workflows professionnels.
Cette présentation est importante, car Astra ne doit pas être compris comme un simple « chatbot de nouvelle génération ».
Les améliorations les plus visibles concernent les tâches dans lesquelles un modèle doit poursuivre son travail en plusieurs étapes : inspecter un environnement, utiliser des outils, réviser un plan, gérer les échecs, utiliser des logiciels et produire un résultat final plutôt qu’une réponse unique.
L’article original décrit cette évolution comme le début d’une « ère native des agents ». Cette formulation est utile pour comprendre la tendance, mais l’implémentation est plus nuancée que l’idée selon laquelle l’ensemble du framework agentique aurait été transféré dans les poids du modèle.
La documentation d’OpenAI décrit deux couches qui coopèrent :
- GPT-6 Astra, entraîné pour gérer des workflows longs et comportant plusieurs étapes, utiliser efficacement les outils, répartir le travail, déléguer à des sous-agents et rester cohérent lorsque les exigences évoluent.
- Le framework agentique, comme la couche d’orchestration utilisée par Codex et ChatGPT Work, qui relie le modèle aux outils, à l’environnement de l’utilisateur, à la gestion du contexte, aux autorisations et aux boucles d’exécution.
En d’autres termes, Astra est nettement plus orienté vers les agents, mais une application a toujours besoin d’un environnement d’exécution autour du modèle.
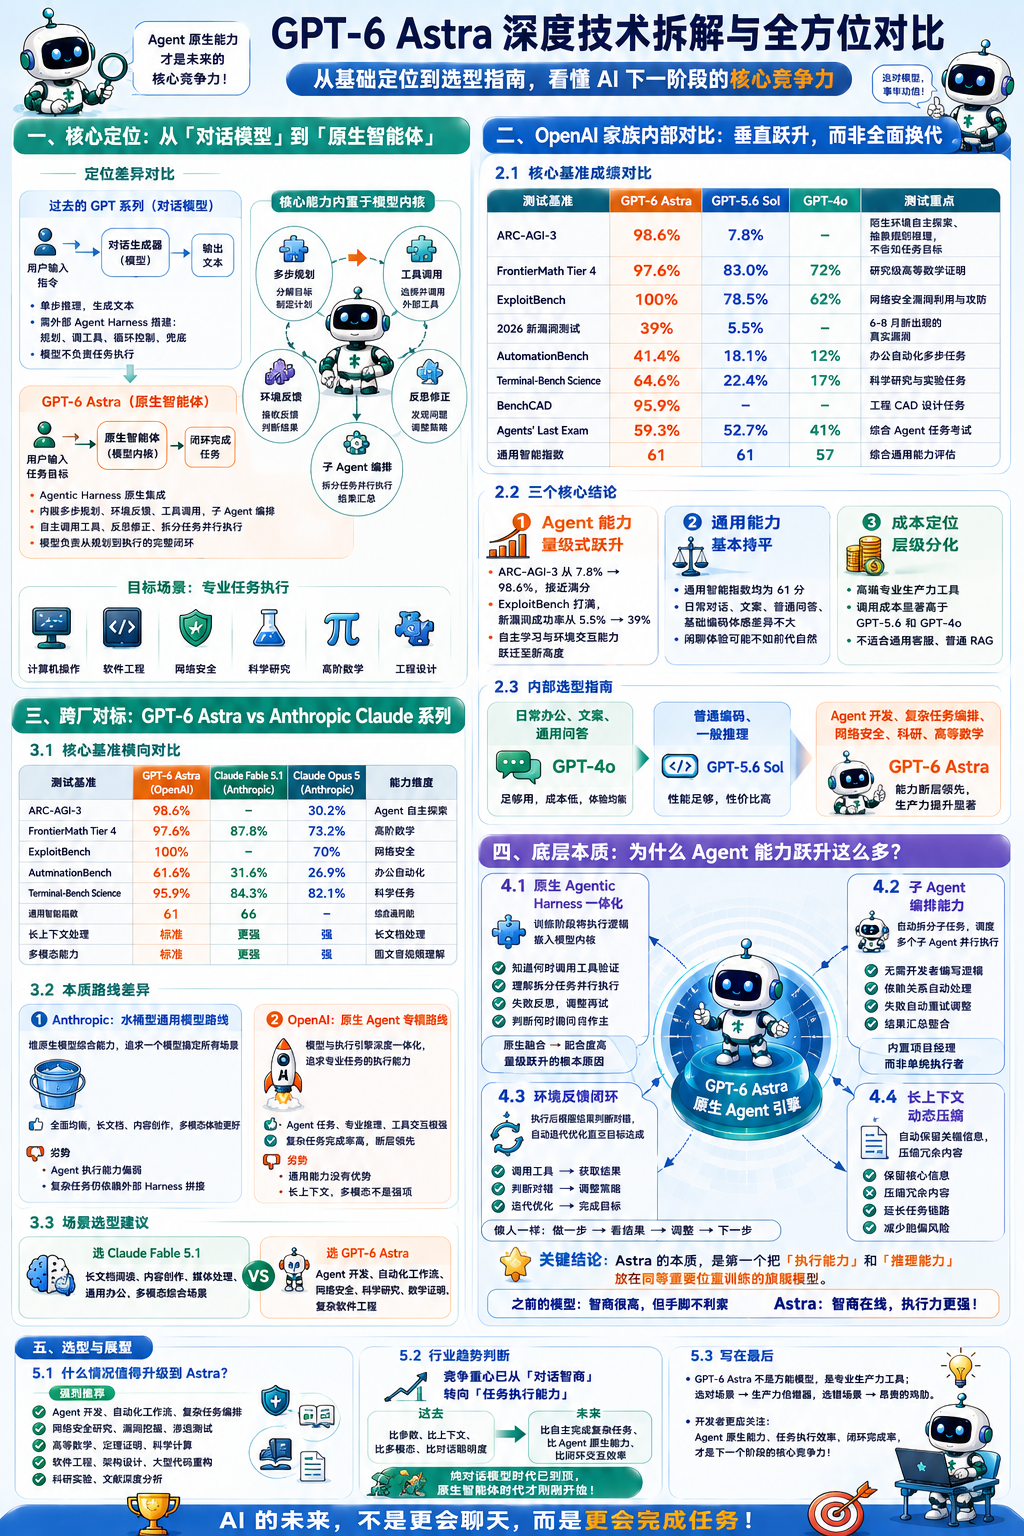
Cet article conserve la structure originale en cinq parties et examine Astra sous cinq angles :
- Son positionnement central.
- Sa comparaison au sein de la famille de modèles OpenAI.
- Sa comparaison avec Claude d’Anthropic.
- Les raisons techniques de cette progression dans les capacités agentiques.
- Les critères de sélection du modèle et ce que cette évolution signifie pour les développeurs.
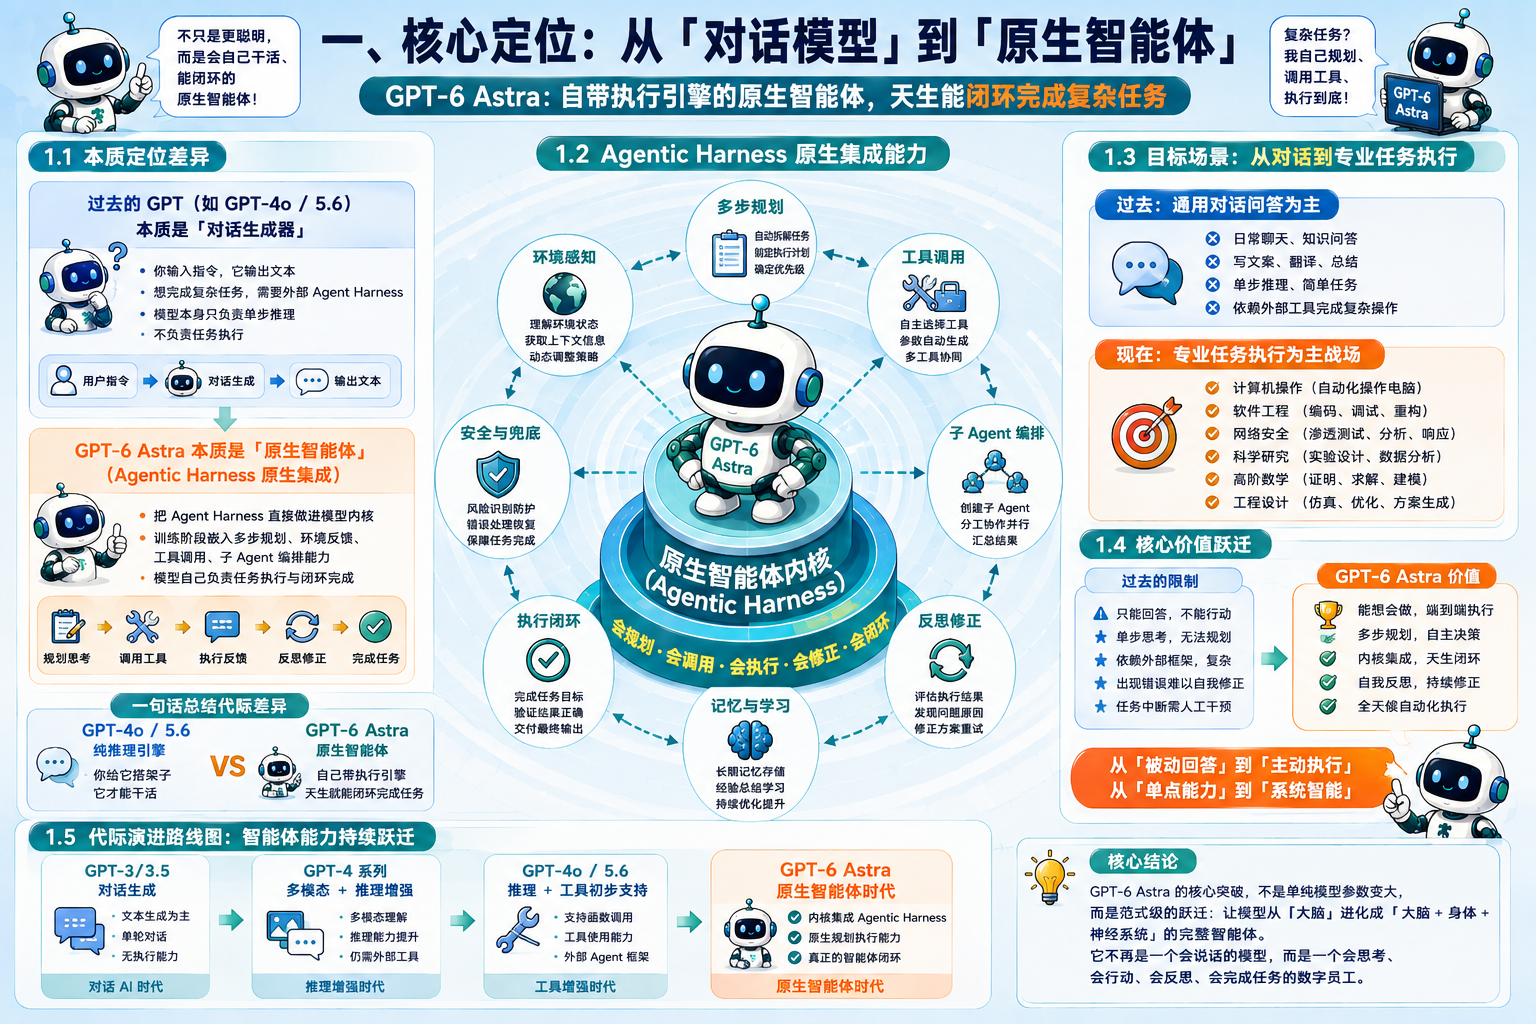
Avant d’examiner les chiffres des benchmarks, il est utile de distinguer le modèle de la pile produit qui l’entoure.
1.1 Les workflows GPT précédents nécessitaient généralement davantage d’orchestration externe
Un workflow classique basé sur un modèle de langage est facile à imaginer :
Demande de l’utilisateur
→ raisonnement du modèle
→ réponse du modèle
Pour un agent plus complexe, l’application qui l’entoure ajoute normalement une couche supplémentaire :
Objectif de l’utilisateur
→ framework agentique
→ modèle
→ appel d’outil
→ résultat de l’environnement
→ modèle
→ action suivante
→ résultat final
Ce framework externe détermine la manière dont les outils sont exposés, dont les résultats sont renvoyés, dont le contexte est conservé, dont les autorisations s’appliquent et le moment où la boucle doit s’arrêter.
OpenAI utilise toujours cette architecture. L’entreprise a d’ailleurs décrit séparément le framework agentique de Codex et ChatGPT Work comme une couche d’orchestration en Rust qui relie les modèles, les outils et l’environnement de l’utilisateur.
1.2 Ce qui a réellement changé avec GPT-6 Astra
Astra est entraîné plus profondément à adopter les comportements qui rendent le framework utile.
Les recommandations d’OpenAI concernant le modèle mettent en avant des capacités telles que :
- Maintenir des workflows complexes comportant plusieurs étapes dans le code, les navigateurs et les logiciels professionnels.
- Continuer à raisonner pendant l’exécution d’outils asynchrones.
- Accepter des directives en cours de tour sans abandonner le travail déjà effectué.
- Préserver le travail dans les conversations longues.
- Répartir le travail et déléguer à des sous-agents lorsque le framework fournit des outils de collaboration.
- Utiliser plus efficacement les outils d’interaction avec l’ordinateur.
- Rester plus proche des limites de la tâche et poser des questions ciblées lorsqu’une décision peut modifier sensiblement le résultat.
La différence est donc mieux décrite comme une co-conception du modèle et du framework que comme la disparition du framework dans le modèle.
1.3 Le workload cible a changé
L’objectif pratique ne se limite plus à :
- Les questions-réponses générales.
- La rédaction de textes.
- La génération de code en une seule étape.
- La synthèse simple.
Astra vise principalement des workloads d’exécution plus exigeants, tels que :
- L’utilisation d’ordinateurs.
- Les workflows dans les navigateurs.
- Le génie logiciel.
- L’analyse scientifique.
- Le traitement de documents professionnels.
- La recherche complexe.
- La cybersécurité autorisée et la recherche défensive en sécurité.
- Les tâches de CAO et d’ingénierie.
Les communications de lancement d’OpenAI insistent à plusieurs reprises sur le travail de bout en bout, plutôt que sur une simple amélioration de la personnalité conversationnelle.
1.4 En bref
Une manière utile de comprendre l’évolution des générations est la suivante :
Workflow centré sur les anciens modèles :
raisonnement avancé + orchestration externe

Workflow GPT-6 Astra :
raisonnement mieux entraîné pour les agents + orchestration externe conçue pour l’exploiter
Le second système est plus performant parce que le modèle lui-même est plus efficace pour planifier, utiliser les retours, manipuler des outils, déléguer le travail et rester cohérent sur des trajectoires de tâches longues.
2. Comparaison au sein de la famille OpenAI : un bond vertical, pas un remplacement universel
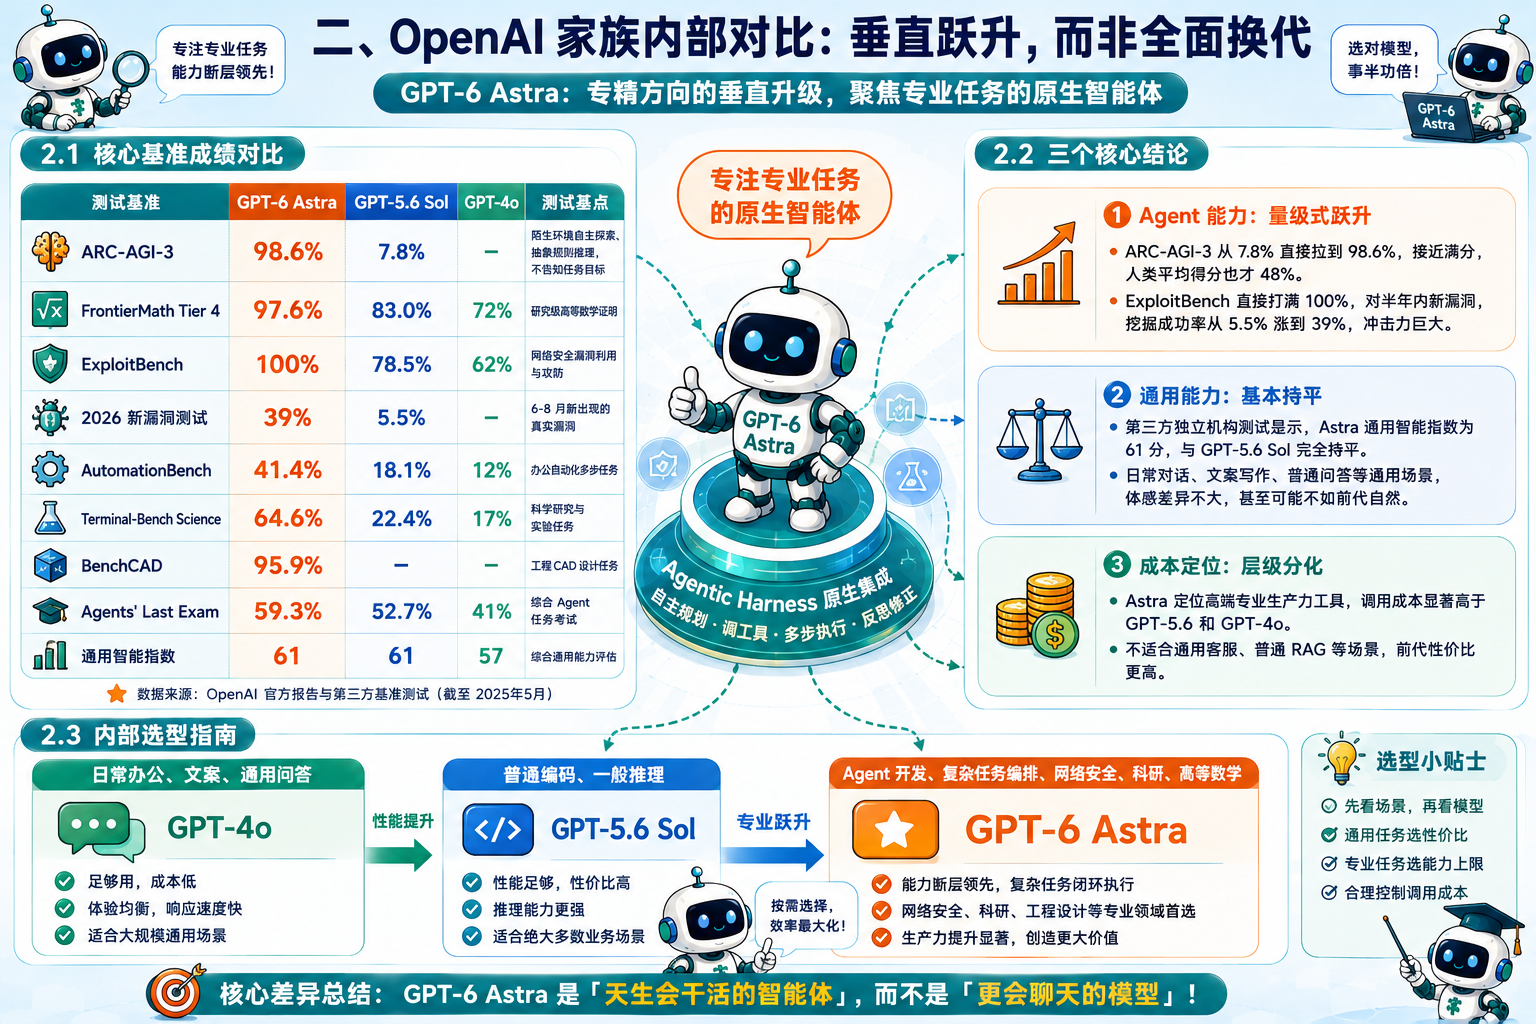
Le point le plus utile de l’article original est qu’Astra ne doit pas être considéré comme un remplacement automatique de tous les modèles moins coûteux pour tous les workloads.
Ses gains les plus importants apparaissent dans les tâches agentiques et professionnelles difficiles.
2.1 Comparaison des principaux benchmarks
Le tableau suivant utilise les valeurs disponibles dans la comparaison officielle publiée par OpenAI lors du lancement de GPT-6 Astra.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Ce qui est évalué |
|---|---|---|---|
| ARC-AGI-3 | 99,9 % | 7,8 % | Environnements interactifs inédits et découverte de règles abstraites |
| FrontierMath Tier 4 (v2) | 97,6 % | 83,0 % | Mathématiques de niveau recherche |
| ExploitBench | 100,0 % | 78,5 % | Développement d’exploits pour des vulnérabilités connues dans des environnements d’évaluation |
| ExploitBench, juin–août 2026 | 39,0 % | 5,5 % | Vulnérabilités récentes apparues après la date limite des connaissances du modèle |
| AutomationBench | 41,4 % | 18,1 % | Automatisation professionnelle en plusieurs étapes |
| Terminal-Bench Science 0.1 | 64,6 % | 22,4 % | Workflows scientifiques utilisant du code et des outils de terminal |
| BenchCAD | 95,9 % | 83,3 % | Reconstruction de modèles de CAO à partir de rendus multi-vues |
| Agents’ Last Exam | 59,3 % | 53,6 % | Tâches professionnelles complexes d’utilisation d’ordinateurs |
| Artificial Analysis Intelligence Index v4.1.1 au lancement | 61,2 | 60,9 | Indice indépendant composite d’intelligence |
Quelques précisions sont importantes pour interpréter ce tableau.
Premièrement, le texte principal d’OpenAI arrondit FrontierMath Tier 4 à 98 %, tandis que le tableau du benchmark indique 97,6 % pour l’évaluation v2.
Deuxièmement, le résultat spectaculaire d’Astra sur ARC-AGI-3 provient d’un benchmark interactif de type agentique. OpenAI précise qu’Astra a été exécuté avec son framework Responses API et que la configuration d’évaluation peut différer de celle de ChatGPT en production.
Troisièmement, les scores de cybersécurité ont été mesurés dans des conditions d’évaluation contrôlées. OpenAI classe désormais Astra au niveau de capacité Critique en cybersécurité dans le cadre de son Preparedness Framework et déploie des mesures de protection renforcées autour de ces capacités.
2.2 Trois conclusions essentielles
① Les tâches agentiques et l’interaction avec des environnements affichent la plus forte progression
ARC-AGI-3 en est l’exemple le plus clair.
Astra obtient 99,9 % dans l’évaluation publiée par OpenAI, contre 7,8 % pour GPT-5.6 Sol. Le benchmark exige qu’un système déduise les objectifs et les règles par l’interaction, plutôt que de répondre simplement à partir d’une demande statique.
La même tendance apparaît dans plusieurs benchmarks opérationnels :
- AutomationBench : 41,4 % contre 18,1 %.
- Terminal-Bench Science : 64,6 % contre 22,4 %.
- Version récente d’ExploitBench : 39,0 % contre 5,5 %.
C’est pourquoi Astra peut donner l’impression d’un bond générationnel beaucoup plus important dans les workflows agentiques que dans les conversations ordinaires.
② L’intelligence générale composite est beaucoup plus proche
Dans l’Artificial Analysis Intelligence Index v4.1.1 publié au moment du lancement, OpenAI a rapporté :
GPT-6 Astra : 61,2
GPT-5.6 Sol : 60,9
Claude Fable 5.1 : 65,7
L’écart entre Astra et Sol sur cet indice composite était minime par rapport à celui observé sur ARC-AGI-3 ou Terminal-Bench Science.
Artificial Analysis est depuis passé à la version v4.2, avec une combinaison différente de benchmarks. Les chiffres absolus ont donc changé. La conclusion générale reste valable : l’avantage distinctif d’Astra n’est pas que toutes les mesures d’intelligence générale aient soudainement doublé.
③ Le prix positionne clairement Astra dans le segment premium
La tarification API standard de GPT-6 Astra proposée par OpenAI est la suivante :
| Type de jeton | Prix par million de jetons |
|---|---|
| Entrée | 10,00 $ |
| Entrée mise en cache | 1,00 $ |
| Écriture du cache | 12,50 $ |
| Sortie | 50,00 $ |
GPT-5.6 Sol est actuellement moins cher, à 4 $ par million de jetons d’entrée et 20 $ par million de jetons de sortie.
Astra est donc surtout pertinent lorsque l’amélioration du taux de réussite des tâches compense le prix plus élevé des jetons.
Un autre élément concerne la tarification des contextes longs : les demandes contenant plus de 272 000 jetons d’entrée sont facturées à des tarifs supérieurs pour l’ensemble de la demande, soit 2 fois les tarifs d’entrée et de cache et 1,5 fois le tarif de sortie, selon la page actuelle du modèle Astra.
2.3 Guide interne de sélection du modèle
L’article original utilisait GPT-4o comme option généraliste à faible coût. GPT-4o existe toujours dans le catalogue API, mais les recommandations actuelles d’OpenAI orientent désormais les développeurs vers les modèles plus récents de la famille GPT-5.6 pour la plupart des nouvelles intégrations.
Un guide de sélection plus actuel est le suivant :
| Scénario | Point de départ recommandé | Pourquoi |
|---|---|---|
| Tâches généralistes à fort volume et sensibles aux coûts | GPT-5.6 Luna ou Terra | Coût inférieur et capacités suffisantes pour de nombreux workloads courants |
| Raisonnement professionnel et programmation | GPT-5.6 Sol | Performances professionnelles solides à un prix inférieur à celui d’Astra |
| Workflows complexes de bout en bout, utilisation d’ordinateurs, tâches scientifiques et travail agentique avancé | GPT-6 Astra | Meilleur choix pour l’exécution difficile en plusieurs étapes et l’utilisation intensive d’outils |
| Intégration GPT-4o existante | GPT-4o peut rester approprié | Toujours disponible, mais ce n’est pas la recommandation par défaut pour les nouveaux workflows de pointe |
La règle pratique est simple :
Commencez par le modèle le moins coûteux qui réalise la tâche de manière fiable. Passez à Astra lorsque la réussite, l’autonomie ou la qualité d’exécution de la tâche comptent davantage que le prix brut des jetons.
3. Comparaison entre fournisseurs : GPT-6 Astra face à Claude d’Anthropic
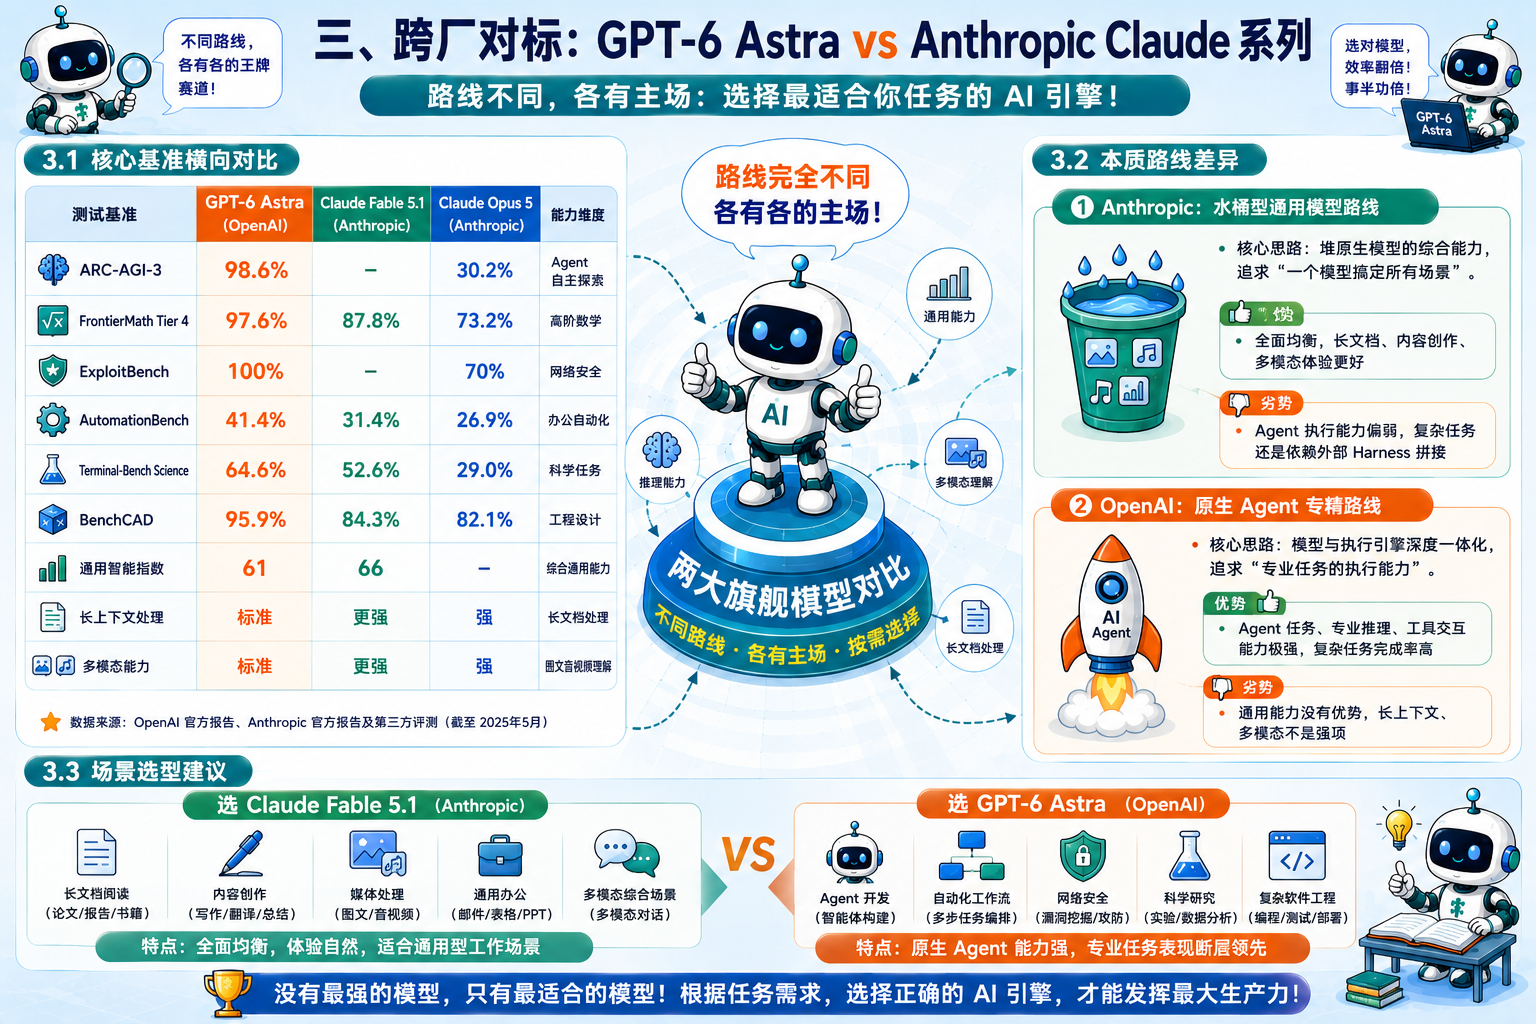
L’article source présente OpenAI et Anthropic comme deux entreprises qui suivent des trajectoires complètement différentes.
Cette distinction est pertinente sur certains points, mais les produits actuels se recouvrent davantage que ne le laisse entendre cette présentation.
Claude Fable 5.1 est lui aussi explicitement conçu pour les agents de longue durée, la programmation, l’utilisation de navigateurs, les workflows d’entreprise et l’exécution d’agents gérés. Astra est également un modèle multimodal doté d’un contexte d’un million de jetons et de solides capacités de raisonnement général.
La comparaison la plus exacte n’est donc pas de dire que « l’un est un agent et l’autre non ».
Il faut plutôt examiner les domaines dans lesquels chaque système présente actuellement les preuves et l’orientation produit les plus fortes.
3.1 Comparaison des principaux benchmarks
Les chiffres suivants proviennent du tableau comparatif publié par OpenAI lors du lancement, sauf indication contraire.
| Benchmark | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5 | Dimension évaluée |
|---|---|---|---|---|
| ARC-AGI-3 | 99,9 % | — | 30,2 % | Raisonnement abstrait interactif |
| FrontierMath Tier 4 (v2) | 97,6 % | 87,8 % | 73,2 % | Mathématiques avancées |
| ExploitBench | 100,0 % | — | 70,0 % | Évaluation de cybersécurité |
| AutomationBench | 41,4 % | 31,4 % | 26,9 % | Automatisation professionnelle |
| Terminal-Bench Science 0.1 | 64,6 % | 52,6 % | 30,0 % | Workflows scientifiques |
| BenchCAD | 95,9 % | 84,3 % | 82,1 % | Ingénierie et CAO |
| Agents’ Last Exam | 59,3 % | — | 55,5 % | Tâches professionnelles d’utilisation d’ordinateurs |
| Artificial Analysis Intelligence Index v4.1.1 au lancement d’Astra | 61,2 | 65,7 | 63,1 | Indice indépendant composite |
Un tiret ne signifie pas que le modèle est incapable d’effectuer la tâche. Il signifie que le tableau comparatif d’OpenAI ne publiait pas de score directement comparable pour cette entrée.
3.2 La différence de trajectoire la plus utile
① Anthropic : travail de connaissance et programmation de longue durée avec de solides capacités générales
Anthropic présente Claude Fable 5.1 comme son modèle le plus performant disponible au public pour la programmation ambitieuse et le travail de connaissance.
Sa page produit officielle met en avant :
- Les projets de longue durée pouvant prendre plusieurs heures.
- La programmation sur des bases de code complètes.
- Les agents gérés.
- L’utilisation de navigateurs.
- Les workflows d’entreprise.
- La vision pour les diagrammes, graphiques, tableaux, fichiers et PDF.
- Un contexte de l’ordre du million de jetons.
- La recherche avancée et le travail professionnel.
Fable 5.1 occupait également la première place de l’indice composite Artificial Analysis v4.1.1 au moment de son lancement et reste l’un des modèles les plus performants du classement indépendant actuel.
Il est donc inexact de réduire Claude à un « modèle conversationnel qui a encore besoin d’un framework externe ». Comme Astra, il s’inscrit dans une pile agentique ; le modèle et l’environnement d’exécution qui l’entoure comptent tous deux.
② OpenAI : des preuves plus fortes sur plusieurs benchmarks d’utilisation d’ordinateurs et d’exécution d’outils
Les résultats publiés lors du lancement d’Astra sont particulièrement solides dans les domaines suivants :
- L’utilisation d’ordinateurs.
- AutomationBench.
- ARC-AGI-3.
- Terminal-Bench Science.
- BenchCAD.
- Les évaluations de cybersécurité.
OpenAI a également introduit autour d’Astra des fonctionnalités API axées sur les agents, comme les appels d’outils asynchrones et les directives en cours de tour. La documentation précise qu’Astra peut répartir le travail et déléguer à des sous-agents lorsque le framework fournit des outils de collaboration.
Astra est donc particulièrement intéressant lorsque le travail consiste moins à produire une réponse aboutie qu’à terminer un workflow difficile au moyen de plusieurs outils et environnements.
3.3 Le contexte long et le multimodal ne constituent pas des avantages unilatéraux
L’article original qualifie le contexte long et le multimodal d’Astra de « standards » et considère ceux de Claude comme plus avancés.
Les spécifications actuelles rendent cette conclusion trop générale.
GPT-6 Astra prend en charge :
- Une fenêtre de contexte de 1 050 000 jetons.
- Les entrées image.
- Les sorties texte.
- La recherche web.
- La recherche de fichiers.
- L’utilisation d’ordinateurs.
- MCP.
- L’interpréteur de code et le shell hébergé via la Responses API.
Claude Fable 5.1 prend lui aussi en charge un contexte d’environ un million de jetons, les entrées image, la compréhension des fichiers et PDF, la programmation, l’utilisation de navigateurs et les workflows agentiques de longue durée.
La bonne décision doit donc reposer sur le workload exact et sur une évaluation concrète, et non sur la seule taille de la fenêtre de contexte.
3.4 Sélection selon les scénarios
Choisissez d’abord Claude Fable 5.1 lorsque votre workload repose principalement sur :
- Les projets de travail de connaissance de grande ampleur.
- Les projets de programmation longs lorsque le workflow de Claude correspond à votre équipe.
- L’analyse de documents.
- L’interprétation avancée de PDF, tableaux et graphiques.
- Les workflows d’agents gérés natifs de l’écosystème Anthropic.
Choisissez d’abord GPT-6 Astra lorsque votre workload repose principalement sur :
- Les tâches complexes d’utilisation d’ordinateurs.
- L’automatisation de bout en bout utilisant intensivement des outils.
- Les workflows scientifiques difficiles.
- L’automatisation de tâches de CAO et d’ingénierie.
- L’orchestration d’agents au sein de l’écosystème OpenAI.
- La recherche défensive autorisée en cybersécurité, dans le respect des mesures de protection et des politiques applicables.
Pour les systèmes de production importants, évaluez les deux modèles sur vos propres tâches représentatives avant de standardiser votre choix.
4. Le cœur technique : pourquoi les performances agentiques ont-elles autant progressé ?
Creez un site vitrine et genere des leads en quelques minutes
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
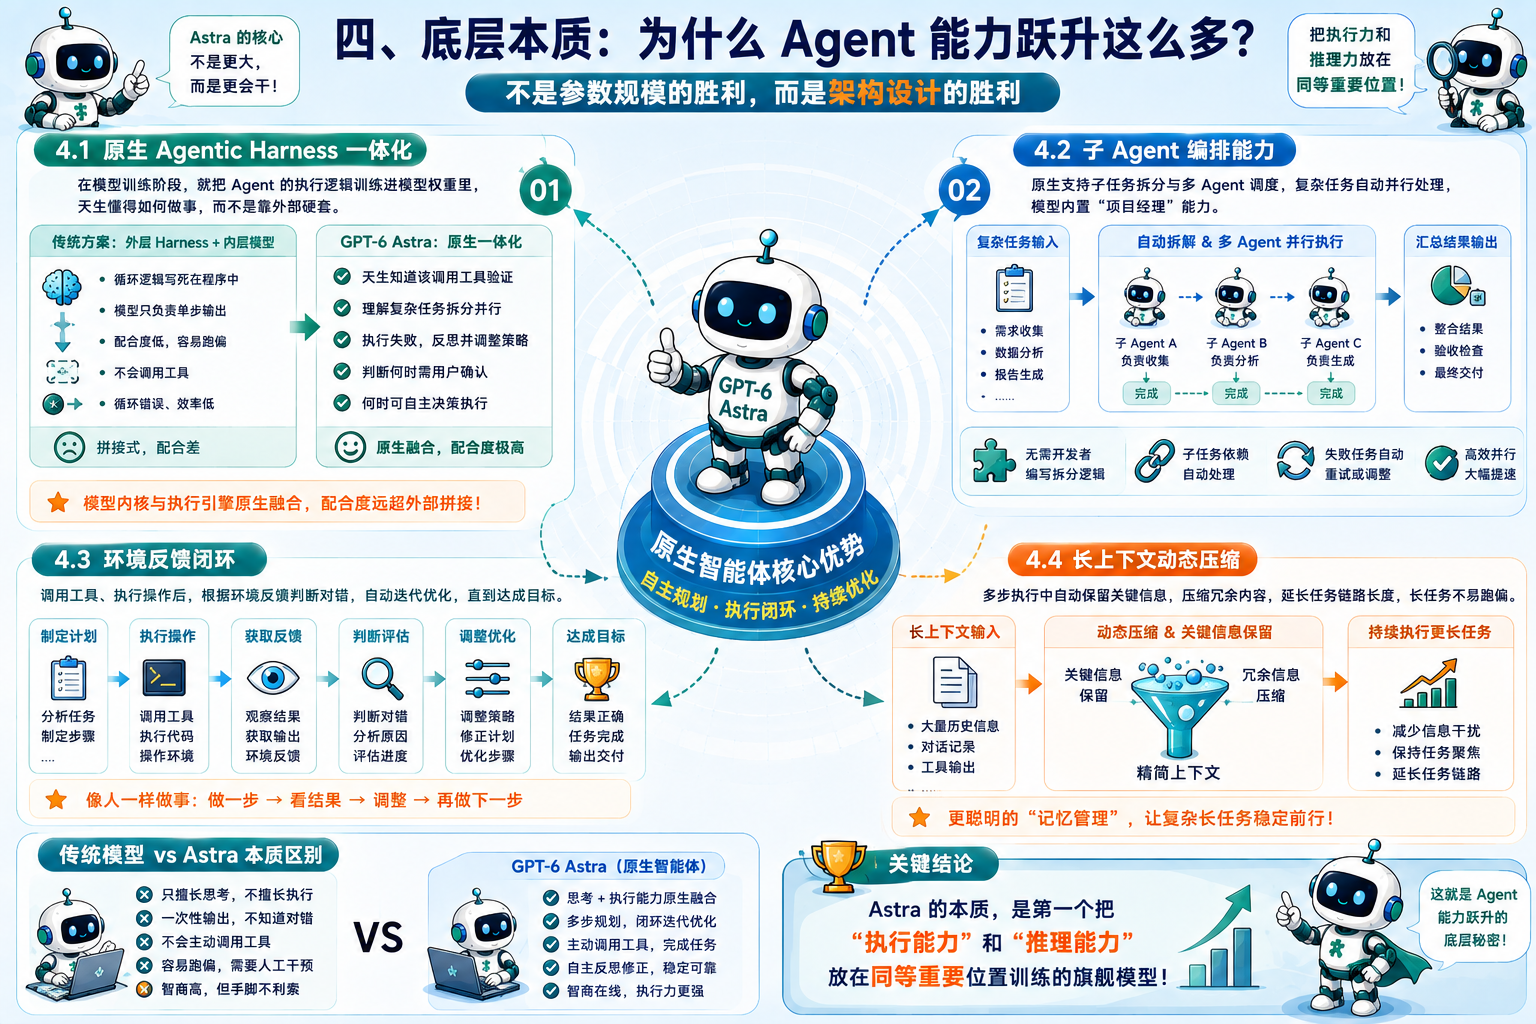
La source attribue principalement les progrès d’Astra à l’architecture plutôt qu’au nombre de paramètres.
OpenAI n’a pas communiqué le nombre de paramètres d’Astra ; les affirmations concernant le rôle de la taille du modèle ne peuvent donc pas être vérifiées directement.
Ce qu’OpenAI a documenté est une combinaison d’entraînement du modèle, d’améliorations de l’inférence et de conception du framework agentique.
4.1 Co-conception du modèle et du framework
C’est ici que la correction la plus importante par rapport à la source doit être apportée.
OpenAI n’affirme pas que l’intégralité de l’Agentic Harness a été littéralement intégrée aux poids du modèle Astra.
OpenAI décrit séparément son framework agentique comme une couche d’orchestration reliant les modèles, les outils et l’environnement de l’utilisateur. L’entreprise indique également qu’Astra est entraîné pour effectuer plus efficacement un travail en plusieurs étapes au sein de tels systèmes.
L’architecture pratique ressemble davantage à ceci :
Objectif de l’utilisateur
   ↓
Framework agentique / Responses API
   ↓
GPT-6 Astra
   ↓
Demande d’outil ou sous-tâche déléguée
   ↓
L’application ou l’outil exécute le travail
   ↓
Le résultat revient à Astra
   ↓
Astra met à jour son plan
   ↓
Le travail se poursuit jusqu’à son achèvement
Cette distinction est importante pour les développeurs, car votre application reste responsable de plusieurs éléments essentiels, notamment :
- L’implémentation des outils.
- Les autorisations.
- L’authentification.
- L’isolation de l’environnement.
- La politique d’approbation.
- La gestion des nouvelles tentatives et des échecs.
- La journalisation et l’observabilité.
- Les limites de sécurité.
Un meilleur modèle réduit la quantité de prompts fragiles et de logique d’orchestration que vous devez écrire, mais il ne supprime pas le besoin d’une ingénierie système.
4.2 Délégation à des sous-agents
OpenAI indique que GPT-6 Astra est entraîné pour diviser le travail et le déléguer à des sous-agents capables d’opérer en parallèle.
Cependant, les recommandations officielles précisent également que cela se produit lorsque vous implémentez un système multi-agents dans votre framework et que vous fournissez des outils de collaboration.
Astra peut donc adopter un comportement comparable à celui d’un chef de projet :
objectif complexe
→ division en flux de travail indépendants
→ délégation en parallèle
→ collecte des résultats
→ résolution des dépendances
→ poursuite de la tâche principale
Mais la création des sous-agents, leur environnement d’exécution et leur canal de communication proviennent toujours du système agentique qui entoure le modèle.
4.3 Boucles de retour depuis l’environnement
Les meilleurs résultats d’Astra proviennent souvent de benchmarks dans lesquels il peut interagir avec un environnement et observer les résultats.
Une boucle agentique robuste ressemble à ceci :
Planifier
→ agir
→ observer le résultat
→ vérifier si l’action a fonctionné
→ réviser le plan
→ agir à nouveau
Cette approche est fondamentalement différente de la génération de texte en une seule étape.
Le modèle peut utiliser les résultats renvoyés par les outils pour décider de poursuivre, de réessayer, de changer de stratégie ou de demander une clarification à l’utilisateur.
Les fonctionnalités actuelles de la Responses API d’OpenAI renforcent ce style de travail grâce à :
- L’appel d’outils.
- L’appel d’outils asynchrones.
- Les directives en cours de tour.
- Le raisonnement conservé.
- L’état conversationnel.
- La compaction.
- L’utilisation d’ordinateurs.
4.4 Gestion du contexte long et compaction
Les tâches agentiques longues créent un problème de gestion du contexte.
Chaque résultat d’outil, fichier, branche de raisonnement et action précédente peut ajouter davantage d’historique. Si le système rejoue simplement tout l’historique, le contexte devient coûteux et bruyant.
Astra dispose d’une fenêtre de contexte de 1,05 million de jetons, mais OpenAI prend également en charge la compaction explicite pour les conversations de longue durée dans la Responses API.
Le schéma utile est le suivant :
historique volumineux d’une tâche
→ conserver l’état récent important
→ compacter les informations plus anciennes
→ préserver les faits nécessaires à la poursuite
→ continuer le travail
La compaction ne constitue pas une mémoire magique. Les développeurs doivent toujours conserver l’état durable des projets dans des dépôts, des bases de données, des documents ou d’autres systèmes de stockage, plutôt que de dépendre d’une conversation qui s’allongerait indéfiniment.
4.5 Les appels d’outils asynchrones transforment le travail de longue durée
L’une des nouvelles capacités API d’Astra est l’appel d’outils asynchrones.
Le modèle peut continuer à raisonner, appeler d’autres outils ou répondre à des parties indépendantes d’une tâche pendant que l’application exécute encore un autre outil. Lorsque cet outil termine son opération, l’application renvoie son résultat en utilisant l’identifiant de l’appel initial.
Cela réduit les temps d’inactivité inutiles dans les workflows où un outil est lent.
Cela montre également pourquoi la progression agentique est une amélioration au niveau du système, et pas simplement le résultat d’un réseau neuronal plus grand.
4.6 La sécurité fait partie de l’architecture agentique
Une exécution plus autonome augmente le coût potentiel d’une erreur.
OpenAI associe donc Astra à des mesures de protection renforcées et à une surveillance des comportements de désalignement. Ses informations de sécurité indiquent qu’Astra est le premier modèle d’OpenAI classé au niveau de capacité Critique en cybersécurité.
OpenAI rapporte également une amélioration des comportements lors de tests destinés à déterminer si le modèle dépasse les limites de la tâche qui lui a été autorisée.
Pour les développeurs, l’architecture doit inclure :
- Des autorisations d’outils limitées.
- Des limites d’autorisation explicites.
- L’isolation des environnements à risque.
- Une confirmation humaine pour les actions aux conséquences importantes.
- La surveillance et des journaux d’audit.
- Un mécanisme fiable d’arrêt ou de neutralisation.
Un modèle agentique plus puissant rend ces contrôles plus importants, et non moins importants.
Conclusion essentielle : la progression d’Astra doit être comprise comme la combinaison d’un comportement de modèle mieux entraîné pour les agents et d’une pile d’exécution plus performante. Le raisonnement et l’exécution sont mieux coordonnés, mais le framework, les outils, les autorisations et l’environnement restent des couches d’ingénierie distinctes.
5. Sélection du modèle et perspectives
5.1 Quand GPT-6 Astra justifie-t-il une mise à niveau ?
Profils particulièrement adaptés
Astra est une option solide si vous travaillez sur :
- Des applications agentiques complexes.
- Des workflows d’automatisation de longue durée.
- Des tâches d’utilisation d’ordinateurs dans des logiciels réels.
- De grands projets de génie logiciel.
- Des workflows scientifiques impliquant du code et des outils.
- L’automatisation de tâches de CAO et d’ingénierie.
- Le raisonnement mathématique avancé.
- La cybersécurité défensive autorisée et la recherche sur les vulnérabilités lorsque l’accès est permis.
Ce sont les domaines dans lesquels les évaluations publiées par OpenAI montrent la séparation la plus nette par rapport à GPT-5.6 Sol.
Cas où il n’est généralement pas nécessaire
Astra est souvent inutile pour :
- La rédaction courante.
- La classification simple.
- L’extraction basique.
- Le support client à fort volume et à faible risque.
- Les questions-réponses RAG simples.
- Les petites transformations pour lesquelles les modèles moins coûteux atteignent déjà le niveau de qualité requis.
- Les workloads dans lesquels le prix élevé des jetons d’Astra ne peut pas être justifié par une meilleure réalisation des tâches.
Pour ces scénarios, GPT-5.6 Terra ou Luna peut constituer un point de départ plus économique, tandis que Sol reste une excellente option par défaut pour les usages professionnels.
5.2 Le coût doit être mesuré par tâche terminée, pas uniquement par jeton
La tarification de 10 $/50 $ par million de jetons d’Astra est bien supérieure à celle de GPT-5.6 Sol, qui s’élève à 4 $/20 $.
Cependant, les workflows agentiques ne sont pas toujours les moins chers lorsque l’on choisit le modèle dont les jetons sont les moins coûteux.
Un modèle moins cher peut nécessiter :
- Davantage de nouvelles tentatives.
- Davantage d’appels d’outils.
- Davantage de corrections manuelles.
- Davantage de supervision humaine.
- Des trajectoires de tâches plus longues.
OpenAI indique que, dans plusieurs évaluations publiées lors du lancement, Astra a obtenu de meilleurs résultats avec moins de jetons de sortie et parfois un coût API estimé inférieur par tâche de benchmark terminée, malgré un prix par jeton plus élevé.
C’est la bonne manière d’évaluer un modèle agentique en production :
Coût total d’une tâche réussie
= jetons du modèle
+ coûts des outils
+ nouvelles tentatives
+ latence
+ revue humaine
+ coût des échecs
5.3 La mesure concurrentielle évolue vers l’achèvement des tâches
La tendance générale relevée dans l’article original est convaincante.
Pendant des années, les comparaisons entre modèles de pointe se sont largement concentrées sur :
- L’ampleur des paramètres.
- La longueur du contexte.
- Les tests de raisonnement statiques.
- La qualité des conversations générales.
- Les entrées multimodales.
Ces éléments restent importants.
Mais l’étape suivante pose de plus en plus les questions suivantes :
- Le modèle peut-il terminer une tâche de plusieurs heures ?
- Peut-il utiliser des logiciels de manière fiable ?
- Peut-il récupérer après l’échec d’un appel d’outil ?
- Peut-il respecter les limites d’autorisation ?
- Peut-il déléguer intelligemment le travail ?
- Peut-il intégrer de nouvelles instructions pendant l’exécution ?
- Peut-il produire un livrable final plutôt qu’une simple suggestion ?
Astra est l’un des exemples les plus clairs de cette évolution.
5.4 Ne confondez pas « natif pour les agents » et « sans framework nécessaire »
Il s’agit de la conclusion d’ingénierie la plus importante.
Un modèle peut être hautement agentique tout en nécessitant un framework.
En réalité, plus le modèle devient performant dans l’exécution de tâches complexes, plus un framework bien conçu devient précieux, car il fournit :
- Un accès sécurisé aux outils.
- Un état fiable.
- Une gestion du contexte.
- La concurrence.
- Les validations.
- Le bac à sable.
- L’observabilité.
- Une logique de récupération.
Les développeurs ne doivent donc pas cesser d’apprendre l’ingénierie des agents parce qu’Astra est plus performant dans ce domaine.
Ils doivent au contraire l’approfondir.
5.5 Perspective finale
GPT-6 Astra ne doit être ni considéré comme un remplacement universel ni écarté au motif que son score général composite est proche de celui d’un autre modèle de pointe.
Sa valeur la plus forte apparaît lorsque le travail constitue un workflow, et non un simple prompt.
Si votre application a principalement besoin de réponses courtes, un modèle moins coûteux peut constituer un meilleur choix d’ingénierie.
Si votre application a besoin d’un système d’IA capable d’inspecter, de décider, d’agir, de vérifier, de récupérer et de poursuivre son travail en plusieurs étapes, Astra devient beaucoup plus intéressant.
C’est le véritable signal générationnel.
FAQ
Qu’est-ce que GPT-6 Astra ?
GPT-6 Astra est le modèle phare actuel d’OpenAI pour les tâches complexes de bout en bout. OpenAI le positionne pour le raisonnement complexe, la programmation, l’utilisation d’ordinateurs, la recherche, les workflows professionnels et les tâches agentiques utilisant intensivement des outils.
GPT-6 Astra est-il réellement un modèle « natif pour les agents » ?
Il est plus exact de qualifier Astra de modèle optimisé pour les agents que d’affirmer que l’intégralité du framework agentique réside dans le modèle. Astra est entraîné pour le travail en plusieurs étapes, l’utilisation d’outils et la délégation à des sous-agents, tandis que Codex, ChatGPT Work ou votre propre application fournissent toujours le framework externe, les outils, les autorisations et l’environnement d’exécution.
Quel est l’identifiant du modèle API de GPT-6 Astra ?
L’identifiant du modèle API est gpt-6-astra. OpenAI le rend actuellement accessible via la Responses API et l’API Chat Completions, même si l’appel d’outils pour Astra est documenté principalement autour de la Responses API.
Combien coûte GPT-6 Astra ?
La tarification API standard est de 10 $ par million de jetons d’entrée et de 50 $ par million de jetons de sortie. L’entrée mise en cache coûte 1 $ par million de jetons, l’écriture du cache 12,50 $ par million et les demandes dépassant 272 000 jetons d’entrée utilisent des tarifs supérieurs pour les contextes longs selon les règles de tarification actuelles.
Comment GPT-6 Astra se compare-t-il à GPT-5.6 Sol ?
Astra est nettement plus performant dans plusieurs évaluations publiées portant sur les agents et l’interaction avec des environnements, notamment ARC-AGI-3, AutomationBench, Terminal-Bench Science et les tâches récentes de cybersécurité. Sol reste beaucoup moins cher et constitue toujours un excellent choix pour le raisonnement professionnel général et la programmation lorsque l’exécution de tâches au niveau d’Astra n’est pas nécessaire.
Comment GPT-6 Astra se compare-t-il à Claude Fable 5.1 ?
Les deux modèles de pointe sont conçus pour les tâches complexes et de longue durée. Astra affiche actuellement des résultats particulièrement solides dans les comparaisons d’OpenAI portant sur l’utilisation d’ordinateurs, l’automatisation, les sciences, la CAO et la cybersécurité. Claude Fable 5.1 est quant à lui extrêmement performant en programmation et dans le travail de connaissance, et a dominé certaines évaluations composites récentes d’Artificial Analysis selon la version de l’indice et les paramètres d’effort utilisés.
Quelle est la fenêtre de contexte de GPT-6 Astra ?
OpenAI documente une fenêtre de contexte de 1 050 000 jetons, avec jusqu’à 128 000 jetons de sortie. Les demandes très longues sont plus coûteuses, et les développeurs doivent malgré tout utiliser la compaction ainsi qu’un état externe durable pour les workflows agentiques de longue durée.
Quand dois-je choisir Astra plutôt qu’un modèle moins coûteux ?
Choisissez Astra lorsque des taux de réussite supérieurs sur des tâches complexes en plusieurs étapes peuvent justifier son prix premium. Pour l’extraction courante, le support, la rédaction, le RAG simple ou les tâches à fort volume et faible risque, un modèle moins coûteux constitue généralement un meilleur point de départ.
Outils associés
- OpenAI Responses API : principale interface API pour les workflows agentiques utilisant intensivement des outils et conservant un état avec GPT-6 Astra.
- OpenAI Codex : environnement d’agent de programmation d’OpenAI, qui associe des modèles de pointe à un framework agentique externe et à des outils de développement.
- Page du modèle GPT-6 Astra : spécifications officielles du modèle, tarification, fenêtre de contexte, outils et limites de débit.
- Anthropic Claude : page produit officielle de Claude Fable 5.1 pour la programmation, le travail de connaissance, la vision et les agents de longue durée.
- Artificial Analysis : plateforme indépendante de benchmarks de modèles et de comparaison des performances API.
- ARC Prize : organisation à l’origine des évaluations ARC-AGI, notamment les benchmarks de raisonnement abstrait interactif.
Liens associés
- OpenAI : GPT-6 Astra — Une nouvelle génération d’intelligence : annonce officielle du lancement, tableaux de benchmarks, disponibilité et contexte tarifaire.
- Documentation du modèle GPT-6 Astra d’OpenAI : détails officiels sur le modèle API, les outils pris en charge, les limites de contexte et la tarification des jetons.
- Guide du modèle GPT-6 Astra d’OpenAI : recommandations officielles concernant les outils asynchrones, les directives en cours de tour, la délégation à des sous-agents, les prompts et la migration.
- Présentation de la sécurité de GPT-6 Astra par OpenAI : informations générales sur la sécurité et le déploiement d’Astra.
- OpenAI : Path to Astra — Capacités critiques et protections des modèles de pointe : contexte sur l’évaluation des capacités d’Astra en cybersécurité et les mesures de protection associées.
- Anthropic Claude Fable 5.1 : disponibilité officielle, tarification, cas d’usage, mesures de protection et informations de benchmark concernant Fable 5.1.
- Artificial Analysis : GPT-6 Astra : suivi indépendant des performances, des prix et de l’Intelligence Index d’Astra.
- Article original sur CSDN : article chinois original, sous licence CC BY-SA 4.0.
Résumé
GPT-6 Astra constitue une avancée importante pour les workflows agentiques, mais la description la plus exacte n’est pas qu’« OpenAI a intégré l’intégralité de l’Agent Harness dans le modèle ». Astra est mieux entraîné pour l’exécution longue et en plusieurs étapes, tandis que Codex, ChatGPT Work, la Responses API et les applications personnalisées fournissent toujours l’orchestration, les outils, les autorisations et l’environnement qui l’entourent.
Ses progrès publiés les plus importants apparaissent dans le raisonnement interactif, l’utilisation d’ordinateurs, l’automatisation professionnelle, les workflows scientifiques, la CAO et les évaluations de cybersécurité. Sur les mesures générales composites d’intelligence, l’écart avec les autres modèles de pointe peut être beaucoup plus faible. Astra ne doit donc pas remplacer automatiquement les modèles moins coûteux pour les tâches courantes.
Pour les développeurs, le changement stratégique est clair : la sélection d’un modèle dépend de plus en plus de la réussite d’une tâche au sein d’un système, et non plus seulement de la qualité d’une réponse dans une fenêtre de chat.
GPT-6 Astra est surtout pertinent lorsque le problème n’est pas « Que doit dire l’IA ? », mais « L’IA peut-elle mener le travail à son terme en toute sécurité ? »


