For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/open-weight-ai-coding-models-workflows.md.
Les modèles de codage open-weight font désormais partie de systèmes d’ingénierie concrets. Leur valeur ne se limite plus aux performances su...
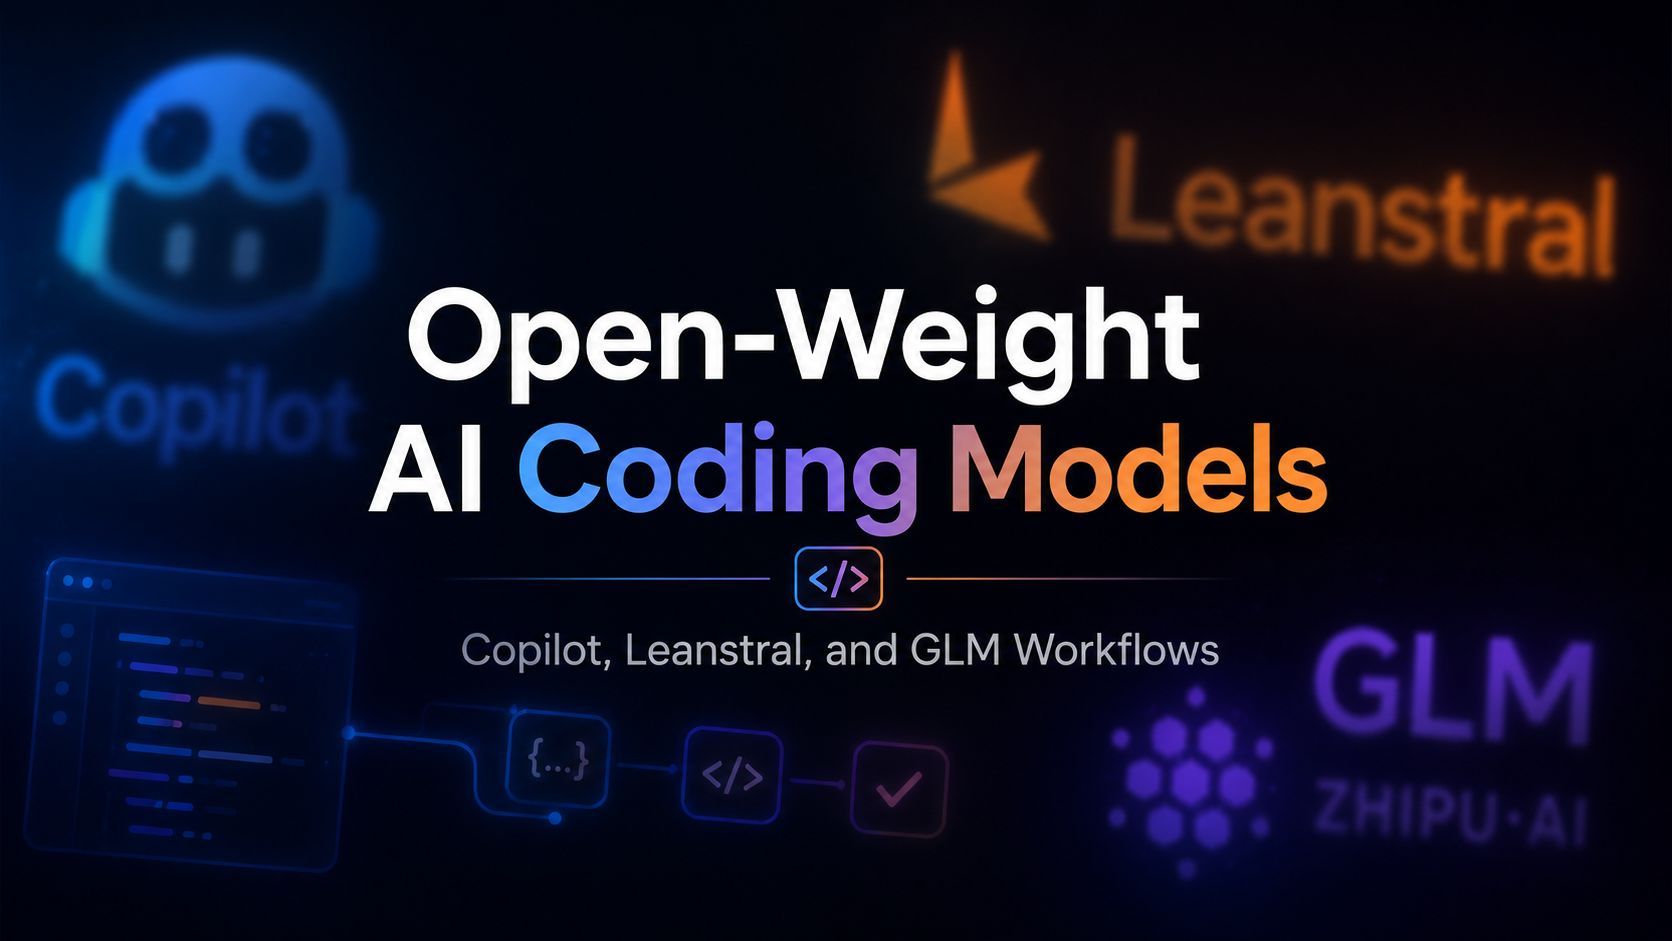
Les modèles de codage à poids ouverts ne sont plus seulement des entrées de classement ou des démonstrations de recherche. Ils commencent à apparaître dans les outils que les développeurs utilisent déjà, notamment les assistants d’IDE, les catalogues de modèles hébergés, les environnements de vérification et les workflows d’agents de codage multimodèles.
Ce changement modifie la question pratique pour les équipes d’ingénierie. La question n’est plus seulement « quel est le meilleur modèle ? ». Elle devient « quel modèle doit prendre en charge quelle tâche, sous quelle frontière de sécurité, avec quel processus d’évaluation et avec quel plan de repli ? »
Cet article réécrit et développe l’article original de We0 AI en anglais tout en conservant sa structure principale : Copilot comme point d’entrée du workflow, Leanstral pour la vérification formelle, GLM-5.2 via un accès hébergé, la leçon tirée de l’instabilité de l’API Llama, et un cadre d’évaluation pratique pour les équipes.
Le changement important n’est pas simplement que de nouveaux modèles apparaissent dans les classements publics. Le changement le plus important est l’endroit où ils apparaissent.
Kimi K2.7 Code est disponible dans GitHub Copilot. Leanstral 1.5 se positionne autour de la preuve formelle et de la vérification. GLM-5.2 peut être testé via NVIDIA Build avant qu’une équipe ne s’engage dans une intégration plus poussée ou dans l’auto-hébergement.
Ensemble, ces mises à jour suggèrent un nouveau modèle de workflow. Les équipes doivent décider quel modèle planifie le travail, quel modèle modifie le code, quel modèle relit le résultat et quel outil vérifie le résultat. Le choix du modèle devient une composante de l’architecture d’ingénierie, et non plus seulement une préférence personnelle.
Le changement concerne l’accès et le positionnement.
Par le passé, de nombreux modèles à poids ouverts étaient surtout évalués au travers de publications de benchmarks, de démonstrations isolées ou d’expériences locales. Désormais, ils entrent dans les surfaces de développement quotidiennes : sélecteurs de modèles dans Copilot, points de terminaison d’inférence hébergés, outils de vérification formelle et systèmes de codage agentiques.
C’est important, car les points d’entrée du workflow façonnent les comportements. Si un modèle est disponible là où les développeurs travaillent déjà, il devient partie prenante de décisions réelles : quelle tâche lui attribuer, quelle quantité de contexte envoyer, comment relire le correctif et quand faire appel à un système plus puissant ou mieux contrôlé.
Pour les responsables d’ingénierie, c’est aussi un changement de gouvernance. Le fait qu’un modèle soit à poids ouverts ne signifie pas automatiquement une infrastructure ouverte, un comportement d’API stable, une facturation prévisible ou une gestion sûre des données. Chaque voie de déploiement doit encore être comprise séparément.
GitHub Copilot n’est pas un terrain de jeu de recherche. Pour de nombreux développeurs, c’est déjà une interface de développement par défaut.
C’est pourquoi l’arrivée de Kimi K2.7 Code dans Copilot est significative. Le modèle
devient sélectionnable au sein d’un flux de travail de codage familier au lieu d’être quelque chose qu’un développeur doit connecter manuellement à un outil distinct. Le propre journal des modifications de GitHub décrit Kimi K2.7 Code comme un modèle à poids ouverts disponible dans Copilot et hébergé par GitHub sur Microsoft Azure.
Cela transforme aussi le choix du modèle en une question d’approvisionnement et de gouvernance. Les équipes qui utilisent Copilot Business ou Enterprise doivent toujours réfléchir aux politiques, à la facturation, aux coûts liés à l’usage, aux journaux, à la revue de sécurité et au fait qu’un modèle donné soit ou non activé pour l’organisation.
Une règle utile est simple : ne considérez pas « disponible dans Copilot » comme équivalent à « approuvé pour tous les dépôts ». Les modifications à faible risque, les outils internes et le code prototype peuvent relever d’une politique. L’authentification, le paiement, les autorisations, les données réglementées et les systèmes orientés client peuvent nécessiter un examen plus strict et un accès plus restreint aux modèles.
Leanstral 1.5 ne doit pas être compris comme un modèle d’autocomplétion à usage général.
Son point fort est plutôt l’ingénierie de la preuve. Il est conçu autour des flux de travail Lean 4, du raisonnement formel, de la démonstration de théorèmes et des tâches de vérification de code où la justesse compte davantage que la complétion rapide de texte.
Cela rend Leanstral utile à un autre niveau de la pile de codage par IA. Au lieu de demander à un seul modèle de tout générer et valider, une équipe peut séparer ces rôles. Un modèle peut produire un correctif. Un autre système peut exécuter les tests. Un modèle ou une chaîne d’outils orientés vers la vérification peut aider à raisonner sur les invariants, les protocoles, les algorithmes et les modules critiques.
Cette séparation est importante. Le code généré par l’IA peut sembler plausible tout en restant erroné. La vérification formelle ne supprime pas la nécessité du jugement humain, mais elle donne aux équipes un moyen plus solide de vérifier des propriétés spécifiques lorsque le code est suffisamment important pour justifier le travail supplémentaire.
GLM-5.2 montre une autre voie pratique : un accès hébergé avant un engagement plus profond.
Des catalogues comme NVIDIA Build permettent aux équipes de tester un modèle via un point de terminaison avant de décider de l’adopter, d’y acheminer certaines tâches, de l’auto-héberger ou de l’ignorer. Cela abaisse la barrière à l’évaluation. Une équipe peut exécuter de vraies tâches sur le modèle sans construire immédiatement toute l’infrastructure de service.
Pour les cas d’usage liés au code, l’évaluation ne devrait pas s’arrêter à « le modèle répond-il à une invite ? ». Un ensemble de tests internes réaliste devrait inclure de vrais bogues, des migrations, des modifications de documentation, la génération de tests, des tâches de refactorisation et des cas sensibles sur le plan de la sécurité où le modèle devrait refuser, demander des précisions ou transmettre à un humain.
Les modèles ouverts hébergés sont utiles, mais ils nécessitent tout de même des contrôles. Les équipes devraient consigner quel point de terminaison a traité une tâche, quel contexte a été envoyé, quelle sortie a été acceptée et quels tests ou examens ont ensuite été effectués.
La leçon à tirer de l’aperçu public de l’API Llama de Meta est simple : des poids ouverts ne garantissent pas automatiquement des API hébergées stables.
Un modèle peut avoir des poids ouverts alors que le service hébergé qui l’entoure change, s’arrête, ajoute des limites, modifie sa tarification ou passe à un autre modèle d’accès. Cette distinction est importante pour les systèmes de production.
Une architecture plus sûre évite de tout lier à un seul point de terminaison de fournisseur. Les équipes
il faut garder des prompts portables, faire passer les modèles par une passerelle de modèles lorsque c’est possible, consigner les résultats d’évaluation et définir des solutions de repli avant qu’un changement de service ne devienne urgent.
L’objectif n’est pas d’éviter les modèles hébergés. Les points de terminaison hébergés sont souvent le moyen le plus rapide d’expérimenter. L’objectif est d’éviter qu’un point de terminaison temporaire ne devienne un point de défaillance unique pour le travail d’ingénierie en production.
Les équipes devraient évaluer les modèles par type de tâche, et non uniquement selon leur réputation.
Commencez par regrouper les tâches en catégories pratiques :
Mesurez ensuite les résultats à l’aide de critères pertinents pour votre dépôt :
Les benchmarks publics peuvent être utiles, mais ils ne doivent pas remplacer l’évaluation au niveau du dépôt. Un modèle qui obtient de bons résultats sur des benchmarks publics de programmation peut malgré tout se comporter mal dans votre stack, avec vos conventions de code ou dans vos limites de sécurité.
Un workflow de développement multi-modèles pratique devrait rendre chaque étape visible.
En amont, utilisez un routeur de modèles ou une couche de politique. Cela détermine quel modèle peut être utilisé pour quel dépôt, quel type de tâche et quel niveau de sensibilité du contexte.
Au milieu, utilisez la sélection de contexte. N’envoyez pas l’ensemble du dépôt par défaut. N’envoyez que les fichiers, journaux, traces, exigences et sorties de test nécessaires à la tâche.
En aval, exécutez la vérification. Cela peut inclure des tests unitaires, des vérifications de type, du linting, une analyse de sécurité, une revue de code et, lorsque c’est approprié, une vérification formelle avec des outils basés sur Lean.
Enfin, consignez la décision. Enregistrez la tâche, le modèle sélectionné, la catégorie de contexte, le correctif accepté, les résultats des tests et l’issue de la revue humaine. Cela transforme la sélection de modèles en système d’ingénierie plutôt qu’en décision cachée dans une boîte de dialogue.
Des modèles différents devraient servir à des usages différents.
Les travaux répétitifs à faible risque peuvent souvent être confiés à des modèles open-weight à moindre coût ou à des modèles ouverts hébergés. Cela inclut par exemple les modifications de texte, les refactorisations simples, les mises à jour élémentaires de documentation ou la création répétitive de structures de tests.
Les tâches à forte ambiguïté peuvent encore nécessiter un agent de codage de pointe plus puissant. Il s’agit notamment des changements d’architecture, du débogage sur plusieurs fichiers, des problèmes de production mal définis et des travaux qui exigent une planification sur le long terme.
Les travaux orientés preuve devraient utiliser des outils de vérification et des environnements de raisonnement formel. Leanstral est pertinent ici, car il se concentre sur Lean 4 et l’ingénierie de la preuve plutôt que sur l’autocomplétion générale.
Le code sensible devrait rester local ou au sein de points de terminaison contrôlés chaque fois que possible. Authentification, paiements, autorisations, données privées des clients,
et les flux de travail réglementés devraient avoir des limites plus strictes et une validation humaine obligatoire.
Les modèles de code à poids ouverts offrent davantage de choix, mais ils introduisent aussi plusieurs risques.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Le premier risque consiste à confondre poids ouverts et service ouvert. Un modèle peut être téléchargeable, tandis que l’API hébergée, l’intégration produit, la facturation et le flux de données restent contrôlés par quelqu’un d’autre.
Le deuxième risque est le surajustement aux benchmarks. Un modèle peut sembler impressionnant sur des tâches publiques tout en échouant face à vos véritables schémas de bugs, à vos abstractions internes ou aux conventions de votre base de code.
Le troisième risque est la surcharge de revue. Si un modèle génère rapidement de nombreux correctifs, les relecteurs peuvent devenir le goulet d’étranglement. Produire davantage de code généré n’aide pas si personne ne peut le relire attentivement.
Le quatrième risque est la fuite de contexte. Les assistants de codage IA ont souvent besoin de code, de journaux, de tickets, de traces de pile et parfois de détails sensibles sur le produit. Les équipes ont besoin de règles claires sur ce qui peut sortir de l’environnement.
Le cinquième risque est la dérive des modèles hébergés. Un modèle hébergé peut faire évoluer son comportement, ses tarifs, ses limites ou sa disponibilité au fil du temps. Une réévaluation mensuelle est plus sûre que de supposer que les résultats d’hier s’appliquent encore.
Une équipe peut commencer modestement.
Choisissez environ 20 tâches réelles issues de l’historique de votre dépôt. Incluez au moins une correction frontend, un bug backend, une tâche de finalisation de tests, une mise à jour de documentation, une mise à niveau de dépendance et une tâche sensible sur le plan de la sécurité pour laquelle la bonne réponse peut être de s’arrêter ou d’escalader.
Exécutez le même ensemble de tâches avec votre assistant actuel, Kimi dans Copilot si cela est disponible dans votre offre, GLM via un point de terminaison hébergé, ainsi qu’un agent de codage frontier plus puissant.
Suivez les mêmes champs à chaque fois : si le correctif était correct, si les tests sont passés, combien de temps la revue a pris, si le modèle a modifié des fichiers sans rapport, le coût estimé et si le modèle a respecté la bonne limite de politique.
Choisissez ensuite un petit invariant ou un comportement critique et testez si la vérification formelle peut aider. Ne commencez pas par le système de production le plus difficile. Commencez par une propriété petite et bien définie, puis mesurez l’effort réel que le flux de travail exige.
L’avenir du codage par IA ne sera probablement pas celui d’un modèle parfait capable de traiter toutes les tâches.
Un avenir plus réaliste est celui d’un flux de travail contrôlé dans lequel plusieurs modèles remplissent des rôles différents. Un modèle peut planifier. Un autre peut modifier. Un autre peut relire. Un système de test vérifie le comportement. Un outil de vérification prouve certaines propriétés sélectionnées. Un humain conserve la décision finale.
L’enseignement pratique est clair : le choix du modèle devrait faire partie du système d’ingénierie. Les équipes devraient définir des règles d’orientation, des limites de contexte, des enregistrements d’évaluation, des politiques de revue et des chemins de secours avant d’utiliser largement ces modèles.
Ne transformez pas l’adoption des modèles à poids ouverts en concours de loyauté envers un modèle.
Une meilleure approche consiste à maintenir un petit ensemble de benchmarks réalistes issus de votre propre travail. Chaque fois qu’un nouveau modèle devient populaire, exécutez à nouveau les mêmes tâches. Enregistrez les résultats. Comparez le modèle à votre flux de travail existant au lieu de comparer des captures d’écran vues sur les réseaux sociaux.
Pour les managers, la valeur des modèles à poids ouverts ne réside pas seulement dans le coût plus faible. Ils créent aussi des options de sortie et
un levier de négociation. Une équipe peut utiliser Kimi dans Copilot, tester GLM via un endpoint hébergé, explorer Leanstral pour des travaux orientés preuve, et conserver Claude Code, Codex ou un autre agent de pointe pour les tâches ambiguës.
Ce que les équipes doivent éviter, c’est de confier par défaut toutes les tâches à la même boîte noire. Le flux de travail doit relier le type de tâche, le contexte, le choix du modèle, les tests et l’historique de revue.
Premièrement, définissez quels dépôts peuvent envoyer du contexte à des modèles externes et lesquels doivent rester locaux ou au sein d’endpoints contrôlés.
Deuxièmement, attribuez un modèle par défaut et un chemin d’escalade pour chaque catégorie de tâches. Une correction CSS n’a pas besoin du même processus qu’une modification liée à la connexion, au paiement, aux autorisations ou à la suppression de données.
Troisièmement, archivez la sortie du modèle avec les résultats des tests et les notes de revue. Cela facilite la compréhension, a posteriori, des raisons pour lesquelles un correctif a été accepté ou rejeté.
Quatrièmement, relancez les évaluations chaque mois. Le comportement des modèles hébergés, la tarification, les limites et les politiques produit peuvent évoluer.
Cinquièmement, apprenez aux développeurs à savoir quand arrêter de formuler des prompts. Si un modèle s’oriente dans la mauvaise direction, davantage de tokens ne feront peut-être que compliquer la revue.
Cette liste de contrôle n’a pas pour but de ralentir les équipes. Elle vise à réduire les risques cachés. Les modèles à poids ouverts offrent davantage d’options aux équipes, et davantage d’options exigent des limites plus claires.
Un rythme d’adoption sain comporte trois étapes : observation, pilote et défaut.
Au stade de l’observation, collectez les sources, les environnements pris en charge, les notes sur la tarification, les limites de politique et les premiers résultats de test. Ne modifiez pas l’ensemble du flux de travail simplement parce qu’un modèle est tendance.
Au stade pilote, autorisez un petit groupe de développeurs à utiliser le modèle sur des dépôts à faible risque et pour des tâches bien définies. Consignez soigneusement les résultats.
Au stade par défaut, n’inscrivez le modèle dans les règles de l’équipe qu’après qu’il a passé l’évaluation interne. La règle doit préciser où il peut être utilisé, où il ne peut pas l’être et quand une revue humaine ou un outil plus puissant est requis.
Cela permet de maintenir l’adoption des modèles liée à des preuves d’ingénierie plutôt qu’à l’engouement d’un lancement, aux mouvements des classements ou à l’excitation passagère des réseaux sociaux.
Les modèles d’IA de programmation à poids ouverts sont des modèles dont les poids sont disponibles pour inspection, téléchargement ou déploiement selon une licence définie. En pratique, les équipes doivent néanmoins distinguer les poids du modèle des API hébergées, des intégrations produit, de la tarification, des journaux et des politiques de traitement des données.
Non. La disponibilité en poids ouverts ne signifie pas automatiquement qu’il existe une API hébergée permanente. Un modèle peut être à poids ouverts alors qu’un aperçu hébergé, un endpoint ou une intégration produit évolue avec le temps.
GitHub Copilot constitue une interface de développement quotidienne pour de nombreuses équipes ; l’apparition d’un modèle dans cet environnement a donc un impact immédiat sur le flux de travail. Cela transforme le choix du modèle en une question concrète de gouvernance, impliquant l’accès selon le forfait, la facturation, les politiques du modèle et les règles au niveau du dépôt.
Leanstral 1.5 est surtout pertinent pour l’ingénierie de preuves en Lean 4, la vérification formelle et les propriétés du code qui nécessitent des contrôles de correction plus poussés. Il convient de le considérer comme
dans le cadre d’un workflow de vérification plutôt que seulement comme outil général d’autocomplétion de code.
Oui. NVIDIA Build offre un moyen hébergé de prototyper avec GLM-5.2 avant de prendre une décision de déploiement plus importante. Les équipes peuvent utiliser ce type de point de terminaison pour mener des évaluations internes avant de décider d’adopter le modèle, d’y acheminer des requêtes, de l’auto-héberger ou de l’écarter.
Les équipes devraient exécuter le même ensemble de tâches réelles issues de dépôts sur les modèles candidats. Une bonne évaluation doit suivre la justesse des correctifs, les tests, le temps de revue, les modifications sans rapport, le coût, le risque lié aux données et le respect, par le modèle, des règles d’escalade.
En général, non. Les modifications à faible risque, le travail d’architecture ambigu, les changements sensibles en matière de sécurité et les tâches de vérification formelle ont des exigences différentes. Un workflow multi-modèles avec des règles claires d’acheminement et de revue est plus sûr que de forcer toutes les tâches à passer par un seul modèle.
GLM-5.2](https://build.nvidia.com/z-ai/glm-5.2) : point de terminaison NVIDIA Build et fiche descriptive du modèle pour GLM-5.2.
Les modèles de code à poids ouverts s’intègrent de plus en plus aux systèmes d’ingénierie pratiques. Leur valeur ne se limite plus aux performances sur les benchmarks ; elle dépend désormais de l’endroit où ils s’insèrent dans le flux de travail, de la manière dont ils sont acheminés et de la façon dont leurs résultats sont examinés.
Copilot fait du choix du modèle une composante du développement quotidien. Leanstral oriente vers une ingénierie fondée sur la vérification et la démonstration formelle. GLM-5.2 montre comment des modèles ouverts hébergés peuvent être testés avant de prendre des décisions de déploiement plus poussées.
Les équipes devraient évaluer ces modèles à partir de tâches réelles sur des dépôts, avec des frontières de données clairement définies, des relevés de tests et des politiques de revue.
L’approche la plus sûre n’est pas un modèle universel unique, mais un flux de travail contrôlé dans lequel chaque modèle a un rôle défini.
La configuration gagnante, ce n’est pas « utiliser partout le modèle le plus récent ». C’est « affecter le bon modèle à la bonne tâche, puis vérifier le résultat ».
Partez d’une phrase et obtenez un site complet en quelques minutes.