GPT-6 est encore récent, mais OpenAI réfléchit déjà bien au-delà de cette génération.
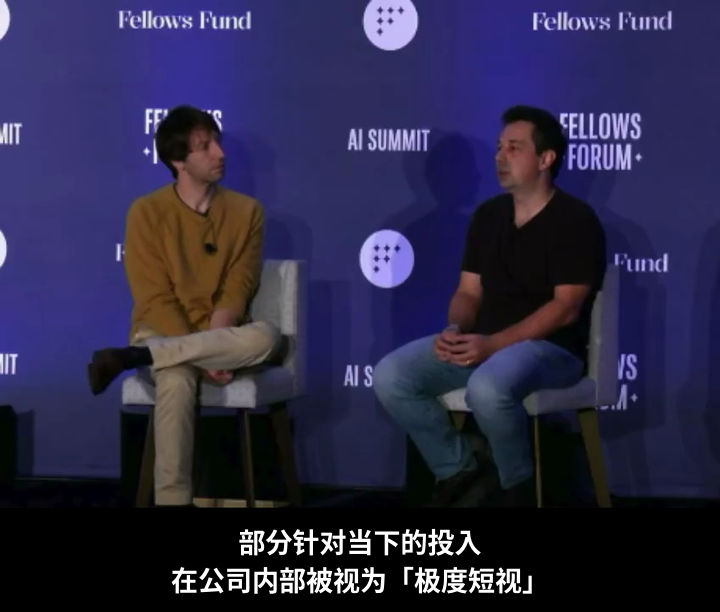
Lors du Fellows Forum AI Summit, le 23 septembre 2026, Boris Power, responsable de la recherche appliquée chez OpenAI, a estimé qu’environ 80 % à 90 % des recherches de l’entreprise sont déjà axées sur :
GPT-7
GPT-8
et les générations ultérieures
Cette remarque a été formulée lors d’un échange public avec Zachary Lipton sur la manière dont les modèles de pointe passent de la recherche aux agents et aux systèmes du monde réel.
Le propos de Power n’était pas de dire que GPT-6 n’a plus d’importance.
OpenAI continue d’améliorer activement la génération actuelle. Plus tôt en septembre, l’entreprise a lancé GPT-6 Astra, son modèle GPT-6 aux capacités les plus élevées. Le 22 septembre, elle a élargi la famille avec les modèles plus rapides et moins coûteux GPT-6 Sol et GPT-6 Luna.
Cela semble créer une contradiction :
- Si la plupart des efforts de recherche sont déjà tournés vers GPT-7 et GPT-8, pourquoi continuer d’optimiser GPT-6 ?
- Si l’objectif consiste à rendre les modèles plus performants, pourquoi investir également dans des variantes plus petites et moins chères ?
L’explication de Power relie ces deux dimensions.
OpenAI peut continuer à améliorer les modèles actuels, car ces corrections rendent les produits d’aujourd’hui meilleurs et apportent des enseignements utiles aux équipes de recherche. En même temps, les gains les plus importants à long terme pourraient provenir de la création d’un modèle de nouvelle génération beaucoup plus puissant, puis de l’utilisation de ce modèle pour contribuer à entraîner des systèmes moins coûteux.
Le résultat est une stratégie à deux voies :
faire progresser la frontière des capacités
+
faire baisser le coût des capacités utiles
Pourquoi améliorer le modèle actuel peut être « extrêmement myope »
Power a employé une formulation inhabituellement forte pour certains travaux portant sur les systèmes de génération actuelle.
Il a déclaré que certains investissements destinés aux modèles actuels étaient considérés en interne comme « extrêmement myopes ».
Cela ne signifie pas que ce travail soit inutile.
Supposons qu’un modèle actuel ait des difficultés avec l’appel d’outils.
Une équipe pourrait :
- Collecter des exemples de l’échec.
- Ajouter de meilleures données d’entraînement.
- Ajuster le processus d’entraînement ou d’évaluation.
- Relancer les tests.
- Déployer une amélioration.
Cette démarche peut immédiatement améliorer le produit.
Elle peut aussi aider les chercheurs à comprendre pourquoi le modèle a échoué et quelles interventions ont été efficaces.
L’avertissement de Power concerne la durée de vie de la correction.
Un problème qui exige une intervention attentive dans GPT-6 peut disparaître naturellement dans GPT-7, parce que la génération suivante est tout simplement meilleure dans la capacité sous-jacente.
Autrement dit :
le correctif d’aujourd’hui
peut devenir
la solution de contournement obsolète de demain
C’est pourquoi les organisations de recherche doivent constamment décider quels problèmes méritent un investissement approfondi.
Le travail à court terme reste important
Le fait qu’une correction puisse devenir obsolète ne signifie pas que les utilisateurs peuvent attendre.
Les utilisateurs emploient les produits actuels dès aujourd’hui.
Si un modèle perd régulièrement de vue un objectif, n’utilise pas correctement un outil ou exige trop de supervision manuelle, ce problème reste important.
La distinction établie par Power se situe donc entre :
ce qui améliore le produit maintenant
et :
ce qui crée le plus de valeur de recherche à long terme
La sortie de GPT-6 Astra par OpenAI montre que l’entreprise réalise toujours un travail important dans la première catégorie.
Dans l’annonce officielle d’Astra, OpenAI décrit des améliorations destinées au travail pratique, notamment une utilisation plus rapide de l’ordinateur et une meilleure collaboration dans Codex.
Astra peut poser à l’utilisateur une question ciblée tout en poursuivant le travail qui ne dépend pas de la réponse. Si la décision a des conséquences importantes, il attend. Si l’information manquante est courante, il peut poursuivre sur la base d’une hypothèse raisonnable.
OpenAI indique également qu’Astra est meilleur pour conserver l’objectif et les contraintes d’origine lorsque l’utilisateur ajoute de nouvelles exigences au cours d’une tâche.
Ces détails peuvent sembler moins spectaculaires qu’un score de benchmark, mais ils influencent directement la capacité d’un système d’IA à se comporter davantage comme un outil ou comme un collègue compétent.
Construire d’abord le modèle puissant, puis former le plus petit
La seconde partie de l’argument de Power concerne la taille des modèles.
Pourquoi investir autant dans un modèle de pointe coûteux si de nombreux utilisateurs veulent au final un système plus rapide et moins cher ?
Parce que le modèle plus puissant peut devenir l’enseignant.
Power a décrit un schéma qui ressemble à ceci :
entraîner un modèle général très performant
→ l’utiliser pour générer des exemples de haute qualité
→ sélectionner ou filtrer les sorties utiles
→ entraîner un modèle plus petit sur ces exemples
→ déployer le plus petit modèle à un coût inférieur
Il s’agit d’une forme de distillation de modèles.
Le modèle élève n’a pas besoin de reproduire toutes les capacités de l’enseignant.
Il lui suffit d’hériter d’une part suffisante des comportements utiles de l’enseignant pour la tâche visée.
C’est pourquoi le travail sur un modèle de pointe peut aussi compter pour les clients qui n’utiliseront jamais directement ce modèle de pointe.
OpenAI a déjà utilisé ce modèle
OpenAI a décrit publiquement la distillation lors de générations de produits antérieures.
En mars 2025, lorsque l’entreprise a introduit une nouvelle génération de modèles audio, elle a indiqué avoir utilisé des méthodes avancées de distillation pour transférer les connaissances de modèles audio plus grands vers des systèmes plus petits et plus efficaces.
L’entreprise a également décrit l’utilisation de données d’auto-jeu afin de capturer des dynamiques conversationnelles plus réalistes, permettant aux modèles plus petits de rester utiles et réactifs.
Un exemple distinct du Cookbook d’OpenAI permet de visualiser plus facilement l’idée enseignant-élève.
L’exemple utilise GPT-4o comme enseignant pour GPT-4o mini dans une tâche de classification de cépages.
Sur un ensemble de validation de 300 exemples, les précisions rapportées étaient les suivantes :
GPT-4o :
79,67 %

GPT-4o mini :
64,67 %

GPT-4o mini distillé :
79,33 %
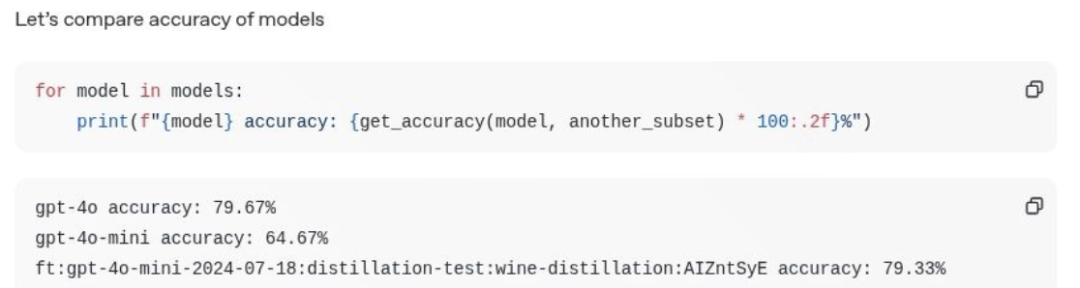
Le modèle élève distillé a presque égalé l’enseignant sur cette tâche spécifique.
Cela ne signifie pas que le modèle plus petit est devenu globalement équivalent à GPT-4o.
Cela signifie qu’un enseignant performant peut transférer un comportement ciblé avec une efficacité suffisante pour rendre un modèle plus petit bien plus utile dans une charge de travail restreinte.
Astra, Sol et Luna suivent la même logique générale
La famille GPT-6 applique une idée semblable à l’échelle du produit, bien qu’OpenAI n’ait pas publié de recette d’entraînement complète qui justifierait de qualifier Luna simplement d’« Astra distillé ».
OpenAI indique que GPT-6 Sol et GPT-6 Luna ont été entraînés avec des méthodes similaires à celles utilisées pour GPT-6 Astra, apportant les avancées de la génération Astra dans des modèles plus rapides et plus abordables.
L’entreprise positionne la famille de cette manière :
GPT-6 Astra
capacités les plus élevées

GPT-6 Sol
solides performances généralistes à moindre coût

GPT-6 Luna
modèle bien moins coûteux pour les travaux à grand volume
La tarification officielle de GPT-6 d’OpenAI lors de la sortie du 22 septembre était la suivante :
| Transition de modèle | Entrée | Sortie | Réduction |
|---|---|---|---|
| GPT-5.6 Sol → GPT-6 Sol | 4 $ → 2 $ / 1 M de tokens | 20 $ → 10 $ / 1 M de tokens | 50 % |
| GPT-5.6 Luna → GPT-6 Luna | 0,20 $ → 0,10 $ / 1 M de tokens | 1,20 $ → 0,50 $ / 1 M de tokens | 50 % |
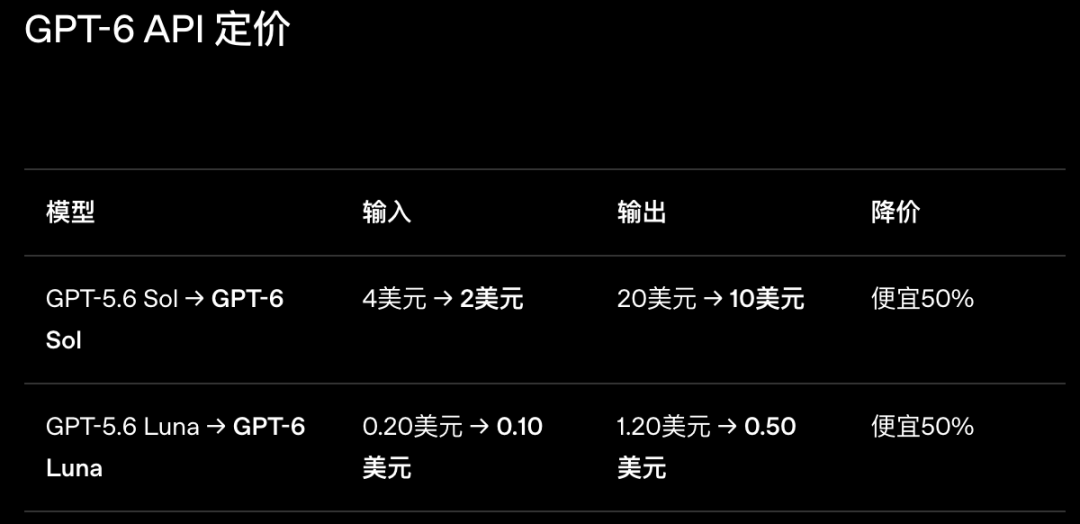
OpenAI décrit explicitement l’objectif comme la diffusion d’une intelligence de pointe auprès de différents budgets et charges de travail.
Un modèle plus grand relève le plafond.
Des modèles plus petits font entrer une plus grande part de ces capacités dans les usages quotidiens.
Pourquoi ne pas utiliser le plus grand modèle pour tout ?
Parce que la plupart des flux de travail ne présentent pas le même niveau de difficulté du début à la fin.
Un rapport de projet offre un exemple utile.
Imaginez plusieurs documents sources qui :
- Emploient des définitions incohérentes.
- S’opposent sur des chiffres clés.
- Contiennent des éléments de preuve manquants.
- Mènent à des conclusions différentes.
La première partie du travail exige un jugement plus solide.
Un modèle performant peut :
- Réconcilier les sources contradictoires.
- Identifier les affirmations non étayées.
- Signaler les preuves manquantes.
- Proposer une structure cohérente.
- Déterminer quels problèmes nécessitent une revue humaine.
Creez un site vitrine et genere des leads en quelques minutes
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Une fois l’orientation arrêtée, de nombreuses étapes restantes deviennent plus routinières.
Un modèle plus petit peut être parfaitement adapté pour :
- Reformater les contenus.
- Transformer des notes vérifiées en sections.
- Générer des variantes répétées.
- Appliquer un modèle connu.
- Mettre à jour des tableaux.
- Produire des résumés simples.
Si une nouvelle ambiguïté apparaît, la tâche peut être renvoyée vers le modèle plus puissant.
Un flux de travail pratique peut donc ressembler à ceci :
modèle puissant
→ jugement difficile

petit modèle
→ exécution répétitive

modèle puissant
→ gestion des exceptions
La véritable métrique est le coût total du flux de travail
Des tokens moins chers ne signifient pas automatiquement un travail moins coûteux.
Un petit modèle peut coûter moins par requête tout en créant davantage de travail pour l’utilisateur s’il nécessite :
- Des prompts plus détaillés.
- Davantage de décomposition manuelle des tâches.
- Davantage de vérifications.
- Davantage de tentatives.
- Davantage de corrections.
- Davantage d’escalades.
La question utile n’est donc pas :
Quel modèle présente le prix par token le plus bas ?
Elle est :
Quel est le coût du résultat final accepté dans son ensemble ?
Ce total comprend à la fois le coût machine et le temps humain.
Une facture API plus basse n’apporte pas un grand avantage si l’utilisateur doit devenir gestionnaire de projet IA à temps plein pour permettre au modèle moins cher de réussir.
La meilleure répartition du travail dépend donc de la tâche.
Un petit modèle est utile lorsqu’il peut exécuter de manière fiable un travail bien défini à faible coût.
Un modèle plus grand justifie son prix supérieur lorsque la tâche exige véritablement un jugement plus fort.
Les rôles humains évoluent à mesure que les modèles deviennent plus capables
Power a également décrit une évolution de la manière dont les personnes interagissent avec les générations successives de modèles.
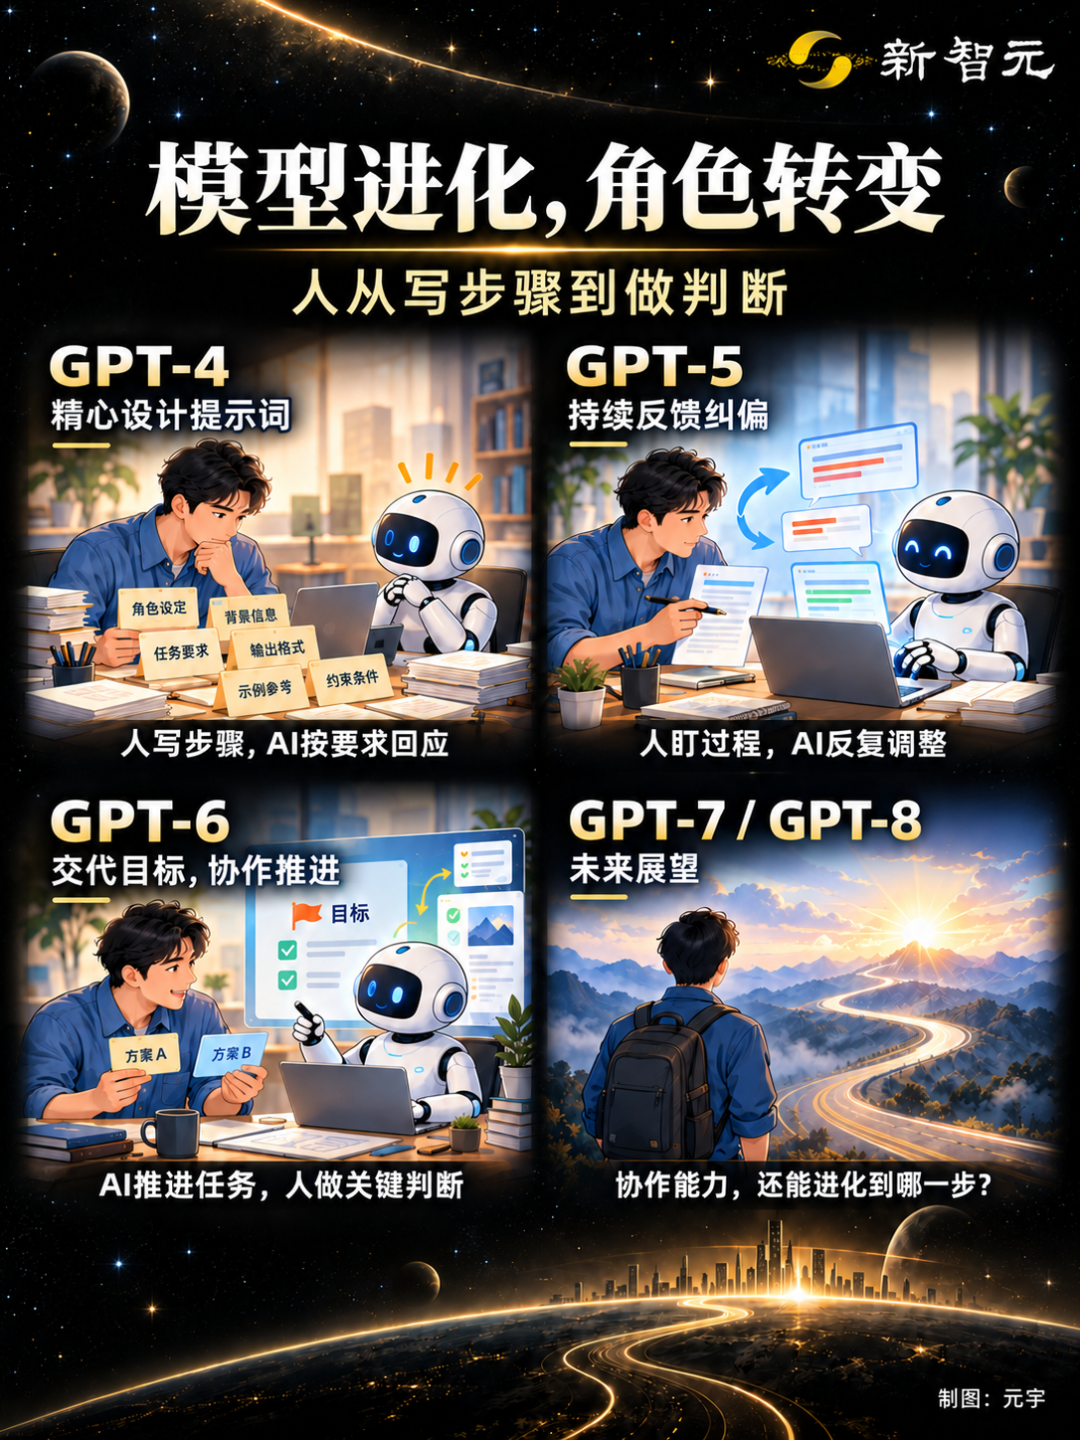
L’article source résume approximativement la progression ainsi :
GPT-4 :
les humains conçoivent soigneusement les étapes

GPT-5 :
les humains guident le processus et corrigent en continu

GPT-6 :
les humains énoncent de plus en plus l’objectif et supervisent les décisions clés
Il s’agit d’une simplification, et non d’une garantie pour chaque tâche.
Mais la documentation d’Astra d’OpenAI décrit la même direction générale.
Astra peut :
- Continuer un travail indépendant en attendant la réponse d’un utilisateur.
- Utiliser le contexte pour combler des lacunes courantes.
- S’arrêter et demander une clarification lorsqu’une décision pourrait modifier sensiblement le résultat.
- Préserver les objectifs et les contraintes à mesure qu’une tâche évolue.
- Rechercher le contexte antérieur lors de longues sessions dans Codex.
Cela change le rôle humain.
Au lieu de spécifier manuellement chaque étape, l’utilisateur fait de plus en plus quelque chose qui s’apparente à :
définir l’objectif
→ fixer les contraintes
→ examiner les choix conséquents
→ contrôler le résultat
La question clé pour GPT-7 et GPT-8 est de savoir jusqu’où ce changement peut aller.
La métrique importante pour les utilisateurs est la charge de supervision
Les progrès des modèles sont souvent présentés au moyen de scores de benchmark.
Pour le travail quotidien, une autre métrique peut être plus importante :
Quelle quantité de supervision l’utilisateur doit-il encore fournir ?
Après avoir donné un objectif au modèle :
- En combien d’étapes l’utilisateur doit-il encore décomposer le travail ?
- Combien de fois doit-il rappeler au modèle ce qui compte ?
- À quelle fréquence le modèle perd-il les contraintes initiales ?
- Combien de tentatives échouées doivent être nettoyées ?
- À quelle fréquence l’utilisateur doit-il reprendre la main ?
Si GPT-7 ou GPT-8 réduit ces charges, cela peut être plus précieux qu’une faible amélioration sur un benchmark.
C’est aussi pourquoi la recherche sur des modèles plus grands et le travail sur des modèles plus petits se renforcent mutuellement.
Le modèle de pointe cherche à découvrir des comportements plus capables.
Le modèle moins coûteux cherche à rendre une part suffisante de ces comportements abordable à grande échelle.
Ce que signifie réellement le chiffre de 80 à 90 % avancé par Power
Le chiffre mis en avant nécessite une qualification importante.
La déclaration de Power sur les « 80 % à 90 % » était une estimation formulée au cours d’un échange public.
Il ne s’agissait pas :
- D’une ventilation auditée du budget de recherche.
- D’un tableau public des effectifs.
- D’une divulgation de l’allocation de capacité de calcul.
- D’une feuille de route produit.
- D’une annonce de date de sortie pour GPT-7 ou GPT-8.
Le programme du Fellows Forum confirme que Power intervenait en tant que responsable de la recherche appliquée chez OpenAI lors d’un échange informel du 23 septembre, intitulé « Where Models Meet Reality ».
Une couverture indépendante de l’enregistrement situe la remarque sur les 80 % à 90 % aux environs de 1:32:52 dans l’enregistrement complet de l’événement.
L’interprétation la plus prudente est donc la suivante :
Power estime que la très grande majorité de l’attention de recherche d’OpenAI est dirigée vers des générations de modèles postérieures à GPT-6, car c’est là qu’il prévoit les gains fondamentaux les plus importants.
Cette affirmation ne doit pas être interprétée comme une déclaration comptable littérale.
Note de calendrier : GPT-6.1 Sol est arrivé après le Fellows Forum
Power a formulé ses remarques le 23 septembre.
Six jours plus tard, le 29 septembre, OpenAI a publié GPT-6.1 Sol.
Ce modèle n’est pas au cœur de l’argument de l’article d’origine, car la discussion se concentre sur la logique enseignant-élève Astra → Sol/Luna décrite par Power lors de l’événement.
Il reste toutefois utile comme contexte pour les lecteurs qui publient cet article maintenant.
OpenAI décrit GPT-6.1 Sol comme la famille de modèles la plus récente de la série GPT-6, avec des capacités proches d’Astra pour le codage, l’utilisation d’ordinateurs et le travail professionnel, à un prix API standard beaucoup plus bas.
Son existence renforce le même schéma abordé dans l’entretien :
les capacités de pointe progressent
→ les modèles moins coûteux en absorbent une plus grande part
→ les utilisateurs obtiennent de meilleures performances à moindre coût
Elle montre également pourquoi les noms des différentes versions intermédiaires importent moins que la stratégie de recherche globale.
FAQ
OpenAI a-t-il réellement déclaré que 80 à 90 % de ses recherches sont axées sur GPT-7 et GPT-8 ?
Boris Power, responsable de la recherche appliquée chez OpenAI, a estimé lors du Fellows Forum 2026 qu’environ 80 % à 90 % des recherches d’OpenAI sont axées sur GPT-7, GPT-8 et les générations suivantes. Ce chiffre était son estimation publique, et non un rapport audité d’allocation des ressources de l’entreprise.
OpenAI a-t-il annoncé GPT-7 ou GPT-8 ?
Aucune date de lancement publique ni feuille de route produit détaillée pour GPT-7 ou GPT-8 n’a été annoncée dans les propos de Power. Il a utilisé ces noms pour désigner les générations postérieures à GPT-6 qui, selon lui, reçoivent l’essentiel de l’attention de recherche à long terme.
Pourquoi OpenAI continue-t-il d’améliorer GPT-6 si la recherche est déjà passée à la suite ?
Le travail sur la génération actuelle améliore les produits d’aujourd’hui et offre aux chercheurs un retour d’information plus rapide. Le point de Power est que certaines corrections peuvent être de courte durée, car un modèle de nouvelle génération plus capable peut faciliter le problème sous-jacent ou le supprimer complètement.
Qu’est-ce que la distillation de modèles ?
La distillation de modèles désigne une famille de techniques dans lesquelles un modèle enseignant plus puissant aide à entraîner un modèle élève plus petit. Un flux courant consiste à utiliser l’enseignant pour générer des exemples de haute qualité, à filtrer ces exemples, puis à entraîner le modèle plus petit à reproduire le comportement nécessaire pour une tâche cible.
GPT-6 Sol et Luna sont-ils seulement des versions plus petites d’Astra ?
OpenAI indique que Sol et Luna ont été entraînés avec des méthodes similaires à celles d’Astra et qu’ils héritent des avancées de la même génération, mais l’entreprise n’a pas publié suffisamment de détails pour décrire Luna ou Sol simplement comme des copies compressées d’Astra. Il est plus exact de dire qu’ils apportent des avancées de capacités connexes à des niveaux de coût inférieurs.
Combien coûtent GPT-6 Sol et Luna ?
Lors de leur lancement du 22 septembre, OpenAI a fixé le prix de GPT-6 Sol à 2 $ par million de tokens d’entrée et 10 $ par million de tokens de sortie, et celui de GPT-6 Luna à 0,10 $ pour l’entrée et 0,50 $ pour la sortie par million de tokens. OpenAI a présenté les deux modèles comme 50 % moins chers que les prix promotionnels de leurs équivalents GPT-5.6.
Quand une équipe doit-elle utiliser un grand modèle plutôt qu’un petit modèle ?
Utilisez le modèle plus puissant lorsque la tâche exige un jugement difficile, un raisonnement ambigu, la gestion d’exceptions ou des décisions importantes. Les modèles plus petits sont souvent mieux adaptés aux travaux répétitifs, clairement spécifiés et à grand volume, une fois l’orientation principale établie.
Comment le rôle de l’utilisateur évolue-t-il avec les modèles récents ?
La tendance consiste à passer de la rédaction de chaque étape à la définition des objectifs, à la fixation des contraintes et à la revue des décisions importantes. La documentation d’Astra d’OpenAI décrit notamment les questions asynchrones, la poursuite du travail pendant l’attente d’une réponse et une meilleure conservation de l’objectif d’origine au cours de longues tâches.
Outils associés
- ChatGPT : l’interface principale d’OpenAI pour utiliser les modèles GPT actuels dans le travail quotidien.
- Codex : l’environnement de codage agentique d’OpenAI destiné aux tâches logicielles de longue durée.
- OpenAI API : la documentation officielle destinée aux développeurs qui intègrent des modèles GPT et des outils dans des applications.
- OpenAI Cookbook : exemples et guides officiels, dont un guide archivé sur la distillation de modèles.
- Journal des modifications pour développeurs OpenAI : historique officiel des sorties de modèles, fonctionnalités API, notes de tarification et changements de plateforme.
Liens associés
- Article original de BAAI Hub : article New Intelligence en langue chinoise adapté et vérifié dans cet article.
- Fellows Forum 2026 : site officiel de l’événement qui répertorie la session de Boris Power, « Where Models Meet Reality ».
- GPT-6 Astra : annonce officielle d’OpenAI sur Astra, couvrant la collaboration, Codex, l’utilisation d’ordinateurs et le contexte sur de longues sessions.
- Présentation de GPT-6 Sol et Luna : tarification officielle, positionnement des modèles et explication de la manière dont les modèles GPT-6 à moindre coût héritent des avancées d’Astra.
- Présentation des modèles audio de nouvelle génération : description par OpenAI en 2025 de la distillation de modèles audio plus grands vers des systèmes plus petits et plus efficaces.
- OpenAI Cookbook — Distillation de modèles : exemple officiel enseignant-élève utilisant GPT-4o et GPT-4o mini.
- Journal des modifications de l’API OpenAI : historique officiel des versions pour GPT-6 Sol, Luna, GPT-6.1 Sol et les mises à jour API associées.
- Addendum de sécurité de GPT-6.1 Sol : document officiel d’OpenAI du 29 septembre identifiant GPT-6.1 comme la famille de modèles la plus récente de la série GPT-6.
Résumé
L’estimation de Boris Power, comprise entre 80 % et 90 %, facilite la compréhension de la stratégie de recherche d’OpenAI. L’entreprise peut continuer d’améliorer les produits GPT-6 actuels tout en orientant l’essentiel de son attention de recherche à long terme vers les générations futures, où elle attend des gains de capacités plus importants.
La seconde partie de cette stratégie est tout aussi importante. Les modèles de pointe plus puissants n’ont pas de valeur uniquement comme produits premium ; ils peuvent aussi servir d’enseignants et de plateformes de recherche permettant de transférer des capacités utiles vers des systèmes plus rapides et moins coûteux, comme Sol et Luna.
Pour les utilisateurs, la question pratique n’est pas de savoir quel modèle est le plus grand. Il s’agit de répartir le travail afin que les décisions difficiles soient confiées au modèle capable de les gérer, tandis que l’exécution routinière est confiée au modèle le moins coûteux qui peut la réaliser de manière fiable.
Le pari à long terme d’OpenAI semble simple : continuer à relever le plafond des capacités, puis rendre une part croissante de ces capacités suffisamment abordable pour un usage quotidien.