For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/claude-haiku-5-pricing-benchmarks-gpt-6-l-8951f544.md.
Anthropicは、これまでで最も高速かつ低コストな小型モデルである**Claude Haiku 5.5**をリリースしました。

Anthropicは、これまでで最も高速かつ低コストな小型モデルであるClaude Haiku 5.5をリリースしました。
このモデルは2026年10月7日に正式リリースされました。あらゆるリクエストで可能な限り強力なモデルを使うことよりも、速度、処理量、コストが重要になる業務向けに設計されています。
Anthropicは、Haiku 5.5を次のようなタスク向けに位置付けています。
最も注目を集めているのは、短いプロンプトに対する次の料金です。
入力:
100万トークンあたり0.10ドル

出力:
100万トークンあたり0.50ドル
これは、入力が10万トークンまでのプロンプトに適用されます。
この料金は、Haiku 4.5の表示価格における入力・出力料金の10分の1であり、Sonnet 5.5の標準入力・出力料金の20分の1です。
ただし、料金が下がったからといって、すべての実際のワークロードが90%安くなるわけではありません。
Anthropic自身の推定はより控えめです。長いコンテキストに対する料金と新しいトークナイザーを考慮すると、Haiku 5.5の実行コストはHaiku 4.5よりも平均で約75%低いと説明しています。
さらに意外なのは、このモデルが単に安いだけではないことです。
Anthropicが公開した複数の評価では、Haiku 5.5はHaiku 4.5を大きく上回っています。また、AnthropicがLunaの結果を公開しているすべてのベンチマークで、同程度の価格設定であるOpenAIのGPT-6 Lunaも上回っています。
とはいえ、Haiku 5.5が難しいコーディングや自由度の高いエージェント作業において、Sonnet 5.5やOpus 5.5の代替になるわけではありません。
Anthropicは、こうしたタスクには明確に上位モデルを推奨しています。
Haiku 5.5を理解するうえで適切なのは、処理量の多い業務を担うワーカーであり、従来のHaikuモデルよりもはるかに本格的なエージェントタスクを処理できるほど強力になったモデルだと考えることです。
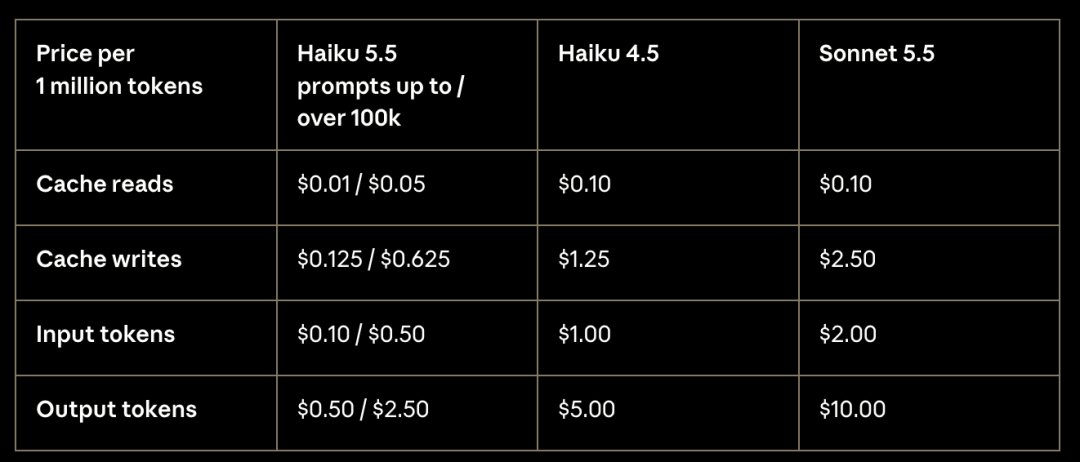
料金体系は2段階に分かれています。
入力が10万トークンまでのプロンプトでは、次の料金が適用されます。
| トークン種別 | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| キャッシュ読み取り | 100万あたり0.01ドル | 100万あたり0.10ドル | 100万あたり0.10ドル |
| キャッシュ書き込み | 100万あたり0.125ドル | 100万あたり1.25ドル | 100万あたり2.50ドル |
| 入力 | 100万あたり0.10ドル | 100万あたり1.00ドル | 100万あたり2.00ドル |
| 出力 | 100万あたり0.50ドル | 100万あたり5.00ドル | 100万あたり10.00ドル |
入力が10万トークンを超えるプロンプトでは、Haiku 5.5の料金は次のように変わります。
キャッシュ読み取り:
100万あたり0.05ドル

キャッシュ書き込み:
100万あたり0.625ドル

入力:
100万あたり0.50ドル

出力:
100万あたり2.50ドル
バッチ処理では、入力トークンと出力トークンが50%割引になります。
Anthropicによると、以前のHaikuモデルに対するリクエストの約90%は、プロンプトが10万トークン未満でした。そのため、一般的な大量処理の導入では、低い料金帯が非常に重要になります。
短いプロンプトに対する料金は、Haiku 4.5より90%低くなっています。
しかし、Anthropicは実際の平均削減率を約**75%**と見積もっています。
主な理由は2つあります。
プロンプトの入力が10万トークンを超えると、Haiku 5.5の料金は5倍に上がります。
その場合でもHaiku 4.5より安価ですが、削減率は90%ではなく50%になります。
Haiku 5.5は、Claude 4.7以降のモデルで使用されている新しいトークナイザーを採用しています。
Anthropicの移行ガイドによると、同じ入力テキストでもHaiku 5.5ではHaiku 4.5よりおよそ次の割合で増加します。
30%多いトークン数
正確な増加率はコンテンツによって異なります。
この変更は次の項目に影響します。
max_tokensしたがって、開発者はHaiku 4.5で数えたトークン数に、Haiku 5.5の新しいトークン料金を単純に掛けるべきではありません。
新しいモデルでテキストを再度カウントする必要があります。
標準的な短いコンテキストのリクエストでは、2つのモデルをトークン料金で直接比較できます。
OpenAIが現在掲載しているGPT-6 Lunaの料金は次のとおりです。
入力:
100万あたり0.10ドル

キャッシュ入力:
100万あたり0.01ドル

キャッシュ書き込み:
100万あたり0.125ドル

出力:
100万あたり0.50ドル
これらはHaiku 5.5の短いプロンプトに対する料金と一致します。
ただし、長いコンテキストに対する料金のしきい値は大きく異なります。
高い料金帯は、プロンプトが次の値を超えた時点で始まります。
入力10万トークン
その後は次の料金になります。
入力:
100万あたり0.50ドル

キャッシュ読み取り:
100万あたり0.05ドル

出力:
100万あたり2.50ドル
OpenAIの長いコンテキスト向け料金は、次の値を超えると始まります。
入力272,000トークン
その後は次の料金に変わります。
入力:
100万あたり0.20ドル

キャッシュ入力:
100万あたり0.02ドル

出力:
100万あたり0.75ドル
したがって、原記事が短いコンテキストと長いコンテキストを区別しているのは妥当です。
10万トークン未満のプロンプトでは、標準料金はほぼ一致します。
非常に長いプロンプトでは、Lunaの長いコンテキスト向け料金のほうが現在は大幅に低く、より大きなプロンプトになるまで高い料金帯も適用されません。
これは、長い文書や大規模なエージェント履歴におけるモデルルーティングの判断を大きく変える可能性があります。
AnthropicはHaiku 5.5のリリースに合わせて、もう1つ重要なコストを引き下げました。
Claude Sonnet 5.5のキャッシュ読み取り料金は、次のように下がりました。
100万トークンあたり0.20ドル
から、次の料金へ変更されています。
100万トークンあたり0.10ドル
Anthropicは、長時間稼働するエージェントではキャッシュ読み取りがトークンの大きな割合を占める可能性があるため、これによりSonnet 5.5のコストは多くのエージェント型ワークロードで約20%低下すると見積もっています。
これにより、モデルファミリーの役割分担がより明確になります。
Haiku 5.5
→ 最も安価で高速な大量処理

Sonnet 5.5
→ より強力で範囲が明確な業務とコーディング

Opus 5.5
→ 最も難しい自由度の高い業務と複雑なエージェント
世代間の改善が最も明確に表れるのは、ベンチマーク表です。
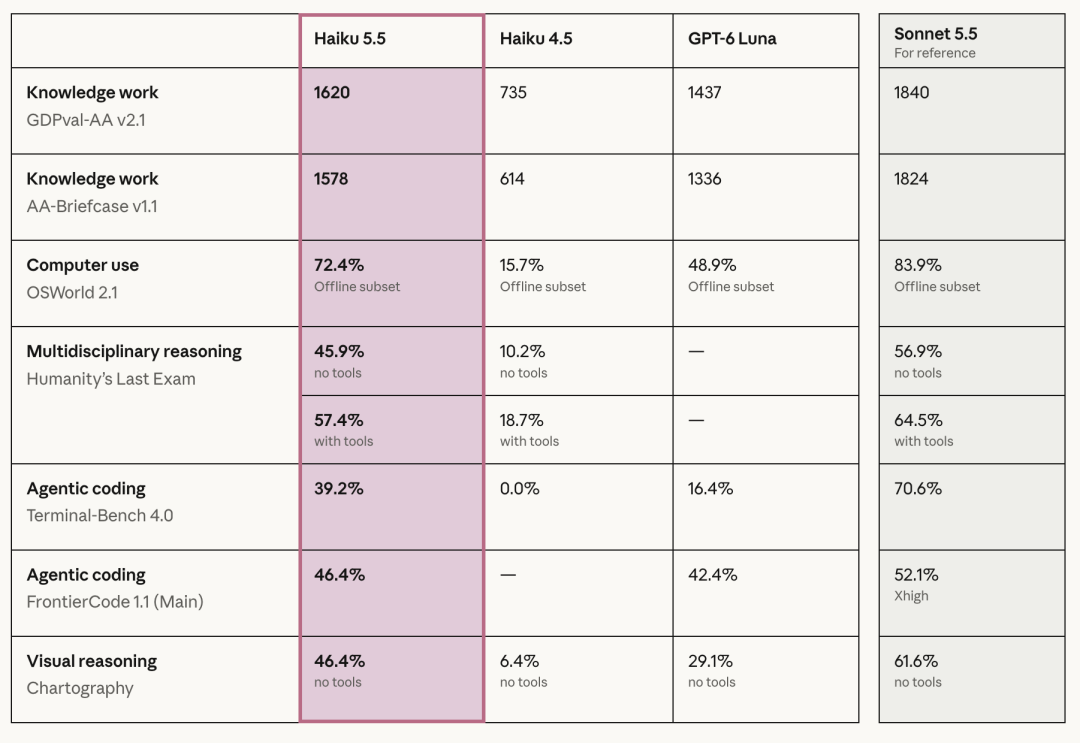
Anthropicの報告値は次のとおりです。
| ベンチマーク | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 offline | 72.4% | 15.7% | 48.9% | 83.9% |
| HLE、ツールなし | 45.9% | 10.2% | — | 56.9% |
| HLE、ツールあり | 57.4% | 18.7% | — | 64.5% |
| Terminal-Bench 4.0 | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1 Main | 46.4% | — | 42.4% | 52.1% Xhigh |
| Chartography | 46.4% | 6.4% | 29.1% | 61.6% |
Anthropicが公開した表では、Lunaのスコアが掲載されているすべての行で、Haiku 5.5がGPT-6 Lunaを上回っています。
2つのモデルが同じ短いコンテキスト向け入力・出力料金を持つことを考えると、注目すべき結果です。
ただし、これらはAnthropicが公開したベンチマーク比較です。
Haiku 5.5があらゆるワークロードでLunaより優れているという普遍的な主張に変えるべきではありません。
本番環境の結果は、次の要素に左右されます。
世代間で最も強い改善が見られるのは、コンピューター操作エージェントの評価であるOSWorld 2.1です。
Haiku 4.5のスコアは次のとおりでした。
15.7%
Haiku 5.5は次に到達しています。
72.4%
Sonnet 5.5は次のとおり、依然として高いスコアです。
83.9%
GPT-6 Lunaは次の値で掲載されています。
48.9%
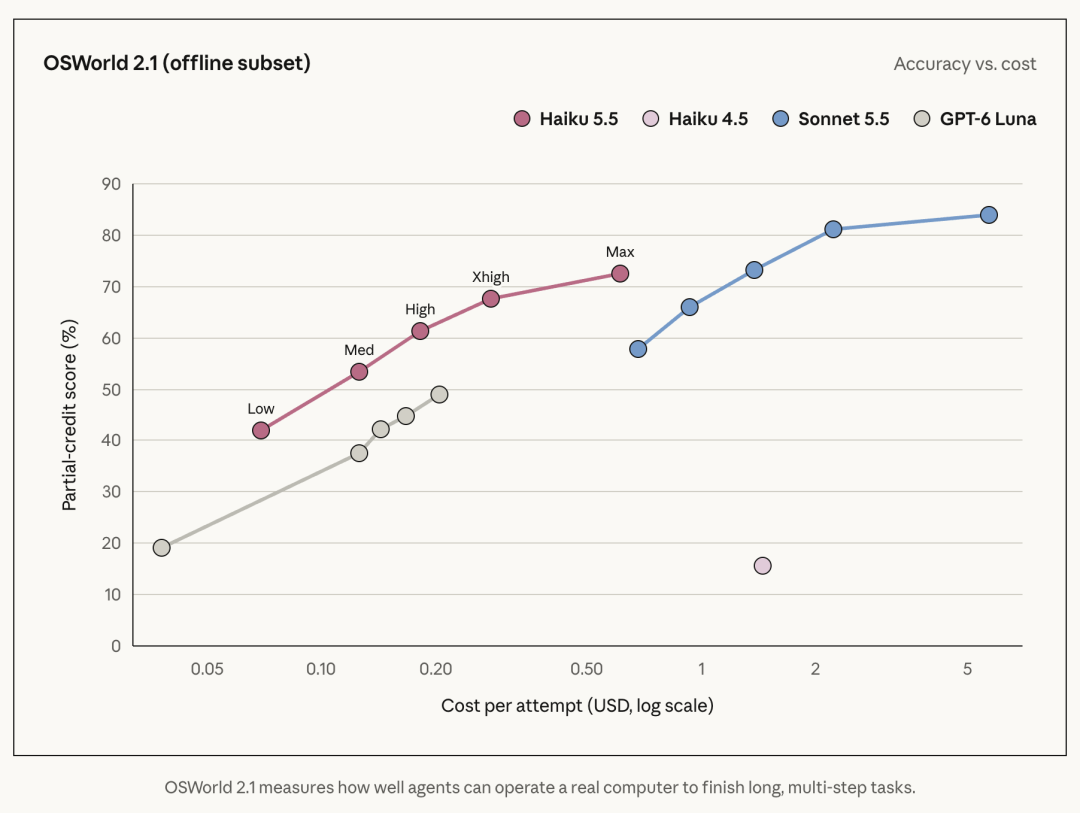
コストパフォーマンスの曲線は特に興味深いものです。
Anthropicのグラフでは、Mediumの努力レベルに設定したHaiku構成が、その評価で示されたLunaの最高点を、試行あたりの測定コストを下げながら上回っています。
これは、2つのモデルの能力や料金が同じであることを意味しません。
しかし、AnthropicがHaiku 5.5をブラウザ操作や、レイテンシの影響を受けやすいその他のエージェントタスク向けに位置付けている理由は示しています。
GDPval-AA v2.1では、Haiku 5.5は次の値に到達しています。
1620 Elo
比較すると、次のとおりです。
Haiku 4.5:
735

GPT-6 Luna:
1437

Sonnet 5.5:
1840
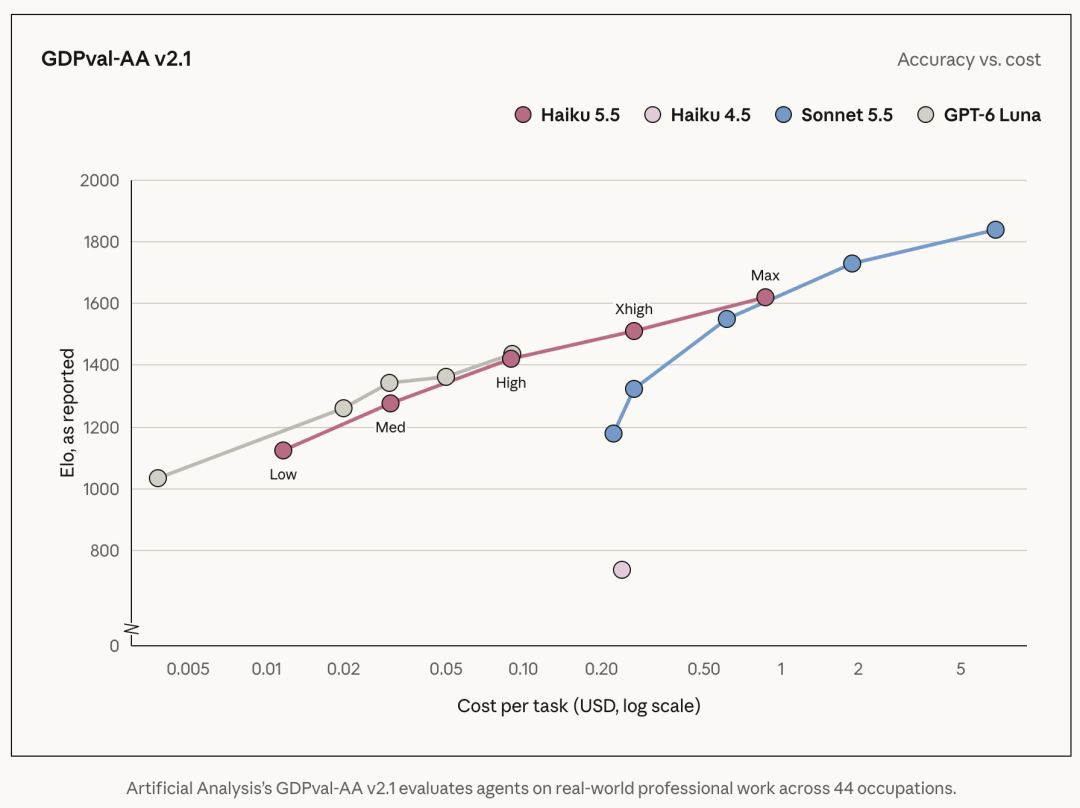
デフォルトのMedium努力レベルでは、HaikuのMax結果よりスコアが低くなりますが、コストも大幅に下がります。
この柔軟性はHaikuファミリーにとって新しいものです。
Claude Haiku 5.5は、努力レベルを調整できる初のHaikuクラスモデルです。
利用可能なレベルは次のとおりです。
low
medium
high
xhigh
max
Claude APIのデフォルト値は次のとおりです。
medium
これにより、推論の深さとコスト・レイテンシのバランスを調整できます。
ルーティングや分類のタスクであれば、lowで十分な場合があります。
より難しい抽出やエージェントタスクでは、より高い努力レベルにして計算量を増やせます。
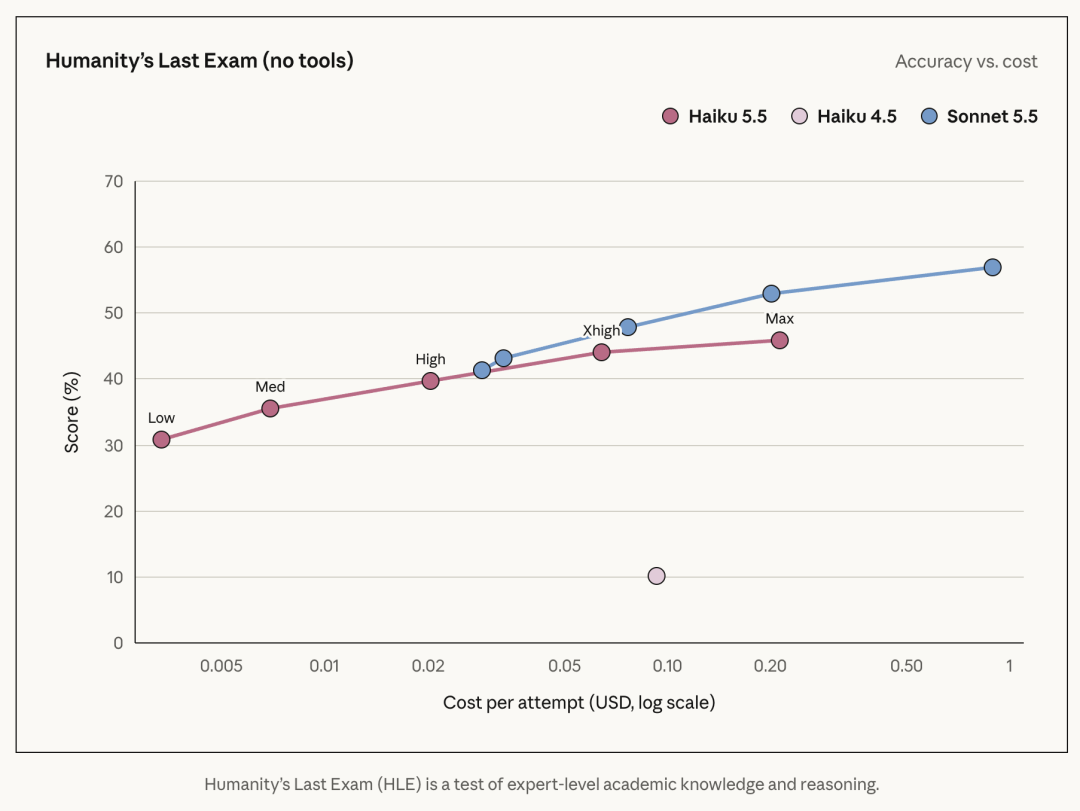
このため、1つのベンチマーク数値だけでは全体像を示せない場合があります。
Haiku 5.5のスコアは、タスクに対して選択した努力レベルによって変わります。
原記事はこの点を慎重に扱っており、公式データもそれを裏付けています。
Terminal-Bench 4.0では次の結果です。
Haiku 5.5:
39.2%

GPT-6 Luna:
16.4%

Sonnet 5.5:
70.6%
FrontierCode 1.1 Mainでは次の結果です。
Haiku 5.5:
46.4%

GPT-6 Luna:
42.4%

Sonnet 5.5:
Xhighで52.1%
特にTerminal-Benchで示されたHaiku 4.5の0.0%と比較すると、Haikuの改善は大きなものです。
ただしAnthropicは、複雑なエージェント型コーディングにはSonnet 5.5とOpus 5.5が依然として適した選択肢だと明確に述べています。
これにより、Haikuの役割はより明確になります。
Haiku:
範囲が限定されたサブタスクの実行

Sonnet:
複雑だが範囲の明確なコーディング

Opus:
最も難しい計画立案と自由度の高いエージェント処理
Anthropicは、Haiku 5.5を次のような業務に推奨しています。
Anthropicは、標準速度ではHaiku 5.5が最速のClaudeモデルだと説明しています。
Opusを別料金のFast Modeに設定した場合を除き、Haiku 5.5がOpusより遅くなることはありません。
このため、レイテンシが製品価値に直接影響する場面でHaiku 5.5は有用です。
Anthropicはリリースに合わせて、複数の顧客評価を公開しました。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
これらは顧客が報告したテストであり、普遍的な性能保証ではありません。
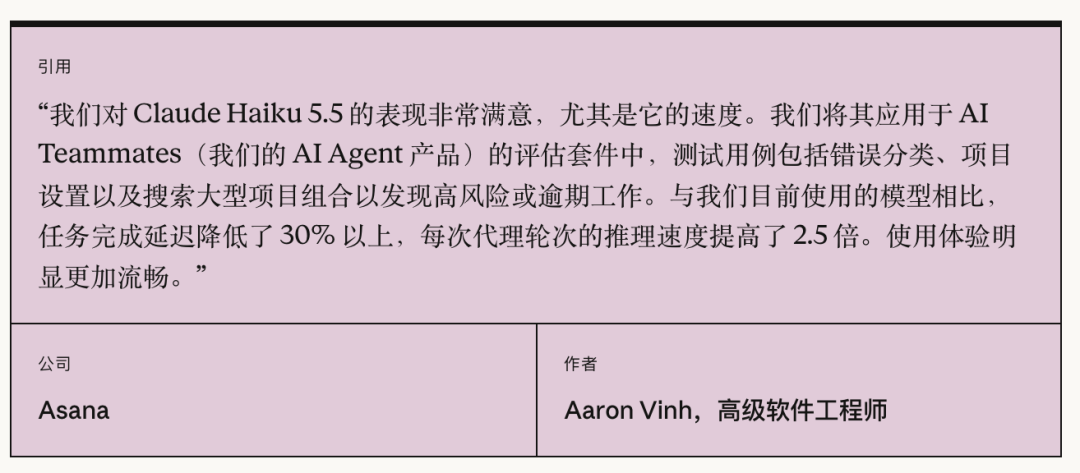
Asanaは、AI TeammatesのテストスイートでHaiku 5.5を評価しました。
タスクには次のようなものが含まれていました。
Asanaは、使用していたモデルと比較して、タスク完了までのレイテンシが30%以上削減され、エージェントの1ターンあたりの推論が最大で2.5倍高速化したと報告しています。
Boxは、初期テストにおいて、Haiku 5.5が約半分のレイテンシでHaiku 4.5より11ポイント高いスコアを記録したと報告しています。
同社は、次のような分析ワークロードを強調しました。
AlphaSenseは、400件の文書質問クエリをテストしました。
評価スコアは次のとおりでした。
Haiku 5.5:
0.84

Haiku 4.5:
0.76
ここで重要なのは規模です。
AlphaSenseによると、この種の「文書内検索」ワークロードは本番環境で週約800万回の呼び出しを処理しています。そのため、コストやレイテンシの小さな変化が運用上重要になります。
最も明確な用途の1つは、より大きなモデルを置き換えることではなく、その下で動作することです。
より大きなモデルは、次の処理を実行できます。
全体のタスクを理解する
→ サブ問題に分解する
→ 範囲を限定した仕事を割り当てる
その後、Haiku 5.5がこれらの仕事を並列で実行できます。
このパターンにより、システムは高価なモデルの処理能力を、重要な部分だけに使えます。
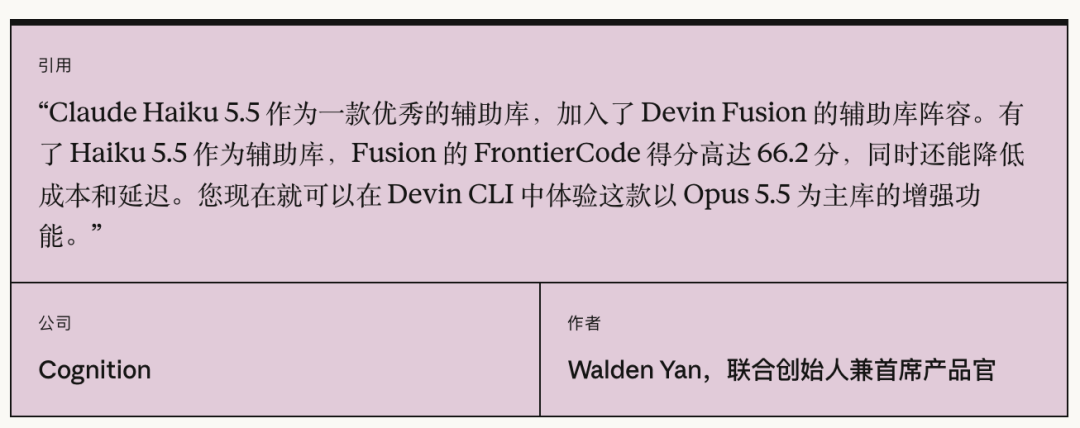
Cognitionによると、Haiku 5.5は現在、Devin Fusion内のサイドキックモデルとして利用できます。
Opus 5.5をリードモデル、Haiku 5.5をサイドキックとして使用した場合、Cognitionはコストとレイテンシを削減しながら、FrontierCodeスコア66.2を報告しています。
これは階層型モデルルーティングの良い例です。
Opus 5.5
→ 計画立案
→ 難しい判断
→ 統合

Haiku 5.5
→ 並列サブタスク
→ 情報検索
→ 範囲を限定した実装
→ 反復的な作業
これは単に「安いモデルを使う」という話ではありません。
「高価なモデルは、それを必要とする仕事にだけ使う」という考え方です。
金融AI企業のRogoも、同様のパターンを説明しています。
大規模なモデルがプレゼンテーション資料を作成する間に、Haiku 5.5のサブエージェントが10-K報告書を検索し、1枚のスライドに必要なセグメント売上高を抽出できます。
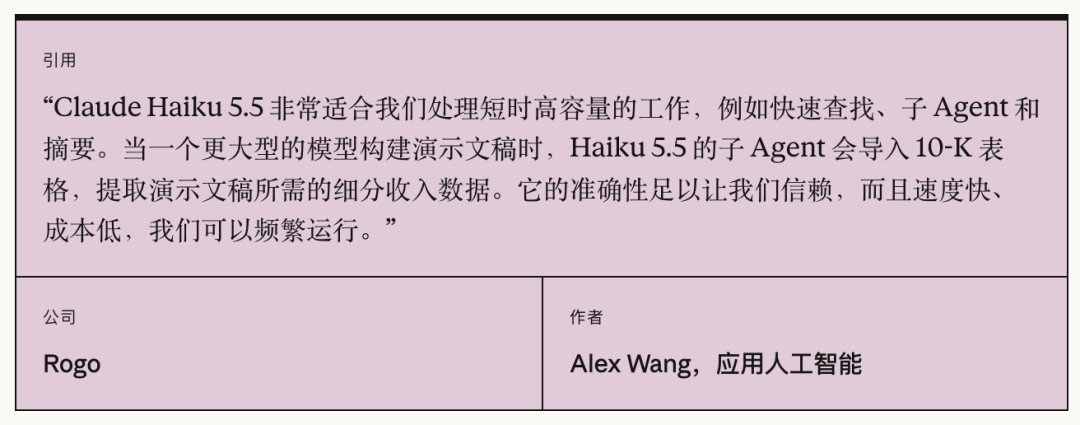
これはHaikuが設計された、まさに次のような限定的で反復可能な仕事です。
具体的な質問
+
既知の情報源
+
大量処理
+
低レイテンシ要件
原記事には、卵落とし設計タスクに関するAnthropicの開発者デモが含まれています。
Opus 5.5が単独で動作した場合、報告された結果は次のとおりです。
3分37秒
25種類の設計をテスト
コスト0.47ドル
Opusが10個のHaiku 5.5サブエージェントを利用した場合、原記事では次の結果が報告されています。
58秒
86種類の設計をテスト
合計コスト0.14ドル
この結果に関する元のBAAI画像は、準備中に安定して読み込めなかったため、ここでは再掲していません。
この例は、特定のエージェントアーキテクチャにおけるAnthropicのデモとして扱うべきであり、速度やコストが一般的に4倍改善する保証ではありません。
目的は並列処理を説明することです。
タスクをきれいに分解できる場合、多数の小型で高速なエージェントは、高価なモデルが順番に処理するよりも多くの可能性を同時に探索できます。
Anthropicの現在のモデルドキュメントには、次の仕様が掲載されています。
| 仕様 | Claude Haiku 5.5 |
|---|---|
| モデルID | claude-haiku-5-5 |
| コンテキストウィンドウ | 1,000,000トークン |
| 最大出力 | 128,000トークン |
| Batch APIの最大出力、ベータ | 300,000トークン |
| 入力 | テキスト、画像 |
| 出力 | テキスト |
| 思考 | アダプティブ |
| デフォルトの努力レベル | medium |
| 信頼できる知識カットオフ | 2026年6月 |
| リリース日 | 2026年10月7日 |
100万トークンのコンテキストウィンドウがデフォルトです。
コンテキストウィンドウ全体を利用するだけであれば、特別なベータヘッダーは必要ありません。
これは原記事で最も重要な実務セクションの1つです。
Anthropicの公式移行ガイドでは、いくつかの破壊的変更または動作変更が確認されています。
Claude APIでは、次のように変更します。
claude-haiku-4-5
→
claude-haiku-5-5
Haiku 5.5のIDは固定されており、日付のサフィックスは使用しません。
同じテキストでも、新しいトークナイザーではトークン数が約30%増えます。
開発者は次の項目を再計算する必要があります。
max_tokensHaiku 4.5では、次の設定を利用できました。
{
  "thinking": {
    "type": "enabled",
    "budget_tokens": 8000
  }
}
Haiku 5.5では、代わりにアダプティブ思考を使用します。
古い手動のbudget_tokens設定を送信すると、400エラーが返されます。
開発者はアダプティブ思考を使用し、effortパラメーターで深さを制御する必要があります。
Anthropicは、Haiku 5.5のリクエストから次の項目を省略することを推奨しています。
temperature
top_p
top_k
デフォルト以外の値を指定すると、400エラーが返される場合があります。
動作の制御には、プロンプトと努力レベルを使用する必要があります。
Haiku 5.5は、最後のメッセージをアシスタントターンとしてモデルに続けさせる従来のパターンをサポートしていません。
構造化形式では、代わりに構造化出力またはツールスキーマを使用することをAnthropicは推奨しています。
Claude APIおよびGoogle Cloudのコンピューター操作統合では、移行ガイドに従い、次へ移行します。
computer_toolset_20260801
現在のツールセットは、1つのコンピューターツールセットのメンバーツールとして、次のようなアクションを公開します。
Anthropicは、コンピューター操作環境に対して強力な分離とアクセス制御を推奨しています。
アプリケーションでは、次の状態を明示的に処理する必要があります。
refusal
model_context_window_exceeded
安全性による拒否は、通常の再試行可能なインフラ障害とは異なります。
AnthropicのHaiku 5.5移行ガイドによると、新しいモデルではPriority Tierはサポートされていません。
既存のHaiku 4.5向けPriority Tier契約があるチームは、容量を別途計画する必要があります。
Anthropicは、Claude API移行用のスキルを同梱しています。
Claude Codeでは、原記事にある次のコマンドを使用できます。
/claude-api migrate this project to claude-haiku-5-5
公式移行ガイドによると、このスキルは次の処理を実行できます。
ファイルを編集する前に、移行範囲の確認をユーザーに求めます。
API呼び出しが複数のファイルに分散している大規模なリポジトリでは、これは有用です。
Anthropicによると、PythonおよびTypeScript SDKには現在、次のベータクラスが含まれています。
現在のコンピューター操作インターフェースは、次を使用します。
computer_toolset_20260801
対応プラットフォームでは、ツールセットが次のような17個のメンバーアクションを提供します。
screenshot
left_click
type
scroll
zoom
ウェブだけを扱うワークフローでは、完全なデスクトップ環境を公開するのではなく、適切な場合にブラウザ操作ツールを使用することをAnthropicは推奨しています。
Haikuは高速かつ低コストであるため、反復的なブラウザ操作やデスクトップエージェントとのインタラクションに特に適しています。
Anthropicによると、Haiku 5.5は次のサービスを通じて利用できます。
原記事では、CursorやOpenRouterなどのサードパーティープラットフォームを通じても利用できると説明しています。
これらは外部統合であり、独自の料金、レート制限、モデルルーティング動作を持つ場合があります。
Anthropicで直接開発する場合、公式のモデルIDは次のとおりです。
claude-haiku-5-5
Claude Haiku 5.5は、Claude 5.5ファミリーにおけるAnthropicの最速かつ低コストな小型モデルです。要約、分類、ルーティング、抽出、ブラウザ操作、サブエージェントタスクなど、大量処理かつレイテンシが重要な業務向けに設計されています。
10万トークンまでのプロンプトでは、入力が100万トークンあたり0.10ドル、出力が100万トークンあたり0.50ドルです。10万トークンを超えるプロンプトでは、入力が100万トークンあたり0.50ドル、出力が100万トークンあたり2.50ドルという高い料金が適用されます。
短いプロンプトに対するトークン料金は90%低くなっています。Anthropicは、10万トークンを超えるリクエストでは価格低下が50%にとどまり、さらに新しいトークナイザーによって同じテキストのトークン数が約30%増えるため、実際の平均ワークロードコストは約75%低くなると見積もっています。
短いコンテキストでは、標準入力、キャッシュ入力、出力の料金は同じです。長いコンテキストでは、GPT-6 Lunaの高い料金帯が始まるのは272,000トークン超であり、Haiku 5.5の10万トークン超よりも遅く、長いコンテキスト向け料金も低いため、現在はGPT-6 Lunaのほうが有利です。
はい。Anthropicは、コンテキストウィンドウを1,000,000トークン、通常のリクエストにおける最大出力を128,000トークンと掲載しています。ベータ版のMessage Batchesオプションでは、最大300,000トークンの出力をサポートできます。
Haiku 4.5より大幅に強力であり、Anthropicが公開したTerminal-BenchとFrontierCodeの結果ではGPT-6 Lunaを上回っています。ただしAnthropicは、複雑なエージェント型コーディングにはSonnet 5.5またはOpus 5.5を推奨しています。
主な変更点には、新しいモデルID、同じテキストに対するトークン数の約30%増加、budget_tokensに代わるアダプティブ思考、古いサンプリング設定の削除、アシスタントプレフィルの非サポート、更新されたコンピューター操作ツール、新しい停止理由などがあります。
Claude APIのモデルIDは次のとおりです。
claude-haiku-5-5
Anthropicは、Amazon Bedrock、Google Cloud、Microsoft Foundry、AWS上のClaude Platform向けに、プラットフォーム固有の識別子も公開しています。
/claude-api migrateワークフローを含む、Anthropicのコーディングエージェント環境。computer_toolset_20260801とデスクトップエージェント統合に関する公式ガイド。computer_toolset_20260801インターフェースとセキュリティガイダンスのドキュメント。Claude Haiku 5.5は、Claudeの料金体系の最下層に位置するモデルから想像される以上に大幅なアップグレードです。Anthropicは短いプロンプトの料金を入力100万トークンあたり0.10ドル、出力100万トークンあたり0.50ドルに引き下げる一方、100万トークンのコンテキストウィンドウ、アダプティブ思考、コンピューター操作、コーディング、ナレッジワーク、推論における大幅に強化された性能を実現しました。
このモデルの役割は依然として明確です。Sonnet 5.5とOpus 5.5は、難しいエージェント型コーディングや自由度の高い作業に適しています。一方、Haiku 5.5は、高速で範囲が限定され、反復可能であり、大規模に実行したり、より大きなリードモデルから委任したりできる仕事に最適化されています。
Haiku 4.5から移行する開発者は、モデルIDを変更するだけでは不十分です。新しいトークナイザー、アダプティブ思考、サンプリング制限、プレフィルの変更、コンピューター操作ツールセット、長いコンテキスト向け料金のしきい値が、既存の統合に影響します。
Haiku 5.5の最大の価値は、あらゆる上位モデルの安価な代替ではなく、大量処理やマルチエージェントシステムを大幅に効率化する高速な実行レイヤーとして発揮されます。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



