For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/embeddinggemma-2-740m-multimodal-embeddin-2078d39c.md.
Googleは、スマートフォン、ノートパソコン、ブラウザなどのエッジデバイス上でセマンティック検索を直接実行できるよう設計された、コンパクトなマルチモーダル埋め込みモデル **EmbeddingGemma 2** をリリースしました。

Googleは、スマートフォン、ノートパソコン、ブラウザなどのエッジデバイス上でセマンティック検索を直接実行できるよう設計された、コンパクトなマルチモーダル埋め込みモデル EmbeddingGemma 2 をリリースしました。
このモデルは2026年10月6日に発表されました。実行できることを考えると、その主要スペックは非常に小規模です。
総パラメータ数:740M
統合埋め込み空間:768次元
コンテキストウィンドウ:8K
対応言語:100以上
Pixel 11 Proでテキストのみの重みを使用した場合のアクティブRAM:約191MB
Pixel 11 Proで完全なマルチモーダルモデルを使用した場合のアクティブRAM:約567MB
EmbeddingGemma 2は、テキスト、コード、画像、動画、音声、およびそれらを組み合わせた入力を、1つの共有ベクトル空間にエンコードできます。
つまり、各ファイルを最初にテキストへ変換しなくても、自然言語のクエリから写真、音声クリップ、動画内の特定の場面を検索できます。
Google CEOのSundar Pichai氏は、これをGoogle初のオープンなネイティブ・マルチモーダル埋め込みモデルと説明しました。
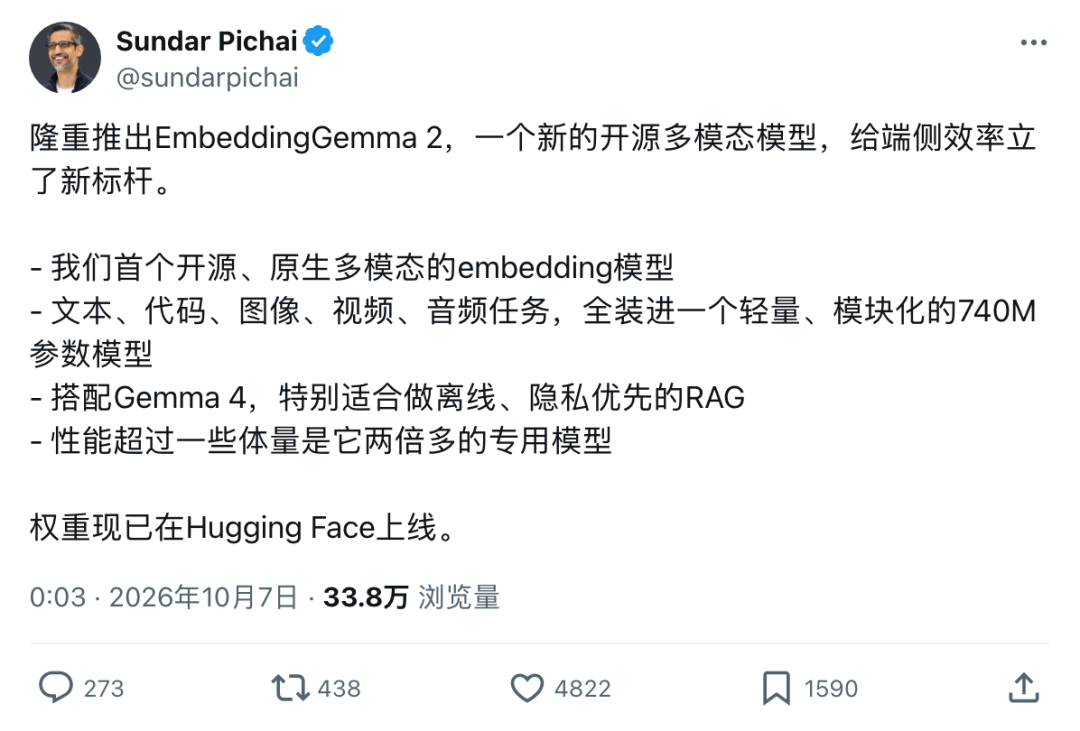
実用面での違いはシンプルです。従来はクラウドAPIや画像・音声・テキストごとの個別モデルに依存していた検索を、現在では1つのコンパクトなモデルでローカル実行できるようになります。
埋め込みモデルはエンドユーザーから見えないことが多いものの、現代の多くの検索システムやRAGシステムを支えています。
その役割は、コンテンツを数値ベクトルに変換することです。
コンテンツ
→ 埋め込みベクトル
→ セマンティック空間内の位置
意味が近い項目は、空間内でも近い位置に配置されます。検索システムはユーザーのクエリも別のベクトルに変換し、最も近い一致結果を取得します。
初代EmbeddingGemmaはテキストに重点を置いていました。EmbeddingGemma 2は、その考え方を統合されたマルチモーダル空間へ拡張します。
Googleのモデルカードによると、新モデルはテキスト、画像、動画、音声を同じ 768次元 の埋め込み空間にマッピングします。
そのため、猫の写真、「猫」という単語、猫の鳴き声の録音は、元のファイル形式がまったく異なっていても、意味的に関連付けることができます。
これにより、次のような検索が可能になります。
テキストクエリ → 一致する画像
テキストクエリ → 一致する音声
テキストクエリ → 一致する動画内の場面
音声クエリ → 一致する動画
画像クエリ → 関連する画像またはメディア
1つのコンテンツに複数のモダリティが含まれる場合にも対応できます。
Googleは、トレイルシューズの商品ページを例として挙げています。このページには、商品説明のテキスト、商品写真、濡れた岩場でのグリップ性能を示す動画が含まれています。EmbeddingGemma 2は、これらを組み合わせたコンテンツを1つの埋め込みとして表現し、「トレイルランニングに適した防水シューズ」のようなクエリと照合できます。
公開直後、Hugging FaceのエンジニアであるVictor M氏が、ブラウザ上でモデルを直接実行する様子を紹介しました。
元記事によると、同氏は次のように入力しました。
鳥のさえずり
すると結果グリッドが即座に再ランキングされました。上位結果には、鳥の写真と、鳥の鳴き声の波形を示す音声クリップの両方が含まれていました。
報告されたクエリの処理時間は約 22ミリ秒 でした。サーバー側のモデル呼び出しは行われず、外部APIも必要ありませんでした。
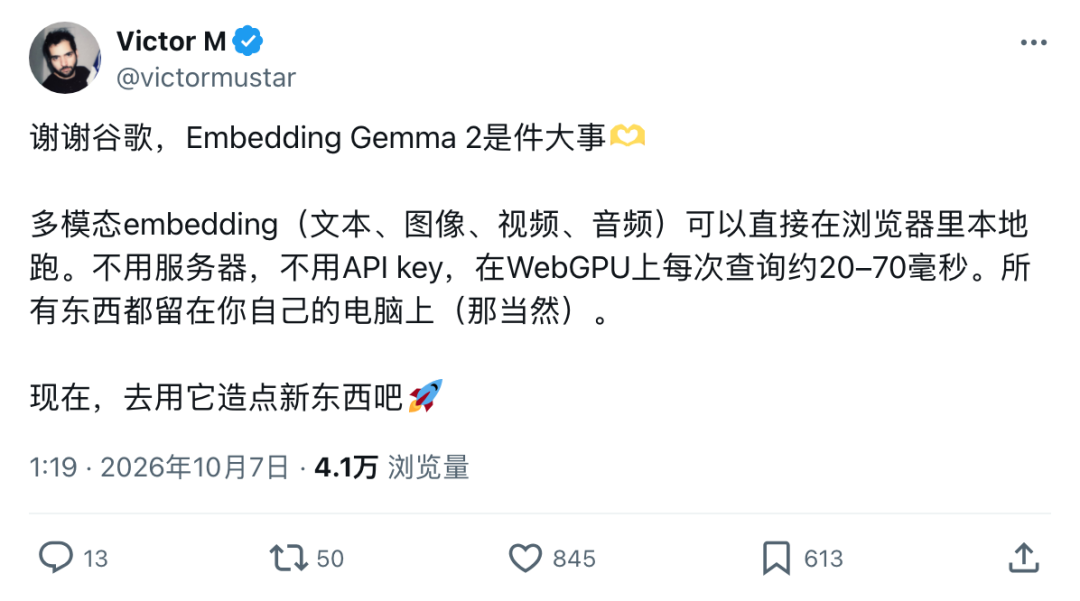
この数値は開発者が報告したブラウザテストの結果であり、Googleが公式に保証するレイテンシーではありません。
それでも、Google自身のデプロイガイダンスは、EmbeddingGemma 2がLiteRT、MediaPipe、WebGPU、transformers.js、MLX、llama.cpp、Ollamaなどのエッジ向けランタイムを通じたローカル実行を想定していることを示しています。
EmbeddingGemma 2は 8,192トークンのコンテキストウィンドウ を使用します。これは前世代のEmbeddingGemmaの4倍です。
Googleによると、単一モダリティの入力には、およそ次の量を含めることができます。
音声:5.5分
画像:29枚
動画フレーム:58枚
または、複数モダリティを交互に組み合わせた入力にも対応します。
このモデルは100以上の言語もサポートしています。
これにより、ローカル検索システムの柔軟性が大きく高まります。短いテキスト断片だけをインデックス化するのではなく、より長い文章、画像、動画フレーム、音声セグメントを含む、より豊かなコンテンツを表現できるようになります。
Googleは、EmbeddingGemma 2を同程度のサイズを持つ複数の埋め込みシステムと比較しました。
元記事では、視覚検索における大きな差が強調されています。
Googleのモデルカードに掲載された結果は次のとおりです。
| ベンチマーク | EmbeddingGemma 2 |
|---|---|
| MTEB Multilingual v2 | 61.36 |
| MTEB Code v1 | 78.68 |
| MIEB Lite | 64.64 |
| MMEB v2 Image | 57.28 |
| MMEB v2 Visual Document | 67.84 |
| MMEB v2 Video | 50.67 |
| MSEB Retrieval | 69.54 |
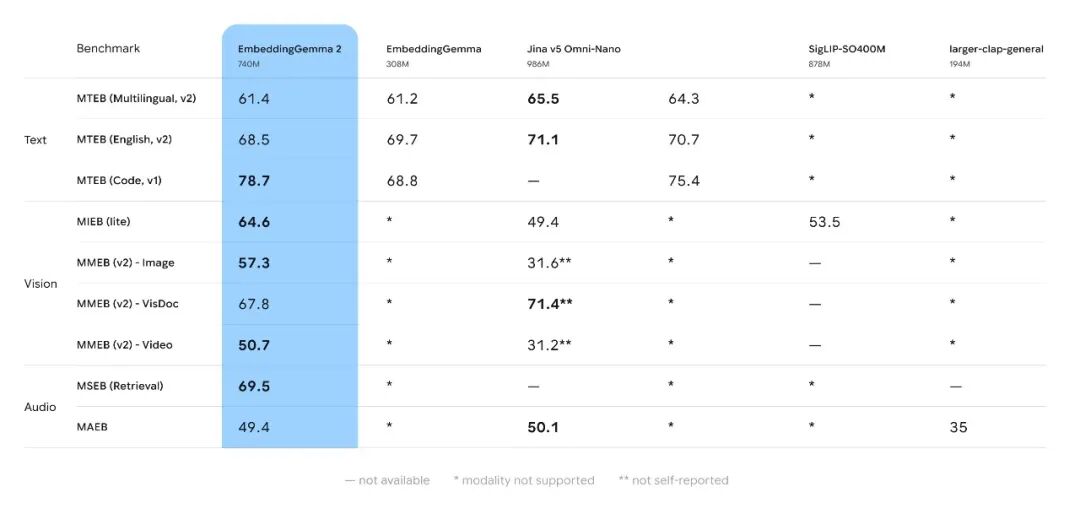
元記事では、Jina v5 Omni-Nano との比較も紹介されています。
MMEB v2 Image
EmbeddingGemma 2:57.3
Jina v5 Omni-Nano:31.6

MMEB v2 Video
EmbeddingGemma 2:50.7
Jina v5 Omni-Nano:31.2
これらの数値は、Googleが公開した評価表に基づいています。
ただし、ベンチマーク結果は、あらゆる本番検索ワークロードに対する普遍的な順位ではなく、特定の評価設定の中で解釈する必要があります。
総パラメータ数740Mは、複数のモジュールに分割されています。
Googleのモデルカードには、次のように記載されています。
テキスト:
合計270Mパラメータ
  バックボーン:130M
  埋め込み器:140M

ビジョンエンコーダ:
170Mパラメータ

音声エンコーダ:
300Mパラメータ
開発者は3つのコンポーネントすべてを読み込む必要はありません。
| 有効なモダリティ | 実効パラメータサイズ |
|---|---|
| テキストのみ | 270M |
| テキスト+画像 | 440M |
| テキスト+音声 | 570M |
| 完全なマルチモーダル | 740M |
このモジュール性は、エッジデバイス上で重要です。アプリがテキストとコードだけを検索するのであれば、音声エンコーダやビジョンエンコーダをメモリに保持する理由はありません。
Googleは、Pixel 11 Pro 上で量子化した場合、モデルが次のメモリ量で動作すると報告しています。
テキストのみのアクティブRAM:
約191MB

完全なマルチモーダルのアクティブRAM:
約567MB
これが、元記事の「600MB未満」という見出しの根拠です。
このモデルは量子化認識トレーニングを使用し、INT4およびINT8でのデプロイオプションをサポートします。
これは、マルチモーダル検索パイプラインが従来、複数の個別コンポーネントを必要としていたことを考えると重要です。
画像エンコーダ
+
音声認識または音声エンコーダ
+
テキスト埋め込みモデル
+
追加の前処理
EmbeddingGemma 2は、その多くを1つの統合アーキテクチャにまとめます。
ネイティブ出力の次元数は768です。
EmbeddingGemma 2はMatryoshka Representation Learningにも対応しており、ベクトルを次の次元数まで切り詰めることができます。
512次元
256次元
128次元
Googleによると、これによりローカルベクトルデータベースのストレージ容量を、768次元の完全な表現と比べて最大 6倍 削減できます。
Google AI Edgeのデプロイブログでは、表現とストレージパイプラインの構成によっては、特定のローカルインデックスおよびストレージ設定で最大 8倍 の削減を達成できると説明しています。
モデルカードには、重要な実装上の詳細も記載されています。切り詰めたベクトルは、コサイン類似度検索の前に再正規化する必要があります。
クエリベクトルとドキュメントベクトルで異なる次元数を使用する場合、それらを直接比較することもできません。
Googleは、このモデルを利用した複数のリファレンスアプリケーションを公開しています。
Google AI Edge Galleryの Instant Media Search では、自然言語またはサンプル画像を使って、ローカルに保存された写真や動画を検索できます。
アプリの処理手順は次のとおりです。
埋め込みの計算にインターネット接続は必要ありません。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
Video Moments Finder では、ローカルの動画ファイル内にある特定の場面を検索できます。
Googleが挙げているクエリの例は次のとおりです。
子どもたちが笑っている
犬がフリスビーを捕まえている
人が誕生日ケーキのろうそくを吹き消している
アプリは映像と音声のチャンクをインデックス化し、一致するタイムスタンプを返します。
GoogleはMac向けに AI Edge Foresight も公開しました。
Foresightは、EmbeddingGemma 2とGemma 4を組み合わせて、ローカル検索とコンテキスト推論を実行します。
Googleによると、会議の文字起こしをインデックス化し、プライベートファイルを検索し、画像・ドキュメント・メモを取得し、オフラインで動作できます。また、機密性の高い元データをデバイス上に保持できます。
これは、元記事で説明されているローカルRAGアーキテクチャに近い構成です。
EmbeddingGemma 2
→ 関連するローカルコンテキストを取得

Gemma 4
→ 取得したコンテキストをもとに推論
元記事では、開発者による初期の実験結果もいくつか取り上げています。
これらは有用な事例ですが、Google公式のベンチマークではなく、コミュニティが報告した結果として扱う必要があります。
MacアプリのNativは、Apple M5 Max上で8ビット量子化モデルを使用したテスト結果を報告しました。
公開された数値には、次のものが含まれます。
FP32とのコサイン類似度:
0.9997

バッチサイズ32でのテキスト埋め込みスループット:
毎秒817項目
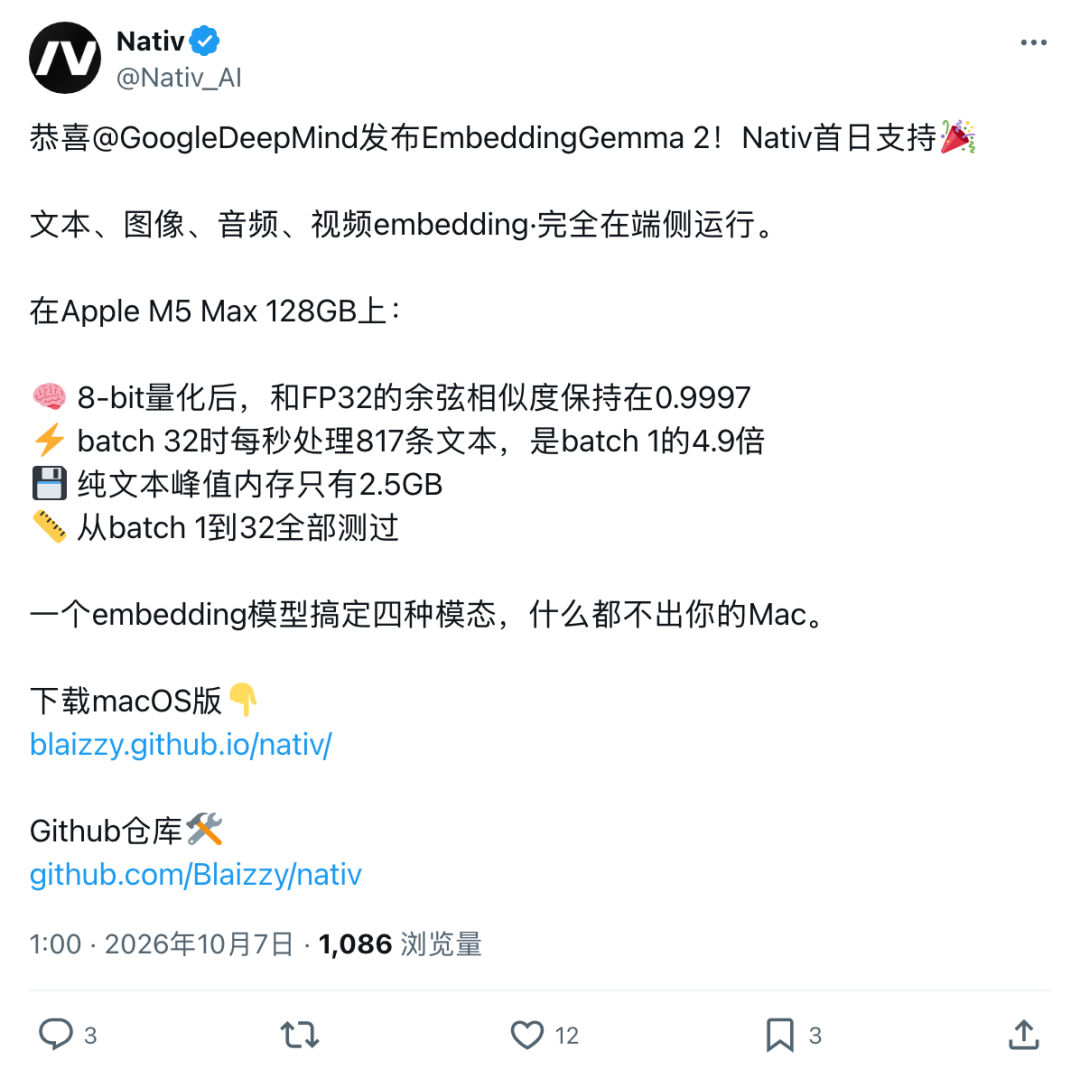
これらの数値は、具体的な実装、量子化方式、ハードウェア、バッチサイズによって変わります。
元記事で紹介されたトルコ人開発者は、個人メモを対象に小規模なテストを実施しました。
メモの多くは英語で書かれていましたが、クエリはトルコ語でした。
報告されたテスト結果は次のとおりです。
キーワードマッチングのヒット率:
15%

EmbeddingGemma 2のヒット率:
97%
この設定では、正しいメモが上位18件の候補に含まれているかを確認しました。
また、実際のメッセージに多い誤字を含むクエリでもテストし、セマンティックモデルがキーワード検索の約2倍の関連メモを見つけたと報告しています。各クエリのローカル処理時間は約50ミリ秒だったとされています。
これは標準化されたベンチマークではありません。しかし、埋め込み検索が有用である主な理由の1つを示しています。セマンティックな類似性により、クエリと保存されたテキストが異なる単語や言語を使っていても検索できるのです。
開発者のNick Lo氏は、llama.cppを通じてNano開発ボード上で量子化したEmbeddingGemma 2を実行するデモも紹介しました。
小規模なローカル画像検索システムで、テキストクエリを埋め込みに変換する処理に、およそ次の時間がかかったと報告しています。
約15ミリ秒
一致する画像が見つかると、ESP32-S3が画像を1行ずつ描画しました。

こちらも、公式の基準レイテンシーではなく、開発者による実験結果です。
このモデルはメディア検索だけを目的としたものではありません。
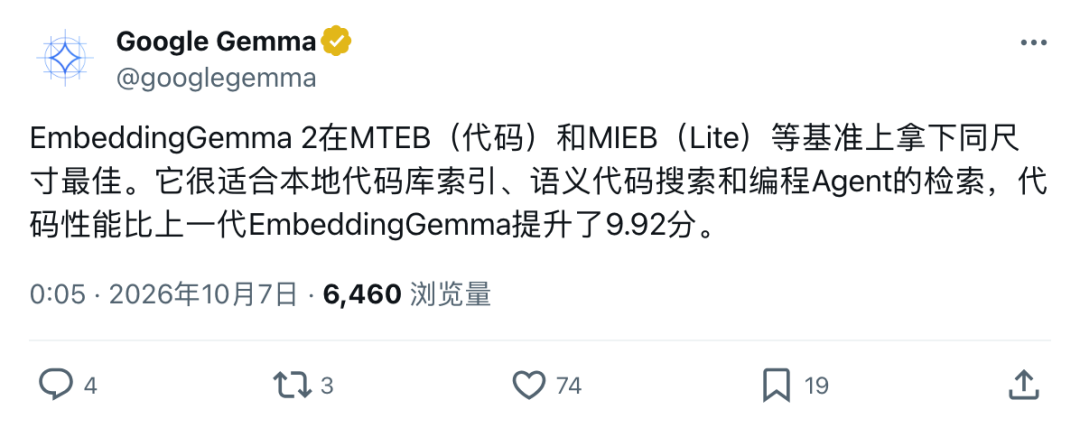
コード検索の性能は、前世代のEmbeddingGemmaから大きく向上しました。
Googleが報告した数値は次のとおりです。
MTEB Code v1

EmbeddingGemma:
68.76

EmbeddingGemma 2:
78.68
これは 9.92ポイント の上昇です。
Google Gemmaは、ローカルのコードベースインデックス化、セマンティックコード検索、コーディングエージェントによる検索を主なユースケースとして明確に挙げています。
コーディングエージェントは、コードを編集する前にリポジトリ内の関連部分を見つける必要があります。
コンパクトなローカル埋め込みモデルによって、開発者は次のような構成を選択できます。
ソースリポジトリ
→ ローカルで埋め込みを生成
→ インデックスをローカルに保存
→ 自然言語クエリ
→ 関連コードを取得
→ 選択したコンテキストだけを大規模コーディングモデルへ送信
インデックス化と第1段階の検索を、開発者自身のマシン内にとどめることができます。
Googleは2026年初頭、クラウドAPIとして Gemini Embedding 2 をすでに公開していました。
EmbeddingGemma 2は異なるアプローチを取ります。
マルチモーダルな埋め込み生成にホスト型APIを必要とする代わりに、ローカルで実行できるオープンウェイトモデルとして提供されています。
| アプローチ | 主な利点 |
|---|---|
| クラウド埋め込みAPI | マネージドインフラと容易なスケーリング |
| オンデバイスのEmbeddingGemma 2 | プライバシー、オフライン動作、ローカルでの低レイテンシー |
個人のメディア、プライベートファイル、企業のメモ、ローカルのコードリポジトリでは、元データを必ずしもデバイス外へ送信する必要がないため、後者が魅力的な選択肢になります。
Googleはこれをプライバシー優先の設計として明確に推奨しています。
ただし、すべてのアプリケーションが自動的にプライベートになるわけではありません。安全なローカルストレージ、アクセス制御、取得したコンテンツの慎重な取り扱いなど、アプリケーション全体を適切に設計する必要があります。
EmbeddingGemma 2は、Gemma 4の技術を基盤にしたGoogleのオープンウェイト・マルチモーダル埋め込みモデルです。テキスト、コード、画像、動画、音声、複合入力を共有された768次元のベクトル空間にマッピングし、検索、RAG、類似性判定、分類、クラスタリングに利用できます。
完全なモデルは740Mパラメータです。テキストコンポーネントは270Mパラメータで、オプションのビジョンエンコーダと音声エンコーダがそれぞれ170Mと300Mパラメータを追加します。
はい。Googleはスマートフォン、ノートパソコン、ブラウザ、エッジハードウェア上での利用を想定して設計しており、デプロイ手段も提供しています。Google自身のAI Edgeデモでは、クラウドの埋め込み呼び出しを必要とせず、ローカル検索を実行できます。
Googleは、Pixel 11 Pro上で量子化したテキストのみの重みに約191MB、完全なマルチモーダルモデルに約567MBのアクティブRAMが必要だと報告しています。実際のメモリ使用量は、ランタイム、ハードウェア、精度、使用するエンコーダによって異なります。
はい。対応するすべてのモダリティが同じベクトル空間にマッピングされるため、テキストから画像、音声、動画セグメントを検索できます。また、メディア同士を比較することも可能です。
Googleは、商用利用に寛容なApache 2.0ライセンスの下でモデルウェイトを公開し、オープンモデルとして説明しています。ただし、利用者はGemma禁止利用ポリシーおよび適用される規約に従う必要があります。
はい。Googleは、EmbeddingGemma 2のMTEB Codeスコアが78.68であり、前世代のEmbeddingGemmaの68.76から向上したと報告しています。また、ローカルリポジトリのインデックス化とコーディングエージェントによる検索を想定ユースケースとして明示しています。
EmbeddingGemma 2は埋め込みモデルであり、検索や類似性判定のためにコンテンツをベクトルへ変換します。一方、Gemma 4は取得した情報をもとに推論できる生成モデルです。そのためGoogleは、完全ローカルのRAGワークフローで両者を組み合わせています。
EmbeddingGemma 2は、マルチモーダルなセマンティック検索をクラウドから取り出し、一般的なコンシューマー向けハードウェアでも利用可能な範囲へ近づけます。740Mの単一モデルで、テキスト、コード、画像、動画、音声を1つのベクトル空間に埋め込み、GoogleがPixel 11 Proで示した完全なマルチモーダル構成では約567MBのアクティブRAMで動作します。
最も実用的な強みは、アーキテクチャのシンプルさです。1つのコンパクトなモデルで、ローカルメディア検索、動画内の場面検索、プライベートRAG、多言語メモ検索、リポジトリのインデックス化を支援できます。しかも、すべての元ファイルをサーバーへアップロードする必要はありません。
Googleの公式デモ、モデルカード、デプロイ用スタックは、オンデバイス動作という方向性を裏付けています。一方、記事内で紹介したブラウザ、Nativ、トルコ語メモ、Nanoボードの数値は、実装固有の初期開発者実験として読むべきであり、保証された性能ではありません。
EmbeddingGemma 2によって、写真、録音、動画、ドキュメント、コードを、すでに保存されている場所、つまりユーザー自身のデバイス上で検索するローカルなマルチモーダル検索が、現実的な選択肢になりつつあります。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



