For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ja/articles/openai-s-gpt-7-and-gpt-8-research-focus-w-75b1c0ac.md.
GPT-6はまだ新しいにもかかわらず、OpenAIはすでにその先を見据えています。
2026年9月23日に開催されたFellows Forum AI Summitで、OpenAIの応用研究責任者であるBoris Powerは、同社の研究のおよそ**80%から90%**がすでに以下に注力していると見積もりました。
GPT-7
GPT-8
およびその後の世代
この発言は、フロンティアモデルが研究段階からエージェントや現実世界のシステムへ移行する過程について、Zachary Liptonと公開対談した際に出たものです。
Powerの主張は、GPT-6がもはや重要ではないということではありません。
OpenAIは現行世代を今も積極的に改善しています。9月初旬には、GPT-6で最も高い能力を持つモデルであるGPT-6 Astraをリリースしました。9月22日には、より高速で低コストなGPT-6 SolとGPT-6 Lunaを追加して、モデル群を拡張しました。
ここには一見すると矛盾があります。
Powerの説明は、この二つを結び付けています。
OpenAIは、現在のモデルに対する改善が現行製品をより良くし、研究チームにも有益な学びをもたらすため、今日のモデルを改善し続けられます。同時に、最大の長期的進歩は、はるかに強力な次世代モデルを構築し、そのモデルを利用してより低コストなシステムを訓練することから生まれる可能性があります。
結果として、二つの軸による戦略になります。
能力の最前線を前へ押し進める
+
有用な能力をコスト曲線に沿って低価格化する
Powerは、現行世代のシステムを対象とする一部の取り組みについて、異例に強い表現を用いました。
彼は、今日のモデルを対象とした一部の投資が社内では**「extremely short-sighted(極めて近視眼的)」**と見なされていると述べました。
これは、その仕事が無意味であることを意味しません。
たとえば、現行モデルがツール呼び出しで苦戦しているとします。
チームは次のように進める可能性があります。
これにより、製品をすぐに改善できます。
また、モデルがなぜ失敗したのか、どの介入が有効だったのかを研究者が学ぶ助けにもなります。
Powerの警告は、その修正の寿命に関するものです。
GPT-6で慎重な介入を必要とする問題が、次世代モデルが基礎となる能力で単純に優れているために、GPT-7では自然に消えることがあります。
言い換えれば、
今日のパッチは
将来には
不要な回避策になるかもしれない
そのため研究組織は、どの問題に深い投資を行うべきかを常に判断しなければなりません。
修正が将来不要になる可能性があるからといって、ユーザーが待てるわけではありません。
人々は今日、現在の製品を使っています。
モデルが目標を繰り返し見失う、ツールを正しく使えない、あるいは過度な手動監督を必要とするなら、その問題は今も重要です。
したがってPowerの区別は、次の二つの間にあります。
今すぐ製品を改善するもの
そして、
最も大きな長期的研究価値を生むもの
OpenAIのGPT-6 Astraのリリースは、同社が最初のカテゴリーにも依然として大きく取り組んでいることを示しています。
公式のAstra発表において、OpenAIは、より高速なコンピューター利用やCodex内でのより良い協業など、実務を対象とした改善について説明しています。
Astraは、ユーザーの回答に依存しない作業を続けながら、要点を絞った質問をユーザーに投げかけられます。判断が重大であれば待機します。欠けている詳細が定型的なら、妥当な仮定のもとで進行できます。
またOpenAIは、タスクの途中でユーザーが新たな要件を追加した場合にも、Astraが当初の目標と制約をより適切に維持できると述べています。
こうした詳細はベンチマークスコアほど劇的には聞こえないかもしれませんが、AIシステムが単なるツールというより、有能な同僚のように振る舞えるかに直接影響します。
Powerの議論の後半は、モデルサイズに関するものです。
多くのユーザーが最終的にはより高速で低価格なものを求めるなら、なぜ高価なフロンティアモデルにこれほど大きく投資するのでしょうか。
より強力なモデルが教師になり得るからです。
Powerは、次のようなパターンを説明しました。
高能力な汎用モデルを訓練する
→ それを用いて高品質な事例を生成する
→ 有用な出力を選別またはフィルタリングする
→ その事例で小型モデルを訓練する
→ より低コストで小型モデルを展開する
これはモデル蒸留の一形態です。
生徒モデルは、教師のすべての能力を再現する必要はありません。
対象タスクにとって必要な教師の有用な振る舞いを、十分に受け継げばよいのです。
そのため、フロンティアモデルへの取り組みは、そのモデルを直接使用しない顧客にとっても重要になり得ます。
OpenAIは、過去の製品世代において蒸留を公開に説明してきました。
2025年3月、同社は新世代の音声モデルを導入した際、大型音声モデルから小型でより効率的なシステムへ知識を移転するために、高度な蒸留手法を使用したと述べました。
また、より小型のモデルも有用性と応答性を維持できるよう、より現実的な会話のダイナミクスを捉えるために自己対戦データを使用したことも説明しています。
OpenAI Cookbookの別の例は、教師と生徒の考え方をより分かりやすく示しています。
この例では、ワイン用ブドウの分類タスクにおいて、GPT-4oをGPT-4o miniの教師として使用しています。
300件の事例からなるある検証セットでは、報告された精度は次のとおりでした。
GPT-4o:
79.67%

GPT-4o mini:
64.67%

蒸留済みGPT-4o mini:
79.33%
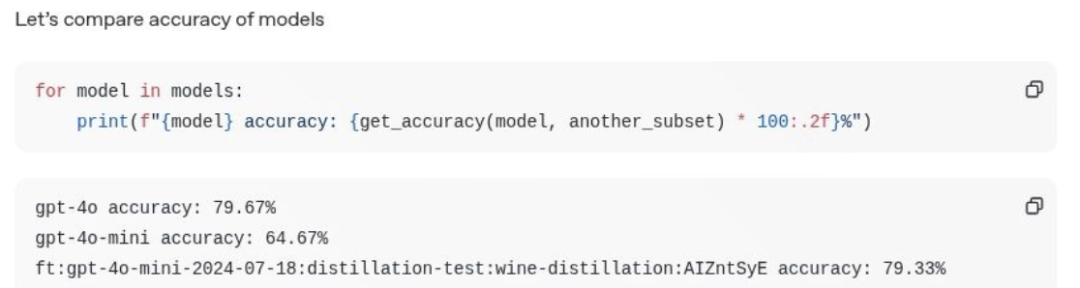
蒸留された生徒モデルは、その特定のタスクでは教師にほぼ匹敵しました。
これは、小型モデルが一般的にGPT-4oと同等になったことを意味するものではありません。
高能力な教師が対象を絞った振る舞いを十分効果的に移転できれば、小型モデルが限定的なワークロードに対してはるかに有用になることを意味しています。
GPT-6ファミリーは、製品規模で類似した考え方を適用しています。ただしOpenAIは、Lunaを単に「蒸留されたAstra」と呼ぶことを正当化できるほど完全な訓練手法を公表していません。
OpenAIによると、GPT-6 SolとGPT-6 LunaはGPT-6 Astraに使用したものと似た手法で訓練され、Astra世代の進歩をより高速で手頃なモデルにもたらしています。
同社はこのモデル群を次のように位置付けています。
GPT-6 Astra
最高レベルの能力

GPT-6 Sol
低コストで強力な汎用パフォーマンス

GPT-6 Luna
大量処理向けの大幅に低コストなモデル
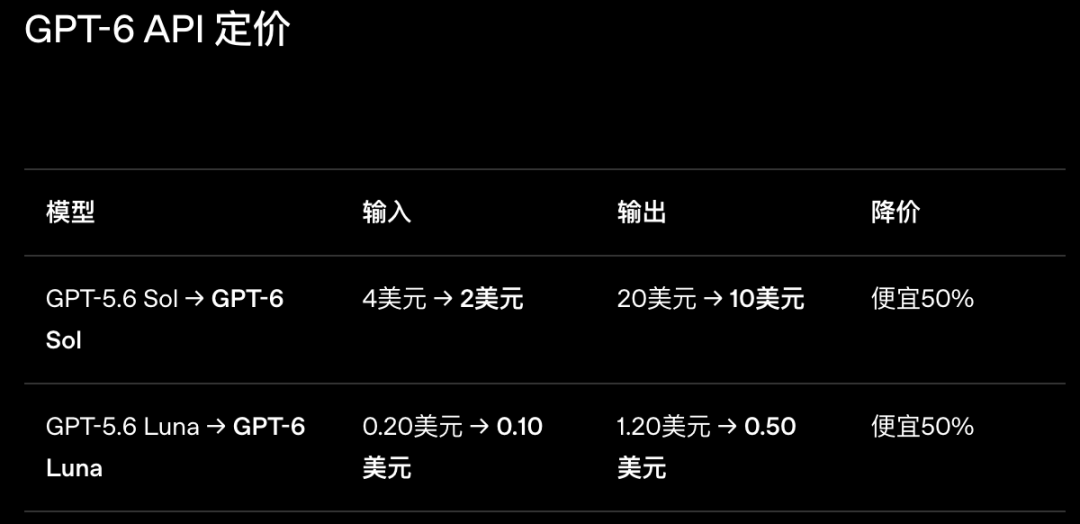
9月22日のリリース時点におけるOpenAI公式のGPT-6価格は次のとおりです。
| モデル移行 | 入力 | 出力 | 削減率 |
|---|---|---|---|
| GPT-5.6 Sol → GPT-6 Sol | $4 → $2 / 100万トークン | $20 → $10 / 100万トークン | 50% |
| GPT-5.6 Luna → GPT-6 Luna | $0.20 → $0.10 / 100万トークン | $1.20 → $0.50 / 100万トークン | 50% |
OpenAIは、異なる予算とワークロード全体にフロンティア知能を行き渡らせることが目標だと明確に述べています。
大型モデルは能力の上限を引き上げます。
小型モデルは、その能力のより多くを日常利用へと移します。
ほとんどのワークフローは、開始から終了まで同じ難易度ではないからです。
プロジェクト報告書は有用な例です。
次のような複数のソース文書を想像してください。
作業の最初の部分には、より強い判断力が必要です。
高能力なモデルは、次のことを行えます。
アイデアを一文で入力するだけで、We0 AI が紹介サイト、ページ、CMS を生成し、公開後の顧客獲得と流入拡大を支援します。
無料登録で完全なプロジェクトを 1 つ生成
1 つの完全な生成フローを試し、最初のプロジェクトのドラフトをすぐに確認するのに最適です。
方向性が定まれば、残りの多くの工程はより定型的になります。
小型モデルでも、次の作業には十分適している可能性があります。
新たな曖昧さが現れた場合は、より強いモデルへタスクを再度エスカレーションできます。
したがって、実践的なワークフローは次のようになります。
強力なモデル
→ 難しい判断

小型モデル
→ 反復的な実行

強力なモデル
→ 例外処理
トークンが安いことは、自動的に作業が安くなることを意味しません。
小型モデルは1リクエスト当たりの費用が低くても、次のことを必要とするなら、ユーザーの作業を増やす可能性があります。
したがって、有用な問いは次ではありません。
最もトークン価格が低いモデルはどれか?
むしろ、次の問いです。
受け入れられる最終成果物全体のコストはいくらか?
その総コストには、機械コストと人間の時間の両方が含まれます。
より安いモデルを成功させるために、ユーザーがAIプロジェクトマネージャーを常勤で担わなければならないなら、API料金が下がっても大きなメリットとは言えません。
そのため、最適な役割分担はタスクによって異なります。
小型モデルは、明確に定義された作業を低コストで確実に完了できる場合に価値があります。
大型モデルは、タスクに本当により強い判断力が求められる場合に、その高い価格に見合う価値を発揮します。
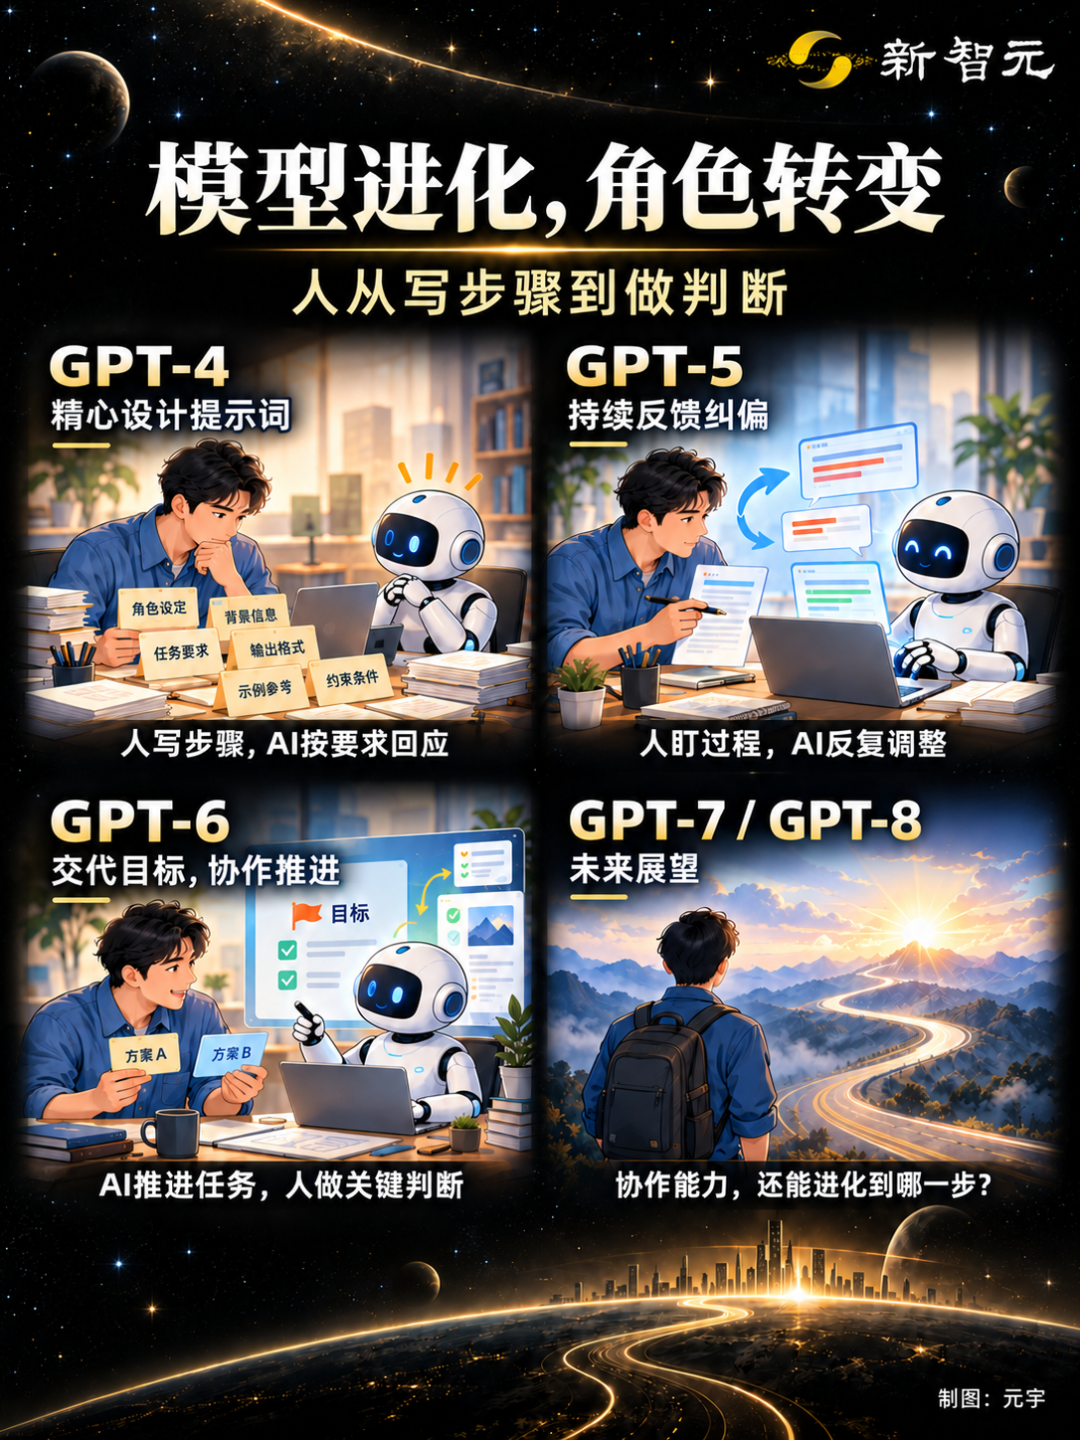
Powerはさらに、モデル世代が進むにつれて人々がモデルと関わる方法が変化していると説明しました。
元記事では、その進展がおおよそ次のように要約されています。
GPT-4:
人間が手順を慎重に設計する

GPT-5:
人間がプロセスを導き、継続的に修正する

GPT-6:
人間は目標を示し、重要な判断を監督する役割へと徐々に移行する
これは単純化であり、すべてのタスクに対する保証ではありません。
しかし、OpenAI自身のAstraドキュメントも同じ大きな方向性を説明しています。
Astraは次のことができます。
これは人間の役割を変えます。
ユーザーはすべての手順を手作業で指定する代わりに、徐々に次のようなことを行うようになります。
目的を設定する
→ 制約を定義する
→ 重要な選択をレビューする
→ 結果を確認する
GPT-7とGPT-8にとって重要な問いは、この変化がどこまで進むかです。
モデルの進歩は、しばしばベンチマークスコアで提示されます。
日常業務においては、別の指標の方がより重要かもしれません。
モデルに対して、ユーザーはどれほどの監督を依然として行う必要があるのか?
モデルに目標を与えた後、次の点を考える必要があります。
GPT-7またはGPT-8がこれらの負担を減らせるなら、小さなベンチマーク改善よりも価値があるかもしれません。
このことは、より大きなモデルに関する研究と、より小さなモデルに関する取り組みが互いを強化する理由でもあります。
フロンティアモデルは、より高能力な振る舞いを発見しようとします。
より低コストなモデルは、その振る舞いの十分な部分を大規模に利用可能な価格へと近づけようとします。
見出しに使われた数値には、一つ重要な留保があります。
Powerによる「80%から90%」という発言は、公開対談の中で示された見積もりです。
これは、次のいずれでもありません。
Fellows Forumのアジェンダは、PowerがOpenAIの応用研究責任者として、9月23日の「Where Models Meet Reality」という題の炉辺談話に登壇したことを確認しています。
録画の独立した報道によると、80~90%という発言はイベント全体の録画のおよそ1:32:52にあります。
そのため、最も慎重な解釈は次のとおりです。
Powerは、OpenAIの研究の大部分がGPT-6以降のモデル世代に向けられていると考えています。それは、そこで最大の根本的進歩が得られると見込んでいるためです。
これは文字通りの会計上の数値として読むべきではありません。
Powerが発言したのは9月23日です。
その6日後の9月29日、OpenAIはGPT-6.1 Solをリリースしました。
このモデルは、議論がイベントでPowerが説明したAstra → Sol/Lunaの教師・生徒の論理に焦点を置いているため、元記事の主張の中心ではありません。
それでも、現在この記事を公開する読者にとって有用な文脈です。
OpenAIはGPT-6.1 Solを、標準API価格を大幅に抑えながら、コーディング、コンピューター利用、プロフェッショナル業務においてAstraに迫る能力を持つ、GPT-6シリーズの最新モデルファミリーとして説明しています。
その存在は、インタビューで論じられた同じパターンを補強しています。
フロンティア能力が改善する
→ 低コストモデルがそのより多くを取り込む
→ ユーザーはより低いコストでより強い性能を得る
また、個々の中間リリース名よりも、より大きな研究戦略の方が重要である理由も示しています。
OpenAIの応用研究責任者であるBoris Powerは、Fellows Forum 2026で、OpenAIの研究のおよそ80~90%がGPT-7、GPT-8、およびその後の世代に注力していると見積もりました。この数値は彼が公開の場で示した見積もりであり、監査済みの企業リソース配分報告ではありません。
いいえ。Powerの発言では、GPT-7またはGPT-8について公開のリリース日や詳細な製品ロードマップは発表されませんでした。彼は、長期的な研究上の注目の大半が向けられていると考える、GPT-6の先の世代を表す名称としてこれらを用いました。
現行世代への取り組みは、今日の製品を改善し、研究者により速いフィードバックをもたらします。Powerが指摘したのは、より高能力な次世代モデルによって基礎的な問題が容易になったり、完全になくなったりするため、一部の修正は短命に終わる可能性があるということです。
モデル蒸留は、より強力な教師モデルがより小型の生徒モデルの訓練を支援する技術群です。一般的なワークフローでは、教師が高品質な事例を生成し、それらをフィルタリングして、対象タスクに必要な振る舞いを小型モデルが再現できるよう訓練します。
OpenAIはSolとLunaがAstraと似た手法で訓練され、同じ世代の進歩を継承していると述べています。しかし、LunaやSolを単純にAstraの圧縮コピーと説明するのに十分な詳細は公表していません。関連する能力上の進歩を、より低コストの層にもたらしていると表現する方が正確です。
9月22日のリリース時点で、OpenAIはGPT-6 Solを入力100万トークン当たり$2、出力100万トークン当たり$10、GPT-6 Lunaを入力100万トークン当たり$0.10、出力100万トークン当たり$0.50と設定しました。OpenAIは、いずれもGPT-5.6の対応モデルにおけるプロモーション価格より50%安いと説明しました。
難しい判断、曖昧な推論、例外処理、または重要な意思決定を必要とするタスクには、より強力なモデルを使用します。主な方向性が定まった後の、大量で明確に仕様化された反復的な作業には、小型モデルの方が適していることが多くあります。
傾向は、すべての手順を書くことから、目標の設定、制約の定義、重要な判断のレビューへと移っています。OpenAIのAstraドキュメントは、非同期の質問、回答を待つ間の作業継続、長期タスクで当初の目的をより適切に保持することを具体的に説明しています。
Boris Powerによる80~90%という見積もりは、OpenAIの研究戦略を理解しやすくします。同社は、より大きな能力向上が期待される将来世代へ長期的な研究の大半を向けながら、今日のGPT-6製品を改善し続けることができます。
この戦略の後半も同じくらい重要です。より強力なフロンティアモデルは、プレミアム製品としてだけ価値があるのではありません。SolやLunaのような、より高速で低価格なシステムへ有用な能力を移すための教師や研究基盤としても機能します。
ユーザーにとって実務上の問いは、どのモデルが最も大きいかではありません。難しい判断は対応できるモデルに割り当て、定型的な実行は確実に完了できる最も低コストなモデルに割り当てるために、どのように作業を配分するかです。
OpenAIの長期的な賭けは明快に見えます。能力の上限を押し上げ続け、その能力のより多くを日常的に使える価格まで引き下げることです。
ひとことから始めて、数分で完全なサイトを手に入れましょう。



