For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/embeddinggemma-2-740m-multimodal-embeddin-2078d39c.md.
A Google lançou o **EmbeddingGemma 2**, um modelo compacto de embeddings multimodais criado para levar a pesquisa semântica diretamente para...

A Google lançou o EmbeddingGemma 2, um modelo compacto de embeddings multimodais criado para levar a pesquisa semântica diretamente para telefones, laptops, navegadores e outros dispositivos de borda.
O modelo foi anunciado em 6 de outubro de 2026. Suas principais especificações são excepcionalmente compactas para o que ele consegue fazer:
740 milhões de parâmetros no total
Espaço de embeddings unificado de 768 dimensões
Janela de contexto de 8K
Mais de 100 idiomas
~191 MB de RAM ativa para pesos somente de texto no Pixel 11 Pro
~567 MB de RAM ativa para o modelo multimodal completo no Pixel 11 Pro
O EmbeddingGemma 2 pode codificar texto, código, imagens, vídeo, áudio e combinações desses formatos em um único espaço vetorial compartilhado.
Isso significa que uma consulta em linguagem natural pode recuperar uma foto, um clipe de áudio ou um momento dentro de um vídeo sem exigir primeiro que cada arquivo seja convertido em texto.
O CEO da Google, Sundar Pichai, descreveu o modelo como o primeiro modelo de embeddings aberto e nativamente multimodal da Google.
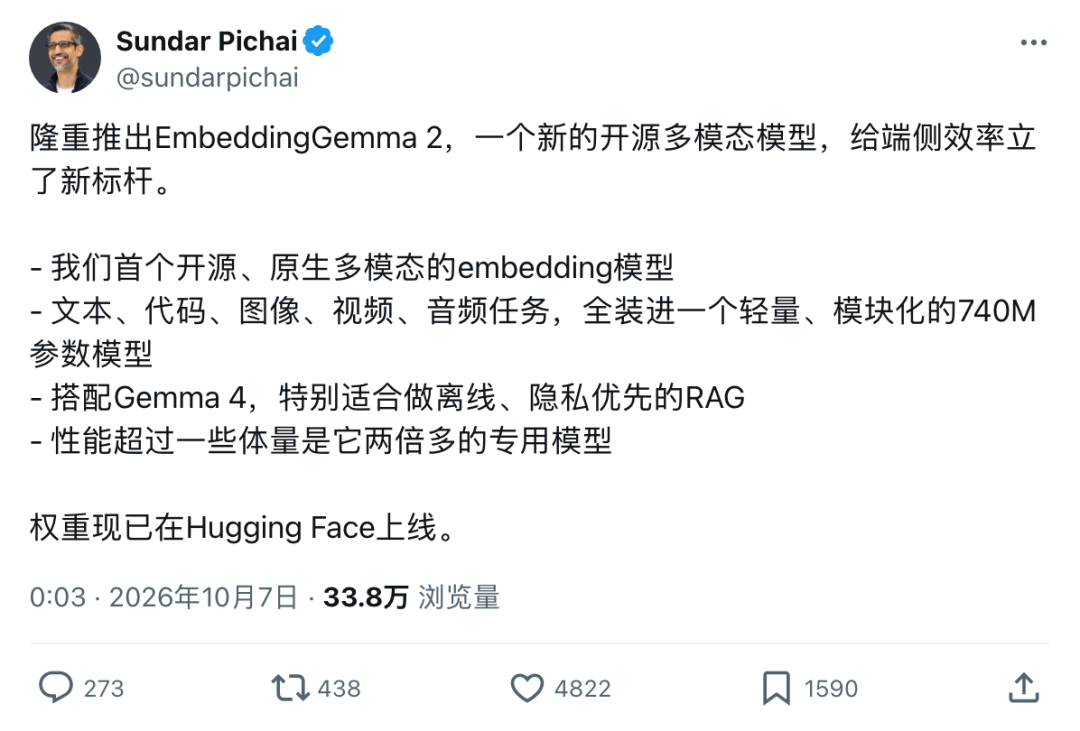
A diferença prática é simples: uma pesquisa que antes dependia de APIs de nuvem ou de modelos separados para imagem, áudio e texto agora pode ser executada localmente com um único modelo compacto.
Os modelos de embeddings costumam ser invisíveis para os usuários finais, mas estão por trás de muitos sistemas modernos de pesquisa e RAG.
Sua função é transformar conteúdo em vetores numéricos:
conteúdo
→ vetor de embedding
→ posição em um espaço semântico
Itens com significado semelhante são posicionados mais próximos uns dos outros. Em seguida, um sistema de pesquisa converte a consulta do usuário em outro vetor e recupera as correspondências mais próximas.
O primeiro EmbeddingGemma era focado em texto. O EmbeddingGemma 2 amplia essa ideia para um espaço multimodal unificado.
O model card da Google informa que o novo modelo mapeia texto, imagens, vídeo e áudio para o mesmo espaço de embeddings de 768 dimensões.
Assim, uma foto de um gato, a palavra “gato” e uma gravação de áudio de um gato podem ser semanticamente relacionadas, embora seus formatos brutos sejam completamente diferentes.
Isso permite pesquisas como:
consulta de texto → imagens correspondentes
consulta de texto → áudio correspondente
consulta de texto → momentos correspondentes em vídeos
consulta de áudio → vídeos correspondentes
consulta de imagem → imagens ou mídias relacionadas
Uma única peça de conteúdo também pode conter várias modalidades.
A Google dá o exemplo de uma página de produto de tênis para trilha que contém uma descrição textual, fotos do produto e um vídeo mostrando a aderência em pedras molhadas. O EmbeddingGemma 2 pode representar o conteúdo combinado com um único embedding e compará-lo com uma consulta como “tênis impermeáveis adequados para corrida em trilhas”.
Pouco depois do lançamento, o engenheiro da Hugging Face Victor M demonstrou o modelo funcionando diretamente em um navegador.
Segundo o artigo de origem, ele digitou:
pássaros cantando
e a grade de resultados foi reordenada imediatamente. Os principais resultados incluíam fotos de pássaros e clipes de áudio com formas de onda de cantos de pássaros.
A consulta teria levado aproximadamente 22 milissegundos. Não houve chamada de modelo no lado do servidor nem necessidade de uma API externa.
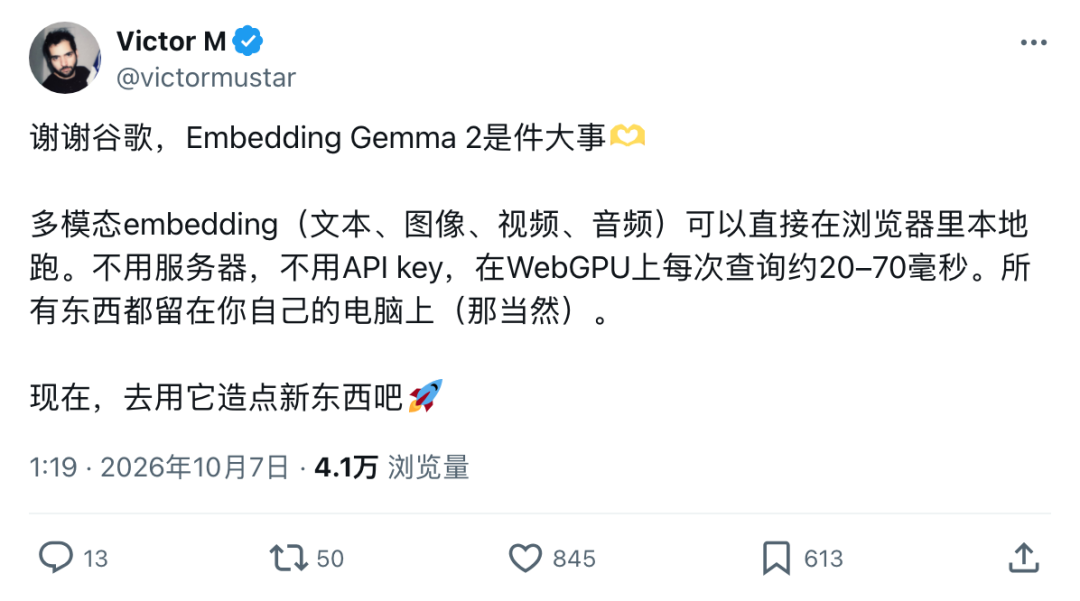
Esse número é um teste de navegador divulgado por um desenvolvedor, não uma garantia oficial de latência da Google.
Ainda assim, o ponto mais amplo é respaldado pelas próprias orientações de implantação da Google: o EmbeddingGemma 2 foi projetado para execução local por meio de ambientes como LiteRT, MediaPipe, WebGPU, transformers.js, MLX, llama.cpp, Ollama e outros runtimes adequados para dispositivos de borda.
O EmbeddingGemma 2 usa uma janela de contexto de 8.192 tokens, quatro vezes maior que a do EmbeddingGemma anterior.
A Google afirma que uma entrada de modalidade única pode conter aproximadamente:
5,5 minutos de áudio
29 imagens
58 quadros de vídeo
ou combinações intercaladas de modalidades.
O modelo também oferece suporte a mais de 100 idiomas.
Isso dá aos sistemas de pesquisa locais muito mais flexibilidade. Em vez de indexar apenas pequenos trechos de texto, uma aplicação pode representar peças de conteúdo mais ricas, contendo passagens mais longas, imagens, quadros de vídeo ou segmentos de áudio.
A Google comparou o EmbeddingGemma 2 com vários sistemas de embeddings de tamanho semelhante.
O artigo de origem destaca as maiores diferenças na recuperação visual.
O model card da Google informa:
| Benchmark | EmbeddingGemma 2 |
|---|---|
| MTEB Multilingual v2 | 61,36 |
| MTEB Code v1 | 78,68 |
| MIEB Lite | 64,64 |
| MMEB v2 Image | 57,28 |
| MMEB v2 Visual Document | 67,84 |
| MMEB v2 Video | 50,67 |
| MSEB Retrieval | 69,54 |
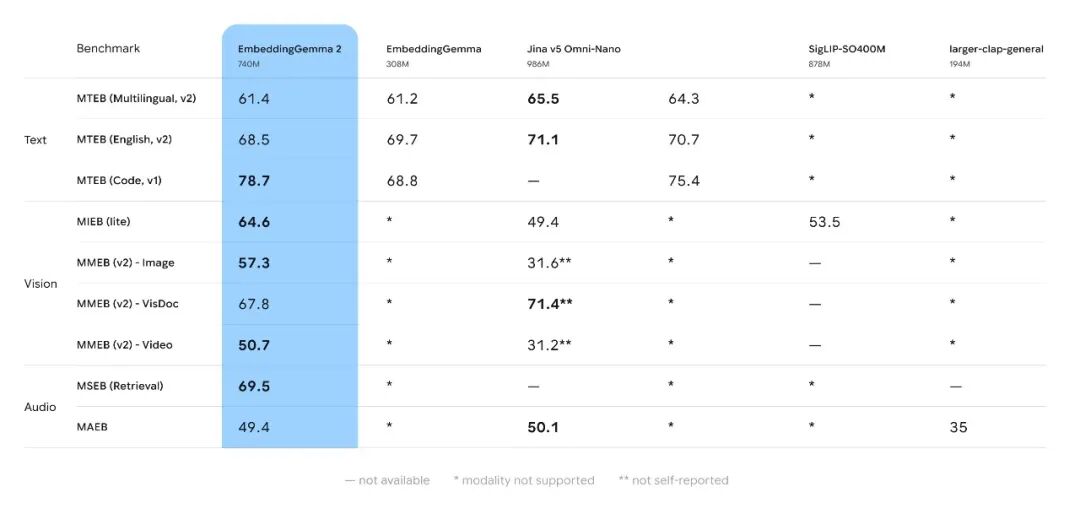
A fonte destaca uma comparação com o Jina v5 Omni-Nano:
MMEB v2 Image
EmbeddingGemma 2: 57,3
Jina v5 Omni-Nano: 31,6

MMEB v2 Video
EmbeddingGemma 2: 50,7
Jina v5 Omni-Nano: 31,2
Esses números vêm da tabela de avaliação publicada pela Google.
Como sempre, os resultados de benchmarks devem ser interpretados dentro da configuração específica de avaliação, e não como uma classificação universal para todas as cargas de trabalho de pesquisa em produção.
O total de 740 milhões de parâmetros é dividido em módulos.
O model card da Google lista:
Texto:
270 milhões de parâmetros no total
  130 milhões no backbone
  140 milhões no embedder

Codificador de visão:
170 milhões de parâmetros

Codificador de áudio:
300 milhões de parâmetros
Os desenvolvedores não precisam carregar os três componentes.
| Modalidades ativas | Tamanho efetivo dos parâmetros |
|---|---|
| Somente texto | 270 milhões |
| Texto + imagem | 440 milhões |
| Texto + áudio | 570 milhões |
| Multimodal completo | 740 milhões |
Essa modularidade é importante em dispositivos de borda. Se uma aplicação pesquisa apenas texto e código, não há motivo para manter o codificador de áudio ou de visão na memória.
A Google informa que, após a quantização em um Pixel 11 Pro, o modelo pode funcionar com aproximadamente:
RAM ativa somente para texto:
~191 MB

RAM ativa multimodal completa:
~567 MB
Essa é a base do título “menos de 600 MB” do artigo de origem.
O modelo usa treinamento ciente de quantização e oferece opções de implantação INT4 e INT8.
Isso é significativo porque os pipelines de pesquisa multimodal tradicionalmente exigem vários componentes separados:
codificador de imagem
+
reconhecimento de fala ou codificador de áudio
+
modelo de embeddings de texto
+
pré-processamento adicional
O EmbeddingGemma 2 reúne grande parte disso em uma arquitetura unificada.
A dimensão de saída nativa é 768.
O EmbeddingGemma 2 também oferece suporte ao Matryoshka Representation Learning, permitindo truncar os vetores para:
512 dimensões
256 dimensões
128 dimensões
A Google afirma que isso pode reduzir em até 6 vezes o armazenamento do banco de dados vetorial local em relação à representação completa de 768 dimensões.
O blog do Google AI Edge descreve determinadas configurações de índice e armazenamento locais como capazes de alcançar reduções de até 8 vezes, dependendo de como a representação e o pipeline de armazenamento são configurados.
O model card acrescenta um detalhe importante de implementação: os vetores truncados devem ser renormalizados antes da pesquisa por similaridade de cosseno.
Se os vetores da consulta e do documento usarem dimensões diferentes, eles também não poderão ser comparados diretamente.
A Google publicou várias aplicações de referência em torno do modelo.
O Instant Media Search, da Google AI Edge Gallery, permite que os usuários pesquisem fotos e vídeos locais usando linguagem natural ou uma imagem de exemplo.
O aplicativo:
Não é necessária uma conexão com a internet para o cálculo dos embeddings.
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
O Video Moments Finder permite pesquisar momentos específicos dentro de arquivos de vídeo locais.
Entre os exemplos da Google estão consultas como:
crianças rindo
a cachorro pegando um frisbee
pessoa apagando velas de aniversário
O aplicativo indexa trechos visuais e de áudio e retorna os timestamps correspondentes.
A Google também lançou o AI Edge Foresight para Mac.
O Foresight usa o EmbeddingGemma 2 junto com o Gemma 4 para recuperação local e raciocínio contextual.
A Google afirma que ele pode indexar transcrições de reuniões, pesquisar arquivos privados, recuperar imagens/documentos/anotações, funcionar offline e manter o material de origem sensível no dispositivo.
Isso se aproxima da arquitetura de RAG local descrita no artigo original:
EmbeddingGemma 2
→ recuperar contexto local relevante

Gemma 4
→ raciocinar sobre o contexto recuperado
O artigo de origem também reúne vários experimentos iniciais de desenvolvedores.
Eles são exemplos úteis, mas devem ser tratados como resultados divulgados pela comunidade, e não como benchmarks oficiais da Google.
O aplicativo para Mac Nativ divulgou testes usando um modelo quantizado para 8 bits em um Apple M5 Max.
Os números publicados incluíam:
similaridade de cosseno em relação a FP32:
0,9997

throughput de embeddings de texto no lote 32:
817 itens/segundo
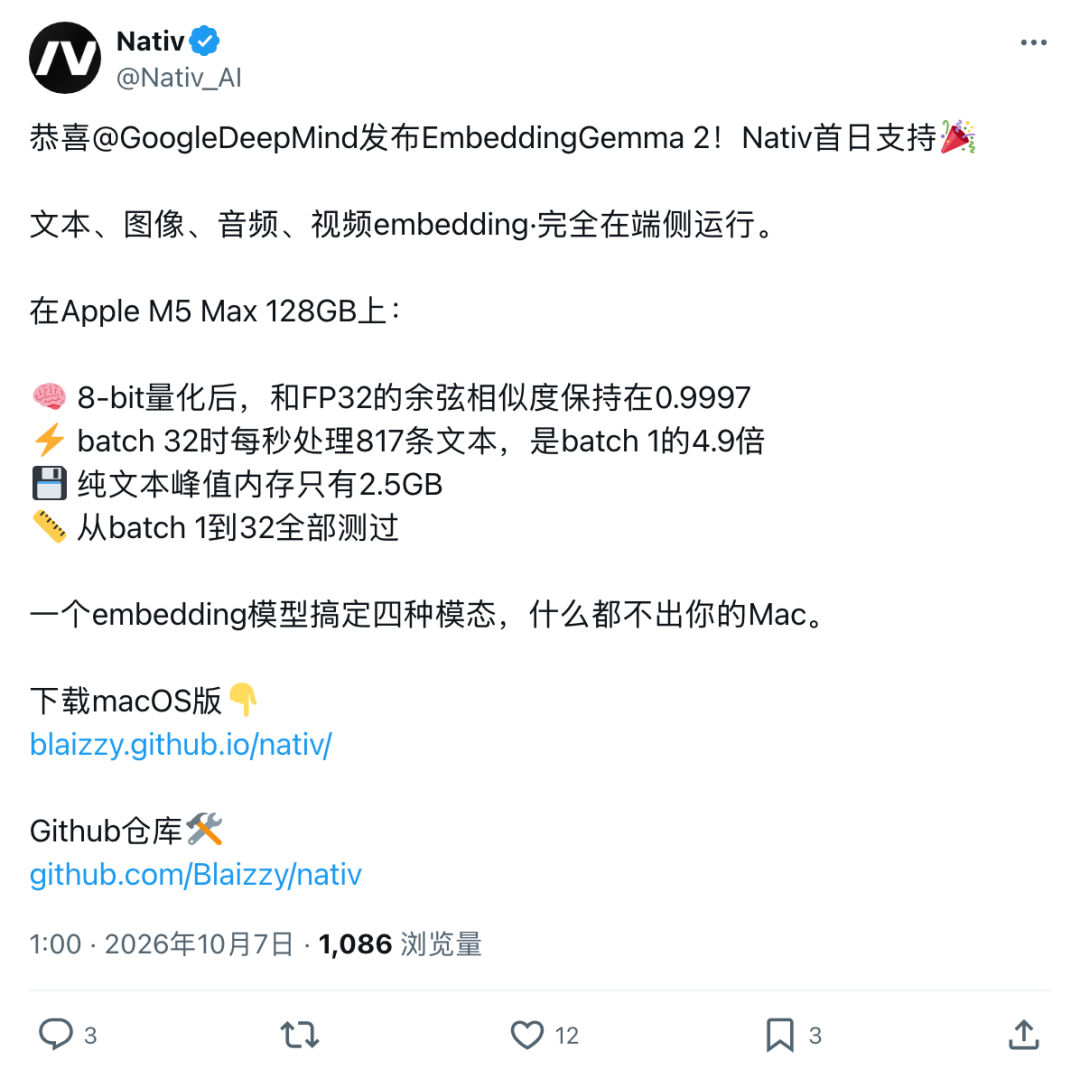
Esses números dependem da implementação específica, da quantização, do hardware e do tamanho do lote.
Um desenvolvedor turco citado na fonte criou um pequeno teste com anotações pessoais.
As anotações foram escritas principalmente em inglês, enquanto as consultas estavam em turco.
Em seu teste divulgado:
taxa de acerto da correspondência por palavra-chave:
15%

taxa de acerto do EmbeddingGemma 2:
97%
A configuração verificava se a anotação correta aparecia entre os 18 principais candidatos.
Ele também testou mensagens reais com muitos erros de digitação e informou que o modelo semântico encontrou aproximadamente o dobro de anotações relevantes em comparação com a pesquisa por palavras-chave. Cada consulta teria levado cerca de 50 milissegundos localmente.
Este não é um benchmark padronizado, mas ilustra uma das principais razões pelas quais a pesquisa por embeddings é útil: a similaridade semântica pode funcionar mesmo quando a consulta e o texto armazenado usam palavras ou idiomas diferentes.
O desenvolvedor Nick Lo também demonstrou uma versão quantizada do EmbeddingGemma 2 executada por meio do llama.cpp em uma placa de desenvolvimento Nano.
Ele relatou aproximadamente:
~15 ms
para converter uma consulta de texto em um embedding para um pequeno sistema local de pesquisa de imagens.
Depois que a imagem correspondente era encontrada, um ESP32-S3 desenhava a imagem linha por linha.

Novamente, este é um experimento de desenvolvedor, e não uma latência de referência oficial.
O modelo não se limita a mídias.
A recuperação de código melhorou significativamente em relação ao EmbeddingGemma anterior.
A Google informa:
MTEB Code v1

EmbeddingGemma:
68,76

EmbeddingGemma 2:
78,68
Isso representa um aumento de 9,92 pontos.
O Google Gemma destaca especificamente a indexação local de bases de código, a pesquisa semântica de código e a recuperação para agentes de programação como casos de uso-alvo.
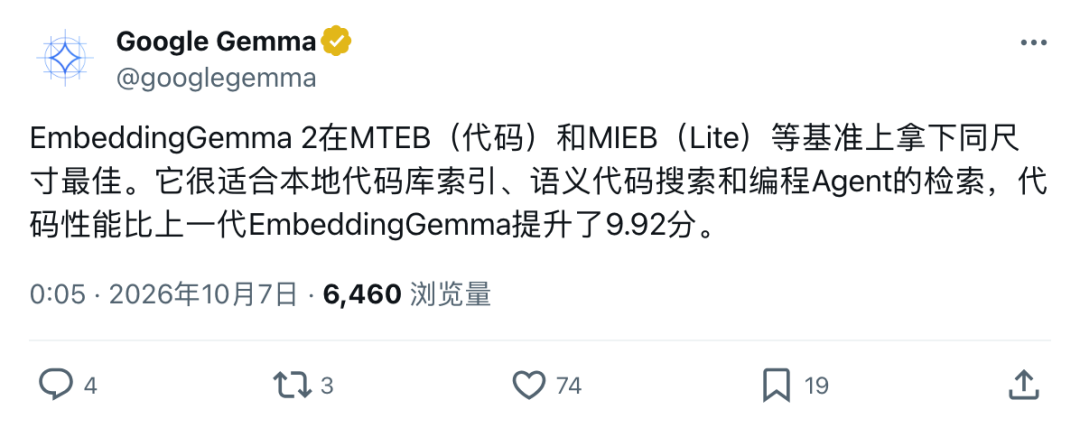
As ferramentas como agentes de programação precisam encontrar a parte relevante de um repositório antes de poderem editá-lo.
Um embedder local compacto oferece aos desenvolvedores outra arquitetura:
repositório de código-fonte
→ criar embeddings localmente
→ armazenar o índice localmente
→ consulta em linguagem natural
→ recuperar o código relevante
→ enviar apenas o contexto selecionado para um modelo de programação maior
A indexação e a recuperação inicial podem permanecer na própria máquina do desenvolvedor.
A Google já havia lançado o Gemini Embedding 2 como uma API de nuvem no início de 2026.
O EmbeddingGemma 2 adota uma abordagem diferente.
Em vez de exigir uma API hospedada para gerar embeddings multimodais, ele é um modelo de pesos abertos que pode ser executado localmente.
| Abordagem | Principal vantagem |
|---|---|
| API de embeddings na nuvem | Infraestrutura gerenciada e escalabilidade fácil |
| EmbeddingGemma 2 no dispositivo | Privacidade, operação offline e baixa latência local |
Para mídias pessoais, arquivos privados, anotações empresariais e repositórios de código locais, a segunda opção pode ser interessante porque o material bruto de origem não precisa necessariamente deixar o dispositivo.
A Google promove explicitamente essa abordagem como um design que prioriza a privacidade.
Isso não significa que toda aplicação se torna automaticamente privada. O restante da aplicação também precisa ser projetado corretamente, incluindo armazenamento local seguro, controle de acesso e tratamento cuidadoso do conteúdo recuperado.
O EmbeddingGemma 2 é o modelo de embeddings multimodais de pesos abertos da Google, baseado na tecnologia Gemma 4. Ele mapeia texto, código, imagens, vídeo, áudio e entradas mistas para um espaço vetorial compartilhado de 768 dimensões, destinado a pesquisa, RAG, similaridade, classificação e agrupamento.
O modelo completo tem 740 milhões de parâmetros. O componente de texto usa 270 milhões de parâmetros, enquanto os codificadores opcionais de visão e áudio adicionam 170 milhões e 300 milhões de parâmetros, respectivamente.
Sim. A Google o projetou para uso no dispositivo e oferece caminhos de implantação para telefones, laptops, navegadores e hardware de borda. As próprias demonstrações de AI Edge da Google realizam pesquisas locais sem exigir chamadas de embeddings na nuvem.
A Google informa cerca de 191 MB de RAM ativa para os pesos quantizados somente de texto e cerca de 567 MB para o modelo multimodal completo em um Pixel 11 Pro. O uso real de memória varia conforme o runtime, o hardware, a precisão e os codificadores habilitados.
Sim. Todas as modalidades compatíveis são mapeadas para o mesmo espaço vetorial. Assim, o texto pode recuperar imagens, áudios ou segmentos de vídeo, e as mídias também podem ser comparadas com outras mídias.
A Google disponibiliza os pesos do modelo sob a licença Apache 2.0, permissiva para uso comercial, e o descreve como um modelo aberto. Os usuários ainda precisam seguir a Gemma Prohibited Use Policy e os termos aplicáveis.
Sim. A Google informa uma pontuação de 78,68 no MTEB Code, acima dos 68,76 do EmbeddingGemma anterior, e lista explicitamente a indexação local de repositórios e a recuperação para agentes de programação entre os casos de uso pretendidos.
O EmbeddingGemma 2 é um modelo de embeddings: ele converte conteúdo em vetores para recuperação e cálculo de similaridade. O Gemma 4 é um modelo generativo que pode raciocinar sobre informações recuperadas. Por isso, a Google mostra os dois combinados em fluxos de trabalho RAG totalmente locais.
O EmbeddingGemma 2 tira a pesquisa semântica multimodal da nuvem e a coloca ao alcance de hardware comum de consumo. Um único modelo de 740 milhões de parâmetros pode gerar embeddings de texto, código, imagens, vídeo e áudio em um espaço vetorial, usando cerca de 567 MB de RAM ativa na configuração multimodal completa da Google em um Pixel 11 Pro.
Sua principal vantagem prática é a simplicidade arquitetural: um único modelo compacto pode oferecer pesquisa local de mídia, recuperação de momentos em vídeos, RAG privado, pesquisa multilíngue de anotações e indexação de repositórios sem exigir que cada arquivo bruto seja enviado a um servidor.
As demonstrações oficiais da Google, o model card e a stack de implantação respaldam a proposta de execução no dispositivo. Os números do navegador, do Nativ, das anotações em turco e da placa Nano apresentados na fonte são experimentos iniciais úteis de desenvolvedores, mas devem ser interpretados como resultados específicos de cada implementação, e não como desempenho garantido.
O EmbeddingGemma 2 torna a recuperação multimodal local suficientemente realista para que fotos, gravações, vídeos, documentos e código possam ser cada vez mais pesquisados onde já estão — no próprio dispositivo do usuário.
Comece com uma frase e tenha um site completo em minutos.



