For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/pt/articles/grok-45-coding-benchmarks-token-efficiency.md.
Grok 4.5 é um modelo de fronteira voltado para codificação, agentes e trabalho com conhecimento. Suas principais vantagens práticas são a co...
O Grok 4.5 coloca a xAI de volta na linha de frente da corrida de modelos de codificação.
Lançado em 8 de julho de 2026, o modelo foi projetado para engenharia de software, tarefas agentivas e trabalho de conhecimento mais amplo. Foi treinado com o Cursor e agora está disponível através da API xAI, Grok Build e Cursor. O destaque não é apenas a qualidade do modelo. O Grok 4.5 também é posicionado em torno de uma execução mais rápida, menos tokens gerados e um menor custo por tarefa concluída.
A documentação oficial do modelo lista uma janela de contexto de 500.000 tokens, entrada de texto e imagem, raciocínio configurável, chamada de funções, suporte a saídas estruturadas e preços de API de $2 por milhão de tokens de entrada e $6 por milhão de tokens de saída.
Este artigo explica onde o Grok 4.5 tem bom desempenho, como suas alegações de eficiência devem ser interpretadas, o que mudou no treinamento e por que a pilha de inferência ao redor pode se tornar tão importante quanto o próprio modelo.

O Grok 4.5 é o modelo principal da xAI para codificação, trabalho agentivo e tarefas gerais de conhecimento baseadas em computador. Os materiais oficiais de lançamento o descrevem como um modelo que pode lidar com trabalhos de longa duração, usar ferramentas, recuperar-se de erros e verificar resultados, em vez de parar após uma única resposta.
Isso o coloca na mesma categoria geral dos modelos de ponta usados para codificação autônoma, alterações em nível de repositório, pesquisa técnica, análise de dados e fluxos de trabalho de escritório com várias etapas.
| Item | Grok 4.5 |
|---|---|
| Nome do modelo | grok-4.5 |
| Casos de uso principais | Codificação, tarefas agentivas, trabalho de conhecimento |
| Modalidades de entrada | Texto e imagens |
| Modalidade de saída | Texto |
| Janela de contexto | 500.000 tokens |
| Raciocínio | Configurável |
| Chamada de funções | Suportada |
| Saídas estruturadas | Suportadas |
| Preço de entrada | $2 por 1M tokens |
| Preço de entrada em cache | $0,50 por 1M tokens |
| Preço de saída | $6 por 1M tokens |
| Velocidade de execução relatada | Até 80 tokens por segundo |
| Disponibilidade | API xAI, Grok Build, Cursor |
A janela de contexto de 500 mil tokens é grande o suficiente para bases de código substanciais, documentos técnicos longos, investigações de vários arquivos e históricos de agentes extensos. Uma janela de contexto grande não garante automaticamente melhores resultados, mas dá às ferramentas mais espaço para fornecer material de origem relevante sem truncamento agressivo.
O anúncio oficial da xAI publica resultados em várias avaliações de engenharia de software. O Grok 4.5 não é o melhor modelo em todos os benchmarks, mas permanece competitivo com outros sistemas de fronteira.
| Benchmark | Grok 4.5 | Resultados de comparação selecionados |
|---|---|---|
| DeepSWE 1.0 | 62,0% | Fable max 66,1%; GPT-5.5 xhigh 64,31%; Opus 4.8 max 55,75% |
| DeepSWE 1.1 | 53,0% | Fable max 70%; GPT-5.5 xhigh 67%; |
| Opus 4.8 max 59% |
| Terminal-Bench 2.1 | 83,3% | Fable max 84,3%; GPT-5.5 xhigh 83,4%; Opus 4.8 max 78,9% |
| SWE-Bench Pro | 64,7% | Fable max 80,4%; Opus 4.8 max 69,2%; Opus 4.7 max 64,3% |
| SWE Marathon | 29,0% | Opus 4.8 max 26,0%; Fable max 24,0%; Opus 4.7 max 16,0% |
Esses números sugerem um modelo especialmente forte em tarefas de terminal, trabalhos práticos de engenharia e fluxos de agente mais longos. Eles ainda devem ser lidos com cuidado. Configurações de benchmark, ajustes de raciocínio, acesso a ferramentas e configurações específicas do provedor podem afetar o resultado.
A Cursor também revelou que um snapshot antigo do código-fonte do Cursor estava acidentalmente presente nos dados de treinamento, o que pode influenciar o CursorBench. A empresa excluiu esse benchmark de sua comparação pública e afirmou que os dados não serão usados para modelos futuros.
A alegação mais prática em torno do Grok 4.5 é a eficiência.
A xAI afirma que o modelo é servido a até 80 tokens por segundo. Isso é rápido o suficiente para tornar rastros de raciocínio longos, edições de repositório e loops de agente iterativos mais responsivos do que modelos premium mais lentos.
A empresa também relata que o Grok 4.5 usou uma média de 15.954 tokens de saída por tarefa do SWE-Bench Pro, em comparação com 67.020 tokens de saída para o Opus 4.8 em sua configuração máxima. Isso resulta em aproximadamente 4,2 vezes menos tokens de saída na carga de trabalho medida.
A eficiência de tokens é importante por três razões:
A métrica importante não é simplesmente o preço por milhão de tokens. As equipes devem comparar o custo de concluir a mesma tarefa em um nível de qualidade aceitável. Um modelo com um preço de token listado mais alto ainda pode ser mais barato se precisar de menos tentativas, menos chamadas de ferramenta ou menos
tokens gerados.
O preço base da API é:
| Tipo de token | Preço |
|---|---|
| Entrada | $2 por 1M tokens |
| Entrada em cache | $0,50 por 1M tokens |
| Saída | $6 por 1M tokens |
A Cursor também oferece uma variante mais rápida a $4 por milhão de tokens de entrada** e $18 por milhão de tokens de saída em sua própria oferta de modelo. Os preços e a disponibilidade podem variar de acordo com a plataforma, portanto, as equipes de produção devem confirmar a taxa no ambiente que realmente utilizam.
O Grok 4.5 é feito para fazer mais do que completar uma função ou explicar um erro. Os exemplos oficiais incluem:
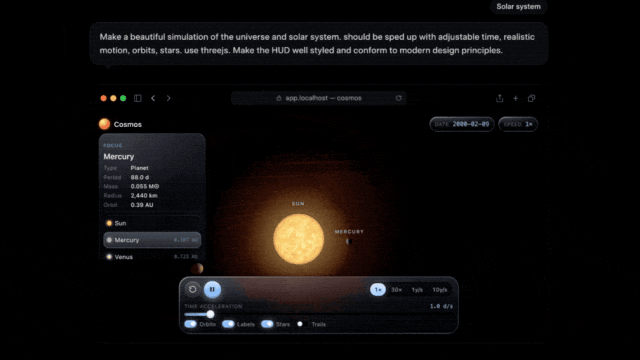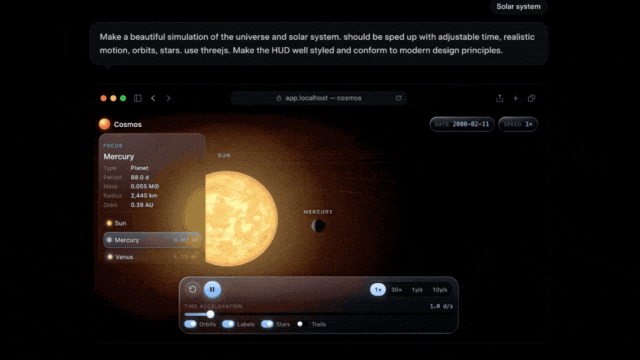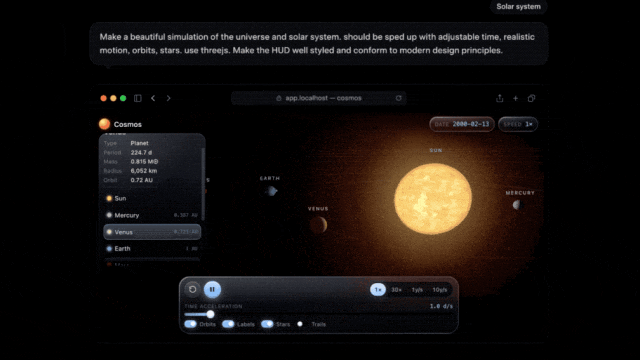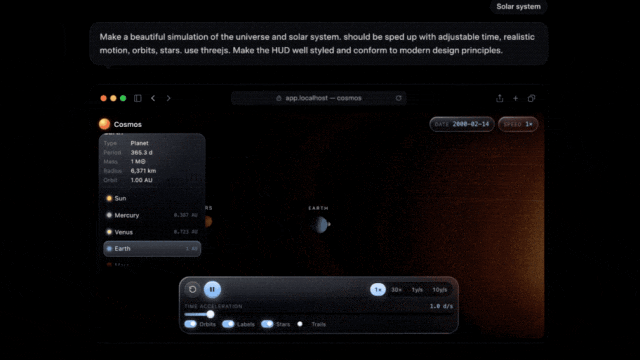
A demonstração do sistema solar é útil porque combina design, código front-end, renderização 3D, controles e lógica de interação. Não é uma prova de que toda aplicação de um único prompt estará pronta para produção, mas mostra o tipo de tarefa integrada para a qual o modelo está sendo otimizado.
O Grok 4.5 também se estende ao trabalho de escritório. Nos materiais de lançamento, ele cria slides estruturados de revisão de negócios e trabalha com planilhas que envolvem fórmulas, pesquisa na web e várias abas.

Para equipes de desenvolvimento, um fluxo de trabalho prático pode ser assim:
Um modelo pode ser rápido e capaz, mas ainda assim produzir suposições incorretas, alterações inseguras ou validação incompleta. O melhor uso de modelos de codificação agênticos é geralmente automação estruturada com evidências visíveis, não autonomia irrestrita.
Os ganhos de eficiência não são apresentados como uma simples otimização de serviço. Tanto a xAI quanto a Cursor descrevem mudanças na arquitetura do modelo, preparação de dados, aprendizado por reforço e treinamento distribuído.
A Cursor descreve o Grok 4.5 como um modelo de mistura de especialistas (MoE). Em um sistema MoE, apenas parte da rede é ativada para um determinado token ou tarefa. Isso pode aumentar a capacidade total do modelo sem exigir que todos os parâmetros participem de cada etapa de inferência.
As fontes oficiais não divulgam detalhes de implementação suficientes para calcular o poder computacional exato usado por token. Portanto, é mais preciso focar no comportamento medido — velocidade, qualidade em benchmarks e consumo de tokens — do que inferir o desempenho a partir de uma contagem de parâmetros não verificada.
A xAI afirma que o Grok 4.5 foi treinado em dezenas de milhares de GPUs NVIDIA GB300. O treinamento nessa escala exige mais do que hardware bruto. Execuções longas precisam de sistemas distribuídos estáveis, recuperação de pontos de verificação, rede, pipelines de dados e monitoramento que mantenham milhares de aceleradores produtivos.
O anúncio enfatiza técnicas de estabilidade projetadas para execuções de treinamento em grande escala. Isso é importante porque uma falha em um experimento longo pode desperdiçar uma grande quantidade de poder computacional se o sistema não conseguir se recuperar de forma eficiente.
O pipeline de treinamento incluiu:
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
O objetivo é melhorar a densidade de sinais de treinamento úteis, em vez de depender apenas do volume bruto de tokens. Dados repetidos, de baixa qualidade ou fracamente relevantes podem aumentar o custo do treinamento sem proporcionar a mesma melhoria que exemplos cuidadosamente selecionados.
A Cursor afirma que o modelo foi treinado com trilhões de tokens de dados do Cursor. De acordo com a empresa, o conjunto de dados captura interações entre usuários, bases de código, ferramentas de software e agentes.
Essa distinção é importante. Um conjunto de dados apenas de código ensina sintaxe, padrões, bibliotecas e implementações comuns. Os dados de interação também podem ensinar a sequência de trabalho:
Isso ajuda a explicar por que o Grok 4.5 é posicionado em torno da engenharia de software, em vez de conclusão de código isolada.
A xAI afirma que seu programa de aprendizado por reforço abrange centenas de milhares de tarefas, com foco em engenharia de software de várias etapas e outros trabalhos técnicos.
A Cursor descreve ambientes que treinam o modelo para:
As empresas também construíram sistemas de agentes distribuídos para gerar, testar e refinar esses ambientes de treinamento em escala. Algumas execuções de agentes podem durar horas enquanto o processo de treinamento maior continua de forma assíncrona.
Esta é uma mudança significativa em relação à otimização estreita de benchmarks. O modelo está sendo treinado não apenas para produzir uma resposta final correta, mas para navegar pelo processo que leva a ela.
para um.
Os pesos do modelo são apenas uma parte do produto final.
Uma declaração pública de Elon Musk disse que o Grok 4.5 ainda não estava usando o software de inferência C/C++ desenvolvido internamente pela xAI, mapeado especificamente para o hardware GB300. Ele sugeriu que a pilha otimizada poderia potencialmente dobrar a velocidade de serviço ou melhorá-la ainda mais.
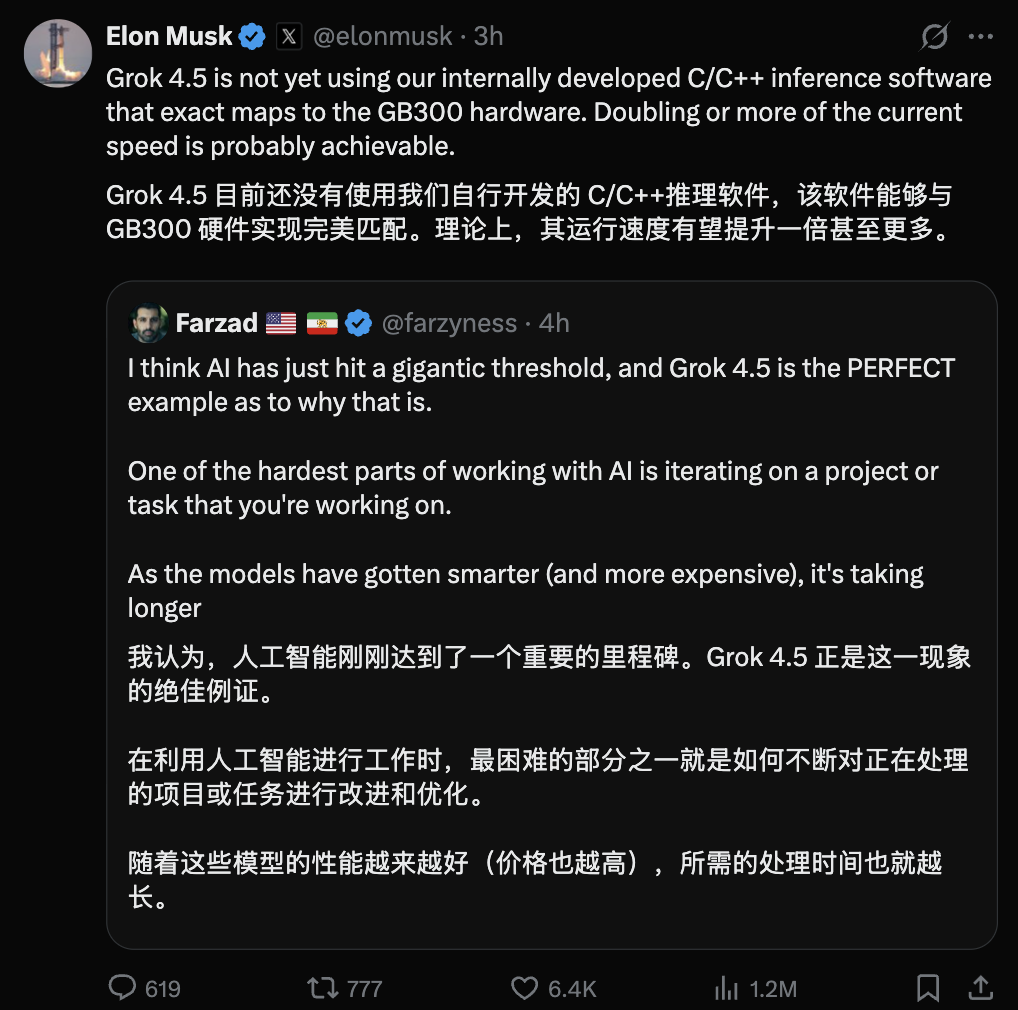
Esta é uma afirmação prospectiva, em vez de um resultado de produção medido, portanto não deve ser tratada como desempenho garantido. Ainda assim, ela destaca para onde a competição de modelos está se movendo.
Quando os modelos de fronteira se aproximam em qualidade de benchmark, o sistema ao redor pode criar a vantagem prática:
Para os usuários, isso significa que as comparações de modelos devem incluir mais do que uma única pontuação de inteligência. Um modelo que responde mais rápido, produz menos tokens, usa cache de forma eficaz e completa tarefas com menos tentativas pode oferecer melhor valor no mundo real, mesmo quando outro modelo lidera em um benchmark.
O Grok 4.5 está disponível através da API Responses da xAI. O exemplo Python a seguir usa a interface de cliente compatível com OpenAI:
import os
from openai import OpenAI

api_key = os.environ.get("XAI_API_KEY")
if not api_key:
    raise RuntimeError("Defina a variável de ambiente XAI_API_KEY primeiro.")

client = OpenAI(
    api_key=api_key,
    base_url="https://api.x.ai/v1",
)

response = client.responses.create(
    model="grok-4.5",
    input=(
        "Revise esta função JavaScript, corrija o bug "
        "e explique a mudança: "
        "function median(values) { values.sort(); "
        "return values[values.length / 2]; }"
    ),
)

print(response.output_text)
Antes de usar o modelo em produção:
Grok 4.5 é o modelo de fronteira da xAI para codificação, tarefas agentivas e trabalho de conhecimento. Ele suporta entrada de texto e imagem, raciocínio configurável, chamada de funções e saídas estruturadas.
A documentação oficial do modelo xAI lista uma janela de contexto de 500.000 tokens. O contexto utilizável real pode depender do formato da requisição, saída da ferramenta e limites específicos da plataforma.
O preço base publicado é de $2 por
milhões de tokens de entrada, US$ 0,50 por milhão de tokens de entrada em cache e US$ 6 por milhão de tokens de saída. Variantes específicas de plataforma ou prioridade de serviço podem usar taxas diferentes.
A resposta depende do benchmark e do fluxo de trabalho. O Grok 4.5 é competitivo em vários testes de engenharia e lidera algumas comparações, enquanto outros modelos permanecem à frente em outras áreas. Velocidade, uso de tokens, confiabilidade da ferramenta e custo de conclusão de tarefas devem ser avaliados juntamente com as pontuações dos benchmarks.
A xAI relata que o Grok 4.5 usou, em média, 15.954 tokens de saída por tarefa do SWE-Bench Pro, em comparação com 67.020 para o Opus 4.8 em sua configuração máxima. Isso representa cerca de 4,2 vezes menos tokens de saída para a carga de trabalho medida.
Sim. A página oficial do modelo lista entrada de texto e imagem com saída de texto. Isso o torna adequado para tarefas como análise de capturas de tela, revisão de documentos e contexto visual em um fluxo de trabalho de agente.
Sim. O Cursor afirma que o Grok 4.5 está disponível em suas experiências de desktop, web, iOS, CLI e SDK. As permissões de uso e os preços dependem do plano do Cursor selecionado.
Ele pode ser usado como o modelo de raciocínio dentro de um agente de produção, mas o sistema ao redor ainda precisa de controles de permissão, validação, observabilidade, novas tentativas e aprovação humana para ações de alto impacto. A força do benchmark não elimina a necessidade de salvaguardas operacionais.
O Grok 4.5 é um modelo de fronteira voltado para programação, agentes e trabalho de conhecimento. Suas vantagens práticas mais fortes são
a combinação de desempenho competitivo em engenharia, processamento de até 80 tokens por segundo, uma janela de contexto de 500 mil tokens e menor consumo de tokens na comparação publicada do SWE-Bench Pro.
A abordagem de treinamento combina infraestrutura em grande escala, dados curados, rastros de interação do Cursor e aprendizado por reforço em ambientes realistas de uso de ferramentas. Isso ajuda a mover o modelo da geração isolada de código para fluxos de trabalho mais longos e de ponta a ponta.
A principal história não é apenas que o Grok se tornou mais capaz; é que a xAI está competindo no custo total e na velocidade para concluir trabalhos reais.
Comece com uma frase e tenha um site completo em minutos.



