O GPT-6 ainda é novo, mas a OpenAI já está pensando muito além dele.
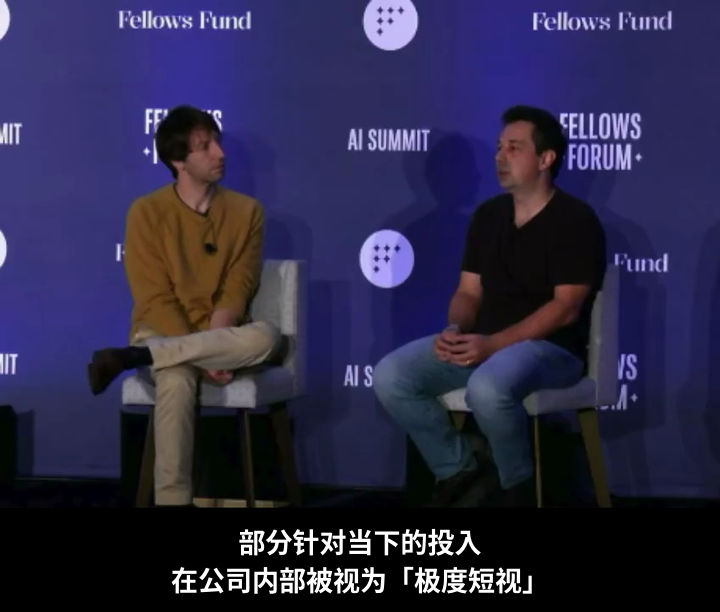
No Fellows Forum AI Summit, em 23 de setembro de 2026, Boris Power, chefe de Pesquisa Aplicada da OpenAI, estimou que aproximadamente 80% a 90% da pesquisa da empresa já está concentrada em:
GPT-7
GPT-8
e gerações posteriores
A declaração foi feita durante uma conversa pública com Zachary Lipton sobre como modelos de fronteira avançam da pesquisa para agentes e sistemas do mundo real.
O ponto de Power não foi que o GPT-6 deixou de ser importante.
A OpenAI ainda está aprimorando ativamente a geração atual. No início de setembro, a empresa lançou o GPT-6 Astra, seu modelo GPT-6 de maior capacidade. Em 22 de setembro, expandiu a família com os mais rápidos e menos caros GPT-6 Sol e GPT-6 Luna.
Isso cria uma contradição aparente:
- Se a maior parte do esforço de pesquisa já está voltada para GPT-7 e GPT-8, por que continuar otimizando o GPT-6?
- Se o objetivo é tornar os modelos mais capazes, por que também investir em variantes menores e mais baratas?
A explicação de Power conecta os dois pontos.
A OpenAI pode continuar aprimorando os modelos atuais porque essas correções tornam os produtos de hoje melhores e ensinam lições úteis à equipe de pesquisa. Ao mesmo tempo, os maiores ganhos de longo prazo podem vir da construção de um modelo de próxima geração muito mais forte — e do uso desse modelo para ajudar a treinar sistemas mais baratos.
O resultado é uma estratégia de duas frentes:
expandir a fronteira de capacidade
+
levar capacidades úteis a uma curva de custo mais baixa
Por que aprimorar o modelo de hoje pode ser "extremamente míope"
Power usou uma linguagem incomumente forte para descrever parte do trabalho em sistemas da geração atual.
Ele disse que certos investimentos voltados aos modelos de hoje são vistos internamente como "extremamente míopes".
Isso não significa que esse trabalho seja inútil.
Suponha que um modelo atual tenha dificuldade com chamadas de ferramentas.
Uma equipe poderia:
- Coletar exemplos da falha.
- Adicionar melhores dados de treinamento.
- Ajustar o processo de treinamento ou avaliação.
- Executar novamente os testes.
- Lançar uma melhoria.
Isso pode melhorar o produto imediatamente.
Também pode ensinar aos pesquisadores por que o modelo falhou e quais intervenções ajudaram.
O alerta de Power diz respeito à vida útil da correção.
Um problema que exige uma intervenção cuidadosa no GPT-6 pode desaparecer naturalmente no GPT-7 porque a próxima geração de modelos é simplesmente melhor na capacidade subjacente.
Em outras palavras:
a correção de hoje
pode se tornar
a solução alternativa obsoleta de amanhã
É por isso que organizações de pesquisa precisam decidir constantemente quais problemas merecem investimento profundo.
O trabalho de curto prazo ainda importa
O fato de que uma correção pode se tornar obsoleta não significa que os usuários possam esperar.
As pessoas estão usando os produtos atuais hoje.
Se um modelo perde repetidamente o objetivo de vista, deixa de usar uma ferramenta corretamente ou exige supervisão manual excessiva, esse problema continua importando.
A distinção de Power é, portanto, entre:
o que melhora o produto agora
e:
o que gera mais valor de pesquisa no longo prazo
O lançamento do GPT-6 Astra pela OpenAI mostra que a empresa ainda está realizando um trabalho substancial na primeira categoria.
No anúncio oficial do Astra, a OpenAI descreve melhorias voltadas ao trabalho prático, incluindo uso mais rápido do computador e melhor colaboração dentro do Codex.
O Astra pode fazer ao usuário uma pergunta específica enquanto continua trabalhando em tarefas que não dependem da resposta. Se a decisão for relevante, ele espera. Se o detalhe ausente for rotineiro, pode seguir adiante com uma suposição razoável.
A OpenAI também afirma que o Astra é melhor em manter o objetivo e as restrições originais quando o usuário adiciona novos requisitos durante uma tarefa.
Esses detalhes podem parecer menos dramáticos do que uma pontuação de benchmark, mas afetam diretamente se um sistema de IA se comporta mais como uma ferramenta ou como um colega capaz.
Primeiro construa o modelo forte, depois ensine o menor
A segunda parte do argumento de Power trata do tamanho do modelo.
Por que investir tão pesadamente em um modelo de fronteira caro se muitos usuários, no fim, querem algo mais rápido e barato?
Porque o modelo mais forte pode se tornar o professor.
Power descreveu um padrão semelhante a este:
treinar um modelo geral altamente capaz
→ usá-lo para gerar exemplos de alta qualidade
→ selecionar ou filtrar resultados úteis
→ treinar um modelo menor com esses exemplos
→ implantar o modelo menor a um custo mais baixo
Essa é uma forma de destilação de modelos.
O modelo aluno não precisa reproduzir todas as capacidades do professor.
Ele precisa apenas herdar comportamento útil suficiente do professor para a tarefa-alvo.
É por isso que o trabalho em um modelo de fronteira ainda pode importar até para clientes que nunca usam diretamente esse modelo.
A OpenAI já usou esse padrão
A OpenAI já descreveu publicamente a destilação em gerações anteriores de produtos.
Em março de 2025, quando a empresa apresentou uma nova geração de modelos de áudio, afirmou ter usado métodos avançados de destilação para transferir conhecimento de modelos de áudio maiores para sistemas menores e mais eficientes.
A empresa também descreveu o uso de dados de autojogo para capturar dinâmicas de conversa mais realistas, de modo que os modelos menores permanecessem úteis e responsivos.
Um exemplo separado do OpenAI Cookbook torna a ideia professor-aluno mais fácil de visualizar.
O exemplo usa o GPT-4o como professor para o GPT-4o mini em uma tarefa de classificação de variedades de uva para vinho.
Em um conjunto de validação com 300 exemplos, as acurácias reportadas foram:
GPT-4o:
79,67%

GPT-4o mini:
64,67%

GPT-4o mini destilado:
79,33%
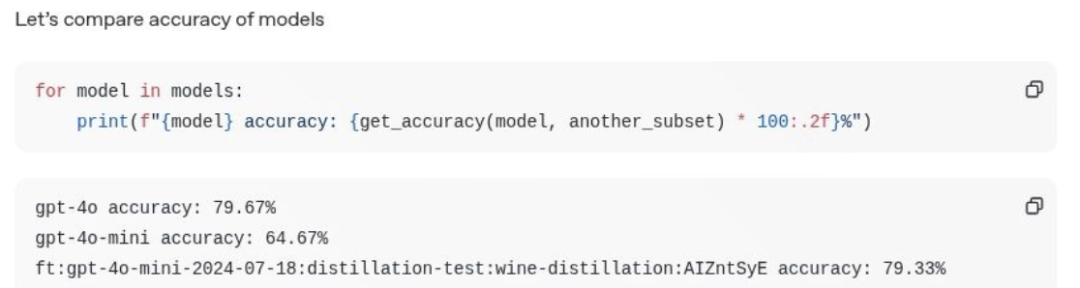
O aluno destilado quase igualou o professor nessa tarefa específica.
Isso não significa que o modelo menor se tornou igual ao GPT-4o de forma geral.
Significa que um professor capaz pode transferir um comportamento direcionado de modo suficientemente eficaz para que um modelo menor se torne muito mais útil em uma carga de trabalho restrita.
Astra, Sol e Luna seguem a mesma lógica mais ampla
A família GPT-6 aplica uma ideia semelhante em escala de produto, embora a OpenAI não tenha publicado uma receita completa de treinamento que justificasse chamar o Luna simplesmente de um "Astra destilado".
A OpenAI afirma que GPT-6 Sol e GPT-6 Luna foram treinados com métodos semelhantes aos usados no GPT-6 Astra, levando os avanços da geração Astra a modelos mais rápidos e acessíveis.
A empresa posiciona a família desta forma:
GPT-6 Astra
maior capacidade

GPT-6 Sol
forte desempenho de propósito geral com menor custo

GPT-6 Luna
modelo de custo muito mais baixo para trabalho de alto volume
Os preços oficiais do GPT-6 da OpenAI no lançamento de 22 de setembro eram:
| Transição de modelo | Entrada | Saída | Redução |
|---|---|---|---|
| GPT-5.6 Sol → GPT-6 Sol | US$ 4 → US$ 2 / 1 milhão de tokens | US$ 20 → US$ 10 / 1 milhão de tokens | 50% |
| GPT-5.6 Luna → GPT-6 Luna | US$ 0,20 → US$ 0,10 / 1 milhão de tokens | US$ 1,20 → US$ 0,50 / 1 milhão de tokens | 50% |
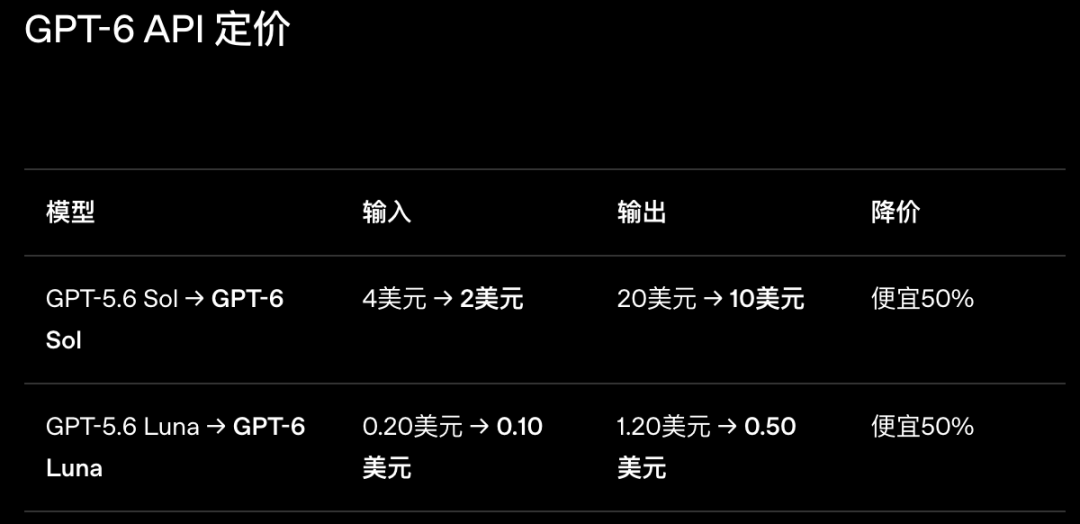
A OpenAI descreve explicitamente o objetivo como distribuir inteligência de fronteira entre diferentes orçamentos e cargas de trabalho.
Um modelo maior eleva o teto.
Modelos menores levam uma parcela maior dessa capacidade para o uso cotidiano.
Por que não usar o maior modelo para tudo?
Porque a maioria dos fluxos de trabalho não tem o mesmo nível de dificuldade do início ao fim.
Um relatório de projeto é um exemplo útil.
Imagine diversos documentos-fonte que:
- Usam definições inconsistentes.
- Discordam sobre números-chave.
- Contêm evidências ausentes.
- Apontam para conclusões diferentes.
A primeira parte do trabalho exige julgamento mais forte.
Um modelo capaz pode:
- Conciliar as fontes conflitantes.
- Identificar alegações sem suporte.
- Sinalizar evidências ausentes.
- Propor uma estrutura coerente.
- Decidir quais questões exigem revisão humana.
Crie um site de apresentacao e gere leads em minutos
Descreva sua ideia uma vez e o We0 AI pode gerar um site de apresentacao, paginas e CMS, alem de ajudar a atrair clientes e trafego apos o lancamento.
Uma geração completa de projetos para registro gratuito
Melhor para experimentar um fluxo de geração completo e ver rapidamente um primeiro rascunho do projeto.
Quando a direção está definida, muitas etapas restantes se tornam mais rotineiras.
Um modelo menor pode ser perfeitamente adequado para:
- Reformatar material.
- Transformar anotações verificadas em seções.
- Gerar variantes repetidas.
- Aplicar um modelo conhecido.
- Atualizar tabelas.
- Produzir resumos diretos.
Se surgir uma nova ambiguidade, a tarefa pode ser escalada novamente para o modelo mais forte.
Um fluxo de trabalho prático poderia, portanto, ser assim:
modelo forte
→ julgamento difícil

modelo pequeno
→ execução repetitiva

modelo forte
→ tratamento de exceções
A métrica real é o custo total do fluxo de trabalho
Tokens mais baratos não significam automaticamente trabalho mais barato.
Um modelo pequeno pode custar menos por solicitação, mas criar mais trabalho para o usuário se exigir:
- Prompts mais detalhados.
- Mais decomposição manual das tarefas.
- Mais verificações.
- Mais tentativas.
- Mais correções.
- Mais escalonamentos.
Portanto, a pergunta útil não é:
Qual modelo tem o menor preço por token?
Mas sim:
Quanto custa todo o resultado aceito?
Esse total inclui tanto o custo da máquina quanto o tempo humano.
Uma conta de API menor não é um grande ganho se o usuário precisar se tornar um gerente de projetos de IA em tempo integral para fazer o modelo mais barato funcionar.
A melhor divisão de trabalho depende, portanto, da tarefa.
Um modelo menor é valioso quando consegue concluir com confiabilidade um trabalho bem definido a baixo custo.
Um modelo maior justifica seu preço mais alto quando a tarefa realmente exige julgamento mais forte.
Os papéis humanos estão mudando à medida que os modelos se tornam mais capazes
Power também descreveu uma mudança na forma como as pessoas interagem com gerações sucessivas de modelos.
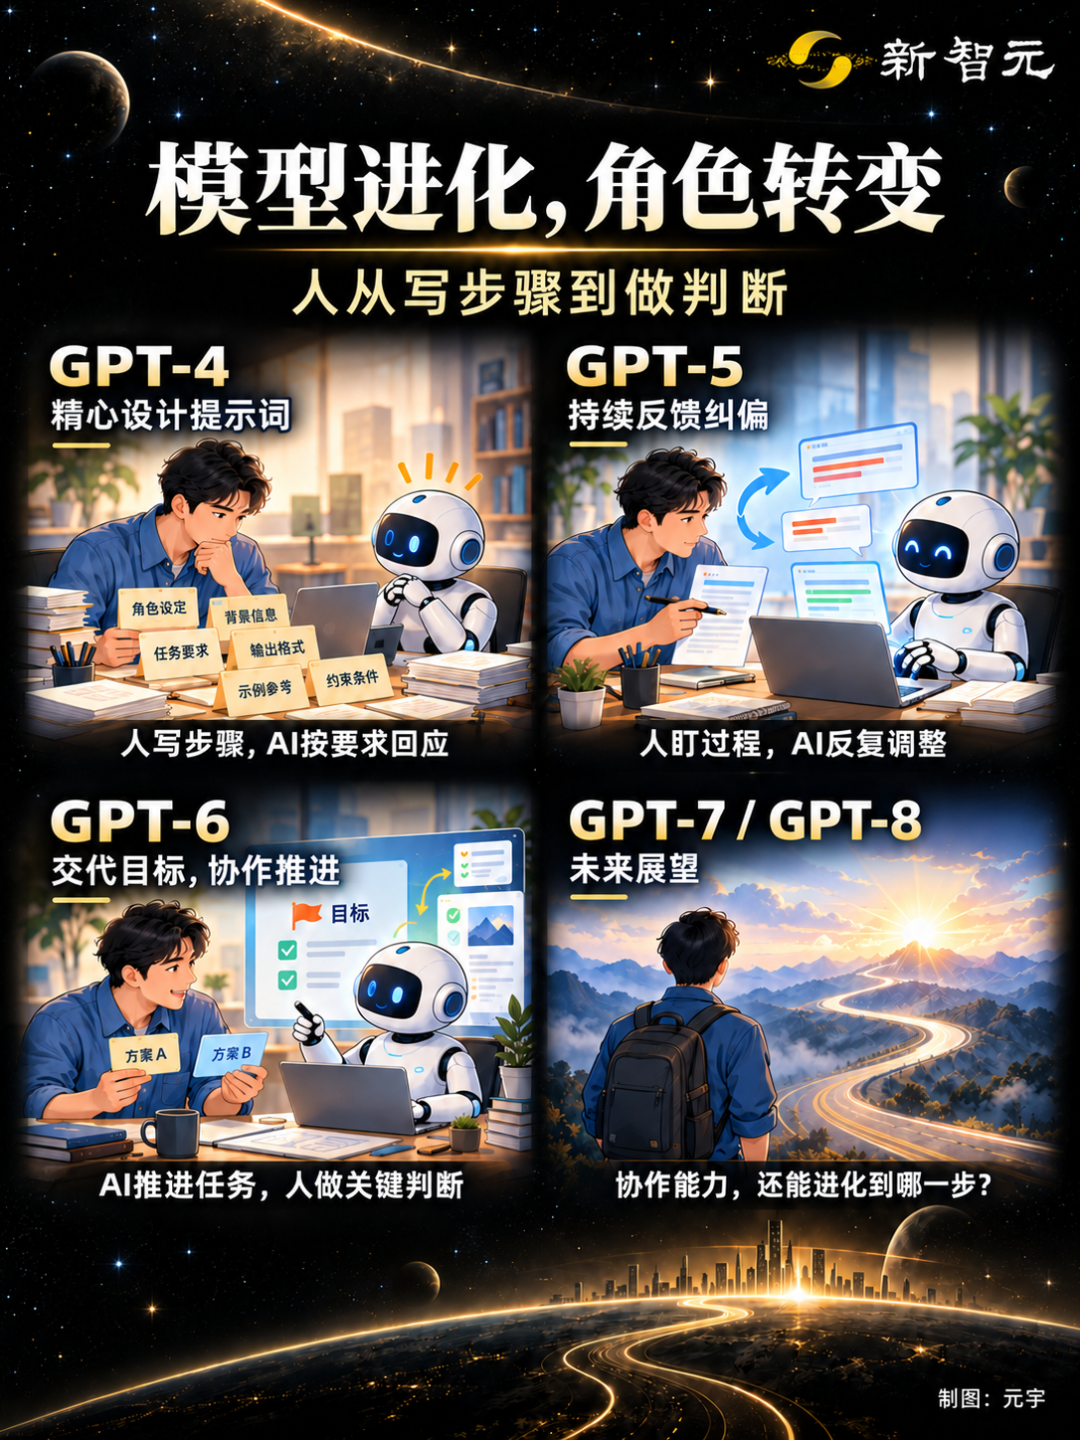
O artigo-fonte resume a progressão aproximadamente desta forma:
GPT-4:
humanos projetam cuidadosamente as etapas

GPT-5:
humanos orientam o processo e seguem corrigindo

GPT-6:
humanos cada vez mais declaram o objetivo e supervisionam decisões-chave
Isso é uma simplificação, não uma garantia para todas as tarefas.
Mas a própria documentação do Astra da OpenAI descreve a mesma direção geral.
O Astra pode:
- Continuar o trabalho independente enquanto aguarda a resposta de um usuário.
- Usar o contexto para preencher lacunas rotineiras.
- Parar e perguntar quando uma decisão puder mudar materialmente o resultado.
- Preservar objetivos e restrições à medida que uma tarefa evolui.
- Pesquisar o contexto anterior ao trabalhar em sessões longas no Codex.
Isso muda o papel humano.
Em vez de especificar manualmente cada etapa, o usuário faz cada vez mais algo próximo a:
definir o objetivo
→ estabelecer restrições
→ revisar escolhas relevantes
→ inspecionar o resultado
A questão-chave para GPT-7 e GPT-8 é até que ponto essa mudança pode avançar.
A métrica importante para usuários é a carga de supervisão
O progresso dos modelos costuma ser apresentado por meio de pontuações de benchmark.
No trabalho cotidiano, outra métrica pode importar mais:
Quanta supervisão o usuário ainda precisa fornecer?
Depois de fornecer um objetivo ao modelo:
- Quantas etapas o usuário ainda precisa dividir?
- Quantas vezes precisa lembrar ao modelo o que importa?
- Com que frequência o modelo perde as restrições originais?
- Quantas tentativas falhas precisam ser corrigidas?
- Com que frequência o usuário precisa assumir o controle?
Se GPT-7 ou GPT-8 reduzir essas cargas, isso pode ser mais valioso do que uma pequena melhoria em benchmarks.
Esse também é o motivo pelo qual a pesquisa em modelos maiores e o trabalho em modelos menores se reforçam mutuamente.
O modelo de fronteira tenta descobrir comportamentos mais capazes.
O modelo mais barato tenta tornar uma parcela suficiente desses comportamentos acessível em escala.
O que o número de 80–90% de Power realmente significa
O número de destaque precisa de uma qualificação importante.
A declaração de "80% a 90%" de Power foi uma estimativa dada durante uma conversa pública.
Ela não foi:
- Uma divisão auditada do orçamento de pesquisa.
- Uma tabela de pessoal publicada.
- Uma divulgação da alocação de capacidade computacional.
- Um roteiro de produto.
- Um anúncio de data de lançamento para GPT-7 ou GPT-8.
A agenda do Fellows Forum confirma que Power falou como chefe de Pesquisa Aplicada da OpenAI em uma conversa informal de 23 de setembro intitulada "Where Models Meet Reality".
A cobertura independente da gravação situa a declaração de 80–90% aproximadamente em 1:32:52 da gravação completa do evento.
Assim, a interpretação mais segura é:
Power acredita que a grande maioria da atenção de pesquisa da OpenAI está voltada para gerações de modelos posteriores ao GPT-6, porque é nelas que ele espera os maiores ganhos fundamentais.
Isso não deve ser interpretado como uma declaração contábil literal.
Nota de cronologia: GPT-6.1 Sol chegou depois do Fellows Forum
Power fez seus comentários em 23 de setembro.
Seis dias depois, em 29 de setembro, a OpenAI lançou o GPT-6.1 Sol.
Esse modelo não é central para o argumento do artigo original porque a discussão se concentra na lógica professor-aluno Astra → Sol/Luna descrita por Power no evento.
Ainda assim, é um contexto útil para leitores que publicam o artigo agora.
A OpenAI descreve o GPT-6.1 Sol como a mais recente família de modelos da série GPT-6, com capacidades próximas às do Astra para programação, uso de computador e trabalho profissional, a um preço padrão de API muito mais baixo.
Sua existência reforça o mesmo padrão discutido na entrevista:
a capacidade de fronteira melhora
→ modelos de menor custo absorvem uma parcela maior dela
→ usuários obtêm desempenho mais forte a custos menores
Também mostra por que os nomes de lançamentos intermediários individuais importam menos do que a estratégia de pesquisa mais ampla.
FAQ
A OpenAI realmente disse que 80–90% de sua pesquisa está focada em GPT-7 e GPT-8?
Boris Power, chefe de Pesquisa Aplicada da OpenAI, estimou no Fellows Forum 2026 que aproximadamente 80–90% da pesquisa da OpenAI está focada em GPT-7, GPT-8 e gerações posteriores. O número foi sua estimativa pública, não um relatório auditado de alocação de recursos da empresa.
A OpenAI anunciou GPT-7 ou GPT-8?
Não. Nenhuma data pública de lançamento ou roteiro detalhado de produto para GPT-7 ou GPT-8 foi anunciado nos comentários de Power. Ele usou os nomes para descrever as gerações posteriores ao GPT-6 que, em sua visão, recebem a maior parte da atenção de pesquisa de longo prazo.
Por que a OpenAI ainda aprimora o GPT-6 se a pesquisa já avançou?
O trabalho na geração atual torna os produtos de hoje melhores e fornece feedback mais rápido aos pesquisadores. O ponto de Power é que algumas correções podem ter vida curta porque um modelo de próxima geração mais capaz pode tornar o problema subjacente mais fácil ou eliminá-lo completamente.
O que é destilação de modelos?
Destilação de modelos é uma família de técnicas em que um modelo professor mais forte ajuda a treinar um modelo aluno menor. Um fluxo de trabalho comum usa o professor para gerar exemplos de alta qualidade, filtra esses exemplos e treina o modelo menor para reproduzir o comportamento necessário para uma tarefa-alvo.
GPT-6 Sol e Luna são apenas versões menores do Astra?
A OpenAI afirma que Sol e Luna foram treinados com métodos semelhantes aos do Astra e herdam avanços da mesma geração, mas não publicou detalhes suficientes para descrever Luna ou Sol simplesmente como cópias comprimidas do Astra. É mais preciso dizer que eles levam avanços de capacidade relacionados a faixas de menor custo.
Quanto custam GPT-6 Sol e Luna?
No lançamento de 22 de setembro, a OpenAI precificou o GPT-6 Sol em US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, e o GPT-6 Luna em US$ 0,10 de entrada e US$ 0,50 de saída por milhão de tokens. A OpenAI descreveu ambos como 50% mais baratos do que os preços promocionais de seus equivalentes GPT-5.6.
Quando uma equipe deve usar um modelo maior em vez de um menor?
Use o modelo mais forte quando a tarefa exigir julgamento difícil, raciocínio ambíguo, tratamento de exceções ou decisões importantes. Modelos menores costumam ser mais adequados para trabalho repetitivo, de alto volume e claramente especificado, uma vez que a direção principal esteja definida.
Como o papel do usuário está mudando com modelos mais novos?
A tendência está passando de escrever cada etapa para definir objetivos, estabelecer restrições e revisar decisões importantes. A documentação do Astra da OpenAI descreve especificamente perguntas assíncronas, continuidade do trabalho enquanto aguarda uma resposta e melhor retenção do objetivo original durante tarefas longas.
Ferramentas relacionadas
- ChatGPT: A principal interface da OpenAI para usar os modelos GPT atuais no trabalho cotidiano.
- Codex: Ambiente de programação com agentes da OpenAI para tarefas de software de maior duração.
- OpenAI API: Documentação oficial para desenvolvedores que integram modelos GPT e ferramentas a aplicações.
- OpenAI Cookbook: Exemplos e guias oficiais, incluindo um tutorial arquivado sobre destilação de modelos.
- OpenAI Developer Changelog: Registro oficial de lançamentos de modelos, recursos de API, observações de preços e alterações da plataforma.
Links relacionados
- Artigo original no BAAI Hub: Artigo em chinês da New Intelligence adaptado e verificado quanto aos fatos aqui.
- Fellows Forum 2026: Site oficial do evento que lista a sessão de Boris Power, “Where Models Meet Reality”.
- GPT-6 Astra: Anúncio oficial do Astra pela OpenAI, que cobre colaboração, Codex, uso de computador e contexto em sessões longas.
- Apresentando GPT-6 Sol e Luna: Preços oficiais, posicionamento dos modelos e explicação de como os modelos GPT-6 de menor custo herdam avanços do Astra.
- Apresentando modelos de áudio de próxima geração: Descrição da OpenAI de 2025 sobre a destilação de modelos de áudio maiores em sistemas menores e mais eficientes.
- OpenAI Cookbook — Destilação de modelos: Exemplo oficial de professor-aluno usando GPT-4o e GPT-4o mini.
- Registro de alterações da OpenAI API: Histórico oficial de lançamentos para GPT-6 Sol, Luna, GPT-6.1 Sol e atualizações relacionadas da API.
- Adendo de segurança do GPT-6.1 Sol: Documento oficial da OpenAI de 29 de setembro que identifica o GPT-6.1 como a mais recente família de modelos da série GPT-6.
Resumo
A estimativa de 80–90% de Boris Power torna a estratégia de pesquisa da OpenAI mais fácil de entender. A empresa pode continuar aprimorando os produtos GPT-6 de hoje enquanto direciona a maior parte da atenção de pesquisa de longo prazo para gerações futuras, nas quais espera ganhos maiores de capacidade.
A segunda parte dessa estratégia é igualmente importante. Modelos de fronteira mais fortes não têm valor apenas como produtos premium; eles também podem servir como professores e plataformas de pesquisa que ajudam a levar capacidades úteis a sistemas mais rápidos e baratos, como Sol e Luna.
Para os usuários, a questão prática não é qual modelo é o maior. É como alocar o trabalho para que o julgamento difícil seja encaminhado ao modelo capaz de realizá-lo, enquanto a execução rotineira seja atribuída ao modelo de menor custo que consiga concluí-la com confiabilidade.
A aposta de longo prazo da OpenAI parece direta: continuar elevando o teto de capacidade e, depois, tornar uma parcela maior dessa capacidade acessível o suficiente para uso diário.