For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/ru/articles/openai-s-gpt-7-and-gpt-8-research-focus-w-75b1c0ac.md.
GPT-6 всё ещё нов, но OpenAI уже думает далеко за его пределами.
GPT-6 всё ещё нов, но OpenAI уже думает далеко за его пределами.
На AI-саммите Fellows Forum 23 сентября 2026 года Борис Пауэр, руководитель отдела прикладных исследований OpenAI, оценил, что примерно 80–90% исследований компании уже сосредоточено на:
GPT-7
GPT-8
и последующих поколениях
Это заявление прозвучало в ходе публичной беседы с Закари Липтоном о том, как передовые модели переходят из исследований в агентов и реальные системы.
Смысл слов Пауэра не в том, что GPT-6 больше не важен.
OpenAI продолжает активно улучшать текущее поколение. Ранее в сентябре компания представила GPT-6 Astra, свою GPT-6-модель с наивысшими возможностями. 22 сентября семейство было расширено более быстрыми и менее дорогими GPT-6 Sol и GPT-6 Luna.
Это создаёт видимое противоречие:
Объяснение Пауэра связывает эти два направления.
OpenAI может продолжать улучшать сегодняшние модели, поскольку эти доработки делают текущие продукты лучше и дают исследовательской команде полезные знания. В то же время самые значительные долгосрочные улучшения могут прийти от создания значительно более сильной модели следующего поколения, а затем от использования этой модели для обучения более дешёвых систем.
В результате возникает двухконтурная стратегия:
продвигать границу возможностей вперёд
+
снижать стоимость полезных возможностей
Пауэр использовал необычно сильные формулировки, говоря о некоторых работах над системами текущего поколения.
Он сказал, что некоторые инвестиции, направленные на сегодняшние модели, внутри компании считают «крайне недальновидными».
Это не означает, что такая работа бессмысленна.
Предположим, текущая модель испытывает трудности с вызовом инструментов.
Команда может:
Это может немедленно улучшить продукт.
Это также может помочь исследователям понять, почему модель дала сбой и какие вмешательства помогли.
Предупреждение Пауэра касается срока актуальности исправления.
Проблема, которая требует тщательной доработки в GPT-6, может естественным образом исчезнуть в GPT-7, потому что модель следующего поколения просто лучше справляется с базовой способностью.
Иными словами:
сегодняшняя заплатка
может стать
завтрашним устаревшим обходным решением
Именно поэтому исследовательским организациям постоянно приходится решать, какие проблемы заслуживают глубоких инвестиций.
Тот факт, что исправление может устареть, не означает, что пользователи могут ждать.
Люди используют текущие продукты уже сегодня.
Если модель регулярно теряет цель, неправильно использует инструмент или требует слишком большого ручного контроля, эта проблема всё равно имеет значение.
Поэтому различие, которое проводит Пауэр, заключается в следующем:
что улучшает продукт сейчас
и:
что создаёт наибольшую долгосрочную исследовательскую ценность
Релиз OpenAI GPT-6 Astra показывает, что компания по-прежнему ведёт существенную работу в первой категории.
В официальном анонсе Astra OpenAI описывает улучшения для практической работы, включая более быстрое использование компьютера и более эффективное взаимодействие внутри Codex.
Astra может задать пользователю точный вопрос, продолжая работу, которая не зависит от ответа. Если решение имеет существенные последствия, она ждёт. Если недостающая деталь является рутинной, модель может продолжить работу, сделав разумное предположение.
OpenAI также заявляет, что Astra лучше сохраняет исходную цель и ограничения, когда пользователь добавляет новые требования в ходе выполнения задачи.
Эти детали могут звучать менее впечатляюще, чем результат бенчмарка, но именно они напрямую влияют на то, ведёт ли себя ИИ-система скорее как инструмент или как компетентный коллега.
Вторая часть аргумента Пауэра касается размера моделей.
Зачем так много инвестировать в дорогую передовую модель, если многим пользователям в конечном счёте нужна более быстрая и дешёвая система?
Потому что более сильная модель может стать учителем.
Пауэр описал схему, которая выглядит так:
обучить высокоспособную универсальную модель
→ использовать её для создания высококачественных примеров
→ отобрать или отфильтровать полезные результаты
→ обучить меньшую модель на этих примерах
→ развернуть меньшую модель с меньшими затратами
Это одна из форм дистилляции моделей.
Модели-ученику не нужно воспроизводить каждую способность модели-учителя.
Ей достаточно унаследовать достаточную часть полезного поведения учителя для целевой задачи.
Именно поэтому работа над передовой моделью может быть важна даже для клиентов, которые никогда не используют такую модель напрямую.
OpenAI публично описывала дистилляцию в предыдущих поколениях продуктов.
В марте 2025 года, когда компания представила новое поколение аудиомоделей, она сообщила об использовании продвинутых методов дистилляции для переноса знаний от более крупных аудиомоделей к меньшим и более эффективным системам.
Компания также описала использование данных самоигры для фиксации более реалистичной динамики диалога, чтобы меньшие модели оставались полезными и отзывчивыми.
Отдельный пример из OpenAI Cookbook позволяет проще увидеть идею учителя и ученика.
В примере GPT-4o используется как учитель для GPT-4o mini в задаче классификации виноградных сортов.
На одном валидационном наборе из 300 примеров были представлены следующие показатели точности:
GPT-4o:
79,67%

GPT-4o mini:
64,67%

Дистиллированный GPT-4o mini:
79,33%
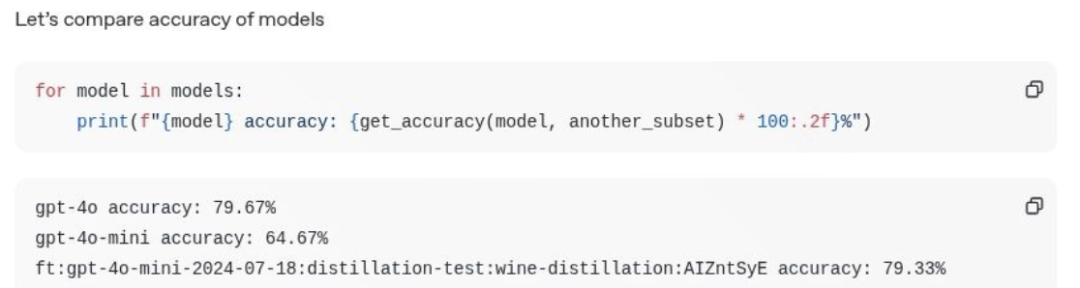
Дистиллированный ученик почти сравнялся с учителем в этой конкретной задаче.
Это не означает, что меньшая модель стала в целом равной GPT-4o.
Это означает, что способный учитель может достаточно эффективно передать целевое поведение, чтобы меньшая модель стала гораздо полезнее для узкого рабочего процесса.
Семейство GPT-6 реализует схожую идею в масштабе продукта, хотя OpenAI не опубликовала полный рецепт обучения, который позволял бы называть Luna просто «дистиллированной Astra».
OpenAI сообщает, что GPT-6 Sol и GPT-6 Luna были обучены методами, схожими с теми, что использовались для GPT-6 Astra, и переносят достижения поколения Astra в более быстрые и доступные модели.
Компания позиционирует семейство следующим образом:
GPT-6 Astra
наивысшие возможности

GPT-6 Sol
сильная производительность общего назначения при меньшей стоимости

GPT-6 Luna
значительно более дешёвая модель для задач большого объёма
Официальные цены OpenAI на GPT-6 на момент релиза 22 сентября были следующими:
| Переход между моделями | Ввод | Вывод | Снижение |
|---|---|---|---|
| GPT-5.6 Sol → GPT-6 Sol | $4 → $2 / 1 млн токенов | $20 → $10 / 1 млн токенов | 50% |
| GPT-5.6 Luna → GPT-6 Luna | $0,20 → $0,10 / 1 млн токенов | $1,20 → $0,50 / 1 млн токенов | 50% |
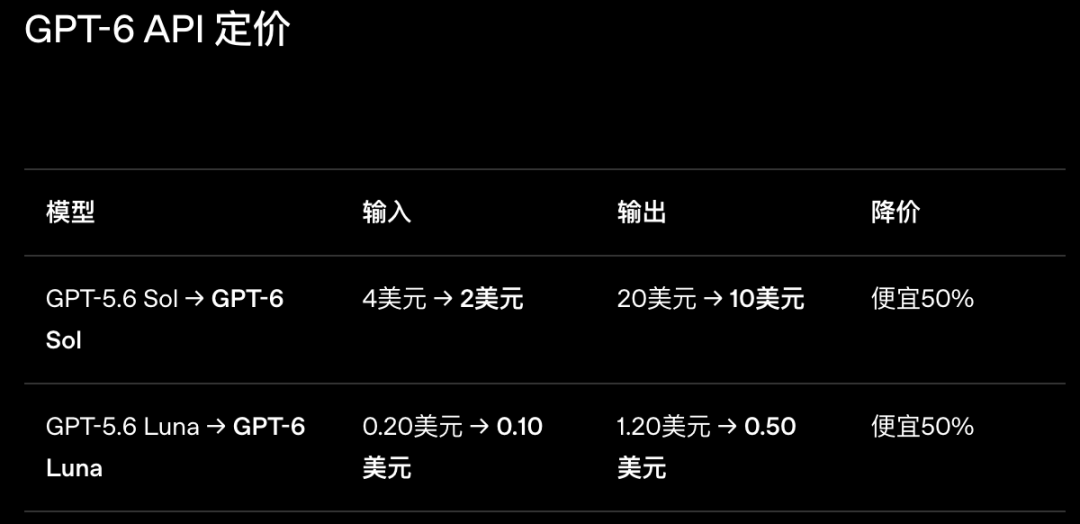
OpenAI прямо описывает цель как распространение передового интеллекта для разных бюджетов и рабочих нагрузок.
Более крупная модель повышает потолок возможностей.
Меньшие модели переносят большую часть этих возможностей в повседневное использование.
Потому что большинство рабочих процессов не одинаково сложны от начала до конца.
Хороший пример — проектный отчёт.
Представьте несколько исходных документов, которые:
Первая часть работы требует более сильного суждения.
Способная модель может:
Опишите идею одной фразой, и We0 AI создаст сайт-витрину, страницы и CMS, а после запуска поможет привлечь клиентов и трафик.
Одна полная генерация проекта для бесплатной регистрации
Лучше всего попробовать один полный поток генерации и быстро увидеть первый черновик проекта.
После определения направления многие оставшиеся шаги становятся более рутинными.
Меньшая модель может быть вполне достаточной для:
Если появляется новая неоднозначность, задачу можно передать обратно более сильной модели.
Таким образом, практический рабочий процесс может выглядеть так:
сильная модель
→ сложное суждение

малая модель
→ повторяющееся выполнение

сильная модель
→ обработка исключений
Дешёвые токены не означают автоматически дешёвую работу.
Малая модель может стоить меньше за запрос, но создавать больше работы пользователю, если она требует:
Поэтому полезный вопрос состоит не в следующем:
У какой модели самая низкая цена токена?
А в следующем:
Во сколько обходится весь принятый результат?
Эта общая стоимость включает и машинные затраты, и время человека.
Меньший счёт за API мало что даёт, если пользователю приходится становиться штатным менеджером ИИ-проектов, чтобы дешёвая модель справилась с задачей.
Поэтому лучшее разделение труда зависит от задачи.
Меньшая модель ценна, когда она может надёжно выполнять чётко определённую работу при низкой стоимости.
Более крупная модель оправдывает более высокую цену, когда задача действительно требует сильного суждения.
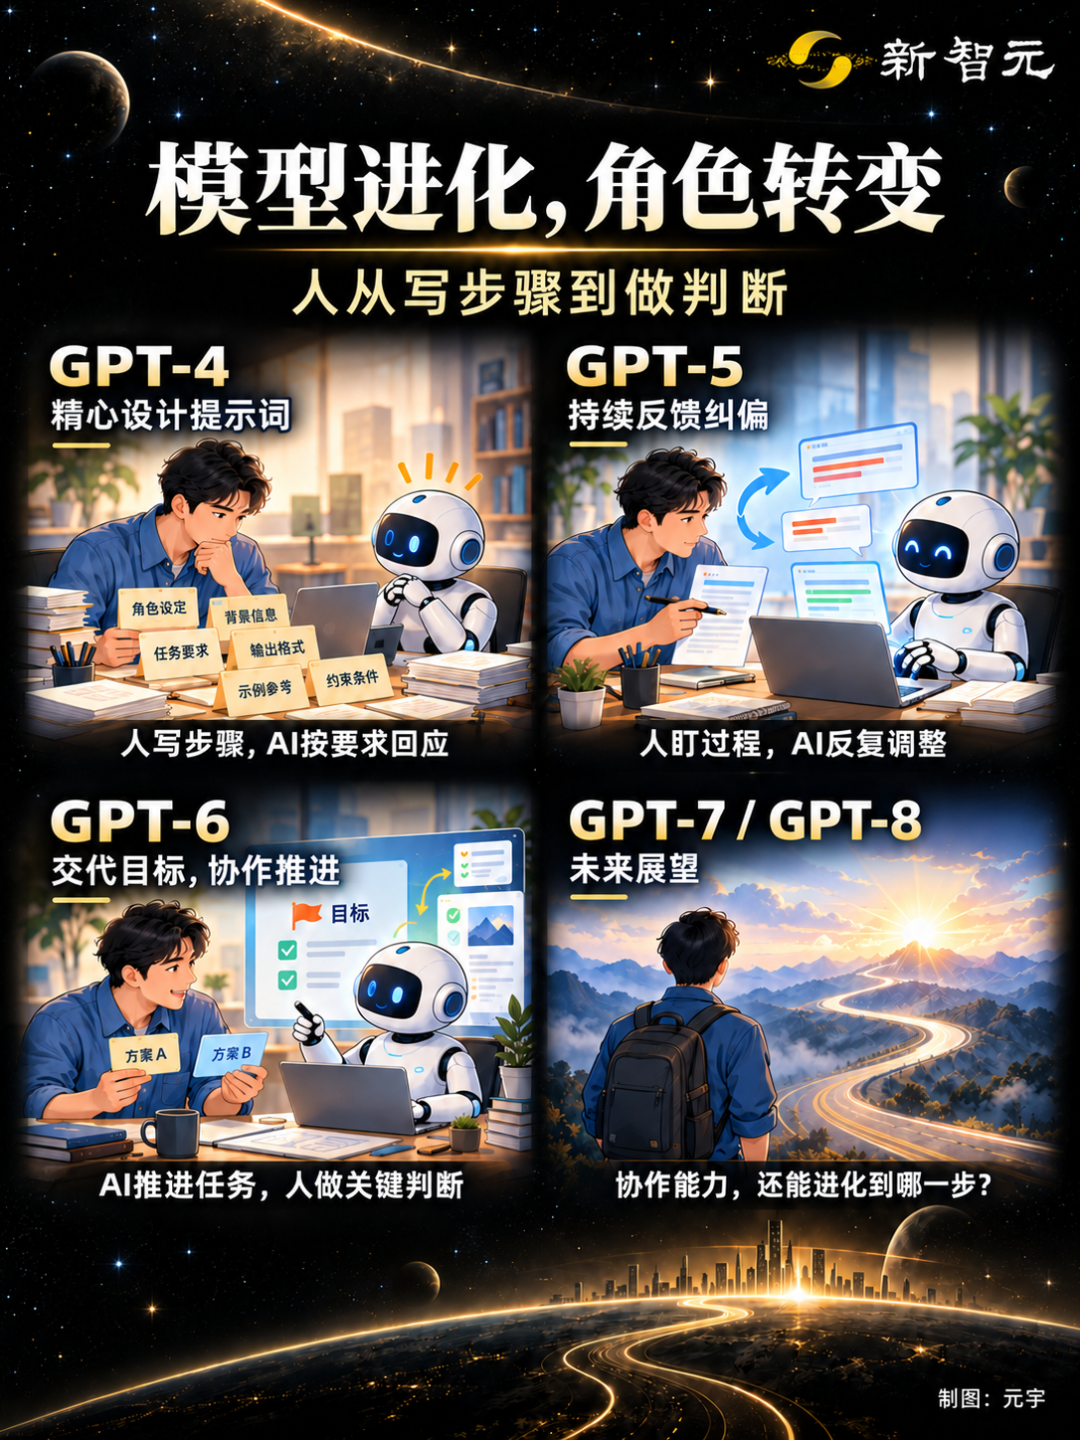
Пауэр также описал сдвиг в том, как люди взаимодействуют с последовательными поколениями моделей.
Исходная статья примерно резюмирует эту эволюцию так:
GPT-4:
люди тщательно проектируют шаги

GPT-5:
люди направляют процесс и продолжают вносить исправления

GPT-6:
люди всё чаще формулируют цель и контролируют ключевые решения
Это упрощение, а не гарантия для каждой задачи.
Однако собственная документация OpenAI по Astra описывает то же общее направление.
Astra может:
Это меняет роль человека.
Вместо ручного указания каждого шага пользователь всё чаще делает нечто ближе к следующему:
задать цель
→ определить ограничения
→ проверить значимые решения
→ оценить результат
Ключевой вопрос для GPT-7 и GPT-8 состоит в том, насколько далеко может зайти этот сдвиг.
Прогресс моделей часто представляют через результаты бенчмарков.
В повседневной работе другой показатель может быть важнее:
Какой объём контроля пользователь всё ещё должен обеспечивать?
После постановки цели модели:
Если GPT-7 или GPT-8 уменьшат эту нагрузку, это может оказаться ценнее небольшого улучшения в бенчмарке.
Именно поэтому исследования более крупных моделей и работа над меньшими моделями усиливают друг друга.
Передовая модель стремится открыть более способное поведение.
Более дешёвая модель стремится сделать достаточную часть этого поведения доступной в масштабе.
Заглавная цифра требует одной важной оговорки.
Заявление Пауэра «80–90%» было оценкой, высказанной в ходе публичной беседы.
Это не:
Программа Fellows Forum подтверждает, что Пауэр выступал как руководитель отдела прикладных исследований OpenAI на беседе 23 сентября под названием «Где модели встречаются с реальностью».
Независимые материалы о записи указывают, что замечание об 80–90% прозвучало примерно на отметке 1:32:52 полной записи мероприятия.
Поэтому наиболее безопасная интерпретация такова:
Пауэр считает, что подавляющее большинство исследовательского внимания OpenAI направлено на поколения моделей после GPT-6, поскольку именно там он ожидает наибольших фундаментальных улучшений.
Это не следует трактовать как буквальное бухгалтерское утверждение.
Пауэр сделал свои комментарии 23 сентября.
Шесть дней спустя, 29 сентября, OpenAI выпустила GPT-6.1 Sol.
Эта модель не является центральной для аргумента исходной статьи, поскольку обсуждение сосредоточено на логике «учитель → ученик» Astra → Sol/Luna, которую Пауэр описал на мероприятии.
Тем не менее это полезный контекст для читателей, публикующих статью сейчас.
OpenAI описывает GPT-6.1 Sol как последнее семейство моделей серии GPT-6 с возможностями, приближающимися к Astra в программировании, использовании компьютера и профессиональной работе, при значительно более низкой стандартной цене API.
Её существование усиливает тот же паттерн, обсуждаемый в интервью:
возможности передовых моделей растут
→ более дешёвые модели усваивают большую их часть
→ пользователи получают более сильную производительность при меньшей стоимости
Это также показывает, почему названия отдельных промежуточных релизов менее важны, чем более широкая исследовательская стратегия.
Борис Пауэр, руководитель отдела прикладных исследований OpenAI, оценил на Fellows Forum 2026, что примерно 80–90% исследований OpenAI сосредоточено на GPT-7, GPT-8 и последующих поколениях. Эта цифра была его публичной оценкой, а не проверенным отчётом о распределении ресурсов компании.
Нет. В комментариях Пауэра не были анонсированы публичная дата запуска или подробная продуктовая дорожная карта GPT-7 либо GPT-8. Он использовал эти названия для обозначения поколений после GPT-6, которые, по его мнению, получают большую часть долгосрочного исследовательского внимания.
Работа над текущим поколением делает сегодняшние продукты лучше и даёт исследователям более быструю обратную связь. Смысл комментария Пауэра в том, что некоторые исправления могут быть недолговечными, поскольку более способная модель следующего поколения может упростить исходную проблему или устранить её полностью.
Дистилляция моделей — это семейство методов, при которых более сильная модель-учитель помогает обучать меньшую модель-ученика. Распространённый рабочий процесс использует учителя для генерации высококачественных примеров, фильтрует эти примеры и обучает меньшую модель воспроизводить поведение, необходимое для целевой задачи.
OpenAI сообщает, что Sol и Luna были обучены методами, похожими на методы Astra, и наследуют достижения того же поколения, но компания не опубликовала достаточно деталей, чтобы называть Luna или Sol просто сжатыми копиями Astra. Точнее сказать, что они переносят связанные улучшения возможностей в более доступные ценовые уровни.
На момент запуска 22 сентября OpenAI установила цену GPT-6 Sol в $2 за миллион входных токенов и $10 за миллион выходных токенов, а GPT-6 Luna — в $0,10 за миллион входных токенов и $0,50 за миллион выходных токенов. OpenAI описывала обе модели как на 50% более дешёвые по сравнению с промоценами их аналогов GPT-5.6.
Используйте более сильную модель там, где задача требует сложного суждения, рассуждений при неоднозначности, обработки исключений или принятия важных решений. Меньшие модели часто лучше подходят для больших объёмов чётко определённой повторяющейся работы после того, как основное направление уже задано.
Тенденция движется от описания каждого шага к постановке целей, определению ограничений и проверке важных решений. В документации OpenAI для Astra прямо описаны асинхронные вопросы, продолжение работы в ожидании ответа и лучшее сохранение исходной цели при выполнении долгих задач.
Оценка Бориса Пауэра в 80–90% помогает лучше понять исследовательскую стратегию OpenAI. Компания может продолжать улучшать сегодняшние продукты GPT-6, направляя при этом большую часть долгосрочного исследовательского внимания на будущие поколения, где она ожидает более крупных приростов возможностей.
Вторая часть этой стратегии не менее важна. Более сильные передовые модели ценны не только как премиальные продукты: они также могут служить учителями и исследовательскими платформами, которые помогают переносить полезные способности в более быстрые и дешёвые системы, такие как Sol и Luna.
Для пользователей практический вопрос заключается не в том, какая модель крупнейшая. Важно распределять работу так, чтобы сложные суждения выполняла модель, способная с ними справиться, а рутинное исполнение поручалось самой дешёвой модели, которая может надёжно завершить задачу.
Долгосрочная ставка OpenAI выглядит простой: продолжать поднимать потолок возможностей, а затем делать всё большую часть этих возможностей достаточно доступной для ежедневного использования.
Начните с одной фразы и получите полноценный сайт за считанные минуты.



