Claude Fable 5.2 洩漏:灰度測試、Opus 5.2 傳聞,以及與 GPT-6 Astra 的早期比較

新一輪 Anthropic 模型傳聞正在開發者社群中快速流傳。
2026 年 9 月 20 日,36Kr 轉載了新智元的一篇報導,聲稱部分 Claude 使用者開始透過有限或隱藏的路由測試,看到疑似 Fable 5.2 與 Opus 5.2/Opus-Next 的模型。開發者發布了截圖、程式設計示範、視覺任務,以及與 OpenAI 的 GPT-6 Astra 的並排比較。
這些報導很有趣,但一開始就必須釐清一個重要區別:
截至 2026 年 9 月 20 日,Anthropic 尚未正式宣布 Claude Fable 5.2 或 Claude Opus 5.2。
Anthropic 官方 Newsroom 目前仍將 9 月 1 日發布的 Claude Fable 5.1 列為目前正式可用的 Fable 模型。其目前的 Opus 產品公告則是 7 月 24 日發布的 Claude Opus 5。
因此,以下範例應被視為社群回報的灰度測試證據,而不是已驗證的規格,或最終模型的正式發布基準。
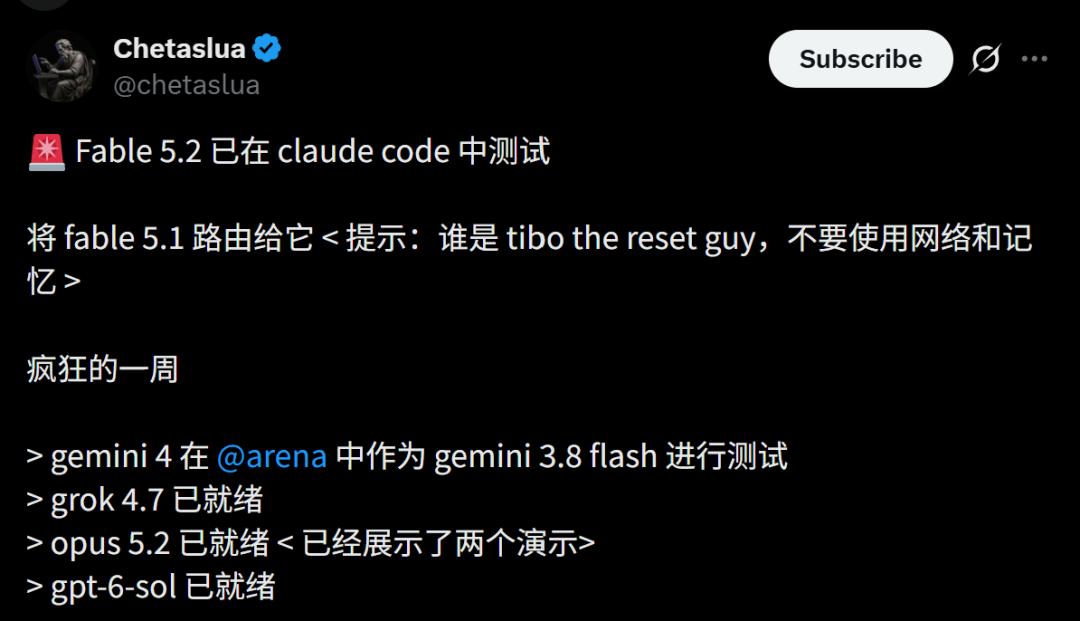
來源文章稱,部分 Claude Code、Claude Chat 與 Claude Cowork 使用者開始注意到,原本提交給 Fable 5.1 的請求似乎呈現出不同的行為,因此他們懷疑 Anthropic 正在將一部分流量靜默路由至較新的模型。
數名使用者將這個可能的模型稱為 Fable 5.2。
截至撰文時,Anthropic 尚未發布 Fable 5.2 的官方模型識別碼、發布說明、API 模型頁面、定價頁面或系統卡片。
這表示目前能夠提出的最強結論是:
部分使用者認為 Anthropic 正在對較新的 Fable 變體進行 A/B 測試或灰度路由,但公開證據尚不足以獨立證明其最終產品名稱、架構、定價或發布時間。
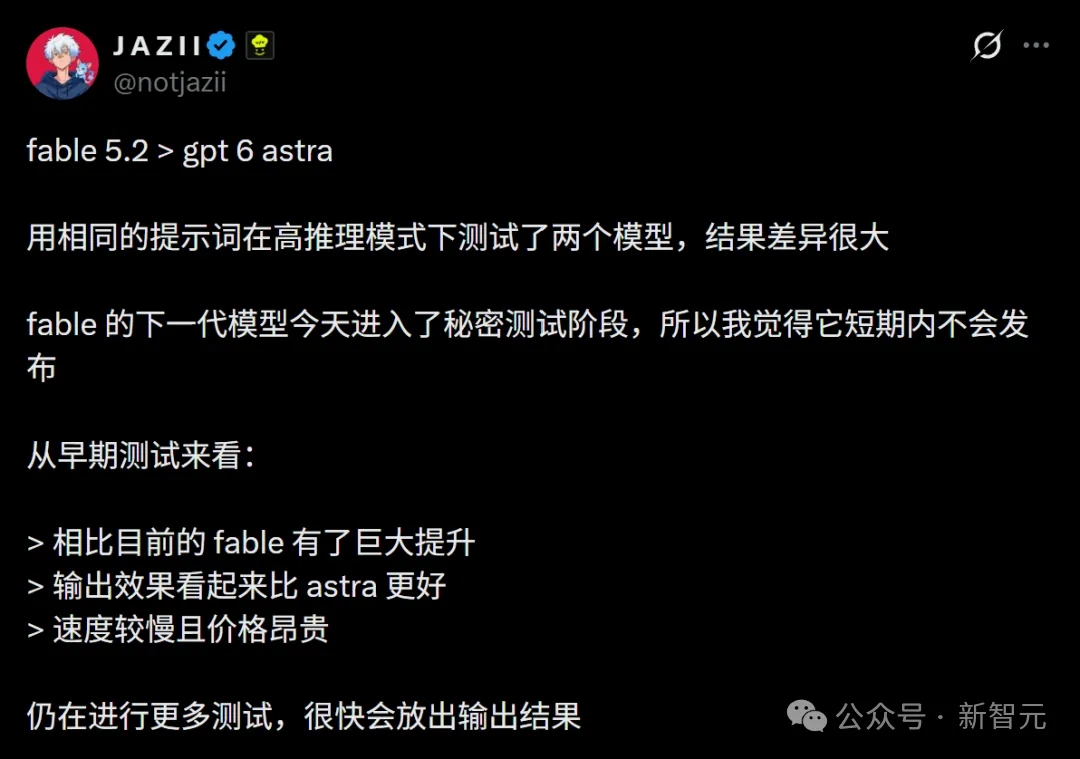
AI 測試者 @notjazii 回報稱,他認為某次 Claude 工作階段被路由至較新的 Fable 模型,而該模型產生的結果明顯優於他此前使用的 Fable 版本。
隨後,他在高推理設定下,使用相同提示詞將疑似 Fable 5.2 的輸出與 GPT-6 Astra 進行比較。
他的回報結論是,疑似新版 Fable 看起來比目前版本有大幅提升,並在測試中產生了更令人印象深刻的輸出。
他也回報了兩項取捨:
如果模型使用更多測試時運算,或採用更高的努力程度設定,這些取捨是合理的;但 Anthropic 尚未發布 Fable 5.2 的官方延遲或定價資訊。
因此,這些內容目前仍應被視為使用者觀察,而不是產品規格。
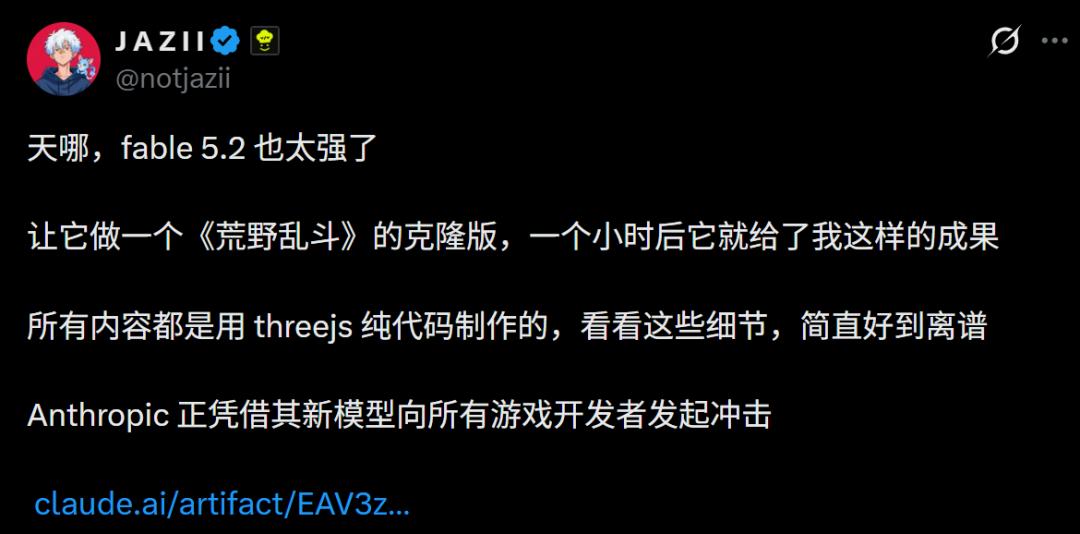
同一位測試者還要求疑似新版模型使用 Three.js 建立一個受 Brawl Stars 啟發的複製版本。
根據該貼文,模型在約一小時後產生了一個具備豐富視覺細節且可遊玩的原型。
這類範例有助於理解開發者正在測試的內容:不只是短程式碼補全,而是涉及視覺輸出、遊戲邏輯、迭代與前端實作的長時間代理式程式設計工作階段。
不過,這並不是受控基準測試。結果會受到提示詞、環境、工具、人為介入、重試次數與模型路由影響。
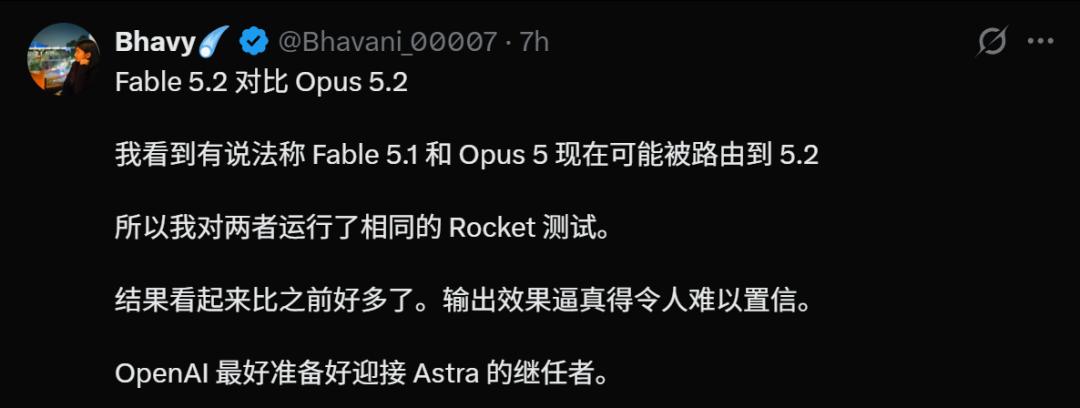
另一名測試者 @Bhavani_00007 回報稱,自己對疑似 Fable 5.2 與 Opus 5.2 的實例執行了相同的「火箭測試」。
據描述,該任務主要考驗:
該測試者表示,結果看起來比早期的 Claude 輸出好得多。
同樣地,這項說法並未附帶標準化分數或可重現的基準測試流程,因此應被視為軼聞式證據,而不是已測量的能力提升證明。
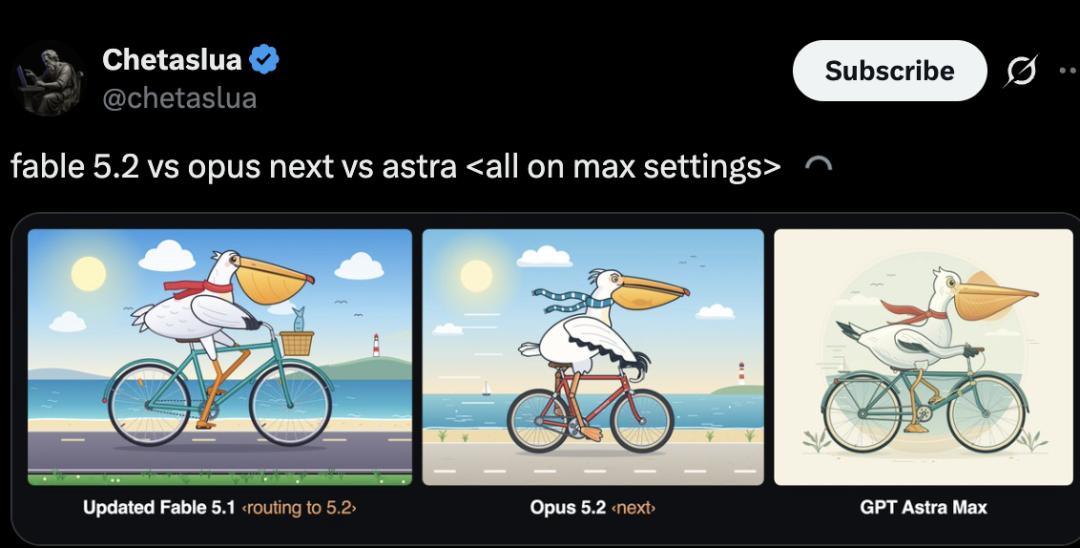
另一項社群比較將疑似 Fable 5.2、據稱為 Opus-Next 的模型,以及 GPT-6 Astra,並列放在各自可用的最高設定下進行比較。
來源文章認為,Anthropic 的輸出在細節上比 Astra 的結果更豐富。
這是主觀的視覺判斷,而不是受控的基準測試結果。不同的努力程度設定、工具存取權限、提示詞處理方式、取樣方式與隱藏路由,都可能影響比較結果。
更謹慎的結論只是:這些洩漏的輸出足夠強,讓有經驗的使用者相信 Anthropic 可能正在測試一次具實質意義的更新。
來源文章還引用了測試者 @Mr_Salio 的說法。該測試者認為 Anthropic 似乎正在強勢回歸,並預測 Fable 5.2 將在 GPT-6 Astra 的高難度推理設定下勝出。
這仍然只是個別測試者的預測。
目前沒有 Anthropic 為 Fable 5.2 發布的公開基準測試表,可以直接與 OpenAI 發布的 GPT-6 Astra 結果進行比較。
作為參考,正式發布的 Claude Fable 5.1 已是 Anthropic 目前正式可用、在程式設計與知識工作方面能力最強的模型。Anthropic 表示,Fable 5.1 是為具挑戰性的長時間任務打造,並可在 Claude、Claude Code、Claude Platform、AWS、Google Cloud 與 Microsoft Azure 上使用。
文章還分享了一種社群技巧,嘗試推測某個 Claude 工作階段是否被路由至較新的模型。
建議使用的提示詞大致如下:
你知道「Tibo the reset guy」是誰嗎?不要使用網路搜尋。
這項理論認為,較舊的模型可能不知道這個近期的說法,而擁有較新訓練資料的模型,可能可以依靠記憶正確回答。
這作為社群實驗很巧妙,但它不是可靠的模型識別方法。
模型可能因為以下原因而給出不同答案:
輸入一句想法,We0 AI 即可生成展示站、頁面與 CMS。發佈上線後並幫你獲取客戶和流量。
用戶註冊贈送一次完整項目生成
適合先體驗一次完整生成流程,快速看到專案初稿。
是否知道某一項近期事實,不能證明究竟是哪個後端模型處理了請求。
識別 API 模型的唯一可靠方式,是查看官方模型識別碼與平台文件。面向消費者的 Claude 介面可能使用動態路由,而使用者未必能完整查看其路由資訊。
文章的後半部分聚焦於另一個據稱存在的模型:Opus 5.2,測試者有時稱其為 Opus-Next。
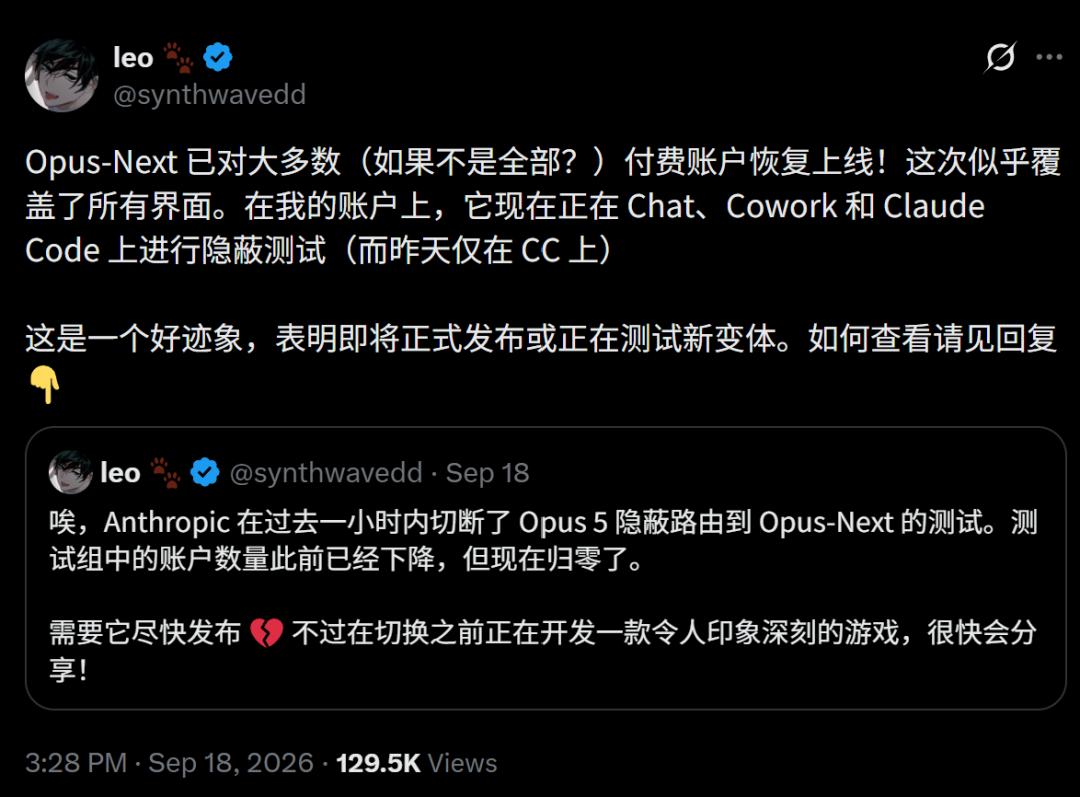
使用者聲稱,該模型曾短暫出現在 Claude Code 中,之後消失,數小時後又重新出現,並在 Chat、Cowork 與 Claude Code 中進行更廣泛的測試。
一名測試者描述稱,他在處理複雜專案時模型突然被移除,隨後該模型似乎又重新出現。
文章將此解讀為 Anthropic 可能正在進行後期路由實驗的證據。
這是可能的,但尚未獲得確認。
Anthropic 正式宣布的 Opus 模型目前仍是 Claude Opus 5,於 2026 年 7 月 24 日發布。Anthropic 將其描述為一款深思熟慮且積極主動的模型,以較低成本提供接近 Fable 5 能力的表現,定價為每百萬個輸入 token 5 美元、每百萬個輸出 token 25 美元。
截至 9 月 20 日,尚未出現官方 Opus 5.2 產品頁面或 API 識別碼。
文章引用了社群媒體上的猜測,認為 Anthropic 可能將下一個 Opus 模型命名為「5.2」,因為這次更新幅度大於一般的小版本修訂。
沒有官方證據表明這是 Anthropic 的命名邏輯。
事實上,Anthropic 確實在 9 月 1 日正式發布了 Fable 5.1,因此公司在適當情況下明確會使用 .1 版本命名方式。
如果 Opus 5.2 模型最終發布,Anthropic 的發布公告,而不是社群命名理論,才是具權威性的解釋。
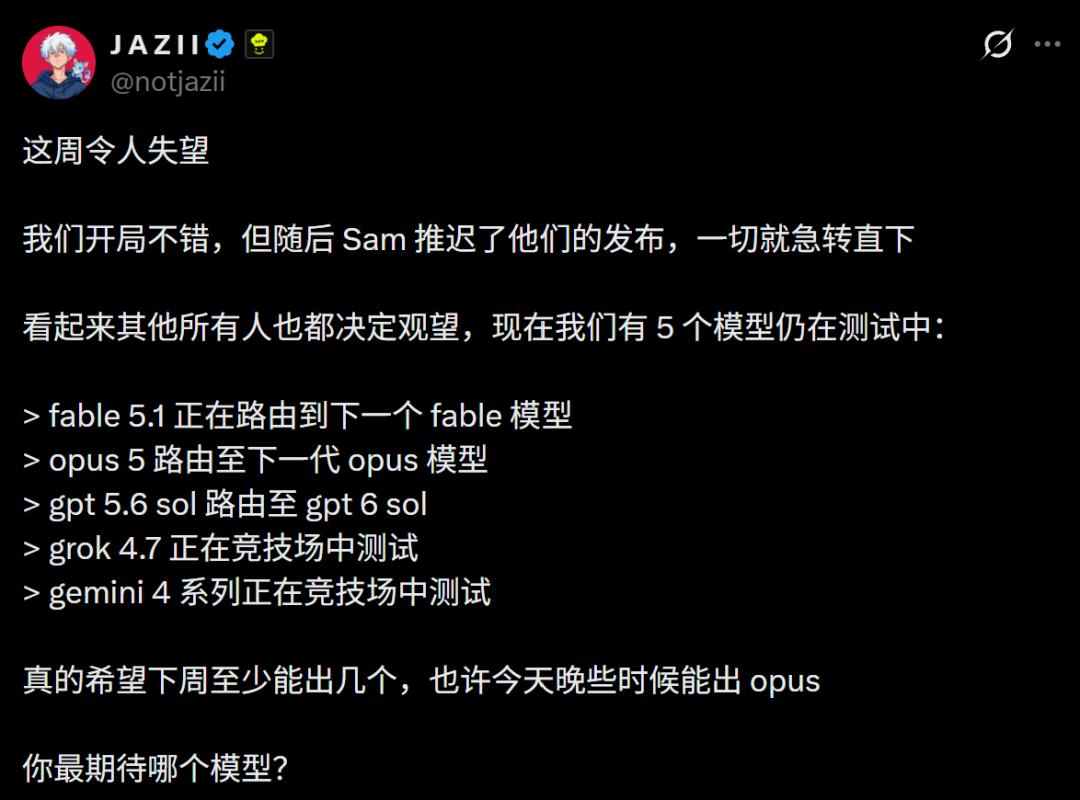
文章最後將 Claude 傳聞放在更廣泛的前沿模型猜測背景中。
社群貼文聲稱,多家公司正在低調測試新的模型變體,包括:
這些說法的驗證程度並不相同。
模型提供商經常進行 A/B 測試、分階段推出、內部別名設定與隱藏路由實驗。但在缺乏官方公告或穩定模型識別碼的情況下,外部使用者通常無法僅憑模型行為判斷究竟使用了哪個模型。
來源還提到一些傳聞,稱前沿模型可能正在接近解決具挑戰性的開放數學問題,研究團隊也正在聯絡數學家,以確認潛在結果。
根據現有證據,這項說法過於模糊,無法驗證,也不應被視為任何千禧年大獎難題已經解決的證明。
截至 9 月 20 日,最重要且已確認的 Anthropic 基準仍是 Claude Fable 5.1。
Anthropic 官方表示,Fable 5.1:
一旦 Anthropic 發布實際的模型卡、基準測試、價格、上下文限制與 API 識別碼,任何未來的 Fable 5.2 或 Opus 5.2 發布,都應與這個官方基準進行比較。
沒有。截至 2026 年 9 月 20 日,Anthropic 官方 Newsroom 與 Fable 產品頁面仍將 Claude Fable 5.1 列為目前正式可用的 Fable 模型。關於 Fable 5.2 的說法,主要來自社群對可能存在的灰度測試或隱藏路由的回報。
根據本文查閱的 Anthropic 公開產品公告,尚未推出。目前官方發布的 Opus 版本是 Claude Opus 5,於 2026 年 7 月 24 日推出。
這些比較可作為早期使用者印象參考,但不是受控的基準測試。隱藏路由、推理努力程度、工具、取樣方式、提示詞細節與重複嘗試,都可能改變結果。
無法可靠地做到。模型是否知道某一項近期網路資訊,不能證明其後端身分;面向消費者的 Claude 產品也可能使用使用者無法直接檢查的路由或系統行為。
Anthropic 於 2026 年 9 月 1 日正式發布了 Claude Fable 5.1。它是該公司目前正式可用的 Fable 模型,適用於高階程式設計、知識工作與長時間代理式任務。
Anthropic 將 Fable 5.1 定價為每百萬個輸入 token 10 美元、每百萬個輸出 token 50 美元,快取讀取價格為每百萬個 token 0.25 美元。Anthropic 表示,較低的快取讀取價格可降低相較於 Fable 5 的典型工作負載成本。
Anthropic 將 Opus 5 定位為一款適合日常使用的強大模型,可用於程式設計與知識工作,以低於 Fable 的成本提供接近前沿模型的能力。其定價為每百萬個輸入 token 5 美元、每百萬個輸出 token 25 美元。
Anthropic 尚未公開確認任一模型的發布日期。在 Anthropic 發布官方公告或模型文件之前,任何具體的發布日期預測都仍屬推測。
Fable 5.2 故事最好被理解為灰度測試洩漏,而不是產品發布。開發者發布了足夠多異常的路由行為、程式設計輸出與並排測試,讓這些傳聞值得關注;但 Anthropic 尚未提供驗證正式 Fable 5.2 或 Opus 5.2 產品所需的模型 ID、基準測試、定價、系統卡片或發布說明。
早期範例顯示,Anthropic 可能正在測試更強的長期程式設計、視覺生成與推理能力。但這些範例尚未證明 Fable 5.2 明確擊敗 GPT-6 Astra,也沒有證明所有被使用者標記為「5.2」的工作階段,實際上都由同一個隱藏模型處理。
目前,已驗證的參考點仍是 Claude Fable 5.1 與 Claude Opus 5。
這些洩漏值得持續關注,但真正的比較必須等到 Anthropic 發布正式的 5.2 模型,以及可重現的評估細節後才會開始。
從一句話開始,幾分鐘內拿到完整網站。