For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/embeddinggemma-2-740m-multimodal-embeddin-2078d39c.md.
Google 发布了 **EmbeddingGemma 2**,这是一款紧凑型多模态嵌入模型,旨在将语义搜索直接带到手机、笔记本电脑、浏览器和其他边缘设备上。

Google 发布了 EmbeddingGemma 2,这是一款紧凑型多模态嵌入模型,旨在将语义搜索直接带到手机、笔记本电脑、浏览器和其他边缘设备上。
该模型于 2026 年 10 月 6 日公布。对于其所能完成的任务而言,它的核心规格异常精简:
总参数量:7.4亿
统一嵌入空间:768维
上下文窗口:8K
支持100多种语言
Pixel 11 Pro 上纯文本权重的活跃内存约为191MB
Pixel 11 Pro 上完整多模态模型的活跃内存约为567MB
EmbeddingGemma 2 可以将文本、代码、图像、视频、音频,以及这些模态的混合内容编码到同一个共享向量空间中。
这意味着,自然语言查询可以直接检索照片、音频片段或视频中的某个时刻,而不必先将每个文件转换成文本。
Google CEO 桑达尔·皮查伊称其为 Google 首款开放的原生多模态嵌入模型。
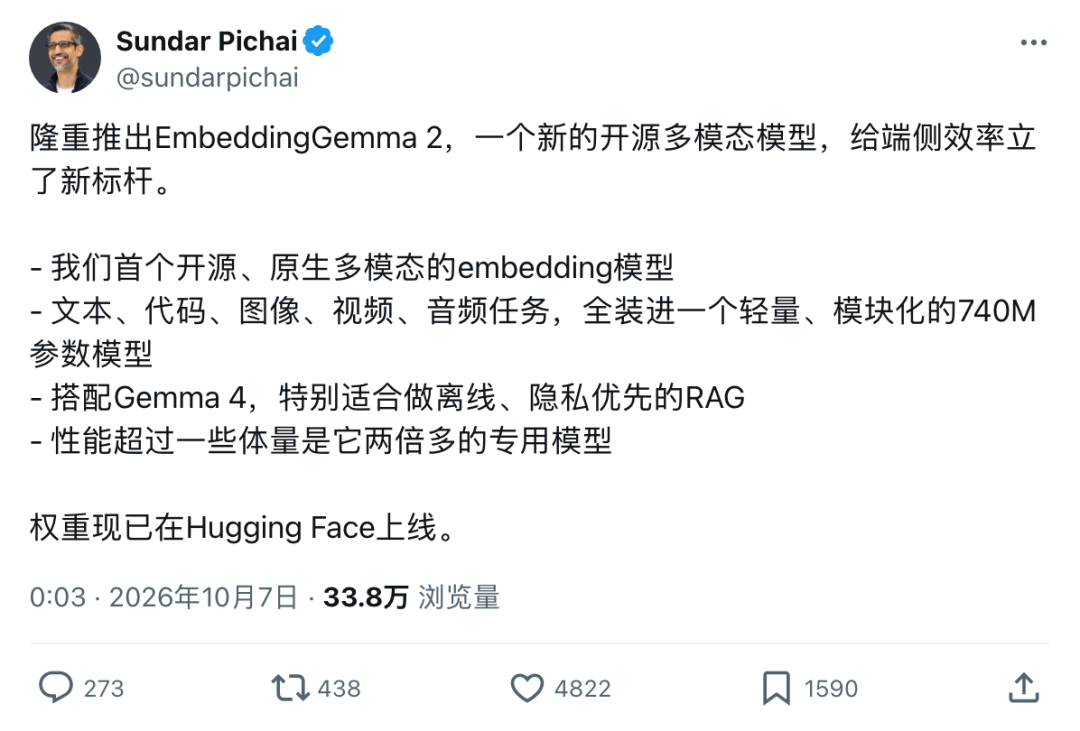
实际区别很简单:过去依赖云端 API,或需要分别使用图像、音频和文本模型的搜索,现在可以通过一个紧凑型模型在本地运行。
嵌入模型通常不会直接被终端用户看到,但它们处于许多现代搜索系统和 RAG 系统的底层。
它们的作用是将内容转换为数值向量:
内容
→ 嵌入向量
→ 语义空间中的位置
含义相近的内容会被放置在更接近的位置。随后,搜索系统将用户查询转换成另一个向量,并检索距离最近的匹配结果。
第一代 EmbeddingGemma 主要面向文本。EmbeddingGemma 2 则将这一理念扩展到了统一的多模态空间。
Google 的模型卡显示,新模型会将文本、图像、视频和音频映射到同一个 768维嵌入空间中。
因此,一张猫的照片、“猫”这个词,以及一段猫叫录音,即使原始格式完全不同,也可以在语义上相互关联。
这使以下搜索成为可能:
文本查询 → 匹配图像
文本查询 → 匹配音频
文本查询 → 匹配视频片段
音频查询 → 匹配视频
图像查询 → 相关图像或媒体
一条内容还可以同时包含多种模态。
Google 举了一个越野跑鞋产品页面的例子:页面包含文字描述、产品照片,以及一段展示鞋底在湿滑岩石上抓地力的视频。EmbeddingGemma 2 可以用一个嵌入表示这组组合内容,并将其与“适合越野跑的防水鞋”这类查询进行匹配。
模型发布后不久,Hugging Face 工程师 Victor M 展示了该模型直接在浏览器中运行的效果。
据原文介绍,他输入了:
birds singing
结果网格随即重新排序。排名靠前的结果同时包括鸟类照片,以及展示鸟鸣波形的音频片段。
据报道,该查询耗时约 22毫秒。整个过程没有调用服务端模型,也不需要外部 API。
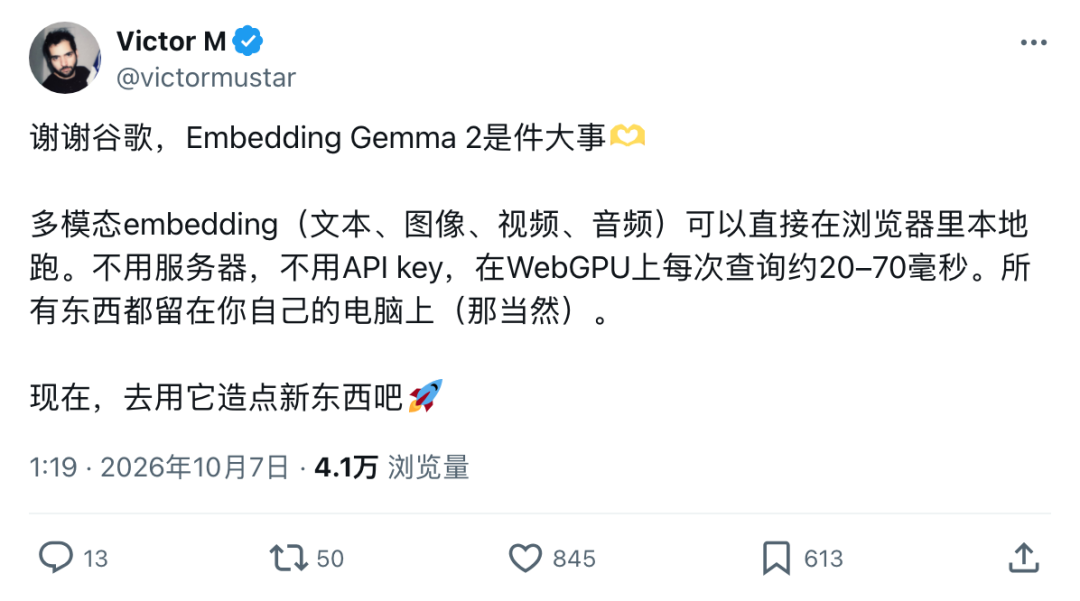
这一数据来自开发者报告的浏览器测试,并不是 Google 官方保证的延迟指标。
不过,更广泛的结论得到了 Google 自身部署指南的支持:EmbeddingGemma 2 面向本地运行,可通过 LiteRT、MediaPipe、WebGPU、transformers.js、MLX、llama.cpp、Ollama 以及其他适合边缘设备的运行时进行部署。
EmbeddingGemma 2 使用 8,192 个 token 的上下文窗口,是上一代 EmbeddingGemma 的四倍。
Google 表示,单模态输入大约可以包含:
5.5分钟音频
29张图像
58帧视频
也可以包含这些模态交错组合的内容。
该模型还支持 100 多种语言。
这为本地搜索系统提供了更大的灵活性。应用不必只索引较短的文本片段,也可以表示包含更长段落、图像、视频帧或音频片段的丰富内容。
Google 将 EmbeddingGemma 2 与多个规模相近的嵌入系统进行了比较。
原文重点强调了视觉检索方面最明显的差异。
Google 的模型卡报告了以下结果:
| 基准测试 | EmbeddingGemma 2 |
|---|---|
| MTEB Multilingual v2 | 61.36 |
| MTEB Code v1 | 78.68 |
| MIEB Lite | 64.64 |
| MMEB v2 Image | 57.28 |
| MMEB v2 Visual Document | 67.84 |
| MMEB v2 Video | 50.67 |
| MSEB Retrieval | 69.54 |
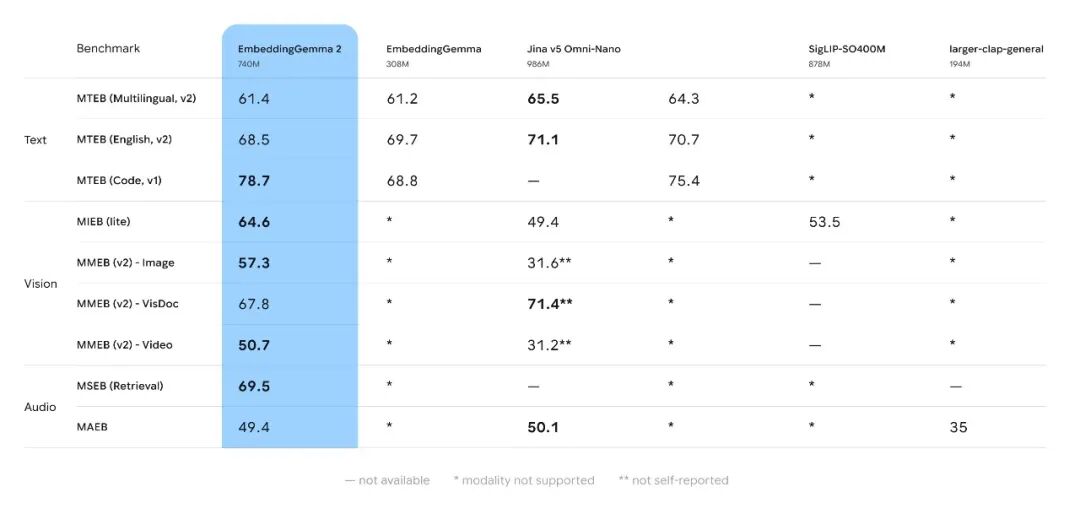
原文重点介绍了与 Jina v5 Omni-Nano 的对比:
MMEB v2 Image
EmbeddingGemma 2:57.3
Jina v5 Omni-Nano:31.6

MMEB v2 Video
EmbeddingGemma 2:50.7
Jina v5 Omni-Nano:31.2
这些数据来自 Google 发布的评测表。
和往常一样,基准测试结果应结合具体评测设置进行解读,而不能视为适用于所有生产搜索工作负载的普遍排名。
7.4亿参数总量被拆分成多个模块。
Google 的模型卡列出了以下组成:
文本:
总参数量:2.7亿
  主干网络:1.3亿
  嵌入器:1.4亿

视觉编码器:
1.7亿参数

音频编码器:
3亿参数
开发者不必加载全部三个组件。
| 启用的模态 | 有效参数规模 |
|---|---|
| 仅文本 | 2.7亿 |
| 文本 + 图像 | 4.4亿 |
| 文本 + 音频 | 5.7亿 |
| 完整多模态 | 7.4亿 |
这种模块化对于边缘设备很重要。如果应用只搜索文本和代码,就没有必要让音频或视觉编码器持续占用内存。
Google 报告称,在 Pixel 11 Pro 上进行量化后,该模型大约可以使用:
仅文本活跃内存:
约191MB

完整多模态活跃内存:
约567MB
这也是原文“低于600MB”这一标题的依据。
该模型采用量化感知训练,并支持 INT4 和 INT8 部署选项。
这一点很重要,因为传统多模态搜索流程通常需要多个独立组件:
图像编码器
+
语音识别或音频编码器
+
文本嵌入模型
+
额外预处理
EmbeddingGemma 2 将其中相当一部分整合进了统一架构。
原生输出维度为 768。
EmbeddingGemma 2 还支持 Matryoshka 表征学习,允许将向量截断为:
512维
256维
128维
Google 表示,与完整的 768 维表示相比,这可以将本地向量数据库的存储空间最多减少 6倍。
Google AI Edge 的部署博客则介绍称,在特定的本地索引和存储配置下,根据表示方式和存储流程的不同,存储空间最多可以减少 8倍。
模型卡还补充了一个重要的实现细节:截断后的向量应在余弦相似度搜索前重新归一化。
如果查询向量和文档向量使用不同维度,也不能直接进行比较。
Google 围绕该模型发布了多个参考应用。
Google AI Edge Gallery 的 即时媒体搜索允许用户使用自然语言或示例图像搜索本地照片和视频。
该应用会:
嵌入计算不需要互联网连接。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
视频片段查找器允许用户在本地视频文件中搜索特定时刻。
Google 给出的示例查询包括:
孩子们在笑
狗接住飞盘
有人吹灭生日蜡烛
该应用会索引视觉和音频片段,并返回匹配的时间戳。
Google 还为 Mac 发布了 AI Edge Foresight。
Foresight 将 EmbeddingGemma 2 与 Gemma 4 结合,用于本地检索和上下文推理。
Google 表示,它可以索引会议记录、搜索私有文件、检索图像/文档/笔记,在离线状态下运行,并将敏感的源材料保留在设备上。
这与原文描述的本地 RAG 架构接近:
EmbeddingGemma 2
→ 检索相关的本地上下文

Gemma 4
→ 基于检索到的上下文进行推理
原文还汇总了几项早期开发者实验。
这些案例很有参考价值,但应被视为社区报告的结果,而不是 Google 官方基准测试。
Mac 应用 Nativ 报告了使用 Apple M5 Max 和 8 位量化模型进行的测试结果。
其公布的数据包括:
与 FP32 的余弦相似度:
0.9997

批量大小为32时的文本嵌入吞吐量:
817项/秒
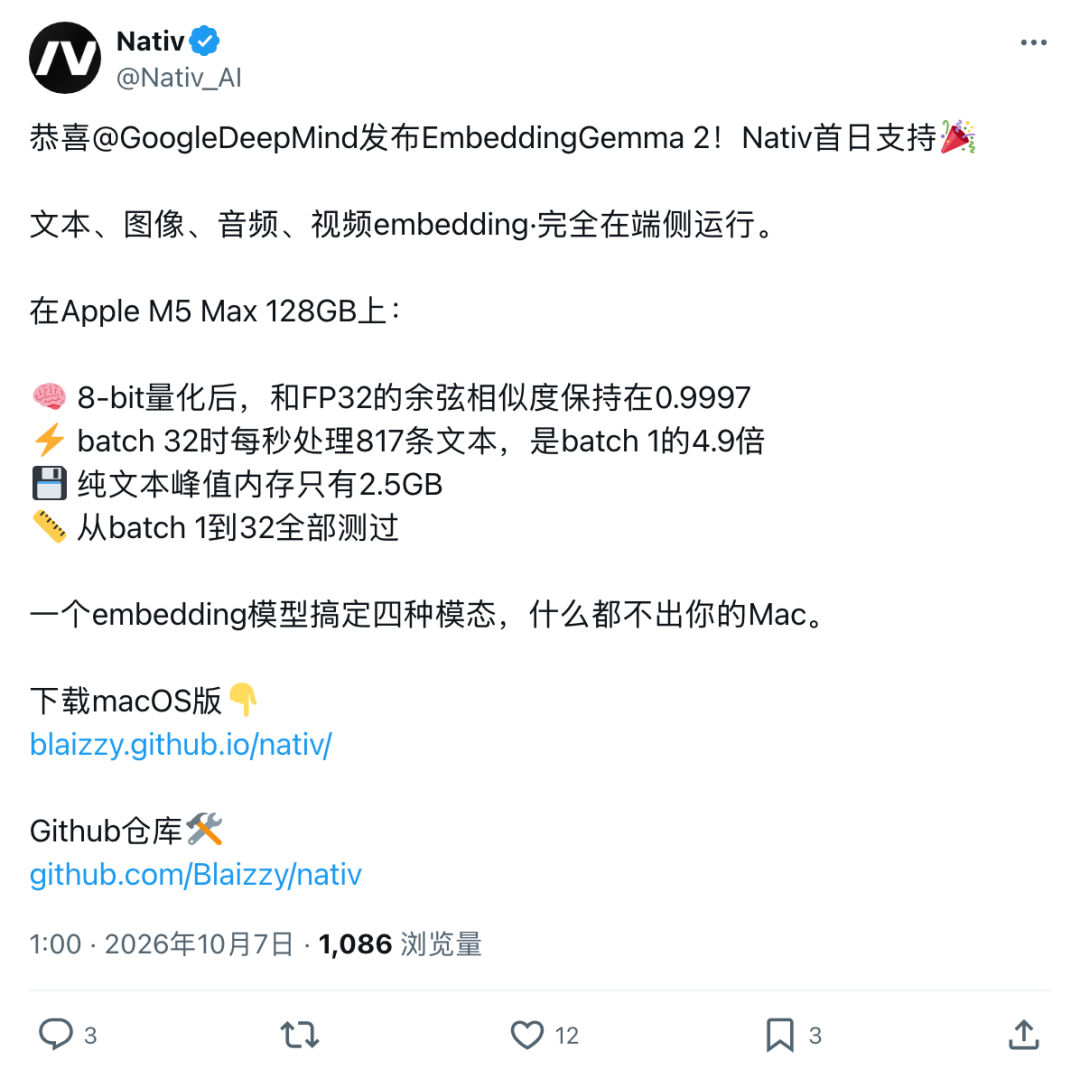
这些数据取决于具体实现、量化方式、硬件和批量大小。
原文提到的一名土耳其开发者围绕个人笔记构建了一个小型测试。
这些笔记大多使用英文书写,而查询使用土耳其语。
在他报告的测试中:
关键词匹配命中率:
15%

EmbeddingGemma 2 命中率:
97%
测试检查的是正确笔记是否出现在前 18 个候选结果中。
他还测试了包含大量拼写错误的真实消息,并报告称,与关键词搜索相比,语义模型找到的相关笔记数量大约是前者的两倍。据报道,每次查询在本地耗时约 50 毫秒。
这不是标准化基准测试,但它说明了嵌入搜索有用的主要原因之一:即使查询和存储文本使用了不同的词语或语言,语义相似度仍然可以发挥作用。
开发者 Nick Lo 还展示了一个通过 llama.cpp 运行的量化版 EmbeddingGemma 2,该版本运行在一块 Nano 开发板上。
他报告称,在一个小型本地图像搜索系统中,将文本查询转换为嵌入大约需要:
约15毫秒
找到匹配图像后,一块 ESP32-S3 会逐行绘制该图像。

同样,这是一项开发者实验,而不是官方参考延迟。
该模型并不只面向媒体内容。
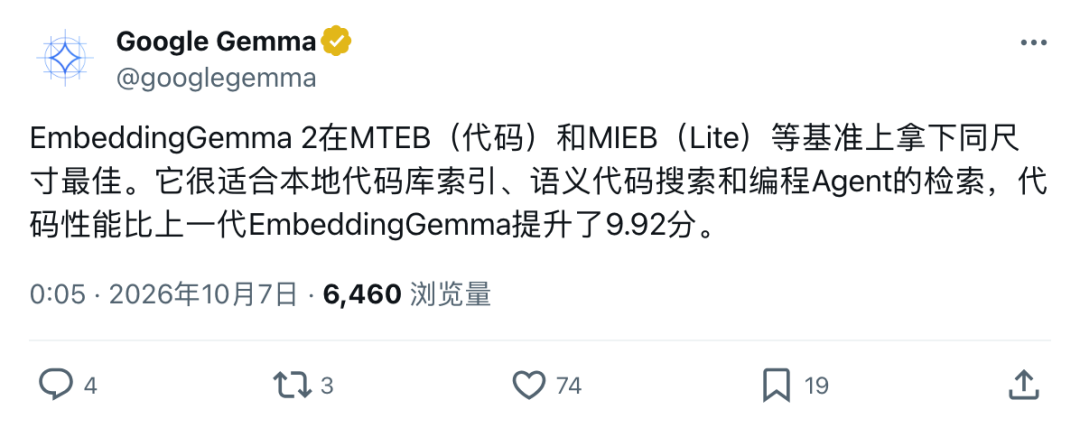
它在代码检索方面相比上一代 EmbeddingGemma 有了明显提升。
Google 报告称:
MTEB Code v1

EmbeddingGemma:
68.76

EmbeddingGemma 2:
78.68
这意味着提升了 9.92分。
Google Gemma 特别强调了本地代码库索引、语义代码搜索和编程智能体检索等目标应用场景。
编程工具需要先找到代码仓库中相关的部分,之后才能对其进行编辑。
紧凑型本地嵌入模型为开发者提供了另一种架构:
源代码仓库
→ 在本地构建嵌入
→ 在本地存储索引
→ 自然语言查询
→ 检索相关代码
→ 仅将选定上下文发送给更大的编程模型
索引和第一阶段检索可以保留在开发者自己的设备上。
Google 早在 2026 年就已经推出了 Gemini Embedding 2 云端 API。
EmbeddingGemma 2 采用了不同的路径。
它不是要求通过托管 API 生成多模态嵌入,而是一个可以在本地运行的开放权重模型。
| 方案 | 主要优势 |
|---|---|
| 云端嵌入 API | 托管基础设施与便捷扩展 |
| 设备端 EmbeddingGemma 2 | 隐私、离线运行和较低的本地延迟 |
对于个人媒体、私有文件、企业笔记和本地代码仓库而言,第二种方案具有吸引力,因为原始源材料不一定需要离开设备。
Google 明确将其定位为隐私优先的设计。
但这并不意味着每个应用会自动具备隐私性。应用的其他部分仍然需要正确设计,包括安全的本地存储、访问控制,以及对检索内容的谨慎处理。
EmbeddingGemma 2 是 Google 基于 Gemma 4 技术构建的开放权重多模态嵌入模型。它会将文本、代码、图像、视频、音频和混合输入映射到共享的 768 维向量空间,用于搜索、RAG、相似度计算、分类和聚类。
完整模型包含 7.4亿个参数。文本组件使用 2.7亿个参数,额外的视觉和音频编码器分别增加 1.7亿和 3亿个参数。
可以。Google 将其设计为设备端模型,并为手机、笔记本电脑、浏览器和边缘硬件提供部署路径。Google 自己的 AI Edge 演示可以在不调用云端嵌入服务的情况下执行本地搜索。
Google 报告称,在 Pixel 11 Pro 上,量化后的纯文本权重需要约 191MB 活跃内存,完整多模态模型需要约 567MB。实际内存占用会因运行时、硬件、精度和启用的编码器不同而变化。
支持。所有受支持的模态都会被映射到同一个向量空间中,因此文本可以检索图像、音频或视频片段,媒体内容之间也可以相互比较。
Google 根据商业许可较为宽松的 Apache 2.0 许可证发布模型权重,并将其描述为开放模型。不过,用户仍需遵守 Gemma 禁止使用政策和适用条款。
可以。Google 报告称,其 MTEB Code 得分为 78.68,高于上一代 EmbeddingGemma 的 68.76,并明确将本地代码仓库索引和编程智能体检索列为目标应用场景。
EmbeddingGemma 2 是嵌入模型,用于将内容转换为向量,以便进行检索和相似度计算。Gemma 4 是生成式模型,可以对检索到的信息进行推理,因此 Google 展示了将二者结合用于完全本地化 RAG 工作流的方式。
EmbeddingGemma 2 将多模态语义搜索从云端带到了普通消费级硬件能够承载的范围内。一个 7.4亿参数的模型,就可以将文本、代码、图像、视频和音频嵌入同一个向量空间;在 Google 针对 Pixel 11 Pro 的完整多模态配置中,活跃内存约为 567MB。
它最突出的实际优势在于架构简单:一个紧凑型模型就可以支持本地媒体搜索、视频片段检索、私有 RAG、跨语言笔记搜索和代码仓库索引,而不要求每个原始文件都上传到服务器。
Google 的官方演示、模型卡和部署工具链支持其设备端运行能力。原文中的浏览器、Nativ、土耳其语笔记和 Nano 开发板数据,是有参考价值的早期开发者实验,但应被视为与具体实现相关的结果,而不是保证性能。
EmbeddingGemma 2 让本地多模态检索变得足够现实:照片、录音、视频、文档和代码,越来越可以在它们原本所在的位置——用户自己的设备上——被搜索。
从一句话开始,几分钟内拿到完整网站。



