For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/grok-45-coding-benchmarks-token-efficiency.md.
Grok 4.5 是一款面向编码、智能体与知识工作的前沿模型。其实用优势主要体现为:工程性能竞争力强劲、每秒处理可达80个token、50万上下文窗口、以及在已发布的SWE-Bench Pro对比测试中更低的token消耗。 训练方法融合了大规模基础设施、精选数据、Cursor交...
Grok 4.5让xAI重返编程模型竞赛的前列。
该模型于2026年7月8日发布,专为软件工程、智能体任务和更广泛的知识工作而设计。它使用Cursor进行训练,现可通过xAI API、Grok Build和Cursor使用。其亮点不仅在于模型质量,Grok 4.5还围绕更快的服务速度、更少的生成令牌数以及更低的单次任务完成成本展开。
官方模型文档显示其具备500,000个令牌的上下文窗口、文本和图像输入、可配置推理、函数调用、结构化输出支持,以及API定价为每百万输入令牌2美元和每百万输出令牌6美元。
本文将解读Grok 4.5在哪些方面表现优异、其效率声明应如何理解、训练过程中有哪些变化,以及配套推理栈为何可能与模型本身同等重要。

Grok 4.5是xAI面向编程、智能体工作和通用计算机知识任务的旗舰模型。官方发布材料将其描述为能够处理长时间运行任务、使用工具、从错误中恢复并验证结果(而非单次响应后即停止)的模型。
这使其与用于自主编程、仓库级代码变更、技术研究、数据分析和多步骤办公工作流的高端模型处于同一类别。
| 项目 | Grok 4.5 |
|---|---|
| 模型名称 | grok-4.5 |
| 主要用例 | 编程、智能体任务、知识工作 |
| 输入模态 | 文本和图像 |
| 输出模态 | 文本 |
| 上下文窗口 | 500,000个令牌 |
| 推理 | 可配置 |
| 函数调用 | 支持 |
| 结构化输出 | 支持 |
| 输入价格 | 每百万令牌2美元 |
| 缓存输入价格 | 每百万令牌0.50美元 |
| 输出价格 | 每百万令牌6美元 |
| 报告服务速度 | 每秒最多80个令牌 |
| 可用性 | xAI API、Grok Build、Cursor |
50万个令牌的上下文窗口足以容纳庞大的代码库、长篇技术文档、多文件调查以及扩展的智能体历史记录。大上下文窗口并不能自动保证更好的结果,但它为工具提供了更多空间来提供相关源材料,而无需进行激进截断。
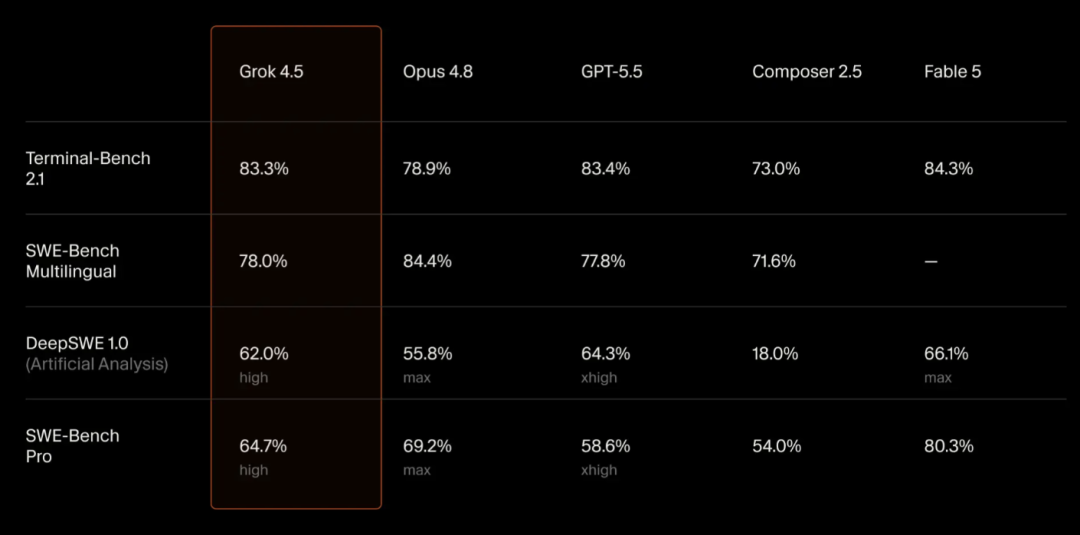
xAI官方公告发布了多项软件工程评估的结果。Grok 4.5并非在所有基准测试中都位列第一,但与其他前沿系统相比仍具竞争力。
| 基准测试 | Grok 4.5 | 部分对比结果 |
|---|---|---|
| DeepSWE 1.0 | 62.0% | Fable最高66.1%;GPT-5.5 xhigh 64.31%;Opus 4.8最高55.75% |
| DeepSWE 1.1 | 53.0% | Fable最高70%;GPT-5.5 xhigh 67% |
Opus 4.8 max 59% |
| Terminal-Bench 2.1 | 83.3% | Fable max 84.3%; GPT-5.5 xhigh 83.4%; Opus 4.8 max 78.9% |
| SWE-Bench Pro | 64.7% | Fable max 80.4%; Opus 4.8 max 69.2%; Opus 4.7 max 64.3% |
| SWE Marathon | 29.0% | Opus 4.8 max 26.0%; Fable max 24.0%; Opus 4.7 max 16.0% |
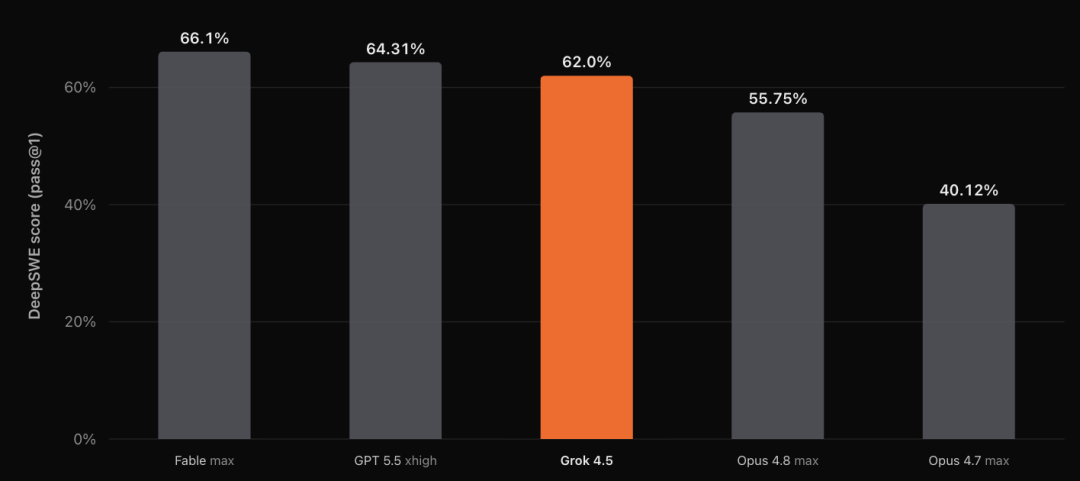
这些数字表明,该模型在终端工作、实际工程任务以及较长的智能体工作流方面表现尤为突出。不过,仍需谨慎解读这些结果,因为基准测试框架、推理设置、工具访问权限以及服务商特定配置都会影响最终表现。
Cursor 还透露,旧版本的 Cursor 代码库快照意外出现在了训练数据中,这可能会影响 CursorBench 的结果。该公司已将该基准测试从其公开对比中排除,并表示这些数据不会用于未来的模型训练。
关于 Grok 4.5,最实用的卖点在于其效率。
xAI 表示,该模型的服务速度高达 每秒80个令牌 。这一速度足以让长推理链、仓库编辑和迭代式智能体循环的响应比慢速的高级模型更迅速。
该公司还报告称,在 SWE-Bench Pro 的每项任务中,Grok 4.5 平均消耗 15,954个输出令牌,而 Opus 4.8 在最大设置下平均消耗 67,020个输出令牌。这意味着,在测量的工作负载中,输出令牌量大约减少了 4.2倍。
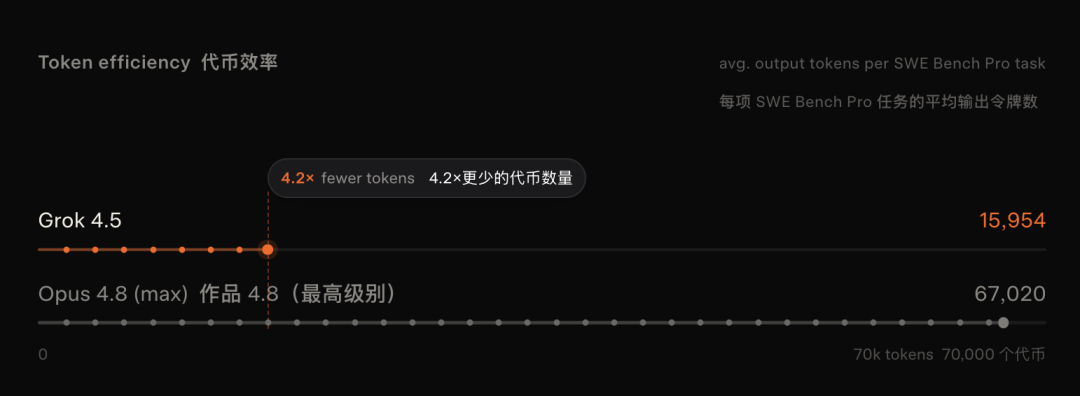
令牌效率之所以重要,原因有三:
关键指标并不仅仅是每百万令牌的价格。团队应该比较在可接受质量水平下完成相同任务的总成本。一个标价更高的模型,如果需要的尝试次数、工具调用或…
生成的令牌。
基础 API 价格如下:
| 令牌类型 | 价格 |
|---|---|
| 输入 | 每100万令牌2美元 |
| 缓存输入 | 每100万令牌0.50美元 |
| 输出 | 每100万令牌6美元 |
Cursor 在其自身模型产品中还提供了一种更快的变体,价格为每100万输入令牌4美元和每100万输出令牌18美元。不同平台的定价和可用性可能有所不同,因此生产团队应在其实际使用的环境中确认费率。
Grok 4.5 的定位不仅仅是完成一个函数或解释一个错误。官方示例包括:
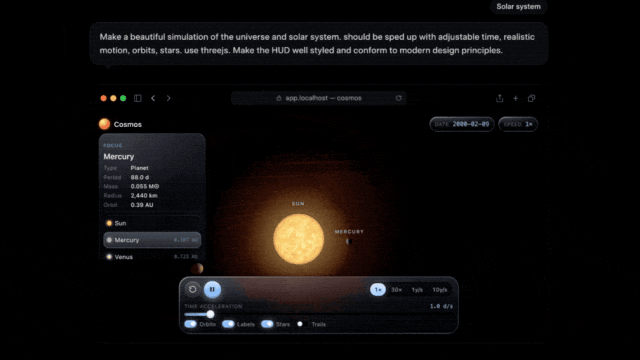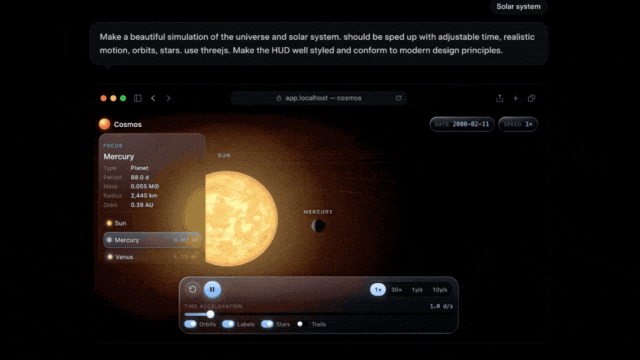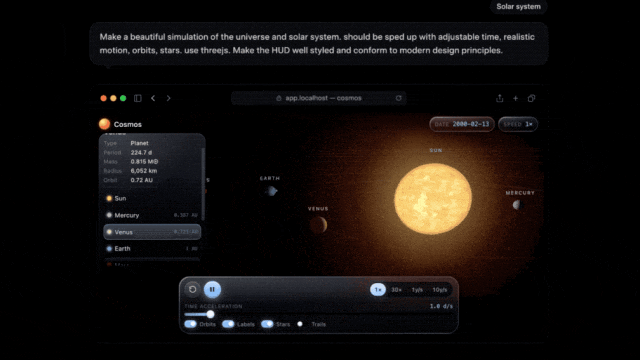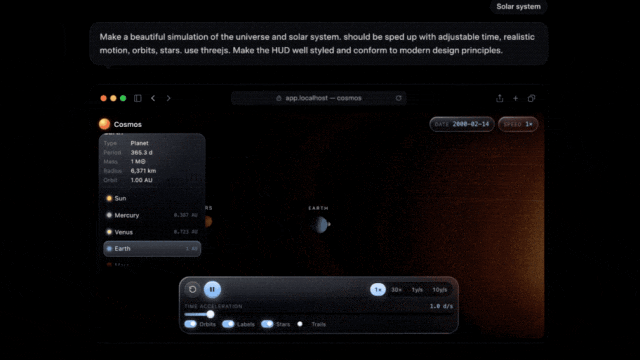
太阳系演示很有用,因为它结合了设计、前端代码、3D 渲染、控件和交互逻辑。这并不能证明每个单提示应用程序都能直接用于生产,但它展示了该模型正在被优化以处理的那种集成任务。
Grok 4.5 还延伸到了办公工作。在发布材料中,它创建了结构化的业务审查幻灯片,并处理涉及公式、网络研究和多工作表的电子表格。

对于开发团队来说,一个实用的工作流程可能如下所示:
一个模型可能既快速又强大,但仍然会产生错误的假设、不安全的更改或不完整的验证。使用代理编码模型的最佳方式通常是带有可见证据的结构化自动化,而不是不受限制的自主性。
效率提升并非仅仅表现为简单的服务优化。xAI 和 Cursor 都描述了在模型架构、数据准备、强化学习和分布式训练方面的改变。
Cursor 将 Grok 4.5 描述为一种混合专家模型。在 MoE 系统中,仅会为特定token或任务激活网络的一部分。这种方法可以在不要求每个参数都参与每次推理步骤的情况下,提升模型的总容量。
官方来源并未公布足够的实现细节来精确计算每个token所需的计算量。因此,与其依据未经证实的参数数量推断性能,不如更准确地聚焦于可观测行为——速度、基准测试质量和 token 消耗。
xAI 表示,Grok 4.5 是在数万块英伟达 GB300 GPU 上训练的。如此规模的训练不仅需要原始硬件支持。长时间运行需要稳定的分布式系统、检查点恢复、网络通信、数据管道以及能够保持数千个加速器高效运转的监控机制。
公告特别强调了为大规模训练任务设计的稳定性技术。这之所以重要,是因为在长期实验中出现故障时,如果系统无法高效恢复,可能会浪费大量计算资源。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
训练流程包括:
其目标是提升有用训练信号的密度,而非仅仅依赖原始 token 量。重复、低质量或相关性弱的数据可能增加训练成本,却无法带来与精心挑选样本相同的改进效果。
Cursor 表示,该模型使用了数万亿个 Cursor 数据 token 进行训练。据该公司称,数据集捕捉了用户、代码库、软件工具和代理之间的交互。
这一区别至关重要。纯代码数据集教导的是语法、模式、库和常见实现方法。而交互数据还能教导工作流程的顺序:
这有助于解释为何 Grok 4.5 定位在软件工程领域,而非孤立的代码补全。
xAI 表示,其强化学习项目涵盖了数十万个任务,重点是多步骤软件工程及其他技术工作。
Cursor 描述了训练模型的多种环境:
两家公司还构建了分布式代理系统,以大规模生成、测试和优化这些训练环境。部分代理任务可能运行数小时,而更大的训练过程则异步继续进行。
这是与狭隘基准优化相比的一个重大转变。模型不仅被训练用于产生正确的最终答案,还要学会导航达成目标的整个过程。
对某人而言。
模型权重只是最终产品的一部分。
埃隆·马斯克在一份公开声明中表示,Grok 4.5 尚未使用 xAI 内部开发的、专门映射到 GB300 硬件的 C/C++ 推理软件。他暗示,优化后的技术栈可能使服务速度翻倍或进一步提升。
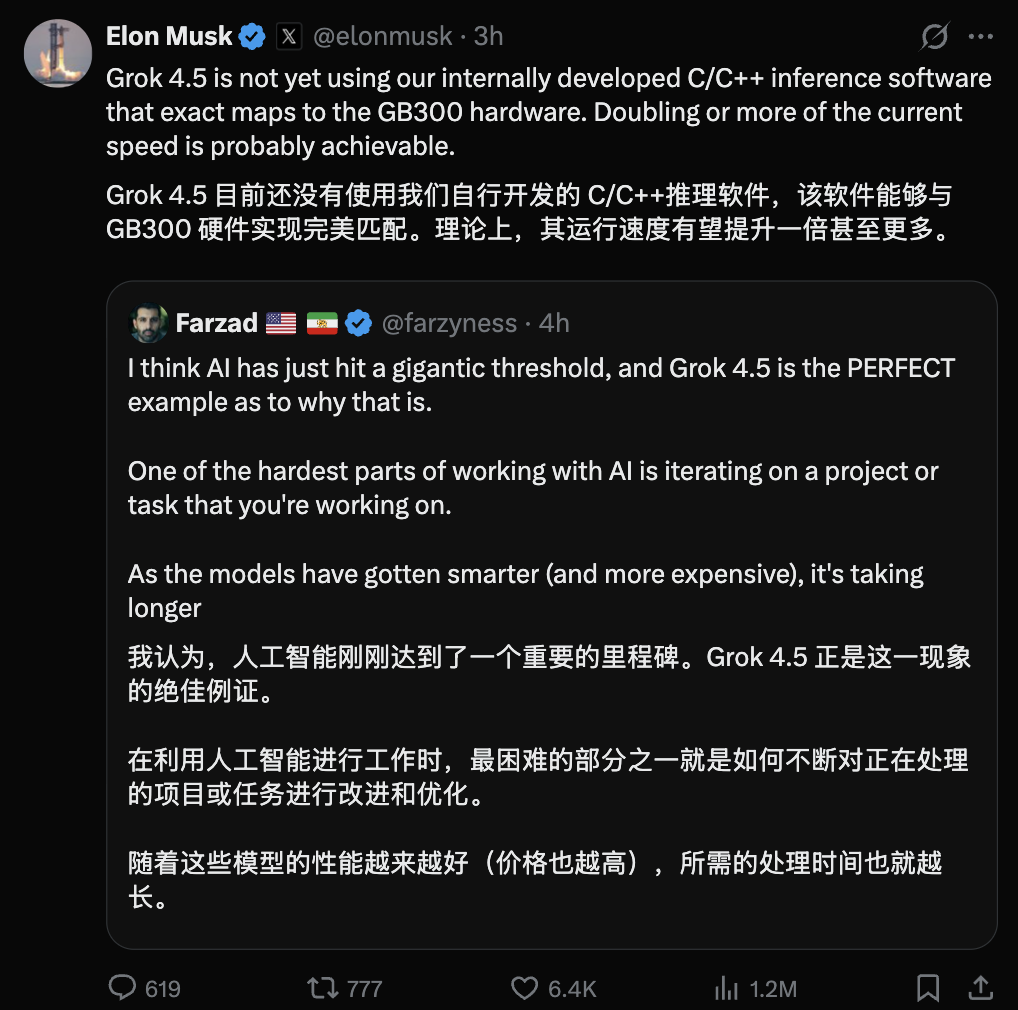
这是一个前瞻性的说法,而非经过验证的生产结果,因此不应视作有保证的性能表现。尽管如此,它凸显了模型竞争的动向。
当前沿模型的基准质量日益接近时,周边系统可创造实际优势:
对用户而言,这意味着模型比较不应仅包含单一的智能评分。一个响应更快、产生更少令牌、有效利用缓存、并以更少重试完成任务,即使在基准测试上落后于其他模型,也可能提供更好的实际价值。
Grok 4.5 可通过 xAI 的 Responses API 使用。以下 Python 示例使用了兼容 OpenAI 的客户端接口:
import os
from openai import OpenAI

api_key = os.environ.get("XAI_API_KEY")
if not api_key:
    raise RuntimeError("请先设置 XAI_API_KEY 环境变量。")

client = OpenAI(
    api_key=api_key,
    base_url="https://api.x.ai/v1",
)

response = client.responses.create(
    model="grok-4.5",
    input=(
        "审查这个 JavaScript 函数,修复错误,"
        "并解释改动:"
        "function median(values) { values.sort(); "
        "return values[values.length / 2]; }"
    ),
)

print(response.output_text)
在生产中使用模型前:
Grok 4.5 是 xAI 的前沿模型,用于编程、代理任务和知识工作。它支持文本和图像输入、可配置推理、函数调用和结构化输出。
xAI 官方模型文档列出其上下文窗口为 500,000 个令牌。实际可用上下文可能因请求格式、工具输出和平台特定限制而异。
公布的基础价格为每
每百万输入令牌 0.50 美元,每百万缓存输入令牌 0.50 美元,以及每百万输出令牌 6 美元。特定平台的变体或优先级服务可能适用不同的费率。
答案取决于基准测试和工作流程。Grok 4.5 在多项工程测试中具有竞争力,并在一些比较中领先,而其他模型在其他方面仍然保持优势。速度、令牌使用情况、工具可靠性以及任务完成成本应与基准分数一起评估。
xAI 报告称,Grok 4.5 在每个 SWE-Bench Pro 任务中平均使用 15,954 个输出令牌,而 Opus 4.8 在最大设置下使用 67,020 个。对于所测量的工作负载,输出令牌数减少了约 4.2 倍。
可以。官方模型页面列出了文本和图像输入以及文本输出。这使得它适用于截图分析、文档审查以及代理工作流程中的视觉上下文等任务。
是的。Cursor 表示 Grok 4.5 可在其桌面、网页、iOS、CLI 和 SDK 体验中使用。使用配额和定价取决于所选的 Cursor 计划。
它可以在生产级代理中用作推理模型,但周围系统仍然需要权限控制、验证、可观测性、重试机制,以及对高影响操作的人工审批。基准测试的优势并不能消除对操作防护措施的需求。
Grok 4.5 是一个面向编码、代理和知识工作的前沿模型。其最强大的实际优势是
竞争性的工程性能、高达每秒80个token的处理速度、50万token的上下文窗口,以及在已发布的SWE-Bench Pro对比中更低的token消耗——这些优势的结合。
其训练方法融合了大规模基础设施、精选数据、Cursor交互轨迹,以及真实工具使用环境中的强化学习。这有助于模型从孤立的代码生成转向更长的端到端工作流程。
主要故事不仅在于Grok变得更强大了,更在于xAI正在完成实际工作的全成本与速度上展开竞争。
从一句话开始,几分钟内拿到完整网站。



