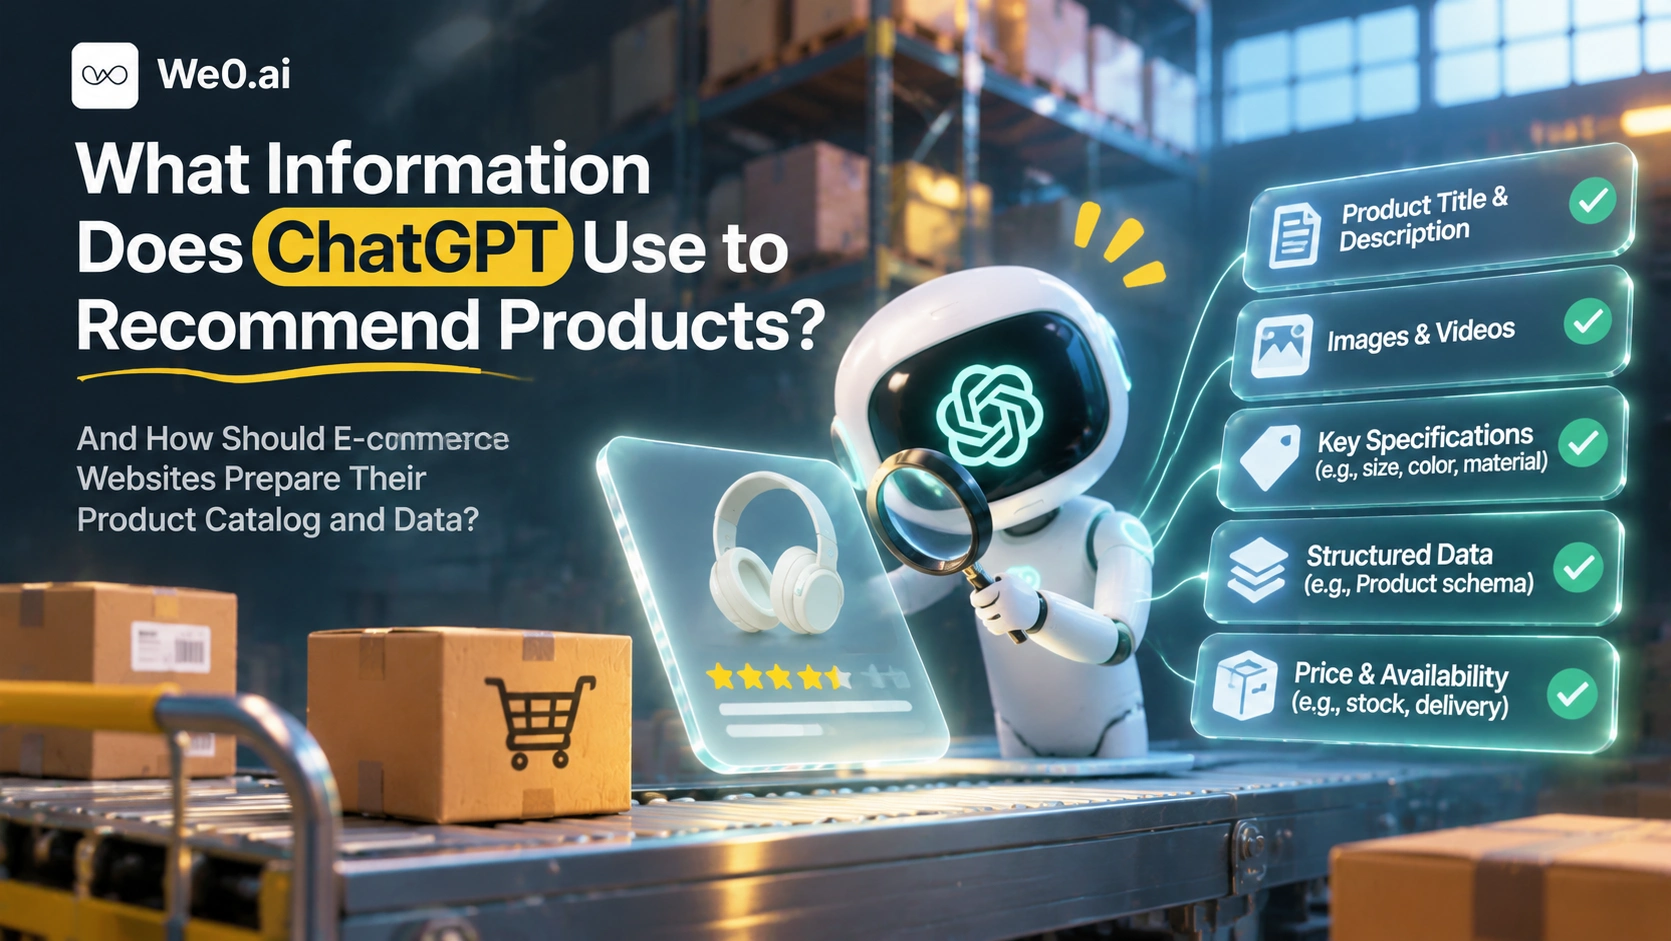
Direkte Antwort auf die Frage im Titel: ChatGPT liest bei der Produktempfehlung hauptsächlich zwei Arten von Eingaben.
Bei der ersten handelt es sich um strukturierte Produkt-Feeds, die Händler aktiv einreichen. Gemäß der Spezifikation für OpenAI-Produkt-Feeds ist ein Feed die einzige verlässliche Quelle der Produktdaten und umfasst Titel, Preis, Lagerbestand, Medienmaterial und Logistikinformationen; er dient der Produktsuche, der Produktentdeckung und – sofern die Voraussetzungen erfüllt sind – der sofortigen Kaufabwicklung. Diese Daten werden nicht per Crawler erfasst, sondern Händler pushen strukturierte Dateien an einen sicheren Endpunkt und halten sie durch häufige Aktualisierungen aktuell (Spezifikation für ChatGPT-Produkt-Feeds).
Bei der zweiten handelt es sich um Produktseiteninformationen, die es auf öffentlichen Webseiten analysieren kann: Produktname, aktueller Preis, technische Daten, Anwendungsfälle, Liefer- und Rückgaberichtlinien. Kaufempfehlungen, die Nutzer im Kontext der Einkaufsrecherche erhalten, enthalten in der Regel Empfehlungen beliebter Produkte, Vergleiche der wichtigsten Unterschiede, Analysen von Vor- und Nachteilen sowie Händlerlinks (Bericht über die ChatGPT-Einkaufsrecherche).
Entscheidend sind daher zwei Ebenen: Der Feed bestimmt, ob Ihr Produkt in den Kandidatenpool gelangt; die Produktseite bestimmt, ob es bei einer Zitierung korrekt dargestellt wird. Wenn beide nicht übereinstimmen, ist das die häufigste Problemquelle.
Drei Wege, über die ChatGPT Produktinformationen erhält
- Einkaufsrecherche: eine dialogbasierte Recherche für Kaufentscheidungen, bei der zuerst Budget, Nutzer und relevante Funktionen geklärt werden und anschließend Vergleiche und Empfehlungen ausgegeben werden; die Ergebnisse enthalten klickbare Händlerlinks.
- Produkt-Feed: Händler reichen ihren Produktkatalog strukturiert ein, wodurch durchsuchbare, vergleichbare und empfehlungsfähige Produkteinträge entstehen; die Vollständigkeit der Felder entscheidet direkt darüber, ob ein Produkt gefunden wird.
- Feed-Anzeigen: Am 12. Mai 2026 führte OpenAI innerhalb von ChatGPT das Anzeigenformat für Produkt-Feeds ein. Händler verbinden ihren Produktkatalog, legen Filterbedingungen fest, und das System generiert Anzeigen automatisch aus Produktname, Bild, Preis und Attributen. Berichten zufolge kann ein einzelner Werbetreibender bis zu 1 Million SKUs abdecken; neu hinzukommende E-Commerce-Partner müssen zunächst 100 Produktmuster einreichen. Die verwendeten Feed-Dateien entsprechen im Wesentlichen den strukturierten Dateien, die an Google Shopping übermittelt werden (Bericht zur Einführung der Produkt-Feed-Anzeigen).
Die Gemeinsamkeit der drei Wege ist eindeutig: Die Eingaben sind strukturierte Felder, sie reagieren empfindlich auf Datenrichtigkeit, und keiner von ihnen gewinnt durch Keyword-Dichte.
Was ist ein Produkt-Feed?
Ein Feed ist eine maschinenlesbare Produktliste: eine Zeile pro Produkt oder Variante, feste Felder, festes Format, regelmäßige Aktualisierung. Es ist etwas anderes als „eine Produktseite optisch ansprechend zu gestalten“. Die Produktseite dient dem Lesen und der Conversion durch Menschen, der Feed der Zuordnung und dem Vergleich zwischen Maschinen.
Die Spezifikation enthält ein leicht zu übersehendes Detail: Der Feed wird als einzige verlässliche Quelle der Produktdaten definiert. Das bedeutet, dass Titel, Preis und Lagerbestand desselben Produkts im Feed mit der Darstellung auf der Landingpage übereinstimmen müssen; andernfalls sehen Plattform und Nutzer zwei unterschiedliche Faktenstände.
Eine Tabelle zeigt, welche Felder vorbereitet werden müssen

| Feld | Empfohlene Inhalte | Warum es wichtig ist | Häufige Probleme |
|---|---|---|---|
| Product Name | Marke + Serie + Modell + Kernattribute | Erstes Signal für die Zuordnung zur Dialogabsicht | Keyword-Stapelung, fehlendes Modell, uneinheitliche Benennung gleicher Produkte |
| Description | Hauptfunktionen, Anwendungsfälle, Zielgruppe | Entscheidet, ob es als „passend für diesen Bedarf“ eingestuft wird | Auf der gesamten Website derselbe Textbaustein |
| Price | Aktueller Verkaufspreis und Währung | Für Preisvergleich und Filterung | Sonderpreise nicht synchronisiert, Mehrwertsteuerlogik unklar |
| Availability | Auf Lager / Vorbestellung / Nicht vorrätig | Beeinflusst, ob empfohlen und ob bestellt werden kann | Dauerhaft auf „auf Lager“ |
| Variants | Farbe, Größe, Kapazität, Modell | Entscheidet, ob Varianten jeweils zugeordnet werden können | Elternprodukt und untergeordnete SKU vermischt |
| Specifications | Technische Parameter in Schlüssel-Wert-Form | Unterstützt Fragen zu Parametervergleichen | Lange Satzbeschreibungen, uneinheitliche Einheiten |
| Policies | Rückgabe-, Versand- und Garantiebedingungen | Beeinflusst Vertrauen und endgültige Entscheidung | Richtlinien auf Seite und im Feed nicht identisch |
| Images | Hauptbild, Mehrwinkelbilder, Szenenbilder | Beeinflusst Darstellung und Klicks | Hauptbild mit Aktionsschriftzug |
Name, Preis und Lagerbestand müssen übereinstimmen
Ein Fall eines Elektronik-Onlineshops soll dies verdeutlichen. Dasselbe Modell „AuraSound NC-700 kabellose Kopfhörer mit Geräuschunterdrückung“ erscheint an drei Stellen: Auf der offiziellen Website kostet es 1299 Yuan und ist als auf Lager gekennzeichnet; im Produkt-Feed steht weiterhin 1499 Yuan und es ist als nicht vorrätig markiert; auf einer Drittanbieterplattform wird es für 1199 Yuan angeboten. Fragt ein Nutzer nach „Empfehlungen für Kopfhörer mit Geräuschunterdrückung unter 1500 Yuan“, kann das System das Produkt überspringen, weil der Feed-Preis das Budget überschreitet, oder es aufgrund des auf der offiziellen Seite gelesenen Preises von 1299 Yuan empfehlen und beim Landing jedoch einen anderen Informationsstand anzeigen.
Es gibt drei Vorgehensweisen: Preise und Lagerbestände in einer zentralen Datenquelle zusammenführen; Preisen und Lagerbeständen einen Aktualisierungszeitpunkt zuweisen und anhand des Zeitstempels entscheiden, welcher Datensatz gültig ist; vor dem Launch eine kanalübergreifende Konsistenzprüfung durchführen und die vier Feldkategorien Name, Preis, Lagerbestand und Link einzeln abgleichen.
Wie Varianten und Spezifikationen organisiert werden sollten
Zuerst muss klar definiert werden, was „ein Produkt“ ist, bevor über Daten gesprochen wird. Bei Produkten mit mehreren Ausführungen wird eine Eltern-Kind-Struktur empfohlen: Das Elternprodukt repräsentiert die Ausführung oder Serie, die untergeordnete SKU die konkrete Farbe, Kapazität oder das Modell; Preis und Lagerbestand hängen an der untergeordneten SKU. Attributnamen und Einheiten müssen einheitlich sein, zum Beispiel Akkulaufzeit einheitlich in „Stunden“ und Gewicht einheitlich in „Gramm“, damit derselbe Parameter nicht in verschiedenen Produkten als „ca. 30 h“, „etwa 30 Stunden“ oder „1,2 kg/1200 g“ gemischt erscheint. Spezifikationen sollten als Schlüssel-Wert-Paare vorliegen und nicht in einen langen Beschreibungstext gepackt werden.
Die Rolle von Produktbildern und Beschreibungen

Die ersten drei Zeilen der Beschreibung müssen beantworten, was es ist, für wen es gedacht ist und welches Problem es löst; erst danach sollten Details folgen. Eine wirklich wirksame Formulierung beschreibt Anwendungsfall, Zielgruppe und Einschränkungen klar, zum Beispiel: „Geeignet für Pendeln und Langstreckenflüge; die aktive Geräuschunterdrückung ist bei tieffrequentem Lärm deutlich wirksam, nicht geeignet für Radfahrsituationen, in denen Umgebungsgeräusche wahrgenommen werden müssen.“ Keyword-Stapelung bringt bei der Zuordnung durch große Modelle nahezu keinen Nutzen und verringert die Lesbarkeit. Bei Bildern sollte das Hauptbild sauber und ohne Aktionsschriftzug bleiben; Mehrwinkelbilder und Szenenbilder mit Größenreferenz helfen, Größe und Form einzuschätzen.
Sollten Produktseiten strukturierte Daten enthalten?
Ja, aber man darf sich nicht allein darauf verlassen. Produktseiten sollten schema.org Product und Offer ausgeben und bei Bedarf Bewertungen sowie FAQ-Auszeichnungen ergänzen; außerdem müssen Preis und Lagerbestand auf der Seite vollständig mit dem Feed übereinstimmen. Gleichzeitig ist sicherzustellen, dass diese Informationen im initialen HTML verfügbar sind und nicht erst nach dem Rendern durch Frontend-Skripte erscheinen; jedes Produkt benötigt eine stabile, langfristig erreichbare eigene URL, und Varianten sollten über kanonische Links unterschieden werden, statt alle auf dieselbe Adresse zu verweisen.
Erstelle in Minuten eine Showcase-Website und gewinne Leads
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Wie KI die Unterschiede zwischen verschiedenen Produkten genauer verstehen kann
Ähnliche Produkte verschwimmen am leichtesten. Die Methode besteht darin, Unterschiede in vergleichbare Skalen und boolesche Attribute zu übersetzen: drei Kopfhörermodelle in denselben Parametersatz einordnen (Tiefe der Geräuschunterdrückung, Akkulaufzeit, Gewicht, Bluetooth-Version, Unterstützung für Multipoint-Verbindungen) und für jedes Modell einen Satz „für wen es nicht geeignet ist“ ergänzen. Bei Produktgenerationen müssen Unterschiede zur Vorgängergeneration ausdrücklich genannt werden, zum Beispiel „NC-700 bietet im Vergleich zum NC-600 eine längere Akkulaufzeit und ein geringeres Gewicht“. Bei Modellen mit gleichem Namen, aber unterschiedlicher Konfiguration muss im Titel unbedingt eine Unterscheidungskennzeichnung enthalten sein; zwei verschiedene SKUs dürfen nicht denselben Namen teilen.
Wie Preis- und Lagerbestandsänderungen synchronisiert werden
Die Synchronisierung muss die Prozesskette betrachten und darf nicht auf manuellen Änderungen beruhen. Erstens: Änderungen an Preis und Lagerbestand werden ausschließlich über das Backend in die Produktstammdaten geschrieben; direkte Änderungen an Exportdateien sind nicht zulässig. Zweitens: Aus den Stammdaten werden der externe Produkt-Feed und die Seitendarstellung erzeugt; beide stammen aus demselben Schreibvorgang. Drittens: Aktualisierungsfrequenzen unterscheiden: Preise und Lagerbestände werden häufig aktualisiert, Beschreibungen und Spezifikationen selten, um Schwankungen durch vollständige Neuübertragungen zu vermeiden. Viertens: Änderungsprotokolle und Rollback-Fähigkeit erhalten, damit bei Anomalien auf die letzte stabile Version zurückgegangen werden kann. Fünftens: Monitoring-Kennzahlen etablieren, zum Beispiel Fehlquote bei Feldern, Anzahl kanalübergreifender Preisabweichungen und Zeit seit der letzten Aktualisierung.
Eine einheitliche Produktdatenquelle aufbauen: Umsetzung in fünf Schritten
- Bestandsaufnahme: Auflisten, wo Produktdaten derzeit liegen (Website-Backend, ERP, Tabellen, Verkäuferzentralen der Plattformen), und markieren, welche Quelle korrekt ist.
- Modellierung: Ein Feldwörterbuch definieren und Pflichtfelder, Typen, Einheiten und Wertelisten festlegen.
- Zentralisierte Schreibvorgänge: Nur einen Eingangspunkt für Schreibvorgänge beibehalten; andere Systeme beziehen Daten über Schnittstellen, statt jeweils eine eigene Kopie zu pflegen.
- Multi-Channel-Export: Aus denselben Stammdaten die Produktseitendarstellung, Feed-Dateien und Daten für Drittanbieterplattformen erzeugen; Feldzuordnungen zentral pflegen.
- Validierung und Monitoring: Vor dem Launch abgleichen, nach dem Launch überwachen und Inkonsistenzen als Fehler behandeln, nicht als vorübergehende operative Korrektur.
Die begleitende Entscheidungscheckliste kann so aussehen: Dürfen operative Mitarbeiter Preise direkt ändern? Bis zu welcher Ebene werden Varianten aufgeteilt? Bleiben nicht vorrätige Produkte im Feed? Wer pflegt die Richtlinien? Wie lautet der Rückfallplan, wenn die Feed-Übertragung fehlschlägt?
Was Unternehmen jetzt tun sollten
- Zuerst die Daten reparieren, dann über Kanäle sprechen. Die Vollständigkeit von Produkttiteln, Kategorien, Bildern, Preisen und Lagerbeständen zu erhöhen, ist die Voraussetzung für alle maschinellen Empfehlungsszenarien.
- Produktdaten als Eingaben für Maschinen behandeln, nicht als Keyword-Sammlung für Suchmaschinen: Anwendungsfälle, Zielgruppen und Attribut-Tags sind nützlicher als die Anhäufung von Synonymen.
- Messung von Empfehlungsquellen etablieren und die Performance von Zugriffen über dialogbasierte Einstiegspunkte bei Conversion-Rate und durchschnittlichem Bestellwert separat beobachten, bevor über Investitionen entschieden wird.
- Produktseite und Feed dieselben Stammdaten nutzen lassen und Konsistenz als Prozessvorgabe etablieren.
We0s eigenständiger E-Commerce-Store verwaltet Produkte, Kategorien, Spezifikationen und Lagerbestände im selben Backend; das CMS-Backend ermöglicht die kontinuierliche Aktualisierung von Produktinhalten; die Full-Stack-Codegenerierung kann Produktdaten-Schnittstellen und Synchronisierungslogik nach Bedarf anpassen; SEO- und GEO-Optimierung dienen der Strukturierung der Informationsarchitektur von Produktseiten (We0 E-Commerce-Store). Es ist zu beachten, dass die direkte Anbindung an OpenAI-Produkt-Feeds Qualifikationen, Endpunkte und Feldzuordnungen betrifft und weiterhin separat validiert und entwickelt werden muss; sie darf nicht als bereits integrierte Funktion betrachtet werden.
Häufig gestellte Fragen
Crawlt ChatGPT aktiv meine E-Commerce-Website?
Der Weg über den Produkt-Feed besteht darin, dass Händler strukturierte Dateien aktiv pushen, nicht auf Crawling beruhen (Spezifikation). Produktinformationen auf öffentlichen Webseiten können jedoch durchsucht und zitiert werden; daher müssen Produktseiten weiterhin klare Fakten enthalten.
Müssen Produktname, Preis und Lagerbestand vollständig mit dem Feed übereinstimmen?
Ja. Der Feed wird als einzige verlässliche Quelle der Produktdaten definiert. Wenn Preis, Lagerbestand und Landingpage nicht übereinstimmen, beeinträchtigt das direkt die Empfehlung und das Bestellerlebnis.
In welcher Form sollten Produktspezifikationen organisiert werden?
Als technische Parameter in Schlüssel-Wert-Paaren, mit einheitlichen Attributnamen und Einheiten. Parameter nicht in lange Absätze schreiben und für jede Farbe keinen eigenen Feldsatz erfinden.
Reichen strukturierte Daten aus?
Nein. Strukturierte Daten helfen Maschinen, Produktseiten korrekt zu analysieren, aber ob ein Produkt in den Kandidatenpool gelangt, hängt auch davon ab, ob ein vollständiger Produkt-Feed eingereicht wurde. Beide müssen dieselben Stammdaten nutzen.
Wie werden Preisänderungen synchronisiert?
Die Produktstammdaten werden über das Backend geschrieben; aus den Stammdaten werden sowohl die Seitendarstellung als auch die Feed-Datei erzeugt. Aktualisierungszeitpunkt, Änderungsprotokoll und Rollback-Plan müssen erhalten bleiben, um manuelle Änderungen an Exportdateien zu vermeiden.
Verwandte Tools
- E-Commerce-Store-Backend: zentrale Verwaltung von Produkten, Kategorien, Varianten und Lagerbeständen
- CMS-Backend: kontinuierliche Aktualisierung von Produktbeschreibungen, Richtlinien und Inhaltsseiten
- Full-Stack-Codegenerierung: individuelle Produktdaten-Schnittstellen und Synchronisierungslogik
- SEO- und GEO-Optimierung: Strukturierung von Informationsarchitektur und zitierfähigen Abschnitten auf Produktseiten
- Validierung strukturierter Daten: Prüfung, ob Product- und Offer-Auszeichnungen mit der Seite übereinstimmen
Verwandte Links
- Spezifikation für ChatGPT-Produkt-Feeds (Lengow)
- Bericht über die ChatGPT-Einkaufsrecherche (China.com Software)
- Bericht zur Einführung des Produkt-Feed-Anzeigenformats durch OpenAI (Stellagent)
- We0 E-Commerce-Store
Zusammenfassung
Bei der Produktempfehlung liest ChatGPT strukturierte Produktfakten: Der von Händlern gepushte Produkt-Feed entscheidet, ob ein Produkt in den Kandidatenpool gelangt; öffentlich analysierbare Produktseiteninformationen entscheiden, ob ein Produkt bei einer Zitierung korrekt dargestellt wird. E-Commerce-Websites sollten nicht die Keyword-Dichte optimieren, sondern Name, Preis, Lagerbestand, Varianten, Spezifikationen, Bilder und Richtlinien in einer einheitlichen Stammdatenquelle zusammenführen, Seitendarstellung und Feed synchron erzeugen und durch Validierung und Monitoring die kanalübergreifende Konsistenz sicherstellen. Die direkte Feed-Anbindung und der Anzeigenzugang sind eigenständige Arbeitspakete, die gemäß den Plattformanforderungen separat validiert werden müssen.