For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/zh/articles/claude-haiku-5-pricing-benchmarks-gpt-6-l-8951f544.md.
Anthropic 发布了 **Claude Haiku 5.5**,这是其迄今速度最快、成本最低的小型模型。

Anthropic 发布了 Claude Haiku 5.5,这是其迄今速度最快、成本最低的小型模型。
该模型于 2026 年 10 月 7 日正式发布,面向速度、调用规模和成本比每次请求都使用最强模型更重要的工作场景。
Anthropic 将 Haiku 5.5 定位用于以下任务:
最引人注目的数字是其短提示词价格:
输入:
每 100 万个 Token 收费 0.10 美元

输出:
每 100 万个 Token 收费 0.50 美元
适用于不超过 100,000 个 Token 的提示词。
这一价格是 Haiku 4.5 标价输入和输出价格的十分之一,也是 Sonnet 5.5 标准输入和输出价格的二十分之一。
价格下降并不意味着每种实际工作负载都会便宜 90%。
Anthropic 自己的估算更加保守:在考虑长上下文定价和新分词器之后,Haiku 5.5 的平均运行成本比 Haiku 4.5 低约 75%。
更令人意外的是,该模型并不只是更便宜。
在 Anthropic 发布的多项评测中,Haiku 5.5 的表现远超 Haiku 4.5;在 Anthropic 发布 Luna 结果的每一项基准测试中,它甚至击败了价格相近的 OpenAI GPT-6 Luna。
但这并不意味着 Haiku 5.5 可以在困难编码和开放式智能体工作中取代 Sonnet 5.5 或 Opus 5.5。
Anthropic 明确建议在这些任务中使用更大型的模型。
更准确的理解方式是:Haiku 5.5 是一种高吞吐量工作模型,其能力终于足以承担比早期 Haiku 模型严肃得多的智能体任务。
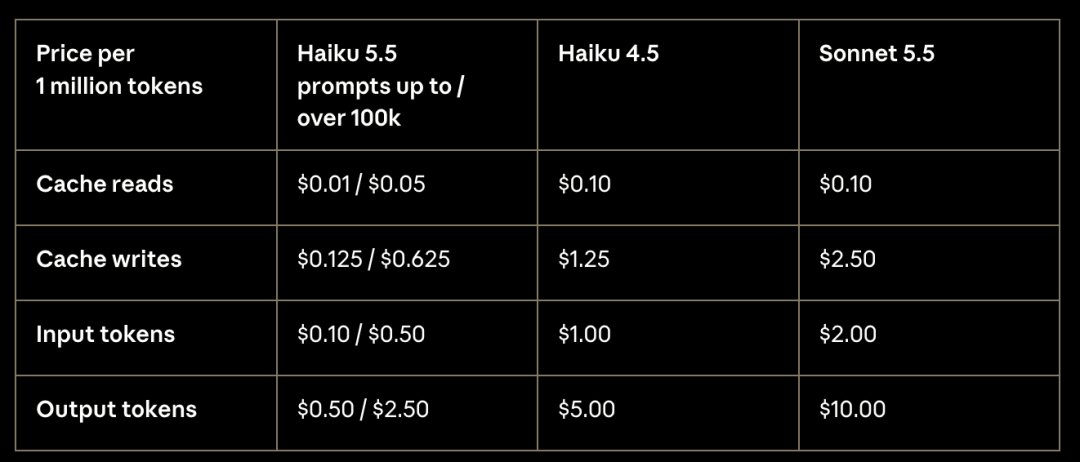
其定价结构分为两个层级。
对于不超过 100,000 个输入 Token 的提示词:
| Token 类型 | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| 缓存读取 | 每 100 万个 Token 收费 0.01 美元 | 每 100 万个 Token 收费 0.10 美元 | 每 100 万个 Token 收费 0.10 美元 |
| 缓存写入 | 每 100 万个 Token 收费 0.125 美元 | 每 100 万个 Token 收费 1.25 美元 | 每 100 万个 Token 收费 2.50 美元 |
| 输入 | 每 100 万个 Token 收费 0.10 美元 | 每 100 万个 Token 收费 1.00 美元 | 每 100 万个 Token 收费 2.00 美元 |
| 输出 | 每 100 万个 Token 收费 0.50 美元 | 每 100 万个 Token 收费 5.00 美元 | 每 100 万个 Token 收费 10.00 美元 |
对于超过 100,000 个输入 Token 的提示词,Haiku 5.5 的价格变为:
缓存读取:
每 100 万个 Token 收费 0.05 美元

缓存写入:
每 100 万个 Token 收费 0.625 美元

输入:
每 100 万个 Token 收费 0.50 美元

输出:
每 100 万个 Token 收费 2.50 美元
批处理会对输入和输出 Token 提供 50% 的折扣。
Anthropic 还表示,之前的 Haiku 模型约 90% 的请求都低于 100K 提示词阈值,这也是较低价格层级对典型高吞吐量部署如此重要的原因。
短提示词价格比 Haiku 4.5 低 90%。
但 Anthropic 估算实际平均降幅约为 75%。
主要有两个原因。
当提示词超过 100,000 个输入 Token 后,Haiku 5.5 的价格会提高五倍。
此时模型仍然比 Haiku 4.5 更便宜,但降幅从 90% 变为 50%。
Haiku 5.5 使用 Claude 4.7 及后续模型采用的新分词器。
Anthropic 的迁移指南表示,相同的输入文本在 Haiku 5.5 中生成的 Token 数量约为:
比 Haiku 4.5 多 30%
具体增幅取决于内容。
这会影响:
max_tokens因此,开发者不能直接拿 Haiku 4.5 的 Token 数量乘以 Haiku 5.5 的新 Token 价格。
必须使用新模型重新计算文本的 Token 数量。
对于标准短上下文请求,两款模型的 Token 价格可以直接比较。
OpenAI 目前列出的 GPT-6 Luna 价格为:
输入:
每 100 万个 Token 收费 0.10 美元

缓存输入:
每 100 万个 Token 收费 0.01 美元

缓存写入:
每 100 万个 Token 收费 0.125 美元

输出:
每 100 万个 Token 收费 0.50 美元
这些价格与 Haiku 5.5 的短提示词价格一致。
但两者的长上下文价格阈值差异很大。
当提示词超过以下长度时,价格进入更高层级:
100,000 个输入 Token
之后价格为:
输入:
每 100 万个 Token 收费 0.50 美元

缓存读取:
每 100 万个 Token 收费 0.05 美元

输出:
每 100 万个 Token 收费 2.50 美元
OpenAI 的长上下文价格从超过以下长度开始:
272,000 个输入 Token
之后价格变为:
输入:
每 100 万个 Token 收费 0.20 美元

缓存输入:
每 100 万个 Token 收费 0.02 美元

输出:
每 100 万个 Token 收费 0.75 美元
因此,原文区分短上下文和长上下文是正确的。
对于低于 100K 的提示词,两者的标准价格基本一致。
对于超长提示词,Luna 目前的长上下文价格明显更低,而且只有在提示词更大时才会触发更高价格层级。
这可能会实质性改变长文档或大型智能体历史记录场景中的模型路由决策。
Anthropic 借助 Haiku 5.5 的发布降低了另一项重要成本。
Claude Sonnet 5.5 的缓存读取价格从:
每 100 万个 Token 收费 0.20 美元
降至:
每 100 万个 Token 收费 0.10 美元
Anthropic 估计,这会让 Sonnet 5.5 在大多数智能体工作负载中的成本降低约 20%,因为在长时间运行的智能体中,缓存读取可能占据 Token 总量的较大比例。
这让模型家族的层级更加清晰:
Haiku 5.5
→ 最便宜、最快,适合最高吞吐量的工作

Sonnet 5.5
→ 更强,适合边界明确的工作和编码

Opus 5.5
→ 适合最困难的开放式工作和复杂智能体
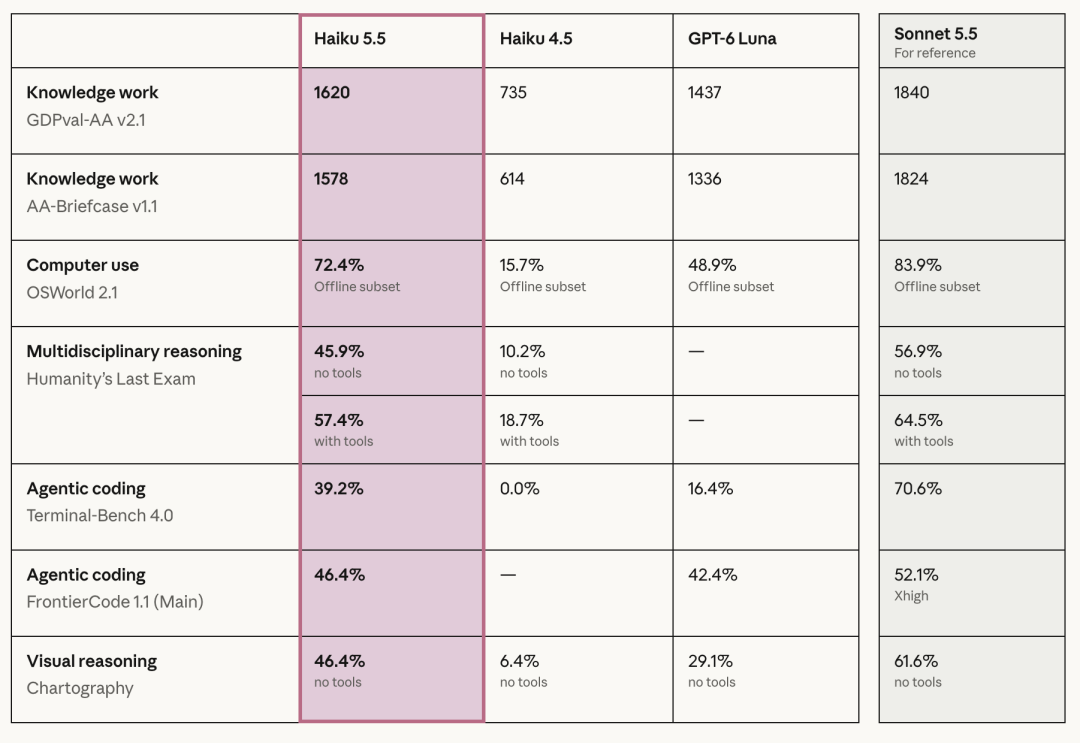
基准测试表最直观地展现了这一代模型的进步。
Anthropic 报告如下:
| 基准测试 | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 离线 | 72.4% | 15.7% | 48.9% | 83.9% |
| HLE,无工具 | 45.9% | 10.2% | — | 56.9% |
| HLE,使用工具 | 57.4% | 18.7% | — | 64.5% |
| Terminal-Bench 4.0 | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1 Main | 46.4% | — | 42.4% | 52.1% Xhigh |
| Chartography | 46.4% | 6.4% | 29.1% | 61.6% |
在 Anthropic 发布的表格中,只要包含 Luna 分数,Haiku 5.5 就在每一项中超过 GPT-6 Luna。
考虑到两款模型的短上下文输入和输出价格相同,这是一个值得关注的结果。
但这些是 Anthropic 发布的基准测试对比。
不能据此得出 Haiku 5.5 在所有工作负载中都优于 Luna 的普遍结论。
生产环境结果取决于:
代际提升最明显的是 OSWorld 2.1,这是一项针对计算机操作智能体的评测。
Haiku 4.5 的得分为:
15.7%
Haiku 5.5 达到:
72.4%
Sonnet 5.5 仍然更高,达到:
83.9%
而 GPT-6 Luna 的得分为:
48.9%
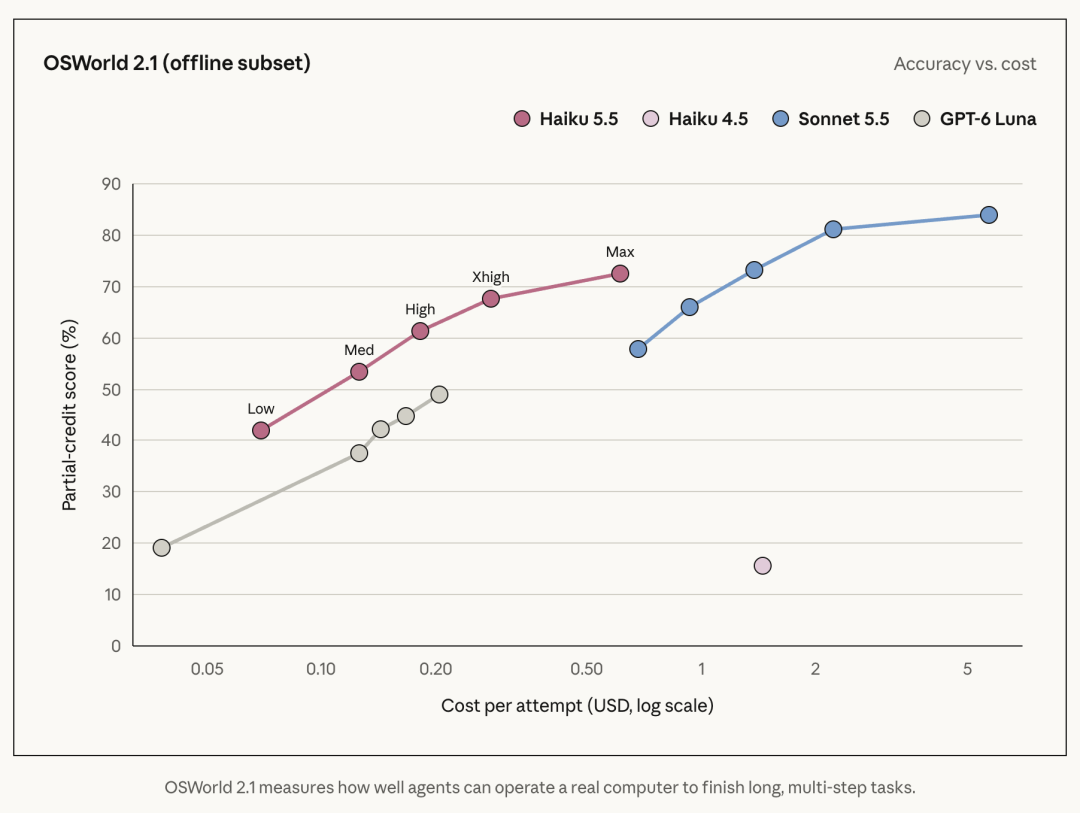
其成本性能曲线尤其值得关注。
Anthropic 的图表显示,在该评测中,Medium 努力程度的 Haiku 配置已经能够以更低的单次尝试测量成本超过图中 Luna 的最佳结果。
这并不意味着两款模型在能力或定价上完全相同。
但它确实说明了 Anthropic 为何将 Haiku 5.5 定位用于浏览器操作及其他对延迟敏感的智能体任务。
在 GDPval-AA v2.1 上,Haiku 5.5 达到:
1620 Elo
相比之下:
Haiku 4.5:
735

GPT-6 Luna:
1437

Sonnet 5.5:
1840
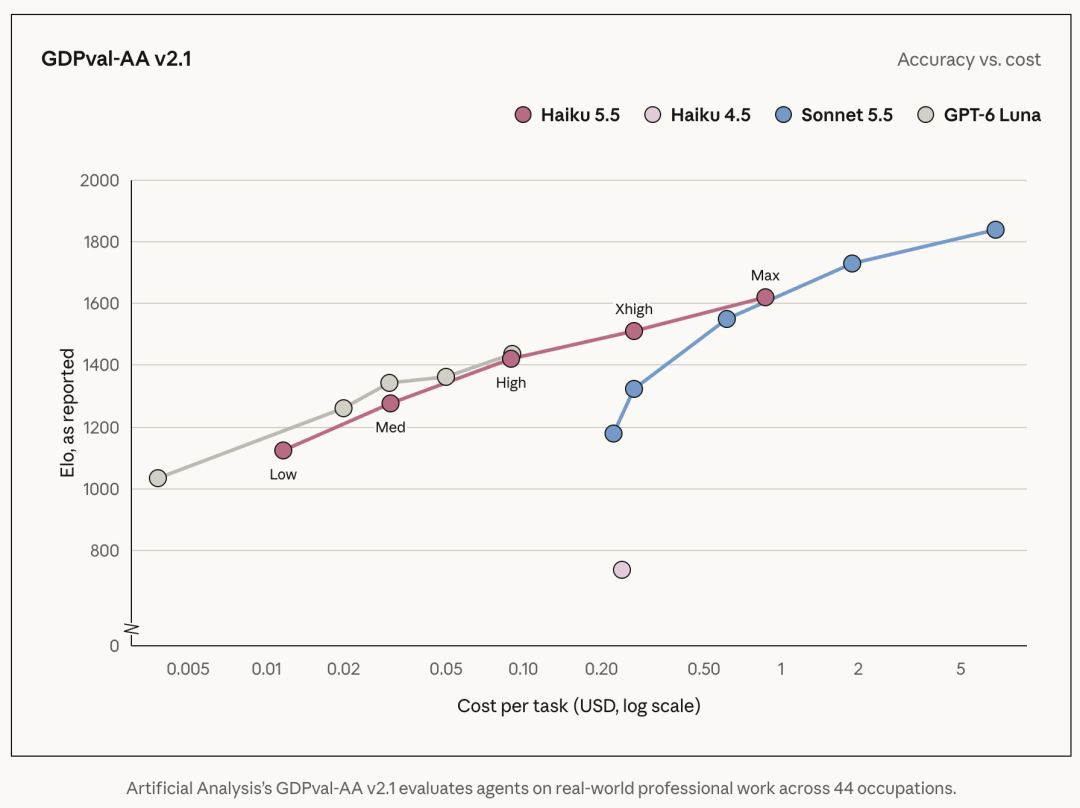
在默认的 Medium 努力程度下,得分低于 Haiku 的 Max 结果,但成本也大幅下降。
这种灵活性是 Haiku 家族此前不具备的。
Claude Haiku 5.5 是首个支持可调节 努力程度的 Haiku 级模型。
可用级别包括:
low
medium
high
xhigh
max
Claude API 的默认值为:
medium
这让开发者能够在推理深度、成本和延迟之间进行权衡。
对于路由或分类任务,low 可能已经足够。
对于更困难的信息提取或智能体任务,更高的努力程度可以投入更多计算资源。
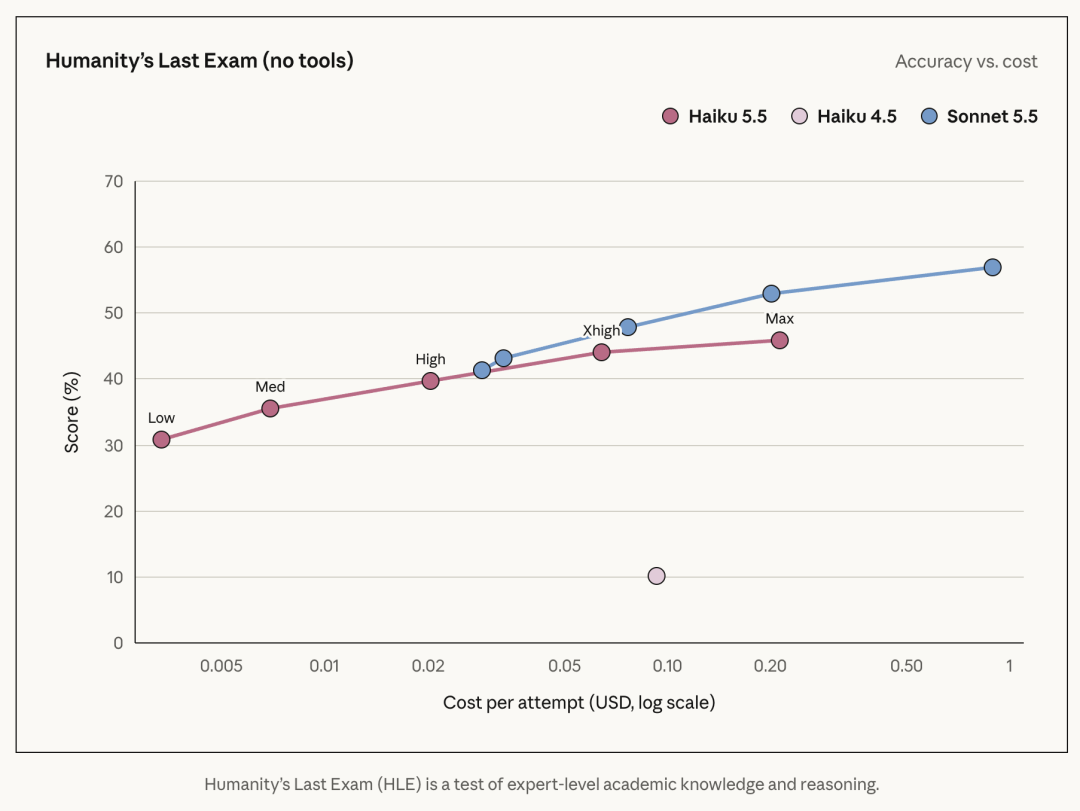
这也解释了为什么单个基准测试数字并不总能说明全部情况。
Haiku 5.5 的得分取决于为任务选择的努力程度。
原文对此保持了谨慎,官方数据也支持这一点。
在 Terminal-Bench 4.0 上:
Haiku 5.5:
39.2%

GPT-6 Luna:
16.4%

Sonnet 5.5:
70.6%
在 FrontierCode 1.1 Main 上:
Haiku 5.5:
46.4%

GPT-6 Luna:
42.4%

Sonnet 5.5:
52.1%,Xhigh
Haiku 的进步十分显著,尤其是与 Terminal-Bench 中 Haiku 4.5 显示的 0.0% 结果相比。
但 Anthropic 明确表示,对于复杂智能体编码,Sonnet 5.5 和 Opus 5.5 仍然是更好的选择。
这让 Haiku 的角色更加清晰:
Haiku:
执行范围明确的狭窄子任务

Sonnet:
复杂且边界清晰的编码

Opus:
最困难的规划和开放式智能体工作
Anthropic 建议将 Haiku 5.5 用于以下工作:
Anthropic 称其为标准速度下最快的 Claude 模型。
只有当 Opus 使用单独定价的 Fast Mode 时,Haiku 的运行速度才会慢于 Opus。
这使 Haiku 5.5 适用于延迟能够直接转化为产品价值的场景。
Anthropic 在发布时公布了多项客户评测。
输入一句想法,We0 AI 即可生成展示站、页面与 CMS。发布上线后并帮你获取客户和流量。
用户注册赠送一次完整项目生成
适合先体验一次完整生成流程,快速看到项目初稿。
这些是客户报告的测试结果,并非适用于所有场景的性能保证。
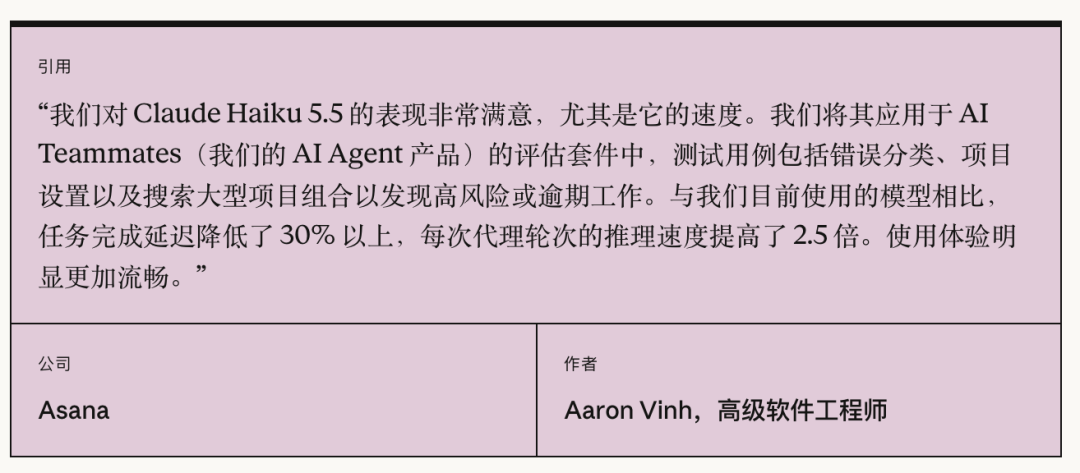
Asana 使用 AI Teammates 测试套件评估了 Haiku 5.5。
任务包括:
Asana 报告称,与其当时使用的模型相比,任务完成延迟降低了超过 30%,每个智能体回合的推理速度最高提升 2.5 倍。
Box 报告称,在早期测试中,Haiku 5.5 的得分比 Haiku 4.5 高 11 分,而延迟约为后者的一半。
该公司重点介绍了以下分析型工作负载:
AlphaSense 测试了 400 个文档问答查询。
其报告的评测得分为:
Haiku 5.5:
0.84

Haiku 4.5:
0.76
其价值在于规模。
AlphaSense 表示,这类“在文档中提问”工作负载在生产环境中每周处理约 800 万次调用,因此成本和延迟的小幅变化也具有重要的运营意义。
一个最明确的使用场景并不是取代更大型的模型,而是在更大型模型之下工作。
更大型的模型可以:
理解整体任务
→ 将任务拆分为子问题
→ 分配狭窄的工作
随后,Haiku 5.5 可以并行执行这些工作。
这种模式让系统只在真正需要的地方使用昂贵的模型能力。
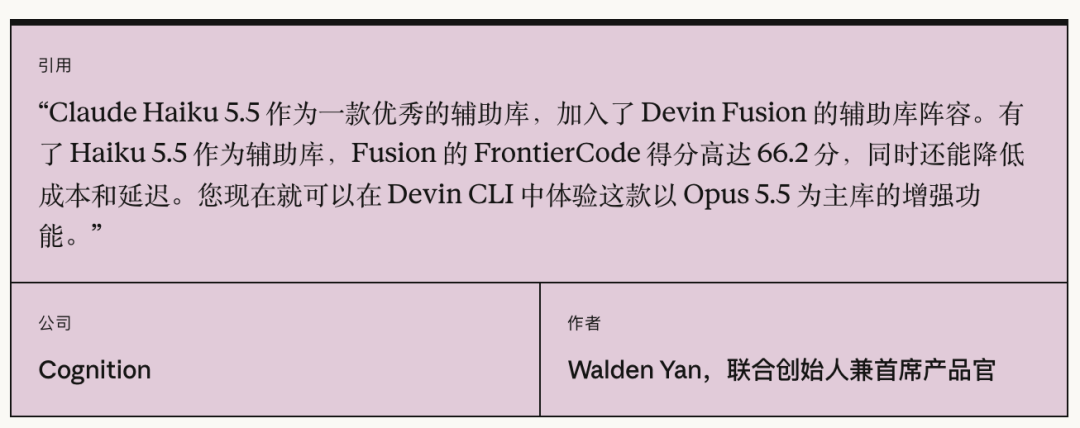
Cognition 表示,Haiku 5.5 现已作为协作模型进入 Devin Fusion。
在 Opus 5.5 作为主模型、Haiku 5.5 作为协作模型的配置下,Cognition 报告 FrontierCode 得分达到 66.2,同时降低了成本和延迟。
这是分层模型路由的一个良好示例:
Opus 5.5
→ 规划
→ 困难决策
→ 集成

Haiku 5.5
→ 并行子任务
→ 检索
→ 范围明确的实现
→ 重复性工作
其结果并不只是“使用更便宜的模型”。
更准确的说法是:“只让昂贵模型处理真正需要它的工作。”
金融 AI 公司 Rogo 描述了类似的模式。
更大型的模型可以制作演示文稿,而 Haiku 5.5 子智能体则搜索 10-K 申报文件,并提取某张幻灯片所需的分部收入数据。
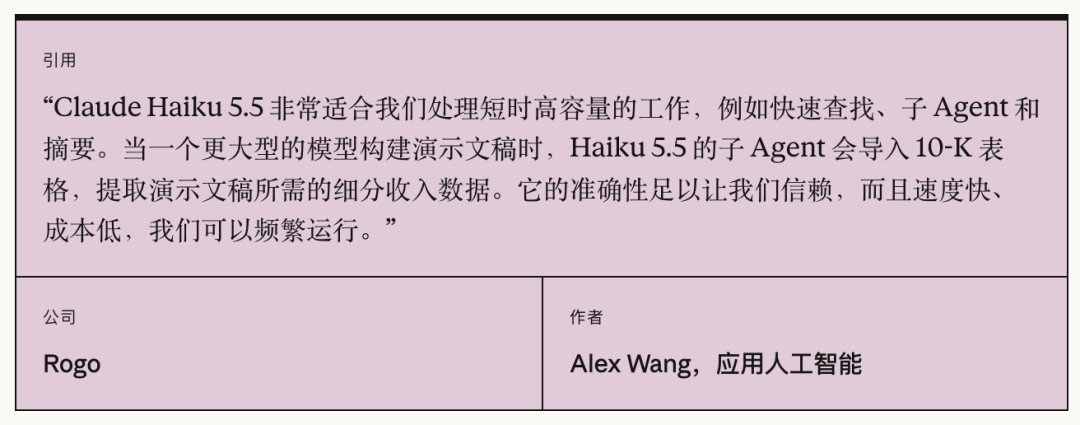
这正是 Haiku 的设计目标:狭窄、可重复的工作:
明确的问题
+
已知来源
+
高调用量
+
低延迟要求
原文介绍了 Anthropic 开发者演示中的一个扔鸡蛋落地设计任务。
据报道,Opus 5.5 单独工作时:
耗时 3 分 37 秒
测试 25 个设计
成本 0.47 美元
当 Opus 使用 10 个 Haiku 5.5 子智能体时,原文报告:
耗时 58 秒
测试 86 个设计
总成本 0.14 美元
原始 BAAI 图片在准备过程中无法稳定加载,因此本文未予转载。
这一示例应被视为 Anthropic 对特定智能体架构的演示,而不是普遍适用的 4 倍速度或成本保证。
它的目的在于说明并行化的价值。
当任务能够被清晰拆分时,多个快速的小型智能体可以同时探索更多可能性,而不是由一个昂贵模型按顺序工作。
Anthropic 当前的模型文档列出如下信息:
| 规格 | Claude Haiku 5.5 |
|---|---|
| 模型 ID | claude-haiku-5-5 |
| 上下文窗口 | 1,000,000 个 Token |
| 最大输出 | 128,000 个 Token |
| 批处理 API 最大输出,测试版 | 300,000 个 Token |
| 输入 | 文本、图像 |
| 输出 | 文本 |
| 思考 | 自适应 |
| 默认努力程度 | medium |
| 可靠知识截止日期 | 2026 年 6 月 |
| 发布日期 | 2026 年 10 月 7 日 |
1M Token 上下文窗口是默认配置。
仅使用完整上下文窗口不需要特殊的测试版请求头。
这是原文中最重要的实操部分之一。
Anthropic 的官方迁移指南确认了几项不兼容变化或行为变化。
对于 Claude API:
claude-haiku-4-5
→
claude-haiku-5-5
Haiku 5.5 的 ID 是固定格式,不使用日期后缀。
对于相同文本,新分词器生成的 Token 数量约增加 30%。
开发者应重新计算:
max_tokensHaiku 4.5 可以使用:
{
  "thinking": {
    "type": "enabled",
    "budget_tokens": 8000
  }
}
Haiku 5.5 则使用自适应思考。
如果请求仍发送旧的手动 budget_tokens 配置,将返回 400 错误。
开发者应使用自适应思考,并通过 effort 参数控制深度。
Anthropic 建议从 Haiku 5.5 请求中省略:
temperature
top_p
top_k
非默认值可能会返回 400 错误。
应使用提示词和努力程度来控制行为。
Haiku 5.5 不支持旧模式,即将最终消息设置为助手回合并让模型继续生成。
对于结构化格式,Anthropic 建议改用结构化输出或工具模式。
对于 Claude API 和 Google Cloud 的计算机操作集成,迁移指南称应改用:
computer_toolset_20260801
当前工具集提供以下操作:
Anthropic 建议为计算机操作环境配置强隔离和访问控制。
应用程序应将以下状态作为明确状态处理:
refusal
model_context_window_exceeded
安全拒答与普通的可重试基础设施故障并不相同。
Anthropic 的 Haiku 5.5 迁移指南表示,新模型不支持 Priority Tier。
已经对 Haiku 4.5 做出 Priority Tier 容量承诺的团队,应单独规划容量。
Anthropic 提供了捆绑式 Claude API 迁移技能。
在 Claude Code 中,原文给出的命令有效:
/claude-api migrate this project to claude-haiku-5-5
官方迁移指南表示,该技能可以:
在编辑文件前,它会要求用户确认迁移范围。
对于 API 调用分散在多个文件中的大型代码库,这一功能很有用。
Anthropic 表示,其 Python 和 TypeScript SDK 现已包含以下功能的测试版类:
当前的计算机操作接口使用:
computer_toolset_20260801
在支持的平台上,该工具集提供 17 个成员操作,例如:
screenshot
left_click
type
scroll
zoom
对于仅限 Web 的工作流,Anthropic 建议在适当情况下使用浏览器操作工具,而不是开放完整桌面环境。
这很重要,因为 Haiku 的速度和低价格组合尤其适合重复性的浏览器和桌面智能体交互。
Anthropic 表示,Haiku 5.5 可通过以下渠道使用:
原文还指出,该模型可通过 Cursor 和 OpenRouter 等第三方平台使用。
这些属于外部集成,可能有自己的价格、速率限制和模型路由行为。
对于直接使用 Anthropic 进行开发,官方模型 ID 为:
claude-haiku-5-5
Claude Haiku 5.5 是 Anthropic Claude 5.5 家族中速度最快、成本最低的小型模型。它面向高吞吐量、低延迟工作,例如摘要、分类、路由、信息提取、浏览器操作和子智能体任务。
对于不超过 100K Token 的提示词,输入价格为每 100 万个 Token 收费 0.10 美元,输出价格为每 100 万个 Token 收费 0.50 美元。超过 100K 的提示词使用更高价格,即输入每 100 万个 Token 收费 0.50 美元,输出每 100 万个 Token 收费 2.50 美元。
短提示词的 Token 价格低 90%。Anthropic 估计,实际平均工作负载成本更接近降低 75%,因为超过 100K 的请求只能享受 50% 的价格下降,而且新分词器会为相同文本生成约 30% 更多的 Token。
在短上下文场景中,两者的标准输入、缓存输入和输出价格相同。在长上下文场景中,GPT-6 Luna 目前更有价格优势,因为它在超过 272K Token 后才进入更高价格层级,而不是 100K,并且其长上下文价格更低。
是的。Anthropic 列出的上下文窗口为 1,000,000 个 Token,普通请求最多可输出 128K 个 Token。测试版的 Message Batches 选项最多可支持 300K 个输出 Token。
它比 Haiku 4.5 强得多,并且在 Anthropic 发布的 Terminal-Bench 和 FrontierCode 结果中击败了 GPT-6 Luna。不过,对于复杂智能体编码,Anthropic 仍建议使用 Sonnet 5.5 或 Opus 5.5。
主要变化包括新的模型 ID、相同文本约增加 30% 的 Token 数量、使用自适应思考替代 budget_tokens、移除旧采样设置、不再支持助手预填充、更新计算机操作工具,以及新增停止原因。
Claude API 的模型 ID 是:
claude-haiku-5-5
Anthropic 还为 Amazon Bedrock、Google Cloud、Microsoft Foundry 和 AWS 上的 Claude Platform 记录了平台专用标识符。
/claude-api migrate 工作流。computer_toolset_20260801 和桌面智能体集成的官方指南。computer_toolset_20260801 接口和安全指导的文档。Claude Haiku 5.5 是一次远超其在 Claude 价格梯队中所处位置的升级。Anthropic 将短提示词价格降至输入每 100 万个 Token 收费 0.10 美元、输出每 100 万个 Token 收费 0.50 美元,同时为模型提供 1M Token 上下文窗口、自适应思考,以及明显更强的计算机操作、编码、知识工作和推理能力。
该模型的角色仍然清晰。Sonnet 5.5 和 Opus 5.5 仍然更适合困难的智能体编码和开放式工作,而 Haiku 5.5 则针对能够大规模执行或由更大型主模型委派的快速、狭窄、可重复工作进行了优化。
从 Haiku 4.5 迁移的开发者不应只替换模型 ID。新分词器、自适应思考、采样限制、预填充变化、计算机操作工具集和长上下文价格阈值都会影响现有集成。
Haiku 5.5 最具吸引力的地方,不是成为所有大型模型的廉价替代品,而是作为快速执行层,让高吞吐量和多智能体系统变得更加经济。
从一句话开始,几分钟内拿到完整网站。



