For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/openai-s-gpt-7-and-gpt-8-research-focus-w-75b1c0ac.md.
GPT-6 ist noch neu, doch OpenAI denkt bereits weit darüber hinaus.
GPT-6 ist noch neu, doch OpenAI denkt bereits weit darüber hinaus.
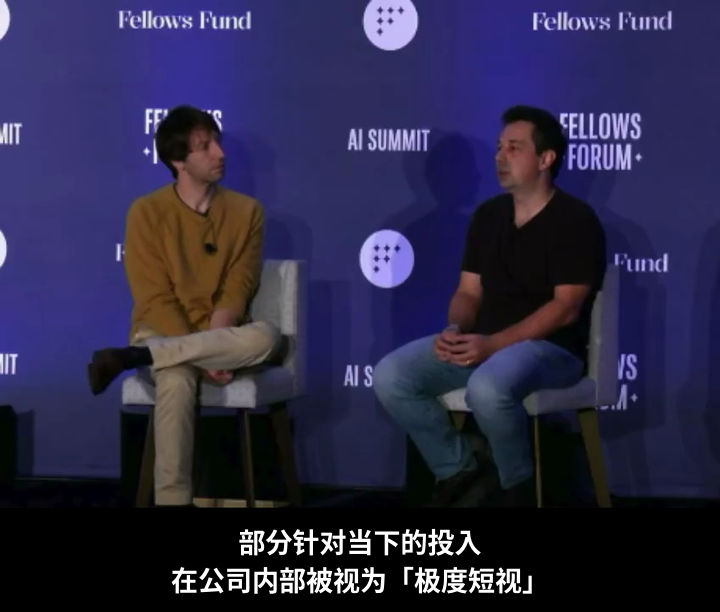
Auf dem Fellows Forum AI Summit am 23. September 2026 schätzte Boris Power, Head of Applied Research bei OpenAI, dass sich rund 80 % bis 90 % der Forschung des Unternehmens bereits auf Folgendes konzentrieren:
GPT-7
GPT-8
und spätere Generationen
Die Aussage fiel in einem öffentlichen Gespräch mit Zachary Lipton darüber, wie Frontier-Modelle von der Forschung in Agents und reale Systeme übergehen.
Powers Punkt war nicht, dass GPT-6 keine Bedeutung mehr habe.
OpenAI verbessert die aktuelle Generation weiterhin aktiv. Anfang September stellte das Unternehmen GPT-6 Astra vor, sein leistungsfähigstes GPT-6-Modell. Am 22. September erweiterte es die Familie um die schnelleren und kostengünstigeren Modelle GPT-6 Sol und GPT-6 Luna.
Das führt zu einem scheinbaren Widerspruch:
Powers Erklärung verbindet beide Aspekte.
OpenAI kann die heutigen Modelle weiter verbessern, weil diese Korrekturen aktuelle Produkte besser machen und dem Forschungsteam wertvolle Erkenntnisse liefern. Gleichzeitig könnten die größten langfristigen Fortschritte daraus entstehen, ein deutlich stärkeres Modell der nächsten Generation aufzubauen – und dieses Modell anschließend zur Schulung kostengünstigerer Systeme einzusetzen.
Das Ergebnis ist eine zweigleisige Strategie:
die Leistungsgrenze weiter nach oben verschieben
+
nützliche Fähigkeiten entlang der Kostenkurve nach unten bringen
Power verwendete für einige Arbeiten an Systemen der aktuellen Generation ungewöhnlich deutliche Worte.
Er sagte, bestimmte Investitionen in die heutigen Modelle würden intern als „extrem kurzsichtig“ betrachtet.
Das bedeutet nicht, dass diese Arbeit sinnlos ist.
Angenommen, ein aktuelles Modell hat Schwierigkeiten mit Tool Calling.
Ein Team könnte:
Das kann das Produkt unmittelbar besser machen.
Es kann Forschenden außerdem zeigen, warum das Modell versagt hat und welche Maßnahmen geholfen haben.
Powers Warnung betrifft die Lebensdauer der Korrektur.
Ein Problem, das bei GPT-6 sorgfältige Eingriffe erfordert, könnte bei GPT-7 von selbst verschwinden, weil die nächste Modellgeneration in der zugrunde liegenden Fähigkeit schlicht besser ist.
Anders ausgedrückt:
die heutige Korrektur
kann zu
morgigen überholten Workaround werden
Deshalb müssen Forschungsorganisationen fortlaufend entscheiden, welche Probleme eine tiefgreifende Investition verdienen.
Die Tatsache, dass eine Korrektur möglicherweise überholt wird, bedeutet nicht, dass Nutzer warten können.
Menschen verwenden aktuelle Produkte heute.
Wenn ein Modell wiederholt ein Ziel aus den Augen verliert, ein Tool nicht korrekt nutzt oder zu viel manuelle Aufsicht benötigt, bleibt dieses Problem relevant.
Powers Unterscheidung liegt daher zwischen:
was das Produkt jetzt verbessert
und:
was den größten langfristigen Forschungswert schafft
Die Veröffentlichung von OpenAIs GPT-6 Astra zeigt, dass das Unternehmen weiterhin erhebliche Arbeit in die erste Kategorie investiert.
In der offiziellen Astra-Ankündigung beschreibt OpenAI Verbesserungen für die praktische Arbeit, darunter eine schnellere Computernutzung und eine bessere Zusammenarbeit innerhalb von Codex.
Astra kann dem Nutzer eine gezielte Frage stellen und gleichzeitig Arbeit fortsetzen, die nicht von der Antwort abhängt. Ist die Entscheidung folgenreich, wartet es. Handelt es sich bei dem fehlenden Detail um eine Routineinformation, kann es mit einer angemessenen Annahme fortfahren.
OpenAI erklärt außerdem, dass Astra das ursprüngliche Ziel und die Einschränkungen besser beibehält, wenn der Nutzer während einer Aufgabe neue Anforderungen ergänzt.
Diese Details klingen möglicherweise weniger spektakulär als ein Benchmark-Wert, beeinflussen aber unmittelbar, ob sich ein KI-System eher wie ein Werkzeug oder wie ein fähiger Kollege verhält.
Die zweite Hälfte von Powers Argument betrifft die Modellgröße.
Warum so stark in ein teures Frontier-Modell investieren, wenn viele Nutzer letztlich etwas Schnelleres und Günstigeres benötigen?
Weil das stärkere Modell zum Lehrer werden kann.
Power beschrieb ein Muster, das folgendermaßen aussieht:
ein hochleistungsfähiges allgemeines Modell trainieren
→ es zur Erzeugung hochwertiger Beispiele nutzen
→ nützliche Ergebnisse auswählen oder filtern
→ ein kleineres Modell mit diesen Beispielen trainieren
→ das kleinere Modell kostengünstiger bereitstellen
Dies ist eine Form der Modelldestillation.
Das Schüler-Modell muss nicht jede Fähigkeit des Lehrer-Modells reproduzieren.
Es muss nur genügend des nützlichen Verhaltens des Lehrers übernehmen, um die Zielaufgabe zu bewältigen.
Deshalb kann die Arbeit an einem Frontier-Modell selbst für Kunden relevant sein, die dieses Modell niemals direkt verwenden.
OpenAI hat Destillation in früheren Produktgenerationen öffentlich beschrieben.
Im März 2025 erklärte das Unternehmen bei der Einführung einer neuen Generation von Audiomodellen, dass es fortschrittliche Destillationsmethoden nutzte, um Wissen von größeren Audiomodellen auf kleinere, effizientere Systeme zu übertragen.
Das Unternehmen beschrieb außerdem den Einsatz von Self-Play-Daten, um realistischere Gesprächsdynamiken abzubilden, sodass die kleineren Modelle nützlich und reaktionsfähig bleiben konnten.
Ein separates Beispiel aus dem OpenAI Cookbook veranschaulicht die Lehrer-Schüler-Idee noch deutlicher.
Das Beispiel verwendet GPT-4o als Lehrer für GPT-4o mini bei einer Klassifikationsaufgabe für Weintrauben.
In einem Validierungsdatensatz mit 300 Beispielen wurden folgende Genauigkeiten angegeben:
GPT-4o:
79,67 %

GPT-4o mini:
64,67 %

Destilliertes GPT-4o mini:
79,33 %
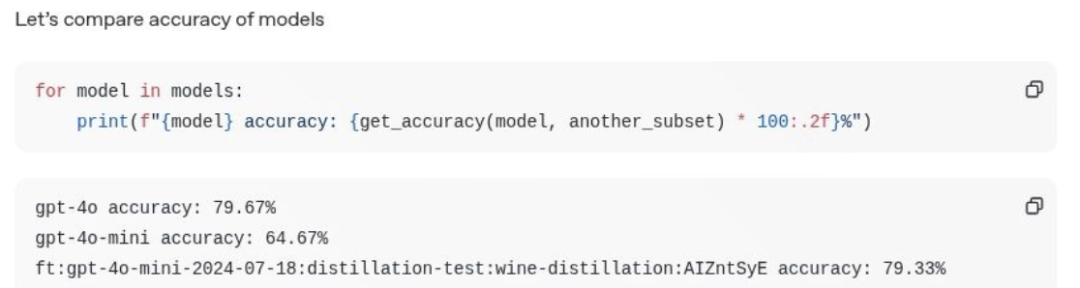
Der destillierte Schüler erreichte bei dieser spezifischen Aufgabe nahezu die Leistung des Lehrers.
Das bedeutet nicht, dass das kleinere Modell GPT-4o allgemein gleichwertig wurde.
Es bedeutet, dass ein leistungsfähiger Lehrer ein gezieltes Verhalten ausreichend effektiv übertragen kann, sodass ein kleineres Modell für einen eng abgegrenzten Arbeitsablauf deutlich nützlicher wird.
Die GPT-6-Familie setzt eine ähnliche Idee im Produktmaßstab um, obwohl OpenAI kein vollständiges Trainingsrezept veröffentlicht hat, das es rechtfertigen würde, Luna einfach als ein „destilliertes Astra“ zu bezeichnen.
OpenAI erklärt, dass GPT-6 Sol und GPT-6 Luna mit Methoden trainiert wurden, die denen von GPT-6 Astra ähneln. Damit übertragen sie Fortschritte der Astra-Generation auf schnellere und günstigere Modelle.
Das Unternehmen positioniert die Familie folgendermaßen:
GPT-6 Astra
höchste Leistungsfähigkeit

GPT-6 Sol
starke Allzweckleistung zu geringeren Kosten

GPT-6 Luna
deutlich kostengünstigeres Modell für Arbeitslasten mit hohem Volumen
Die offiziellen GPT-6-Preise von OpenAI zum Release am 22. September lauteten:
| Modellübergang | Eingabe | Ausgabe | Reduktion |
|---|---|---|---|
| GPT-5.6 Sol → GPT-6 Sol | 4 $ → 2 $ / 1 Mio. Tokens | 20 $ → 10 $ / 1 Mio. Tokens | 50 % |
| GPT-5.6 Luna → GPT-6 Luna | 0,20 $ → 0,10 $ / 1 Mio. Tokens | 1,20 $ → 0,50 $ / 1 Mio. Tokens | 50 % |
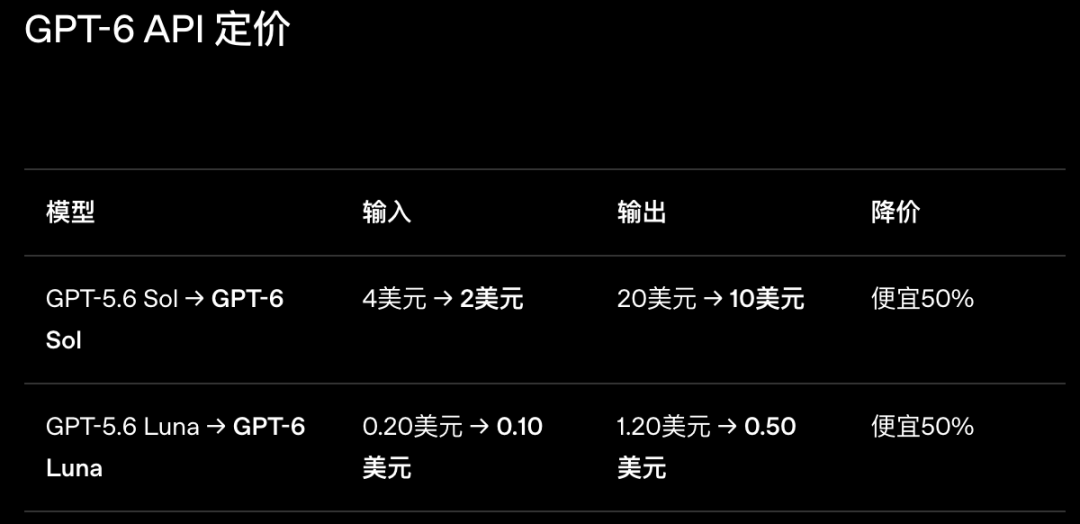
OpenAI beschreibt das Ziel ausdrücklich als die Verteilung von Frontier-Intelligenz über verschiedene Budgets und Arbeitslasten hinweg.
Ein größeres Modell hebt die Obergrenze an.
Kleinere Modelle bringen mehr dieser Fähigkeiten in den täglichen Einsatz.
Weil die meisten Workflows nicht von Anfang bis Ende gleich schwierig sind.
Ein Projektbericht ist ein hilfreiches Beispiel.
Stellen Sie sich mehrere Quelldokumente vor, die:
Der erste Teil der Arbeit erfordert ein stärkeres Urteilsvermögen.
Ein leistungsfähiges Modell kann:
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Sobald die Richtung feststeht, werden viele verbleibende Schritte routinemäßiger.
Ein kleineres Modell kann für Folgendes vollkommen ausreichen:
Tritt eine neue Unklarheit auf, kann die Aufgabe wieder an das stärkere Modell eskaliert werden.
Ein praktischer Workflow könnte daher so aussehen:
starkes Modell
→ schwierige Beurteilung

kleines Modell
→ repetitive Ausführung

starkes Modell
→ Behandlung von Ausnahmen
Günstigere Tokens bedeuten nicht automatisch günstigere Arbeit.
Ein kleines Modell kann pro Anfrage weniger kosten, dem Nutzer aber mehr Arbeit verursachen, wenn es Folgendes erfordert:
Die hilfreiche Frage lautet daher nicht:
Welches Modell hat den niedrigsten Tokenpreis?
Sondern:
Was kostet das gesamte akzeptierte Ergebnis?
Diese Gesamtkosten umfassen sowohl Maschinenkosten als auch menschliche Zeit.
Eine niedrigere API-Rechnung ist kein großer Gewinn, wenn der Nutzer zum hauptberuflichen KI-Projektmanager werden muss, damit das günstigere Modell erfolgreich arbeitet.
Die beste Arbeitsteilung hängt daher von der Aufgabe ab.
Ein kleineres Modell ist wertvoll, wenn es klar definierte Arbeit zuverlässig und kostengünstig abschließen kann.
Ein größeres Modell rechtfertigt seinen höheren Preis, wenn die Aufgabe tatsächlich stärkeres Urteilsvermögen erfordert.
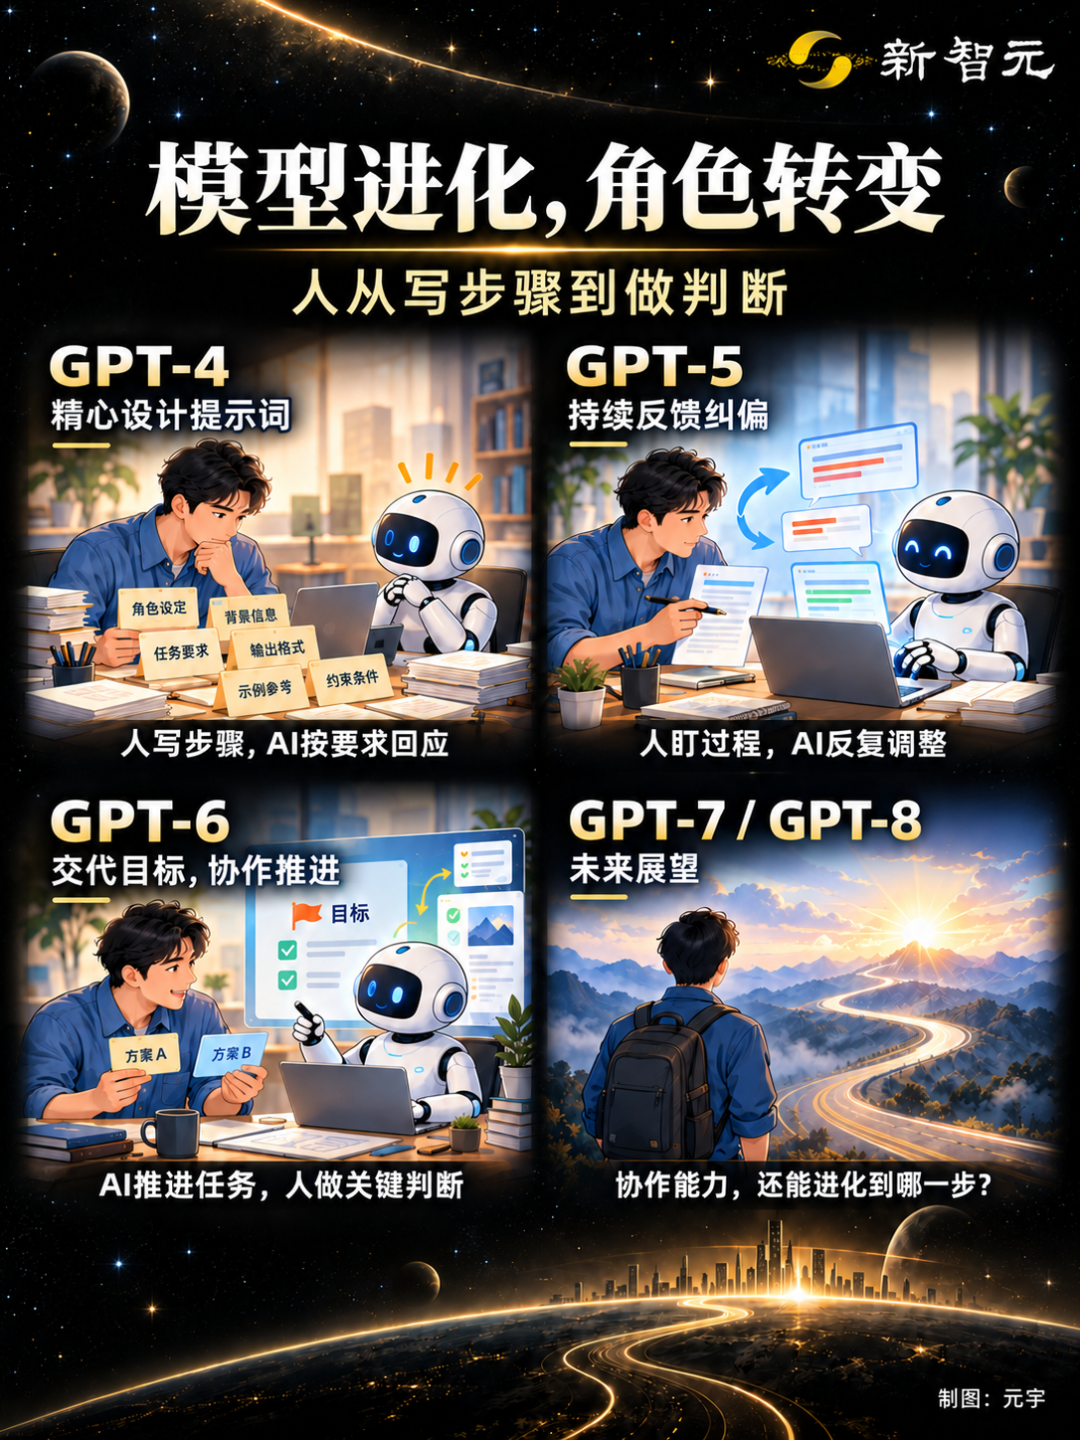
Power beschrieb außerdem einen Wandel darin, wie Menschen mit aufeinanderfolgenden Modellgenerationen interagieren.
Der Quellartikel fasst die Entwicklung ungefähr so zusammen:
GPT-4:
Menschen entwerfen die Schritte sorgfältig

GPT-5:
Menschen steuern den Prozess und korrigieren fortlaufend

GPT-6:
Menschen formulieren zunehmend das Ziel und überwachen zentrale Entscheidungen
Dies ist eine Vereinfachung und keine Garantie für jede Aufgabe.
Doch OpenAIs eigene Astra-Dokumentation beschreibt dieselbe allgemeine Richtung.
Astra kann:
Das verändert die Rolle des Menschen.
Statt jeden Schritt manuell vorzugeben, tut der Nutzer zunehmend eher Folgendes:
das Ziel setzen
→ Einschränkungen definieren
→ folgenreiche Entscheidungen prüfen
→ das Ergebnis kontrollieren
Die zentrale Frage für GPT-7 und GPT-8 lautet, wie weit dieser Wandel noch gehen kann.
Modellfortschritt wird häufig anhand von Benchmark-Werten präsentiert.
Für die tägliche Arbeit könnte eine andere Kennzahl wichtiger sein:
Wie viel Aufsicht muss der Nutzer dem Modell noch geben?
Nachdem das Modell ein Ziel erhalten hat:
Wenn GPT-7 oder GPT-8 diese Belastungen reduziert, könnte das wertvoller sein als eine kleine Verbesserung bei einem Benchmark.
Das ist auch der Grund, warum Forschung an größeren Modellen und Arbeit an kleineren Modellen einander verstärken.
Das Frontier-Modell versucht, leistungsfähigeres Verhalten zu erschließen.
Das günstigere Modell versucht, genügend dieses Verhaltens im großen Maßstab erschwinglich zu machen.
Die Schlagzeilenzahl benötigt eine wichtige Einordnung.
Powers Aussage von „80 % bis 90 %“ war eine Schätzung, die er in einem öffentlichen Gespräch abgab.
Sie war nicht:
Die Agenda des Fellows Forum bestätigt, dass Power als Head of Applied Research bei OpenAI in einem Fireside Chat am 23. September mit dem Titel „Where Models Meet Reality“ sprach.
Unabhängige Berichterstattung über die Aufzeichnung verortet die Bemerkung zu den 80–90 % bei ungefähr 1:32:52 in der vollständigen Veranstaltungsaufzeichnung.
Die vorsichtigste Interpretation lautet daher:
Power glaubt, dass sich die große Mehrheit der Forschungsaufmerksamkeit von OpenAI auf Modellgenerationen nach GPT-6 richtet, weil er dort die größten grundlegenden Fortschritte erwartet.
Die Aussage sollte nicht als buchhalterisch wörtliche Darstellung gelesen werden.
Power machte seine Aussagen am 23. September.
Sechs Tage später, am 29. September, veröffentlichte OpenAI GPT-6.1 Sol.
Dieses Modell ist nicht zentral für das Argument des ursprünglichen Artikels, da die Diskussion sich auf die am Event beschriebene Astra-→-Sol/Luna-Lehrer-Schüler-Logik konzentriert.
Für Leser, die den Artikel jetzt veröffentlichen, ist es dennoch hilfreicher Kontext.
OpenAI beschreibt GPT-6.1 Sol als die neueste Modellfamilie der GPT-6-Serie, deren Fähigkeiten bei Programmierung, Computernutzung und professioneller Arbeit zu einem deutlich niedrigeren Standard-API-Preis an Astra heranreichen.
Seine Existenz unterstreicht dasselbe Muster, das im Interview diskutiert wurde:
Frontier-Fähigkeiten verbessern sich
→ kostengünstigere Modelle übernehmen mehr davon
→ Nutzer erhalten stärkere Leistung zu geringeren Kosten
Sie zeigt außerdem, warum die Namen einzelner Zwischen-Releases weniger wichtig sind als die übergeordnete Forschungsstrategie.
Boris Power, Head of Applied Research bei OpenAI, schätzte auf dem Fellows Forum 2026, dass sich ungefähr 80–90 % der OpenAI-Forschung auf GPT-7, GPT-8 und spätere Generationen konzentrieren. Die Zahl war seine öffentliche Schätzung und kein geprüfter Bericht zur Ressourcenallokation des Unternehmens.
Nein. In Powers Aussagen wurden weder ein öffentlicher Starttermin noch eine detaillierte Produkt-Roadmap für GPT-7 oder GPT-8 angekündigt. Er verwendete die Namen, um die Generationen nach GPT-6 zu beschreiben, die seiner Ansicht nach den größten Teil der langfristigen Forschungsaufmerksamkeit erhalten.
Arbeit an der aktuellen Generation verbessert heutige Produkte und liefert Forschenden schnelleres Feedback. Powers Punkt ist, dass manche Korrekturen nur kurzlebig sein könnten, weil ein leistungsfähigeres Modell der nächsten Generation das zugrunde liegende Problem vereinfachen oder vollständig beseitigen kann.
Modelldestillation ist eine Gruppe von Techniken, bei denen ein stärkeres Lehrer-Modell beim Training eines kleineren Schüler-Modells hilft. Ein häufiger Ablauf nutzt den Lehrer zur Erzeugung hochwertiger Beispiele, filtert diese Beispiele und trainiert das kleinere Modell darauf, das für eine Zielaufgabe erforderliche Verhalten zu reproduzieren.
OpenAI erklärt, dass Sol und Luna mit Astra ähnlichen Methoden trainiert wurden und Fortschritte derselben Generation übernehmen. Das Unternehmen hat jedoch nicht genügend Details veröffentlicht, um Luna oder Sol einfach als komprimierte Kopien von Astra zu bezeichnen. Präziser ist, dass sie verwandte Fortschritte bei den Fähigkeiten in kostengünstigere Stufen übertragen.
Zum Start am 22. September berechnete OpenAI für GPT-6 Sol 2 $ pro Million Eingabe-Tokens und 10 $ pro Million Ausgabe-Tokens. GPT-6 Luna kostete 0,10 $ für Eingabe und 0,50 $ für Ausgabe pro Million Tokens. OpenAI beschrieb beide Modelle als 50 % günstiger als die Aktionspreise ihrer GPT-5.6-Pendants.
Setzen Sie das stärkere Modell dort ein, wo die Aufgabe schwieriges Urteilsvermögen, mehrdeutige Schlussfolgerungen, Ausnahmebehandlung oder wichtige Entscheidungen erfordert. Kleinere Modelle eignen sich häufig besser für klar spezifizierte, repetitive Arbeit mit hohem Volumen, sobald die grundlegende Richtung festgelegt ist.
Der Trend geht vom Formulieren jedes einzelnen Schritts hin zum Setzen von Zielen, Definieren von Einschränkungen und Prüfen wichtiger Entscheidungen. Die Astra-Dokumentation von OpenAI beschreibt ausdrücklich asynchrone Fragen, fortgesetzte Arbeit während des Wartens auf eine Antwort sowie eine bessere Bewahrung des ursprünglichen Ziels bei langen Aufgaben.
Boris Powers Schätzung von 80–90 % macht die Forschungsstrategie von OpenAI leichter verständlich. Das Unternehmen kann die heutigen GPT-6-Produkte weiter verbessern und gleichzeitig den Großteil seiner langfristigen Forschungsaufmerksamkeit auf zukünftige Generationen richten, bei denen es größere Fortschritte bei den Fähigkeiten erwartet.
Die zweite Hälfte dieser Strategie ist ebenso wichtig. Stärkere Frontier-Modelle sind nicht nur als Premiumprodukte wertvoll; sie können auch als Lehrer und Forschungsplattformen dienen, die helfen, nützliche Fähigkeiten in schnellere, kostengünstigere Systeme wie Sol und Luna zu übertragen.
Für Nutzer lautet die praktische Frage nicht, welches Modell das größte ist. Entscheidend ist, Arbeit so zu verteilen, dass schwierige Beurteilungen an das Modell gehen, das sie bewältigen kann, während routinemäßige Ausführung dem kostengünstigsten Modell übertragen wird, das die Aufgabe zuverlässig abschließen kann.
OpenAIs langfristige Wette scheint eindeutig: Die Leistungsgrenze weiter nach oben verschieben und dann mehr dieser Fähigkeiten so erschwinglich machen, dass sie täglich genutzt werden können.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



