curl -sL https://www.example.com/ | grep -o '[^'
curl -sL https://www.example.com/ | head -c 1200
Wenn die Antwort nur `
` und viele Script-Tags enthält, aber keinen lesbaren Firmennamen, Produktnamen oder Absatztext, dann erhält der Crawler beim ersten Zugriff genau diese leere Hülle. Googles Dokumentation zu JavaScript-SEO erklärt das Verhältnis von Crawling und Rendering: Skriptinhalte sind nicht völlig unsichtbar, aber Rendering benötigt zusätzliche Crawling-Warteschlangen und Ressourcen. Je stärker Inhalte und Links von Skripten abhängen, desto größer ist die Unsicherheit, ob sie korrekt gelesen werden (siehe [Google JavaScript SEO Grundlagen](https://developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics)).
**Behebung**: Bringen Sie die Kerninhalte ins initiale HTML – Server-Side Rendering, statische Generierung oder zumindest Titel, Haupttext und interne Links als echte Tags ausgeben. Der Test ist einfach: Schalten Sie JavaScript im Browser aus; die Seite muss weiterhin lesbar sein.
## Prüfung 2: Sind Title und Meta Description korrekt?

Bei KI-generierten Seiten fehlen am häufigsten Metadaten, weil sie visuell vollständig unsichtbar sind. Drei häufige Fehler:
- **Derselbe Title auf der gesamten Website**: Template-Variablen wurden nicht ersetzt; alle Seiten heißen „Startseite | Irgendein Tech-Unternehmen“.
- **Leere Description**: Google muss selbst Text aus dem Hauptinhalt auswählen; die Snippets wirken oft informationslos.
- **Zu langer Title**: Sehr lange Titel werden auf Mobilgeräten nach etwa 30 Zeichen abgeschnitten; das Verkaufsargument fällt weg.
```html
Unternehmenswebsite erstellen: Der komplette Ablauf von der Anforderung bis zum Launch | Markenname
Selbstcheck: Wählen Sie fünf Kernseiten (Startseite, Produktseite, Preisseite, Case-Study-Seite, Blogseite) und stellen Sie sicher, dass die Titles unterschiedlich sind und jeweils das Thema der Seite enthalten; die Description ist ein vollständiger Satz und keine Keyword-Aneinanderreihung.
Prüfung 3: Sind sitemap.xml und robots.txt wirklich nutzbar?
Diese beiden Dateien sind der Einstiegspunkt für Crawler und werden bei KI-Website-Buildern am ehesten übersehen – weil sie in der Oberfläche nicht existieren.
# https://www.example.com/robots.txt
User-agent: *
Disallow: /admin
Disallow: /preview
Disallow: /api
Allow: /

Sitemap: https://www.example.com/sitemap.xml
    https://www.example.com/pricing
    2026-03-01
Prüfen Sie drei Dinge: Die Domain in der sitemap muss die Produktionsdomain sein, nicht die Preview-Domain; per Disallow gesperrte Pfade dürfen nicht gleichzeitig in der sitemap stehen; die Zeile Sitemap: muss eine absolute Adresse enthalten.
Gleichzeitig müssen Sie die Grenzen von robots.txt kennen. Google weist im Indexierungsleitfaden darauf hin, dass robots.txt das Crawling steuert, aber kein zuverlässiges Mittel gegen Indexierung ist: Von robots.txt blockierte URLs können wegen externer Links trotzdem in Suchergebnissen erscheinen. Wenn eine Seite ausdrücklich nicht indexiert werden soll, verwenden Sie noindex (Robots-Meta-Tag oder X-Robots-Tag-Response-Header). Google hat im Oktober 2026 außerdem einen Abschnitt „Nur für die Suche bestimmte Inhalte indexieren“ ergänzt und empfiehlt, generierte Seiten, die nur für Sharing, Zusammenarbeit oder Tool-Ausgaben gedacht sind, standardmäßig nicht zu indexieren sowie Indexierungsauffälligkeiten über den Seitenindexierungsbericht und den Suchleistungsbericht in der Search Console zu beobachten (Details siehe Einordnung des Google-Indexierungsleitfaden-Updates).
Prüfung 4: Zeigt canonical auf diese Seite?
rel=canonical sagt Suchmaschinen, welche URL innerhalb einer Gruppe ähnlicher URLs die Hauptversion ist. Bei KI-Generierung treten drei Fehlertypen auf:
- Alle Seiten zeigen auf die Startseite – das sagt Google, jede Seite sei eine Kopie der Startseite.
- Der Verweis zeigt auf eine Preview- oder Testdomain; die Produktionsseite wird dadurch als Kopie behandelt.
- URLs mit Parametern und saubere URLs verweisen gegenseitig aufeinander, sodass Signale hin- und herspringen.
-
Richtig ist: canonical verwendet eine absolute HTTPS-Adresse und stimmt exakt mit der finalen URL überein, die indexiert werden soll (mit oder ohne abschließenden Schrägstrich – websiteweit einheitlich); mehrsprachige Websites lassen jede Sprachversion auf sich selbst verweisen und verknüpfen sie mit hreflang, statt sie gegenseitig per canonical auf die englische Version zu verweisen.
Prüfung 5: Enthalten strukturierte Daten falsche Informationen?

KI ist gut darin, strukturierte Daten zu „vervollständigen“ – und ebenso gut darin, nebenbei Fakten zu erfinden: nicht existierende Bewertungen, fehlende Preisspannen, fiktive Gründungsjahre. All das verletzt die Grundanforderung an strukturierte Daten: Die Daten müssen mit dem sichtbaren Seiteninhalt übereinstimmen.
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "Markenname",
  "url": "https://www.example.com/",
  "logo": "https://www.example.com/logo.png"
}
Die Regel lautet: lieber weniger als zu viel. Schreiben Sie nur Felder, die auf der Seite sichtbar sind; löschen Sie unsichere Gründungsdaten, Bewertungen und Lagerstatus; testen Sie vor der Veröffentlichung mit einem Tool für strukturierte Daten, ob Parsing-Fehler vorliegen.
Prüfung 6: Blockieren Formulare, Pop-ups und Interaktionen den Crawler?
Formulare selbst beeinflussen die Indexierung nicht; das Problem ist, dass sie oft den Haupttext „ersetzen“: Die ganze Seite besteht nur aus einem Lead-Formular, Inhalte sind hinter einem Login gesperrt, beim ersten Bildschirm erscheint ein Vollbild-Pop-up mit Cookie-Zustimmung. Für Crawler fehlt solchen Seiten der Text, mit dem Suchintentionen abgeglichen werden können.
Außerdem erzeugen KI-Website-Builder häufig viele „Einweg“-Seiten – Erfolgsseiten nach Formularabsendung, Angebotsergebnisseiten, Share-Links. Werden solche Seiten indexiert, verwässern sie die Qualität der Website. Nach Googles Empfehlung ist es sicherer, sie standardmäßig auf noindex zu setzen (Einordnung des Indexierungsleitfadens); echte, auf Suche ausgerichtete Landingpages sollten dagegen vollständigen sichtbaren HTML-Haupttext behalten und nicht erst nach einem Klick entfalten.
Erstelle in Minuten eine Showcase-Website und gewinne Leads
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Prüfung 7: Werden SEO-Einstellungen beim nächsten KI-Umbau zurückgesetzt?
Das ist das am meisten unterschätzte Risiko von KI-Website-Buildern: Seiten werden laufend generiert. Title, canonical und robots-Regeln, die heute manuell ergänzt wurden, können morgen bei einer Neugenerierung mit „Ändere bitte die Farben und optimiere nebenbei die Texte“ überschrieben werden.
Sinnvoll ist eine Prozessvorgabe statt Verlass auf das Gedächtnis:
- SEO-relevante Einstellungen in Templates oder globaler Konfiguration zentralisieren und weniger pro Seite manuell schreiben;
- nach jeder Neugenerierung die Checkliste durchlaufen, mindestens für Startseite, Produktseite und Preisseite;
- auf anomalies Wachstum der URL-Anzahl achten: Template-Änderungen oder neue Funktionen erzeugen oft massenhaft neue URLs; Google empfiehlt, sowohl die Inhaltserstellung als auch die Indexierungsmenge auf Plattformseite zu überwachen (ebd.);
- vor dem Launch fest einen „Einstellungs-Diff“ durchführen: Title, canonical, robots und sitemap mit der letzten veröffentlichten Version vergleichen.
Prüfung 8: Warum sich dieser Aufwand lohnt
Technisches SEO ist kein Nischenthema. Laut Mordor Intelligence betrug der Markt für technische SEO-Dienstleistungen 2025 1,573 Mrd. USD und soll von 1,689 Mrd. USD im Jahr 2026 auf 2,837 Mrd. USD im Jahr 2031 wachsen, mit einer durchschnittlichen jährlichen Wachstumsrate von etwa 10,93 % zwischen 2026 und 2031; die Kategorie technisches SEO machte 2025 32,41 % aus. Der Grund: Rendering, Seitenstruktur, Weiterleitungen, strukturierte Daten und Seitenleistung entscheiden direkt darüber, ob Inhalte in großem Maßstab entdeckt und abgerufen werden können. Der Bericht weist außerdem darauf hin, dass Google Core Web Vitals weiterhin in die Suchbewertung einbezieht (Daten siehe Marktbericht Technical SEO Services). Anders gesagt: Die Veröffentlichung der Seite ist nur der Anfang; ob sie gecrawlt, verstanden und zitiert werden kann, ist die Eintrittskarte im Zeitalter von Suche und KI-Suche.
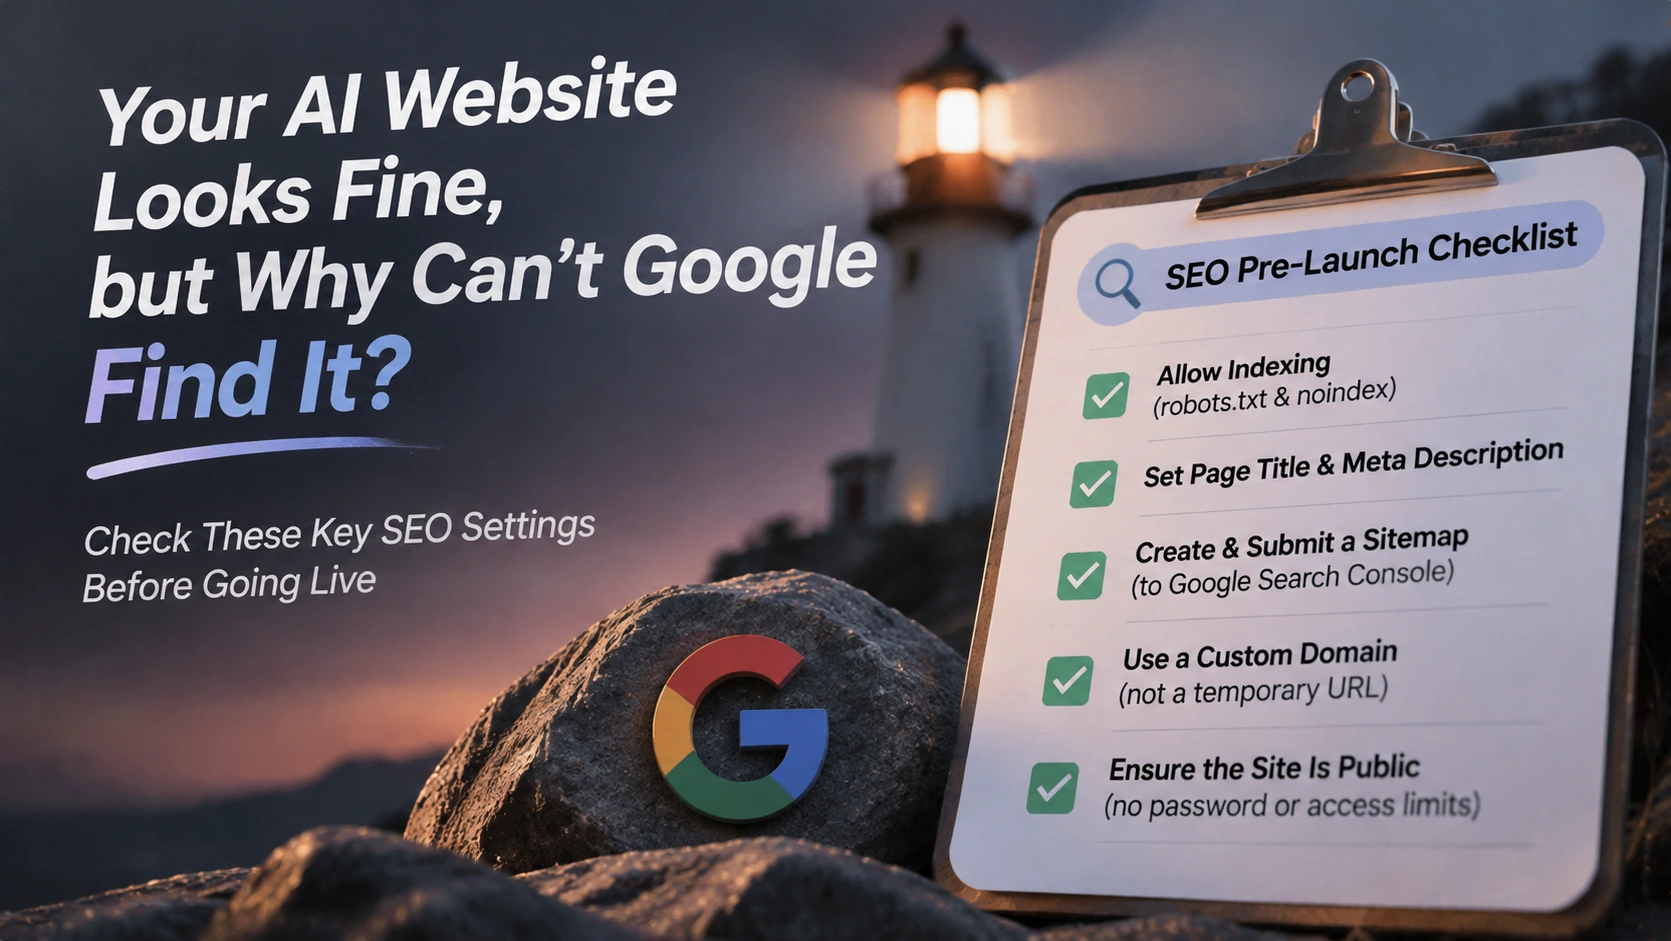
10-Punkte-SEO-Checkliste vor dem Launch einer KI-Website
| # | Prüfpunkt | Bestehenskriterium |
|---|---|---|
| 1 | Initiales HTML | Nach Deaktivieren von JS sind Titel und Haupttext weiterhin sichtbar |
| 2 | HTTP-Status | Kernseiten liefern 200, alte Adressen leiten per 301 auf neue Adressen weiter |
| 3 | Title | Pro Seite eindeutig, enthält das Thema, Länge kontrolliert |
| 4 | Meta Description | Pro Seite eigenständig, vollständiger Satz |
| 5 | robots.txt | Blockiert nur Backend- und Preview-Pfade; Sitemap als absolute Adresse |
| 6 | sitemap.xml | Enthält nur die Produktionsdomain und indexierbare Seiten |
| 7 | canonical | Zeigt auf die eigene Produktions-URL; websiteweite Schrägstrich-Regel einheitlich |
| 8 | noindex | Preview-Site, Ergebnisseiten und Share-Seiten standardmäßig nicht indexieren |
| 9 | Strukturierte Daten | Nur sichtbare Felder, keine Parsing-Fehler |
| 10 | Interaktionen und Formulare | Haupttext wird nicht von Pop-ups, Login-Wänden oder Formularen verdrängt |
Der Wert dieser Tabelle liegt nicht in „fortgeschrittenen Tricks“, sondern in der Wiederholbarkeit: Vor jeder Veröffentlichung einmal durchgehen; zehn Minuten verhindern die meisten Fälle von „fertig, aber nicht auffindbar“.
Was Unternehmen jetzt tun sollten
Wenn Sie eine Website mit KI-Tools erstellen, ändern Sie die Reihenfolge: Zuerst Struktur und Inhalte generieren, dann Metadaten und Indexierungsregeln ergänzen, schließlich eine einheitliche Prüfung vor der Veröffentlichung durchführen. Plattformen wie We0 bringen Seitengenerierung, CMS-Backend, Domain-Deployment und SEO/GEO-Konfiguration bereits in einer Kette zusammen (siehe We0 Website). Die schnelle Generierung ändert aber eine Voraussetzung nicht: Suchmaschinen erkennen nur das, was tatsächlich im HTML ausgegeben wird; ein Praxistest nach dem Launch bleibt daher unverzichtbar.
Drei konkrete Schritte: Prüfen Sie zuerst mit curl das initiale HTML, bestätigen Sie dann in der Search Console Crawling- und Indexierungsstatus, und machen Sie schließlich die oben genannten 10 Punkte zu einem festen Bestandteil vor jeder Veröffentlichung und dokumentieren Sie sie im Launch-Prozess des Teams.
FAQ
F: Entsprechen KI-generierte Websites von Natur aus nicht den SEO-Anforderungen?
Nein. KI-Generierung ist nur die Art der Erstellung; das Problem ist, dass der Generierungsprozess standardmäßig darauf achtet, ob die Seite „richtig aussieht“, aber nicht prüft, „was die Suchmaschine liest“. Solange das initiale HTML Haupttext enthält und Metadaten sowie Indexierungsregeln korrekt sind, gibt es zwischen KI-Website-Buildern und manuell erstellten Websites keinen grundsätzlichen Unterschied in der Suchperformance.
F: Wenn eine Seite bei Google nicht gefunden wird, wurde sie abgestraft?
In den meisten Fällen ist es noch nicht einmal eine „Abstrafung“, sondern die Seite wurde noch nicht gecrawlt oder indexiert. Prüfen Sie zuerst den Indexierungsstatus, dann, ob robots.txt oder noindex blockieren, und erst danach Inhaltsqualität und Wettbewerb.
F: Garantiert die Einreichung einer sitemap die Indexierung?
Nein. Eine sitemap ist ein Entdeckungshinweis, kein Indexierungsversprechen; sie hilft Crawlern, schneller zu erfahren, welche Seiten existieren. Ob eine Seite indexiert wird, hängt von Crawling-Zugriff, Inhaltsqualität und Indexierungsregeln ab.
F: Kann Google Seiten, die per JavaScript gerendert werden, auf keinen Fall lesen?
Nicht unbedingt, aber die Unsicherheit ist höher. Rendering benötigt zusätzliche Ressourcen, und je stärker eine Seite von Skripten abhängt, desto geringer ist die Wahrscheinlichkeit, dass Text und Links im ersten Bildschirm korrekt gelesen werden. Kerninhalte ins initiale HTML zu legen, ist die günstigste Versicherung.
F: Wie lange dauert es, bis Ergebnisse sichtbar sind?
Für Indexierung und Ranking gibt es keinen einheitlichen Zeitplan; er hängt von Crawling-Frequenz, Website-Größe und Wettbewerb ab. Sicher ist: Fehlerhafte Einstellungen wirken so lange, bis Sie sie entdecken und korrigieren.
Verwandte Tools
- Google Search Console: Seitenindexierungsbericht und Suchleistung prüfen
- Google-JavaScript-SEO-Dokumentation: tatsächliche Regeln für Rendering und Crawling bestätigen
curl/ Browser-Entwicklertools: initiales HTML und Lesbarkeit nach Deaktivierung von JS prüfen- Tool zum Testen strukturierter Daten: prüfen, ob JSON-LD parsbar ist
Verwandte Links
- Google JavaScript SEO Grundlagen
- Einordnung des Google-Indexierungsleitfaden-Updates: teilbare Seiten und generierte Inhalte
- Marktgröße und Trends für Technical SEO Services
- We0 Website
Zusammenfassung
KI-Website-Builder machen den Launch schneller, ändern aber nicht die Arbeitsweise von Suchmaschinen: Sie lesen HTML, Response-Header und Linkstrukturen – nicht das Effektbild auf Ihrem Bildschirm. Prüfen Sie vor dem Launch diese sieben Stellen – initiales HTML, Title und Description, robots.txt und sitemap, canonical, noindex, strukturierte Daten sowie Formulare und Interaktionen – und verankern Sie sie als Prozess. So wird aus „Website fertig, aber kein Traffic“ ein reproduzierbar prüfbares Problem statt eines Dauerzustands.