Ein praxisnaher Preisleitfaden für wichtige KI-Modelle und Abonnements im September 2026. Vergleichen Sie Verbrauchertarife, Coding-/Token-T...
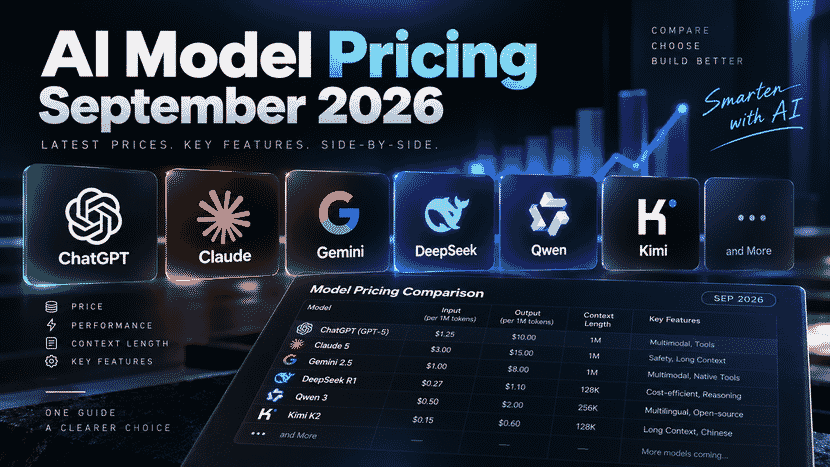
Der Vergleich von KI-Preisen wirkt einfach – bis drei vollständig unterschiedliche Abrechnungsmodelle in derselben Tabelle nebeneinanderstehen.
Das erste Modell ist das Abonnement einer Verbraucher-App. Sie zahlen monatlich für eine sofort nutzbare Oberfläche mit Funktionen wie Chat, Suche, Dateiverarbeitung, Recherche, Präsentationen, Memory und Agent-Workflows.
Das zweite Modell ist ein Coding- oder Token-Tarif. Auch hier wird normalerweise monatlich abgerechnet. Das Geld kauft jedoch ein Kontingent oder Guthaben, das häufig auf die offiziellen Coding-Tools, Agent-Produkte oder unterstützten Integrationen eines Anbieters beschränkt ist.
Das dritte Modell ist die nutzungsabhängige API-Abrechnung. Sie zahlen für Eingabe- und Ausgabetoken. Dies ist der übliche Weg, wenn das Modell in Ihr eigenes Produkt, eine Anwendung, ein Backend oder einen kundenorientierten Dienst integriert werden soll.
Alle drei Konten können mehrere Dutzend oder mehrere Hundert US-Dollar pro Monat kosten, sind aber nicht austauschbar.
Ein ChatGPT-Abonnement umfasst keine gewöhnliche Nutzung der OpenAI-API. Ein Coding-Tarif kann für einen Entwickler günstiger sein als eine API-Abrechnung, ist aber möglicherweise für einen Produktionsdienst ungeeignet. Eine API kann pro Million Token teuer erscheinen, aber die einzige Option sein, die einem Unternehmen die benötigte Parallelität, Überwachung, Rechnungsstellung und Integrationskontrolle bietet.
Dieser Leitfaden behält die Struktur des ursprünglichen Artikels bei und macht die verstreuten Preisinformationen zu einer einkaufsfreundlicheren Referenz.
Preishinweis: Preise ändern sich häufig. Einige Tarife sind regional, werblich oder vorübergehend nicht verfügbar. Die folgenden Tabellen spiegeln den Preisstand vom 18.–20. September 2026 wider und wurden, soweit verfügbar, mit offiziellen Preisseiten abgeglichen.
Verbraucherabonnements sind die einfachste Option, wenn eine Person lediglich die offizielle Anwendung nutzen möchte.
| Anbieter | Kostenloser Tarif | Einstiegstarif | Haupttarif | Höchster individueller Tarif |
|---|---|---|---|---|
| OpenAI ChatGPT | Kostenlos | Go 8 $/Monat in den USA | Plus 20 $/Monat | Pro 100 $; Pro 200 $ für bestehende Abonnenten |
| Anthropic Claude | Kostenlos | Pro 20 $/Monat oder 200 $/Jahr | Max 5x 100 $/Monat | Max 20x 200 $/Monat |
| Google Gemini | Kostenlos | AI Plus, regionale Preise | AI Pro 19,99 $/Monat in den USA | AI Ultra 99,99 $/Monat in den USA |
| xAI Grok | Kostenlos | – | SuperGrok 30 $/Monat | SuperGrok Plus 100 $/Monat |
| Perplexity | Kostenlos | Bildungs-/Rabattarife, sofern berechtigt | Pro | Max |
OpenAI bietet derzeit die Verbrauchertarife Free, Go, Plus und Pro an.
In den Vereinigten Staaten gelten folgende Preise:
Es gibt einen wichtigen Vorbehalt für September 2026: OpenAI hat am 10. September vorübergehend neue Anmeldungen und Upgrades auf Pro 200 $ ausgesetzt. Bestehende Pro-Abonnenten für 200 $ sind nicht betroffen, und Pro für 100 $ bleibt verfügbar.
Nutzer von Free und Go verwenden derzeit GPT-5.6 Luna für das standardmäßige ChatGPT-Erlebnis. Berechtigte kostenpflichtige Tarife ermöglichen den Zugriff auf GPT-5.6 Sol. GPT-6 Pro, betrieben durch GPT-6 Astra, ist in berechtigten Pro-, Business- und Enterprise-Tarifen verfügbar.
Die Preise für Claude für Einzelpersonen sind übersichtlich:
Pro umfasst Claude Code, Cowork, Design und einen umfassenderen Modellzugriff. Die Max-Tarife erhöhen vor allem die Nutzungslimits und den bevorzugten Zugriff.
Die Preise für Google AI variieren je nach Markt. Auf der aktuellen US-Preisseite werden folgende Preise aufgeführt:
Google AI Plus ist als niedrigerer Tarif verfügbar. Der angezeigte Preis kann jedoch je nach Land variieren und wird nicht auf jeder regionalen Preisseite einheitlich dargestellt.
Die Tarife bündeln den Gemini-Zugriff mit Google-Speicher und weiteren Google-Diensten. Daher sollten sie nicht als reine Token-Abonnements verglichen werden.
Auf der aktuellen Verbraucher-Preisseite von xAI werden folgende Tarife aufgeführt:
Dies unterscheidet sich von älteren Tarifnamen und Preisen, die weiterhin online kursieren. Für Kaufentscheidungen sollte die aktuelle Preisseite von xAI verwendet werden, nicht eine alte Vergleichstabelle.
Für die Produktintegration sind API-Preise wichtiger als Verbraucherabonnements.
Die folgende Tabelle zeigt die üblichen Preise für kurze Kontexte, die für eine normale API-Beschaffung besonders relevant sind.
| Anbieter | Modell | Eingabe | Zwischengespeicherte Eingabe | Ausgabe |
|---|---|---|---|---|
| OpenAI | GPT-6 Astra | 10,00 $ | 1,00 $ | 50,00 $ |
| OpenAI | GPT-5.6 Sol | 4,00 $ | 0,40 $ | 20,00 $ |
| OpenAI | GPT-5.6 Terra | 2,00 $ | 0,20 $ | 12,00 $ |
| OpenAI | GPT-5.6 Luna | 0,20 $ | 0,02 $ | 1,20 $ |
| Anthropic | Claude Fable 5.1 | 10,00 $ | 0,25 $ | 50,00 $ |
| Anthropic | Claude Opus 5 | 5,00 $ | 0,50 $ | 25,00 $ |
| Anthropic | Claude Sonnet 5 | 2,00 $ | 0,20 $ | 10,00 $ |
| Anthropic | Claude Haiku 4.5 | 1,00 $ | 0,10 $ | 5,00 $ |
| Gemini 3.5 Flash | 1,50 $ | 0,15 $ | 9,00 $ | |
| Gemini 3.1 Pro Preview (unter 200K Eingabe) | 2,00 $ | – | 12,00 $ | |
| Gemini 3.8 Flash Einführungspreis | 0,75 $ | 0,075 $ | 3,75 $ | |
| xAI | Grok 4.6 | 2,00 $ | 0,50 $ | 6,00 $ |
| xAI | Grok 4.3 | 1,25 $ | 0,20 $ | 2,50 $ |
Die OpenAI-Tabelle des Ausgangsartikels stimmt im Wesentlichen mit den aktuellen offiziellen Preisen überein.
Die aktuellen Standardpreise für kurze Kontexte lauten:
GPT-6 Astra      10 $ Eingabe / 50 $ Ausgabe
GPT-5.6 Sol      4 $ Eingabe  / 20 $ Ausgabe
GPT-5.6 Terra    2 $ Eingabe  / 12 $ Ausgabe
GPT-5.6 Luna     0,20 $ Eingabe / 1,20 $ Ausgabe
Diese Preise gelten pro 1 Million Token.
Der Preis von 4 $/20 $ für GPT-5.6 Sol ist ein Aktionspreis und gilt mindestens bis zum 21. November 2026. Anfragen mit langen Kontexten können ebenfalls anders bepreist werden. Eine Beschaffungstabelle sollte daher nicht davon ausgehen, dass jede Anfrage zum Preis für kurze Kontexte abgerechnet wird.
Die aktuellen Preise von Anthropic für die direkte Nutzung lauten:
Claude Fable 5.1   10 $ Eingabe / 50 $ Ausgabe / 0,25 $ Cache-Treffer
Claude Opus 5      5 $ Eingabe  / 25 $ Ausgabe / 0,50 $ Cache-Treffer
Claude Sonnet 5    2 $ Eingabe  / 10 $ Ausgabe / 0,20 $ Cache-Treffer
Claude Haiku 4.5   1 $ Eingabe  / 5 $ Ausgabe  / 0,10 $ Cache-Treffer
Eine wichtige Korrektur gegenüber älteren Vergleichstabellen lautet: Cache-Treffer bei Fable 5.1 kosten 0,25 $ pro Million Token, nicht 1,00 $.
Anthropic bietet außerdem Rabatte für Batch-Verarbeitung und separate Preise für das Schreiben in den Cache an. Daher können sich die effektiven Kosten eines Agent-Workloads mit langem Kontext deutlich von den angegebenen Preisen für Eingabe und Ausgabe unterscheiden.
Gemini 3.8 Flash kostet derzeit:
0,75 $ / 1 Mio. Eingabetoken
0,075 $ / 1 Mio. zwischengespeicherte Eingabetoken
3,75 $ / 1 Mio. Ausgabetoken
Der Einführungspreis gilt bis zum 31. Dezember 2026. Google gibt an, dass ab dem 1. Januar 2027 die Standardpreise von 1,50 $ für Eingaben und 7,50 $ für Ausgaben gelten.
Gemini 3.5 Flash kostet weiterhin 1,50 $ für Eingaben und 9,00 $ für Ausgaben.
Die aktuellen Preise für kurze Kontexte lauten:
Grok 4.6   2,00 $ Eingabe / 0,50 $ Cache / 6,00 $ Ausgabe
Grok 4.3   1,25 $ Eingabe / 0,20 $ Cache / 2,50 $ Ausgabe
xAI berechnet für sehr lange Kontexte bei Grok 4.6 und verwandten Modellen höhere Preise. Teams, die mehrere Hunderttausend Token pro Anfrage verwenden, sollten die Kosten für lange Kontexte daher separat kalkulieren.
Der chinesische Markt kombiniert kostenlose Verbraucher-Apps, Office-Abonnements, Agent-Tarife und Coding-Abonnements.
Der ursprüngliche Artikel gruppiert die wichtigsten Produkte wie folgt.
| Produkt | Preisstand der Quelle | Wichtigstes aktuelles Modell / Positionierung | Modelle von Drittanbietern |
|---|---|---|---|
| Kimi | Kostenlos sowie Tarife für 49 ¥ / 99 ¥ / 199 ¥ / 699 ¥ | Kimi-K3-Familie und Kimi Work | Vorwiegend Kimi-Modelle |
| Qwen-Office-Produkte | Kostenlos sowie kostenpflichtige Office-Tarife | Qwen3.8-Familie | Einige Produkte stellen Modelle von Drittanbietern bereit |
| Doubao | Kostenlos sowie Tarife für 68 ¥ / 200 ¥ / 500 ¥ im Preisstand der Quelle | Doubao-Seed-2.1-Familie | DeepSeek in ausgewählten Agent-Workflows verfügbar |
| Zhipu Qingyan | Kostenlos sowie kostenpflichtige fortlaufende Abonnements | GLM-5.3-Familie | Vorwiegend GLM-Modelle |
| MiniMax Token Plan | 49 ¥ / 119 ¥ / 469 ¥ | MiniMax-M3-/M2.x-Familien | Vorwiegend MiniMax-Modelle |
| DeepSeek | Kostenlos im Web und in der App | DeepSeek V4.1 Flash / V4 Pro | Keine allgemeine Auswahl von Drittanbietern |
| Tencent Yuanbao | Kostenlos | Hunyuan + DeepSeek | DeepSeek neben Hunyuan verfügbar |
Die wichtigste Kaufunterscheidung ist einfach:
Da sich die Preise für Verbraucher-Apps durch Aktionen, App-Store-Abrechnung, Region und Kontoberechtigung ändern, sollten die Abonnementbeträge des Ausgangsartikels eher als Preisstand für September 2026 und nicht als dauerhafte Preisliste verstanden werden.
API-Abrechnungen lassen sich leichter vergleichen, weil die Einheit standardisiert ist.
Die folgende Tabelle behält die ursprüngliche Struktur bei und korrigiert sie dort, wo sich die aktuellen offiziellen Seiten geändert haben.
| Anbieter | Modell | Eingabe | Ausgabe | Zwischengespeicherte Eingabe |
|---|---|---|---|---|
| DeepSeek | deepseek-flash / V4.1 Flash, Nebenzeiten | 1 ¥ | 4 ¥ | 0,02 ¥ |
| DeepSeek | deepseek-flash / V4.1 Flash, Spitzenzeiten | 2 ¥ | 8 ¥ | 0,04 ¥ |
| DeepSeek | deepseek-v4-pro, Nebenzeiten | 4,5 ¥ | 13,5 ¥ | 0,15 ¥ |
| DeepSeek | deepseek-v4-pro, Spitzenzeiten | 9 ¥ | 27 ¥ | 0,30 ¥ |
| Alibaba Qwen | qwen3.8-flash | 0,8 ¥ | 2,7 ¥ | 0,1 ¥ |
| Alibaba Qwen | qwen3.8-max | 12 ¥ | 36 ¥ | 1,5 ¥ |
| Alibaba Qwen | qwen3.7-flash 0–32K | 0,2 ¥ | 0,8 ¥ | 0,04 ¥ |
| Kimi | Kimi K3 | 20 ¥ | 100 ¥ | 2 ¥ |
| ByteDance | Doubao Seed 2.1 Pro | 6 ¥ | 30 ¥ | 1,2 ¥ laut den zitierten Anbieterpreisen |
| Tencent | Hy4 Preview | 6 ¥ | 18 ¥ | 0,3 ¥ |
| Zhipu | GLM-5.3 | etwa 8–10 ¥ je nach Plattform/Kanal | etwa 28–32 ¥ | plattformabhängig |
| Zhipu | GLM-5.3 Flash | etwa 0,8–1,1 ¥ | etwa 2,8–3,6 ¥ | plattformabhängig |
| MiniMax | MiniMax-M3, bis zu 512K Eingabe | 2,1 ¥ | 8,4 ¥ | 0,42 ¥ auf Tencent TokenHub |
DeepSeek V4.1 Flash ist nun das Modell hinter deepseek-flash.
Die aktuellen offiziellen Preise lauten:
Nebenzeiten:
  Cache-Treffer   0,02 ¥ / 1 Mio. Eingabetoken
  Cache-Fehlversuch  1,00 ¥ / 1 Mio. Eingabetoken
  Ausgabe        4,00 ¥ / 1 Mio. Token

Spitzenzeiten:
  Cache-Treffer   0,04 ¥ / 1 Mio. Eingabetoken
  Cache-Fehlversuch  2,00 ¥ / 1 Mio. Eingabetoken
  Ausgabe        8,00 ¥ / 1 Mio. Token
Die aktuellen Spitzenzeiten von DeepSeek gelten montags bis freitags von 09:00–12:00 Uhr und 14:00–18:00 Uhr Pekinger Zeit. In allen anderen Zeiträumen gilt der Preis für Nebenzeiten.
In der offiziellen Dokumentation steht außerdem, dass die veralteten Modellnamen V4 Flash und V4 Flash Vision Exp nun an V4.1 Flash weiterleiten.
Qwen3.8-Max kostet derzeit:
12 ¥ / 1 Mio. Eingabetoken
1,5 ¥ / 1 Mio. zwischengespeicherte Eingabetoken
36 ¥ / 1 Mio. Ausgabetoken
Qwen3.8-Flash kostet derzeit:
0,8 ¥ / 1 Mio. Eingabetoken
0,1 ¥ / 1 Mio. zwischengespeicherte Eingabetoken
2,7 ¥ / 1 Mio. Ausgabetoken
Qwen3.7-Flash verwendet eine gestaffelte Preisstruktur nach Eingabelänge. Ein einfacher Eingabepreis kann daher bei großen Kontexten irreführend sein.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Tencent Cloud TokenHub führt derzeit mehrere Modelle nebeneinander auf, darunter:
Hy4 Preview        6 ¥ Eingabe / 18 ¥ Ausgabe / 0,3 ¥ Cache
DeepSeek V4.1      1–2 ¥ Eingabe / 4–8 ¥ Ausgabe / 0,02–0,04 ¥ Cache
GLM-5.3            ~10,08 ¥ Eingabe / ~31,67 ¥ Ausgabe
Kimi K3            ~21,97 ¥ Eingabe / ~109,87 ¥ Ausgabe
MiniMax-M3         2,1 ¥ Eingabe / 8,4 ¥ Ausgabe bei <=512K Eingabe
Dies ist für Vergleiche nützlich, stimmt aber nicht immer mit der direkten Preisgestaltung der jeweiligen Anbieter überein. Ein Beschaffungsteam sollte vor dem Preisvergleich entscheiden, ob es direkte Verträge mit Anbietern, einen Cloud-Marktplatz oder ein Gateway für mehrere Modelle nutzen möchte.
Coding-Tarife sind attraktiv, weil sie einer einzelnen Person bei interaktiver Arbeit deutlich mehr Nutzung ermöglichen können als eine gewöhnliche API-Abrechnung.
Die Einschränkung ist ebenso wichtig: Das Kontingent ist häufig an unterstützte Coding-Produkte oder Agent-Tools gebunden.
Der Preisstand des Ausgangsartikels für September umfasst:
| Plattform | Preise laut Preisstand der Quelle | Typische Kontingentstruktur | Einschränkungen |
|---|---|---|---|
| Alibaba Model Studio Token Plan | Lite 39 ¥ / Standard 139 ¥ / Pro 499 ¥ | Wöchentliche Guthaben | Agent-Parallelität je nach Tarif |
| Zhipu GLM Coding Plan | Lite 118 ¥ / Pro 538 ¥ / Max 1.078 ¥ | Wöchentliche / fünfstündige Zeitfenster | Einschränkungen für API-Schlüssel und Sitze |
| Baidu Qianfan Token Plan | Mini / Lite / Pro / Max | Monatliche Token-Pools | Produktspezifische Regeln |
| Tencent Cloud Token Plan | Hy Lite 28 ¥ / Standard 78 ¥ / Pro 238 ¥ / Max 468 ¥ | Guthaben für den Abonnementmonat | Einschränkungen für persönliche Tarifschlüssel |
| MiniMax Token Plan | 49 ¥ / 119 ¥ / 469 ¥ | Agent-orientiertes Kontingent | Limits für parallele Agenten |
| Kimi Code | Im Preisstand der Quelle in berechtigten Kimi-Mitgliedschaften enthalten | Gemeinsame + wöchentliche Limits | An die Mitgliedschaft gebunden |
| ByteDance Trae | Kostenlos bis zu Ultra-Tarifen | Monatliche Guthaben | Parallelität von Cloud-Aufgaben je nach Tarif |
| Tencent CodeBuddy | Kostenlos bis zu Spitzentarifen | Monatliche Guthaben | Gemeinsames Guthaben mit verwandten Produkten |
Die genauen Beträge und Aktionsrabatte können sich schnell ändern. Coding-Tarife sollten daher unmittelbar vor dem Kauf geprüft werden.
Dies ist der wichtigste Beschaffungshinweis des Ausgangsartikels.
Ein Coding-Abonnement ist normalerweise ausgelegt für:
Es ist normalerweise nicht ausgelegt für:
Der Versuch, einen persönlichen Coding-Tarif als Ersatz für eine Produktions-API zu verwenden, führt häufig zu Kontobeschränkungen, Ratenlimits und Lizenzproblemen.
Der einfachste Weg, Beschaffungsfehler zu vermeiden, besteht darin, vor dem Preisvergleich zu entscheiden, zu welchem Abrechnungsmodell der Workload gehört.
Der Ausgangsartikel widmet NoneLinear einer werblichen Passage. Dabei handelt es sich um eine chinesische Aggregationsplattform, die Preise für internationale Modelle in Renminbi umrechnet und mehrere Anbieterprotokolle über ein Gateway verfügbar macht.
Die praktische Kategorie ist auch dann relevant, wenn Sie diesen konkreten Anbieter nicht nutzen.
Ein Modellaggregator kann den operativen Aufwand reduzieren durch:
Der effektive Preis ist jedoch nicht der einzige Prüfpunkt.
Prüfen Sie vor der Nutzung eines Aggregators:
Der Ausgangsartikel sagt, dass der hervorgehobene Aggregator OpenAI-, Anthropic- und Gemini-kompatible Protokolle sowie eine Token-Abrechnung pro Anfrage unterstützt. Dies sind nützliche Funktionen. Beschaffungsteams sollten den aktuellen Vertrag und die Sicherheitsbedingungen des Anbieters dennoch direkt prüfen und den Artikel nicht als Empfehlung verstehen.
Ein niedriger Tokenpreis ist irrelevant, wenn der Dienst nicht gekauft, abgerechnet, integriert oder gemäß den Compliance-Regeln des Unternehmens betrieben werden kann.
Der Ausgangsartikel hebt vier weitere Beschaffungsdimensionen hervor.
Viele chinesische Plattformen von Modellanbietern verlangen eine Echtnamen- oder Unternehmensprüfung, bevor API-Schlüssel, Aufladungen oder bestimmte Modelle verfügbar werden.
Eine persönliche Verifizierung und eine Rechnung für ein Unternehmen sind nicht immer austauschbar.
Ein Unternehmen, das eine Firmenrechnung benötigt, sollte klären, ob das Konto vor Beginn der Nutzung in eine Unternehmenseinheit umgewandelt werden muss.
Prüfen Sie, ob der Anbieter Folgendes unterstützt:
Ein günstigeres Modell mit geringer Parallelität kann betrieblich teurer sein als ein höherpreisiges Modell, das die Anforderungen der Anwendung an Latenz und Durchsatz erfüllt.
Für Produktions-Workloads sollten Sie immer Folgendes prüfen:
| Ihre Situation | Abrechnungsmodell für den Einstieg | Drei zuerst zu prüfende Punkte |
|---|---|---|
| Alltagstauglicher Chat, Dokumente, Recherche | App-Abonnement | Ob der kostenlose Tarif ausreicht; ob kostenpflichtige Funktionen zu den wiederkehrenden Aufgaben passen; Kündigungsbedingungen |
| Einzelne Entwicklerin oder einzelner Entwickler mit moderater Coding-Nutzung | Coding-/Token-Tarif | Fünfstunden- und Wochenlimits; Agent-Parallelität; ob die Nutzung auf genehmigte Tools beschränkt ist |
| Produktintegration mit echten Nutzern | Nutzungsabhängige API | Ausgabepreis; Wirtschaftlichkeit von Cache-Treffern; Ratenlimits und Parallelität |
| Internationale Modelle aus dem chinesischen Festland benötigen | Direkte internationale Abrechnung oder konformer Aggregator | Preissynchronisierung; Währungsumrechnung; Abrechnung pro Anfrage und Datenbedingungen |
| Agent-Workloads mit hohem Volumen | API + Cache-Optimierung | Preis für zwischengespeicherte Eingaben; Kontextlänge; Nutzung von Ausgabetoken |
| Unternehmensbeschaffung | Direkter Unternehmensvertrag oder genehmigter Cloud-Marktplatz | SLA, Rechnungsstellung, Bedingungen zur Datenverarbeitung, Support |
Die Einkaufsregel ist eindeutig:
Wählen Sie zuerst das Abrechnungsmodell und vergleichen Sie erst danach Preise innerhalb dieses Modells.
Wenn Sie Verbraucherabonnements, Coding-Kontingente und Produktions-APIs in ein gemeinsames Ranking aufnehmen, ist die günstigste Zahl häufig bedeutungslos.
Für gelegentliche persönliche Nutzung ist ein kostenloser Verbrauchertarif normalerweise am günstigsten. Für Produktionsintegrationen hängt die günstigste Option von Eingabelänge, Ausgabelänge, Cache-Trefferquote, Parallelität und der Fähigkeit des Modells ab, eine Aufgabe ohne Wiederholungsversuche abzuschließen.
Nein. ChatGPT Plus ist ein Verbraucherabonnement, während die Nutzung der OpenAI-API separat abgerechnet wird. Diese grundsätzliche Trennung gilt für die meisten KI-Anbieter.
Für eine einzelne Entwicklerin oder einen einzelnen Entwickler, die oder der unterstützte Coding-Tools intensiv nutzt, kann dies der Fall sein. Coding-Tarife haben jedoch normalerweise Zeitfenster, Parallelitätslimits, Guthabenpools und Einschränkungen, die sie für einen kundenorientierten Produktionsdienst ungeeignet machen.
Lang laufende Agenten senden System-Prompts, Anweisungen, Repository-Kontext und frühere Gesprächszustände wiederholt. Wenn ein großer Teil dieses Kontexts zwischengespeichert werden kann, kann der Preis für zwischengespeicherte Eingaben zu einem der wichtigsten Kostentreiber werden.
DeepSeek verwendet für V4.1 Flash und V4 Pro eine zeitabhängige Preisgestaltung. Flexible Batch- oder Offline-Workloads können Geld sparen, wenn sie außerhalb der festgelegten Spitzenzeiten ausgeführt werden.
Ja, bis zum 31. Dezember 2026. Google bezeichnet dies als Einführungspreis und gibt an, dass der Standardpreis ab dem 1. Januar 2027 auf 1,50 $ für Eingaben und 7,50 $ für Ausgaben pro Million Token steigen soll.
Bestehende Abonnements von Pro für 200 $ laufen weiter. OpenAI hat jedoch am 10. September 2026 vorübergehend neue Anmeldungen und Upgrades auf den Tarif für 200 $ ausgesetzt. Pro für 100 $ bleibt verfügbar.
Dies kann die Abrechnung und den Zugriff auf mehrere Modelle vereinfachen. Die Entscheidung sollte jedoch von Sicherheit, Bedingungen zur Datenspeicherung, Rechnungsstellung, SLA, Transparenz beim Routing sowie der Frage abhängen, ob der Anbieter Preise und Modellverhalten des ursprünglichen Anbieters korrekt weitergibt.
Vergleiche von KI-Preisen werden erst sinnvoll, wenn drei unterschiedliche Produkte getrennt werden: Verbraucherabonnements, Coding-/Token-Tarife und Produktions-APIs. Ein App-Abonnement für 20 $, ein Coding-Tarif für 139 ¥ und eine API-Abrechnung pro Token lösen unterschiedliche Beschaffungsprobleme.
Bei APIs sind Ausgabetoken und zwischengespeicherte Eingaben häufig wichtiger als der ausgewiesene Eingabepreis. Bei Coding-Tarifen zählen Kontingentfenster und Tool-Einschränkungen. Bei der Unternehmensbeschaffung können Abrechnungseinheit, Rechnungsunterstützung, Parallelität, SLA und Datenbedingungen ebenso wichtig sein wie die Tokenkosten.
Der ursprüngliche Vergleich vom 18. September sollte als richtungsweisend verstanden werden. Mehrere Preise und Angaben zur Verfügbarkeit müssen jedoch live geprüft werden – insbesondere Aktionspreise und die Verfügbarkeit von Verbraucherabonnements.
Wählen Sie zuerst das passende Abrechnungsmodell. Erst danach wird die Frage, welches KI-Modell günstiger ist, wirklich aussagekräftig.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.