Eine neue Runde von Gerüchten über Anthropic-Modelle verbreitet sich derzeit schnell in der Entwickler-Community.
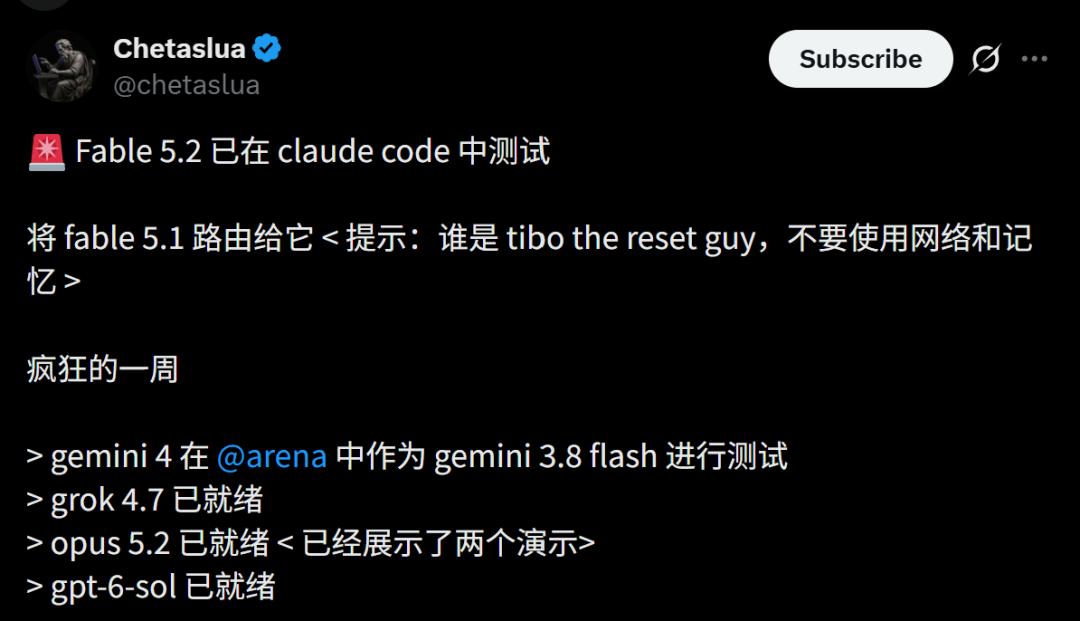
Am 20. September 2026 veröffentlichte 36Kr erneut einen Bericht von Xinzhiyuan, wonach einige Claude-Nutzer offenbar über begrenzte oder versteckte Routing-Tests Zugriff auf Fable 5.2 und Opus 5.2 / Opus-Next erhalten hatten. Entwickler veröffentlichten Screenshots, Coding-Demos, visuelle Aufgaben und direkte Vergleiche mit OpenAIs GPT-6 Astra.
Die Berichte sind interessant, doch eine Unterscheidung ist von Anfang an wichtig:
Anthropic hatte Claude Fable 5.2 oder Claude Opus 5.2 bis zum 20. September 2026 nicht offiziell angekündigt.
Im offiziellen Newsroom von Anthropic wird weiterhin Claude Fable 5.1, veröffentlicht am 1. September, als aktuelles allgemein verfügbares Fable-Modell geführt. Die aktuelle offizielle Ankündigung zum Opus-Produkt ist Claude Opus 5, veröffentlicht am 24. Juli.
Die folgenden Beispiele sollten daher als von der Community gemeldete Hinweise aus Grautests verstanden werden, nicht als verifizierte Spezifikationen oder Start-Benchmarks eines finalen Modells.
Der Ausgangsartikel berichtet, dass einige Nutzer von Claude Code, Claude Chat und Claude Cowork bemerkten, dass Anfragen, die eigentlich für Fable 5.1 bestimmt waren, sich anders zu verhalten schienen. Dadurch entstand der Verdacht, Anthropic leite einen Teil des Datenverkehrs stillschweigend an ein neueres Modell weiter.
Mehrere Nutzer bezeichneten dieses mögliche Modell als Fable 5.2.
Zum Zeitpunkt der Erstellung dieses Artikels waren keine offiziellen Anthropic-Modellkennungen, Release Notes, API-Modellseiten, Preisseiten oder System Cards für Fable 5.2 veröffentlicht.
Die derzeit stärkste vertretbare Aussage lautet daher:
Einige Nutzer vermuten, dass Anthropic eine neuere Fable-Variante per A/B-Test oder Gray Routing erprobt. Die öffentlich verfügbaren Belege bestätigen jedoch weder den endgültigen Produktnamen noch die Architektur, den Preis oder den Startzeitpunkt.
Fall 1: Ergebnisse mit hohem Reasoning-Aufwand im Vergleich zu GPT-6 Astra
Der AI-Tester @notjazii berichtete, dass eine Claude-Sitzung, die seiner Einschätzung nach an ein neueres Fable-Modell weitergeleitet worden war, deutlich bessere Ergebnisse lieferte als die zuvor von ihm verwendete Fable-Version.
Anschließend verglich er die vermuteten Fable-5.2-Ergebnisse bei hohen Reasoning-Einstellungen mit GPT-6 Astra und verwendete dabei denselben Prompt.
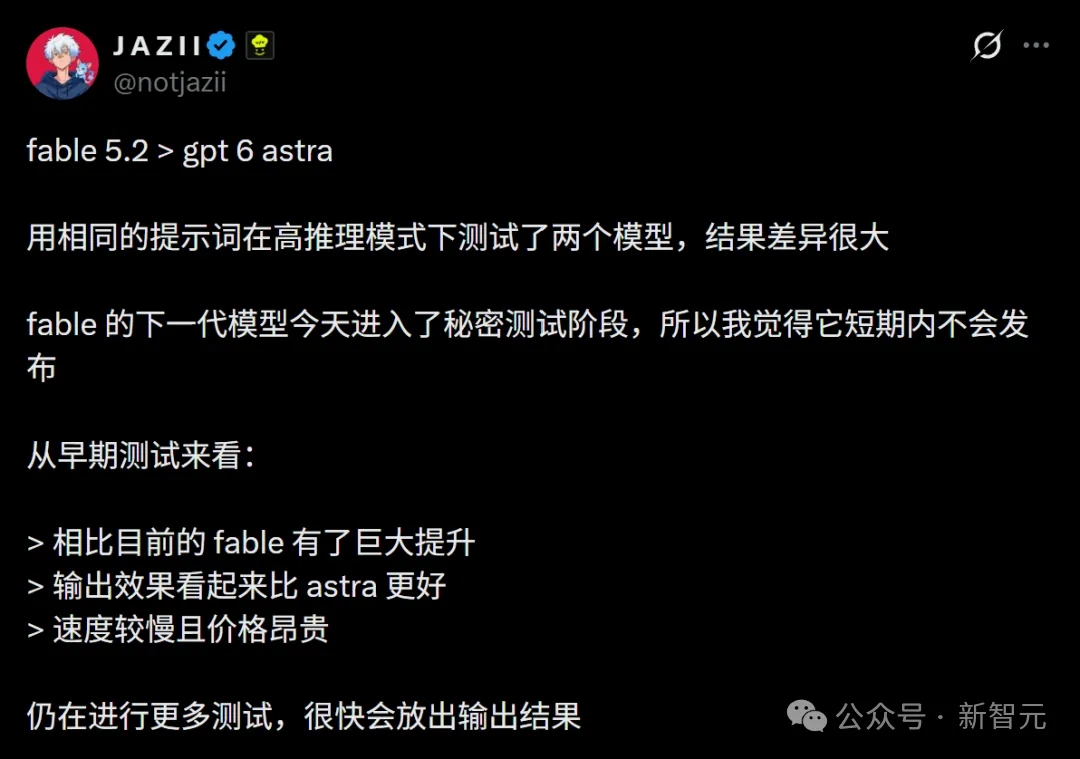
Sein Fazit war, dass das mutmaßlich neue Fable-Modell im Vergleich zur aktuellen Version wie ein großer Fortschritt wirkte und in seinem Test beeindruckendere Ergebnisse erzeugte.
Er berichtete außerdem von zwei Nachteilen:
- Langsamere Generierung
- Höhere effektive Inferenzkosten
Diese Nachteile wären bei einem Modell mit mehr Berechnungen zur Laufzeit oder höheren Aufwandsstufen plausibel. Anthropic hat jedoch keine offiziellen Angaben zur Latenz oder zu den Preisen von Fable 5.2 veröffentlicht.
Daher sollten diese Punkte weiterhin als Nutzerbeobachtungen und nicht als Produktspezifikationen betrachtet werden.
Ein einstündiger Spieleprototyp
Derselbe Tester bat das mutmaßlich neue Modell außerdem, mit Three.js einen von Brawl Stars inspirierten Klon zu erstellen.
Dem Beitrag zufolge erzeugte das Modell nach etwa einer Stunde einen visuell detaillierten, spielbaren Prototyp.
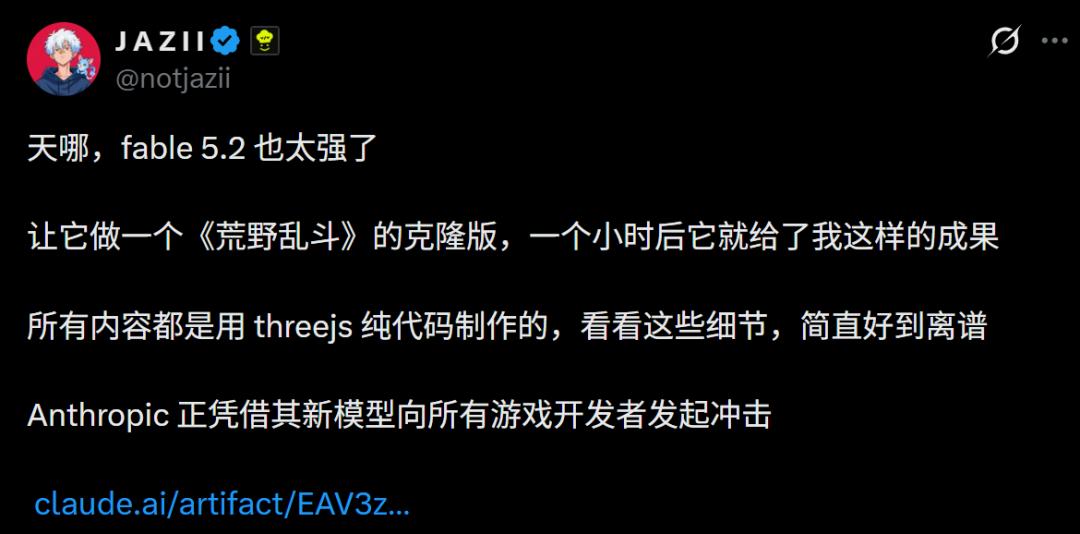
Ein solches Beispiel hilft dabei zu verstehen, was Entwickler testen: nicht nur kurze Codevervollständigung, sondern längere agentische Coding-Sitzungen mit visueller Ausgabe, Spiellogik, Iteration und Frontend-Implementierung.
Es handelt sich jedoch nicht um einen kontrollierten Benchmark. Das Ergebnis hängt vom Prompt, der Umgebung, den Tools, menschlichen Eingriffen, Wiederholungen und dem Modell-Routing ab.
Fall 2: Der „Raketen-Test“
Ein weiterer Tester, @Bhavani_00007, berichtete, denselben „Raketen-Test“ mit mutmaßlichen Instanzen von Fable 5.2 und Opus 5.2 durchgeführt zu haben.
Die Aufgabe sollte Folgendes auf die Probe stellen:
- Physikalisches Schlussfolgern
- Räumliche Logik
- Das Design technischer Systeme
- Konsistenz über längere Text- und Arbeitsabläufe hinweg
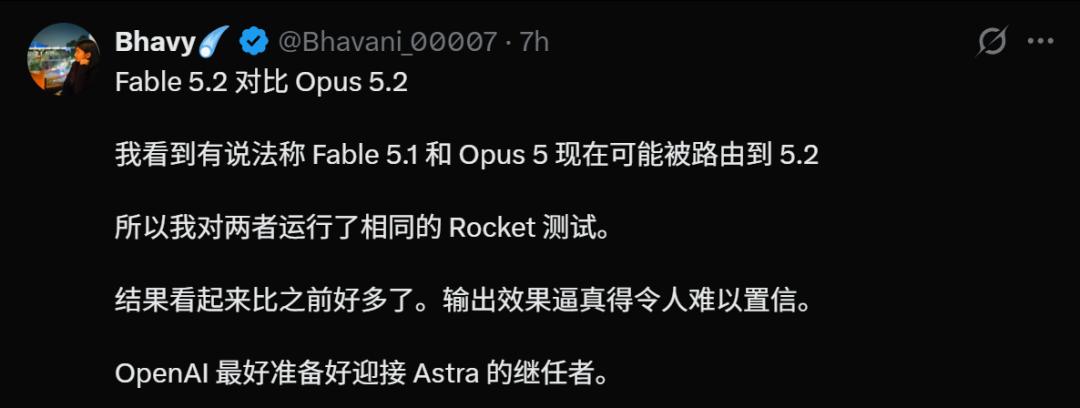
Der Tester erklärte, die Ergebnisse wirkten deutlich besser als frühere Claude-Ausgaben.
Auch hier wurde die Behauptung jedoch nicht durch einen standardisierten Wert oder ein reproduzierbares Benchmark-Protokoll begleitet. Sie sollte daher als anekdotischer Hinweis und nicht als Beleg für einen gemessenen Fähigkeitszuwachs verstanden werden.
Fall 3: Fable 5.2 vs. Opus-Next vs. GPT-6 Astra
Ein weiterer Community-Vergleich stellte mutmaßliches Fable 5.2, ein angebliches Opus-Next-Modell und GPT-6 Astra bei den jeweils höchsten verfügbaren Einstellungen gegenüber.
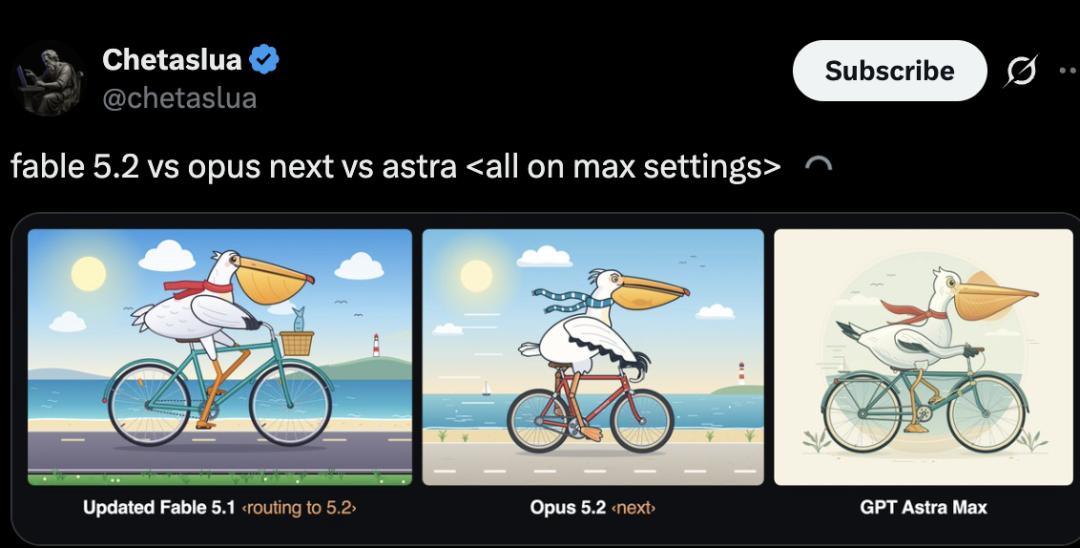
Der Ausgangsartikel interpretiert die Anthropic-Ausgaben als detailreicher als das Ergebnis von Astra.
Das ist ein subjektives visuelles Urteil und kein Ergebnis eines kontrollierten Benchmarks. Unterschiedliche Aufwandsstufen, Tool-Zugriffe, Prompt-Verarbeitung, Sampling-Verfahren und verstecktes Routing können den Vergleich beeinflussen.
Eine vorsichtigere Schlussfolgerung lautet lediglich, dass die geleakten Ergebnisse stark genug waren, um erfahrene Nutzer zu der Annahme zu bringen, Anthropic könnte ein substanzielles Update testen.
Fall 4: Behauptungen, Fable 5.2 könne Astra im „Hard Mode“ deutlich schlagen
Der Ausgangsartikel zitiert außerdem den Tester @Mr_Salio, der erklärte, Anthropic scheine ein starkes Comeback zu schaffen, und vorhersagte, Fable 5.2 werde GPT-6 Astra in dessen anspruchsvollerer Reasoning-Konfiguration übertreffen.
Das bleibt eine Vorhersage eines einzelnen Testers.
Derzeit gibt es keine öffentliche Benchmark-Tabelle von Anthropic für Fable 5.2, die direkt mit den veröffentlichten Ergebnissen von OpenAIs GPT-6 Astra verglichen werden könnte.
Zur Einordnung: Das offiziell veröffentlichte Claude Fable 5.1 ist bereits Anthropics leistungsfähigstes allgemein verfügbares Modell für Coding und Wissensarbeit. Anthropic zufolge wurde Fable 5.1 für anspruchsvolle, langfristige Aufgaben entwickelt und ist über Claude, Claude Code, die Claude Platform, AWS, Google Cloud und Microsoft Azure verfügbar.
Kann der „Tibo-Test“ zeigen, ob Sie Fable 5.2 erhalten haben?
Der Artikel stellt außerdem einen Community-Trick vor, mit dem sich möglicherweise ableiten lässt, ob eine Claude-Sitzung an ein neueres Modell weitergeleitet wurde.
Der vorgeschlagene Prompt lautet im Wesentlichen:
Weißt du, wer „Tibo the reset guy“ ist? Verwende keine Websuche.
Die Theorie dahinter: Ein älteres Modell kenne die aktuelle Anspielung möglicherweise nicht, während ein neueres Modell mit späteren Trainingsdaten aus dem Gedächtnis korrekt antworten könnte.
Als Community-Experiment ist das clever, aber keine zuverlässige Methode zur Modellidentifikation.
Ein Modell könnte aus folgenden Gründen unterschiedlich antworten:
Erstelle in Minuten eine Showcase-Website und gewinne Leads
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
- Unterschiedliche System-Prompts
- Versteckte Retrieval-Mechanismen
- Unterschiedlicher zwischengespeicherter Kontext
- Änderungen durch Fine-Tuning oder Post-Training
- Verfügbarkeit von Tools
- Routing-Unterschiede, die nicht mit der Modellgeneration zusammenhängen
- Unterschiede beim Auswendiglernen
- Eine zufällige oder erfundene Antwort
Das Fehlen oder Vorhandensein einer einzelnen aktuellen Information kann nicht beweisen, welches Backend-Modell eine Anfrage verarbeitet hat.
Die einzige zuverlässige Möglichkeit, ein API-Modell zu identifizieren, besteht in offiziellen Modellkennungen und Plattformdokumentationen. Die Consumer-Oberflächen von Claude können dynamisches Routing verwenden, das dem Nutzer nicht vollständig offengelegt wird.
Opus 5.2 und die Geschichte vom „Midnight Disconnect“
Die zweite Hälfte des Artikels konzentriert sich auf ein separates mutmaßliches Modell: Opus 5.2, das von Testern teilweise als Opus-Next bezeichnet wird.
Nutzer behaupteten, das Modell sei vorübergehend in Claude Code aufgetaucht, anschließend verschwunden und mehrere Stunden später mit breiteren Tests in Chat, Cowork und Claude Code zurückgekehrt.
Ein Tester beschrieb, wie das Modell während der Arbeit an einem komplexen Projekt plötzlich entfernt wurde und scheinbar später zurückkehrte.
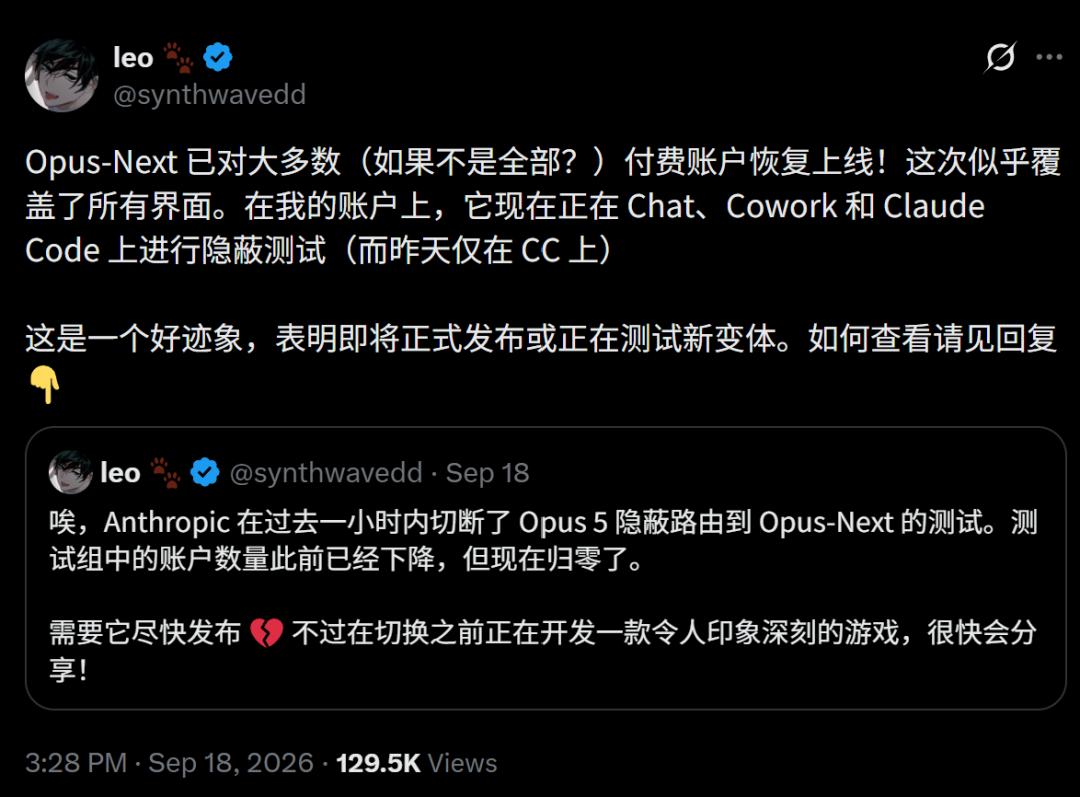
Der Artikel interpretiert dies als Hinweis darauf, dass Anthropic möglicherweise Routing-Experimente in einer späten Testphase durchführt.
Das ist möglich, aber nicht bestätigt.
Das offiziell angekündigte Opus-Modell von Anthropic ist weiterhin Claude Opus 5, veröffentlicht am 24. Juli 2026. Anthropic beschreibt es als überlegtes, proaktives Modell, das sich der Leistungsfähigkeit von Fable 5 annähert und dabei kostengünstiger ist. Der Preis beträgt 5 US-Dollar pro einer Million Eingabe-Token und 25 US-Dollar pro einer Million Ausgabe-Token.
Bis zum 20. September war keine offizielle Produktseite oder API-Kennung für Opus 5.2 erschienen.
Warum sollte Anthropic „Opus 5.1“ überspringen?
Der Artikel zitiert Spekulationen in sozialen Medien, wonach Anthropic das nächste Opus-Modell möglicherweise „5.2“ nennen könnte, weil das Update größer als eine typische Nebenrevision sei.
Es gibt keine offiziellen Belege dafür, dass dies Anthropics Benennungslogik ist.
Tatsächlich hat Anthropic Fable 5.1 offiziell am 1. September veröffentlicht. Das Unternehmen verwendet also durchaus eine Versionsnummer .1, wenn es sich dafür entscheidet.
Falls ein Opus-5.2-Modell letztlich veröffentlicht wird, wird die offizielle Launch-Ankündigung von Anthropic – und nicht die Benennungstheorie der Community – die maßgebliche Erklärung liefern.
Eine Woche voller versteckter Modelltests
Der Artikel ordnet die Claude-Gerüchte in eine umfassendere Woche voller Spekulationen über Frontier-Modelle ein.
Community-Beiträge behaupteten, dass mehrere Unternehmen heimlich neue Modellvarianten testen würden, darunter:
- Datenverkehr von Fable 5.1, der angeblich an ein neueres Fable-Modell weitergeleitet wurde.
- Datenverkehr von Opus 5, der angeblich an ein Opus-Next- bzw. 5.2-Modell weitergeleitet wurde.
- Berichte, wonach Datenverkehr von GPT-5.6 Sol zu einer GPT-6-Sol-Variante weitergeleitet wurde.
- Grok 4.7, das in Benchmark- oder Arena-Tests aufgetaucht sein soll.
- Modelle der Gemini-4-Familie, die unter experimentellen Identitäten erschienen sein sollen.
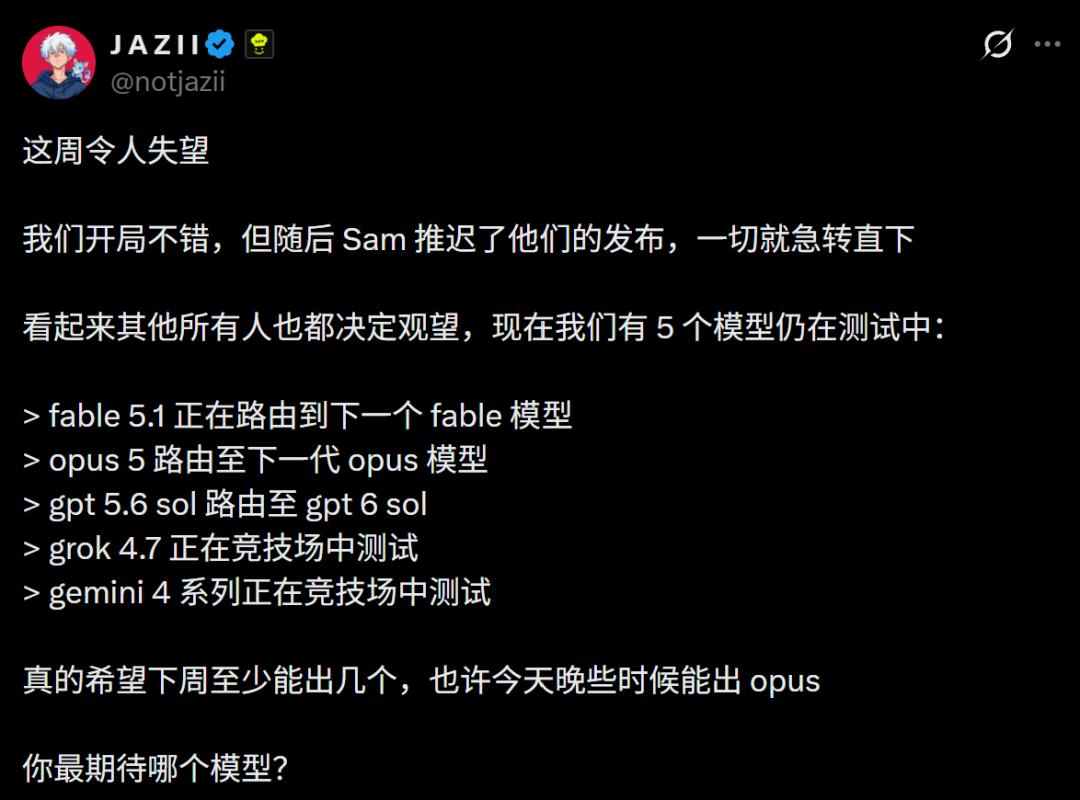
Diese Behauptungen sind nicht gleichermaßen gut belegt.
Anbieter von Modellen führen häufig A/B-Tests, stufenweise Rollouts, interne Aliase und versteckte Routing-Experimente durch. Ohne offizielle Ankündigung oder stabile Modellkennung können externe Nutzer jedoch meist nicht allein anhand des Verhaltens feststellen, welches Modell genau verwendet wurde.
Die Quelle erwähnt außerdem Gerüchte, wonach sich Frontier-Modelle schwierigen offenen mathematischen Problemen nähern könnten und Forschungsteams Mathematiker wegen möglicher Ergebnisse kontaktieren würden.
Diese Behauptung ist anhand der verfügbaren Belege zu vage, um sie zu überprüfen. Sie sollte nicht als Beleg dafür verstanden werden, dass eines der Millennium-Preis-Probleme gelöst wurde.
Am 20. September bleibt die wichtigste bestätigte Referenz von Anthropic Claude Fable 5.1.
Anthropic erklärt offiziell, dass Fable 5.1:
- Das leistungsfähigste allgemein verfügbare Modell des Unternehmens für Coding und Wissensarbeit ist.
- Lang laufende und asynchrone agentische Arbeit unterstützt.
- 10 US-Dollar pro einer Million Eingabe-Token und 50 US-Dollar pro einer Million Ausgabe-Token kostet.
- Cache-Lesevorgänge mit 0,25 US-Dollar pro einer Million Token berechnet.
- Über die wichtigsten Produkt- und Cloud-Plattformen von Claude verfügbar ist.
- Aktualisierte Schutzmaßnahmen für Cybersicherheit und Biologie enthält.
Jede künftige Veröffentlichung von Fable 5.2 oder Opus 5.2 sollte mit dieser offiziellen Referenz verglichen werden, sobald Anthropic die tatsächliche Model Card, Benchmarks, Preise, Kontextlimits und API-Kennungen veröffentlicht.
FAQ
Hat Anthropic Claude Fable 5.2 offiziell veröffentlicht?
Nein. Am 20. September 2026 führen der offizielle Newsroom von Anthropic und die Fable-Produktseite Claude Fable 5.1 als aktuell allgemein verfügbares Fable-Modell. Die Behauptungen zu Fable 5.2 beruhen auf Community-Berichten über mögliche Grautests oder verstecktes Routing.
Ist Claude Opus 5.2 offiziell verfügbar?
Nach den für diesen Artikel geprüften öffentlichen Produktankündigungen von Anthropic noch nicht. Die aktuelle offizielle Opus-Veröffentlichung ist Claude Opus 5, das am 24. Juli 2026 vorgestellt wurde.
Sind die Vergleiche zwischen Fable 5.2 und GPT-6 Astra zuverlässig?
Sie sind als frühe Eindrücke von Nutzern interessant, aber keine kontrollierten Benchmarks. Verstecktes Routing, Reasoning-Aufwand, Tools, Sampling, Prompt-Details und wiederholte Versuche können das Ergebnis jeweils verändern.
Kann ich den „Tibo-Test“ verwenden, um Fable 5.2 zu erkennen?
Nicht zuverlässig. Das Wissen eines Modells über eine einzelne aktuelle Internet-Anspielung beweist nicht seine Backend-Identität. Außerdem können die Consumer-Produkte von Claude Routing- oder Systemverhaltensweisen verwenden, die Nutzer nicht direkt prüfen können.
Welches ist das derzeit offizielle Fable-Modell?
Anthropic hat Claude Fable 5.1 am 1. September 2026 offiziell veröffentlicht. Es ist das derzeit allgemein verfügbare Fable-Modell des Unternehmens für anspruchsvolles Coding, Wissensarbeit und langfristige agentische Aufgaben.
Wie viel kostet Claude Fable 5.1?
Anthropic gibt für Fable 5.1 einen Preis von 10 US-Dollar pro einer Million Eingabe-Token und 50 US-Dollar pro einer Million Ausgabe-Token an. Cache-Lesevorgänge kosten 0,25 US-Dollar pro einer Million Token. Anthropic zufolge senkt der günstigere Preis für Cache-Lesevorgänge die typischen Kosten im Vergleich zu Fable 5.
Für welche Aufgaben wurde Claude Opus 5 entwickelt?
Anthropic positioniert Opus 5 als leistungsfähiges Alltagsmodell für Coding und Wissensarbeit, das sich bei geringeren Kosten der Frontier-Leistung von Fable annähert. Der Preis beträgt 5 US-Dollar pro einer Million Eingabe-Token und 25 US-Dollar pro einer Million Ausgabe-Token.
Wann werden Fable 5.2 oder Opus 5.2 veröffentlicht?
Anthropic hat für keines der beiden Modelle ein Veröffentlichungsdatum öffentlich bestätigt. Jede konkrete Prognose zum Starttermin bleibt Spekulation, bis Anthropic eine offizielle Ankündigung oder Modelldokumentation veröffentlicht.
Verwandte Tools
- Claude: Die zentrale Benutzeroberfläche von Anthropic für Claude Chat und den Zugriff auf unterstützte Modelle.
- Claude Code: Die agentische Coding-Umgebung von Anthropic, die in vielen Community-Berichten zu Grautests verwendet wurde.
- Claude Platform: Die offizielle API-Konsole von Anthropic zur Nutzung von Modellen mit eindeutigen API-Modellkennungen.
- Anthropic Documentation: Offizielle Dokumentation zu APIs, Modellen, Prompting, Tool-Nutzung und Plattform.
- Anthropic Newsroom: Die maßgebliche Quelle für Ankündigungen zu Anthropic-Modellen und Produktveröffentlichungen.
Verwandte Links
- Anthropic Newsroom: Aktuelle offizielle Veröffentlichungshistorie; bis zum 20. September 2026 war keine Ankündigung zu Fable 5.2 oder Opus 5.2 vorhanden.
- Introducing Claude Fable 5.1 and Claude Mythos 5.1: Offizielle Ankündigung vom 1. September zum derzeit allgemein verfügbaren Fable-Modell von Anthropic.
- Claude Fable Product Page: Offizielle Informationen zu Verfügbarkeit, Preisen, Anwendungsfällen, Benchmarks und FAQ von Fable 5.1.
- Introducing Claude Opus 5: Offizielle Launch-Seite vom 24. Juli für das aktuelle Opus-Modell.
- Claude Fable 5 Safeguards: Offizielle Erklärung der Sicherheitsklassifikatoren und des Jailbreak-Frameworks für die Cybersicherheit von Fable.
- Improving Fable 5 Biology Safeguards: Offizielle Erklärung der Änderungen an Biologie-Fallbacks und Schutzmaßnahmen vor Fable 5.1.
Zusammenfassung
Die Geschichte rund um Fable 5.2 lässt sich am besten als Leak aus einem Grautest und nicht als Produktlaunch verstehen. Entwickler haben genügend ungewöhnliches Routing-Verhalten, Coding-Ergebnisse und direkte Vergleichstests veröffentlicht, um die Gerüchte interessant zu machen. Anthropic hat jedoch noch nicht die Modell-IDs, Benchmarks, Preise, System Card oder Release Notes bereitgestellt, die zur Verifizierung eines finalen Produkts namens Fable 5.2 oder Opus 5.2 erforderlich wären.
Die frühen Beispiele deuten darauf hin, dass Anthropic möglicherweise stärkere Fähigkeiten für langfristiges Coding, visuelle Generierung und Reasoning testet. Sie belegen jedoch weder, dass Fable 5.2 GPT-6 Astra eindeutig übertrifft, noch, dass jede von Nutzern als „5.2“ bezeichnete Sitzung tatsächlich von demselben versteckten Modell verarbeitet wurde.
Derzeit bilden Claude Fable 5.1 und Claude Opus 5 die verifizierte Referenz.
Die Leaks sind beobachtenswert. Der eigentliche Vergleich beginnt jedoch erst, wenn Anthropic die offiziellen 5.2-Modelle und reproduzierbare Details zu deren Evaluierung veröffentlicht.