For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/claude-haiku-5-pricing-benchmarks-gpt-6-l-8951f544.md.
Anthropic hat **Claude Haiku 5.5** veröffentlicht, sein bisher schnellstes und kostengünstigstes kleines Modell.

Anthropic hat Claude Haiku 5.5 veröffentlicht, sein bisher schnellstes und kostengünstigstes kleines Modell.
Das Modell wurde offiziell am 7. Oktober 2026 eingeführt und ist für Aufgaben konzipiert, bei denen Geschwindigkeit, Volumen und Kosten wichtiger sind als der Einsatz des leistungsstärksten Modells für jede einzelne Anfrage.
Anthropic positioniert Haiku 5.5 für Aufgaben wie:
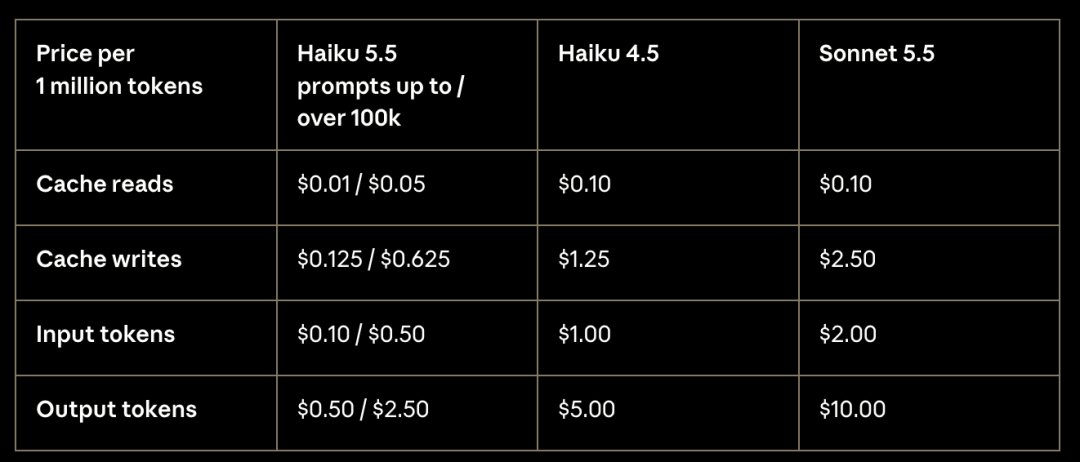
Die auffälligste Zahl ist der Preis für kurze Prompts:
Eingabe:
$0,10 / 1 Mio. Tokens

Ausgabe:
$0,50 / 1 Mio. Tokens
für Prompts mit bis zu 100.000 Tokens.
Das entspricht einem Zehntel des angegebenen Preises für Eingabe und Ausgabe von Haiku 4.5 sowie einem Zwanzigstel des Standardpreises für Eingabe und Ausgabe von Sonnet 5.5.
Die Preissenkung bedeutet nicht, dass jeder reale Workload 90 % günstiger wird.
Anthropics eigene Schätzung ist vorsichtiger: Unter Berücksichtigung der Preise für lange Kontexte und des neuen Tokenizers soll Haiku 5.5 im Durchschnitt rund 75 % weniger kosten als Haiku 4.5.
Der überraschendere Aspekt ist, dass das Modell nicht nur günstiger ist.
In mehreren von Anthropic veröffentlichten Evaluierungen liegt Haiku 5.5 deutlich vor Haiku 4.5 und schlägt sogar OpenAIs ähnlich bepreistes GPT-6 Luna in jedem Benchmark, für den Anthropic ein Luna-Ergebnis veröffentlicht hat.
Das macht Haiku 5.5 dennoch nicht zu einem Ersatz für Sonnet 5.5 oder Opus 5.5 bei anspruchsvoller Programmierung und offenen Agentenaufgaben.
Anthropic empfiehlt für diese Aufgaben ausdrücklich seine größeren Modelle.
Die bessere Einordnung von Haiku 5.5 ist die eines Hochvolumen-Arbeiters, der nun leistungsfähig genug ist, deutlich anspruchsvollere Agentenaufgaben als frühere Haiku-Modelle zu übernehmen.
Die Preisstruktur umfasst zwei Stufen.
Für Prompts mit bis zu 100.000 Eingabe-Tokens:
| Token-Typ | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| Cache-Lesen | $0,01 / 1 Mio. | $0,10 / 1 Mio. | $0,10 / 1 Mio. |
| Cache-Schreiben | $0,125 / 1 Mio. | $1,25 / 1 Mio. | $2,50 / 1 Mio. |
| Eingabe | $0,10 / 1 Mio. | $1,00 / 1 Mio. | $2,00 / 1 Mio. |
| Ausgabe | $0,50 / 1 Mio. | $5,00 / 1 Mio. | $10,00 / 1 Mio. |
Für Prompts mit mehr als 100.000 Eingabe-Tokens gelten für Haiku 5.5 folgende Preise:
Cache-Lesen:
$0,05 / 1 Mio.

Cache-Schreiben:
$0,625 / 1 Mio.

Eingabe:
$0,50 / 1 Mio.

Ausgabe:
$2,50 / 1 Mio.
Für die Batch-Verarbeitung gilt ein Rabatt von 50 % auf Eingabe- und Ausgabe-Tokens.
Anthropic erklärt außerdem, dass rund 90 % der Anfragen an das vorherige Haiku-Modell unter dem Schwellenwert von 100.000 Tokens lagen. Deshalb ist die niedrigere Preisstufe für typische Hochvolumen-Bereitstellungen so relevant.
Die beworbenen Preise für kurze Prompts liegen 90 % unter denen von Haiku 4.5.
Anthropic schätzt die tatsächliche durchschnittliche Reduzierung jedoch auf etwa 75 %.
Dafür gibt es zwei wesentliche Gründe.
Sobald ein Prompt mehr als 100.000 Eingabe-Tokens enthält, verfünffachen sich die Preise von Haiku 5.5.
Das Modell ist dann weiterhin günstiger als Haiku 4.5, aber die Reduzierung beträgt 50 % statt 90 %.
Haiku 5.5 verwendet den neueren Tokenizer, der auch bei Claude 4.7 und späteren Modellen eingesetzt wird.
Anthropics Migrationsleitfaden zufolge erzeugt derselbe Eingabetext bei Haiku 5.5 ungefähr:
30 % mehr Tokens
als bei Haiku 4.5.
Der genaue Anstieg hängt vom Inhalt ab.
Das wirkt sich aus auf:
max_tokensEntwickler sollten daher nicht einfach die Tokenanzahl von Haiku 4.5 übernehmen und mit dem neuen Tokenpreis von Haiku 5.5 multiplizieren.
Der Text muss mit dem neuen Modell erneut gezählt werden.
Für Anfragen mit kurzen Standardkontexten sind die beiden Modelle beim Tokenpreis direkt vergleichbar.
OpenAI führt GPT-6 Luna derzeit mit folgenden Preisen:
Eingabe:
$0,10 / 1 Mio.

Gecachte Eingabe:
$0,01 / 1 Mio.

Cache-Schreiben:
$0,125 / 1 Mio.

Ausgabe:
$0,50 / 1 Mio.
Diese Preise entsprechen den Preisen von Haiku 5.5 für kurze Prompts.
Die Schwellenwerte für lange Kontexte unterscheiden sich jedoch deutlich.
Die höhere Preisstufe beginnt, wenn der Prompt mehr als:
100.000 Eingabe-Tokens
enthält.
Danach gelten:
Eingabe:
$0,50 / 1 Mio.

Cache-Lesen:
$0,05 / 1 Mio.

Ausgabe:
$2,50 / 1 Mio.
Die Preise für lange Kontexte von OpenAI beginnen bei mehr als:
272.000 Eingabe-Tokens
und ändern sich anschließend zu:
Eingabe:
$0,20 / 1 Mio.

Gecachte Eingabe:
$0,02 / 1 Mio.

Ausgabe:
$0,75 / 1 Mio.
Der Ausgangsartikel unterscheidet daher zu Recht zwischen kurzen und langen Kontexten.
Bei Prompts unter 100.000 Tokens liegen die Standardpreise eng beieinander.
Bei sehr langen Prompts bietet Luna derzeit einen deutlich niedrigeren Preis für lange Kontexte und erreicht diese Preisstufe erst bei einem wesentlich größeren Prompt.
Das kann die Entscheidungen beim Model-Routing für lange Dokumente oder umfangreiche Agentenverläufe erheblich beeinflussen.
Anthropic nutzte die Einführung von Haiku 5.5, um eine weitere wichtige Kostenposition zu senken.
Die Preise für Cache-Lesevorgänge bei Claude Sonnet 5.5 sanken von:
$0,20 / 1 Mio. Tokens
auf:
$0,10 / 1 Mio. Tokens
Anthropic schätzt, dass dadurch die Kosten von Sonnet 5.5 bei den meisten agentischen Workloads um ungefähr 20 % sinken, da Cache-Lesevorgänge bei lang laufenden Agenten einen großen Anteil der Tokens ausmachen können.
Damit ist die Modellfamilie klarer gestaffelt:
Haiku 5.5
→ günstigste und schnellste Option für Aufgaben mit höchstem Volumen

Sonnet 5.5
→ anspruchsvollere, klar abgegrenzte Aufgaben und Programmierung

Opus 5.5
→ schwierigste offene Aufgaben und komplexe Agenten
In der Benchmark-Tabelle wird die Verbesserung gegenüber der vorherigen Generation besonders deutlich.
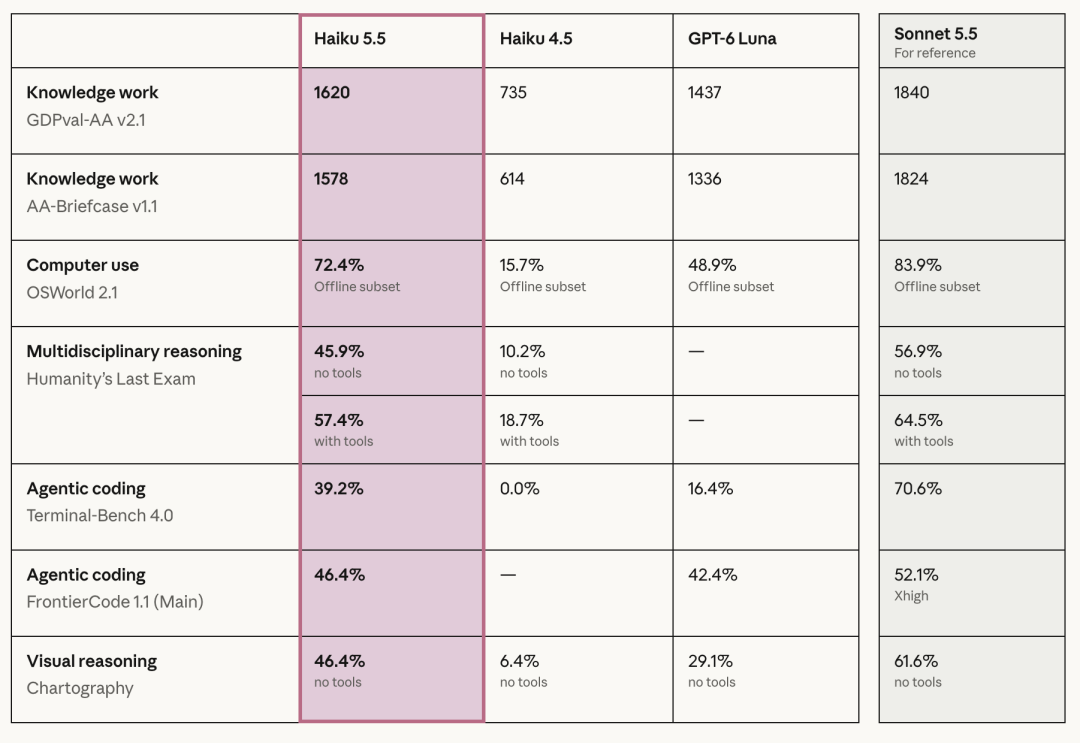
Anthropic berichtet:
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 offline | 72,4 % | 15,7 % | 48,9 % | 83,9 % |
| HLE, ohne Tools | 45,9 % | 10,2 % | — | 56,9 % |
| HLE, mit Tools | 57,4 % | 18,7 % | — | 64,5 % |
| Terminal-Bench 4.0 | 39,2 % | 0,0 % | 16,4 % | 70,6 % |
| FrontierCode 1.1 Main | 46,4 % | — | 42,4 % | 52,1 % Xhigh |
| Chartography | 46,4 % | 6,4 % | 29,1 % | 61,6 % |
In Anthropics veröffentlichter Tabelle schlägt Haiku 5.5 GPT-6 Luna in jeder Zeile, für die ein Luna-Wert angegeben ist.
Das ist angesichts der identischen Preise für Eingabe und Ausgabe bei kurzen Kontexten ein bemerkenswertes Ergebnis.
Dennoch handelt es sich um Benchmark-Vergleiche, die von Anthropic veröffentlicht wurden.
Daraus sollte nicht die allgemeine Aussage abgeleitet werden, dass Haiku 5.5 bei jedem Workload besser als Luna ist.
Die Ergebnisse im Produktivbetrieb hängen ab von:
Die stärkste Verbesserung zwischen den Generationen zeigt sich bei OSWorld 2.1, einer Evaluierung von Computer-Use-Agenten.
Haiku 4.5 erreichte:
15,7 %
Haiku 5.5 erreicht:
72,4 %
Sonnet 5.5 liegt mit:
83,9 %
weiterhin höher, während GPT-6 Luna mit folgendem Wert aufgeführt wird:
48,9 %
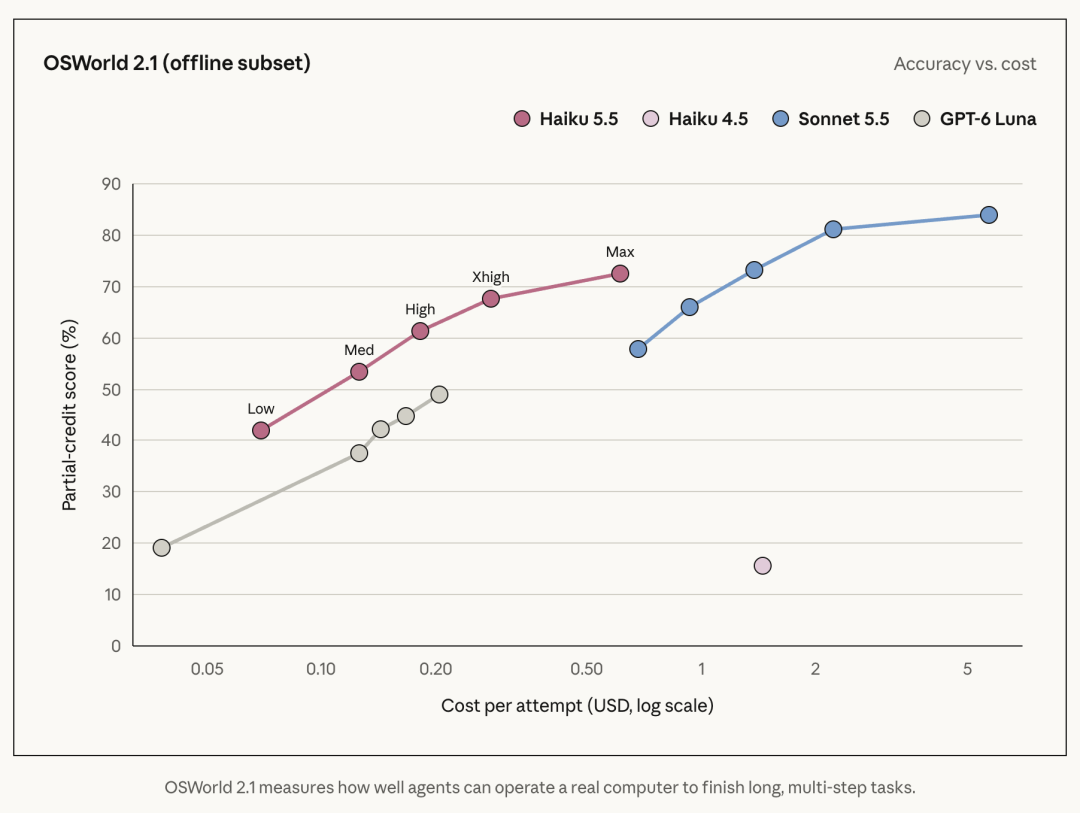
Die Kosten-Leistungs-Kurve ist besonders interessant.
Anthropics Grafik zeigt, dass eine Haiku-Konfiguration mit mittlerem Aufwand bereits den besten in dieser Evaluierung dargestellten Luna-Punkt bei niedrigeren gemessenen Kosten pro Versuch übertreffen kann.
Das bedeutet nicht, dass die beiden Modelle hinsichtlich Fähigkeiten oder Preisen identisch sind.
Es zeigt jedoch, warum Anthropic Haiku 5.5 für die Browser-Nutzung und andere latenzempfindliche Agentenaufgaben positioniert.
Bei GDPval-AA v2.1 erreicht Haiku 5.5:
1620 Elo
im Vergleich zu:
Haiku 4.5:
735

GPT-6 Luna:
1437

Sonnet 5.5:
1840
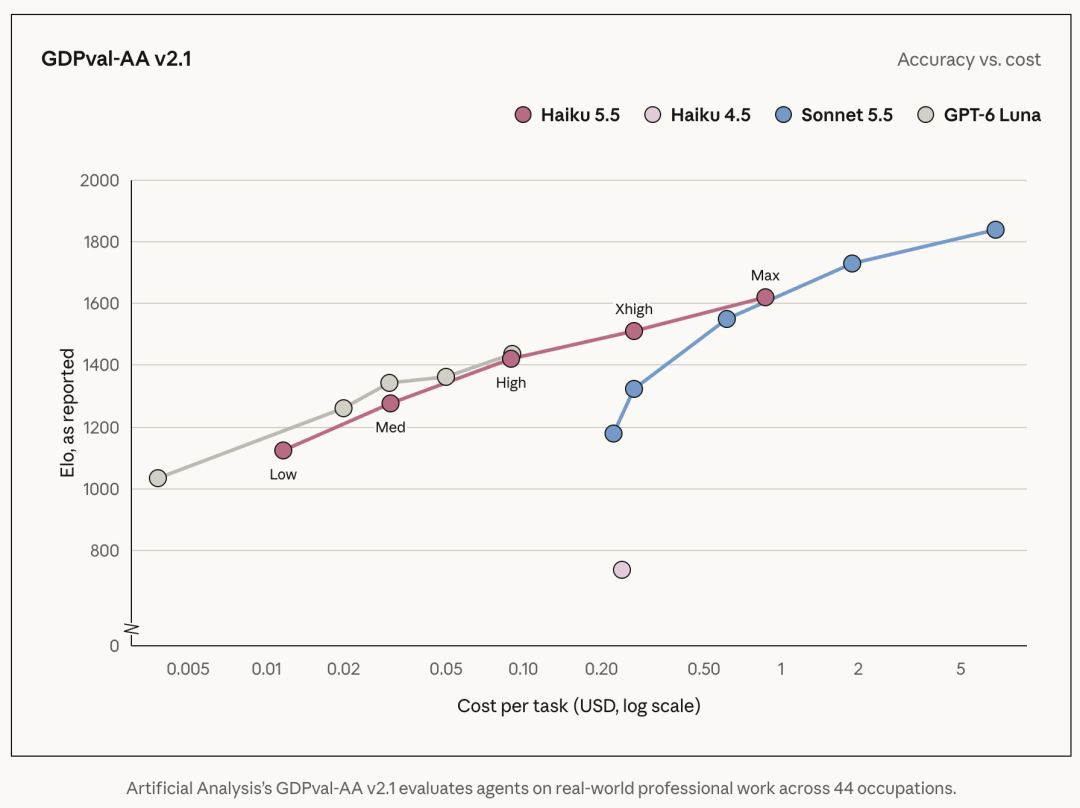
Bei mittlerem Standardaufwand liegt der Wert unter dem Maximalergebnis von Haiku, aber auch die Kosten sinken deutlich.
Diese Flexibilität ist neu für die Haiku-Familie.
Claude Haiku 5.5 ist das erste Modell der Haiku-Klasse mit einer anpassbaren Einstellung für den Aufwand.
Verfügbare Stufen sind:
low
medium
high
xhigh
max
Die Claude API verwendet standardmäßig:
medium
Damit können Entwickler die Tiefe der Schlussfolgerung gegen Kosten und Latenz abwägen.
Für eine Routing- oder Klassifizierungsaufgabe kann low ausreichen.
Bei einer anspruchsvolleren Extraktions- oder Agentenaufgabe kann eine höhere Aufwandsstufe mehr Rechenleistung einsetzen.
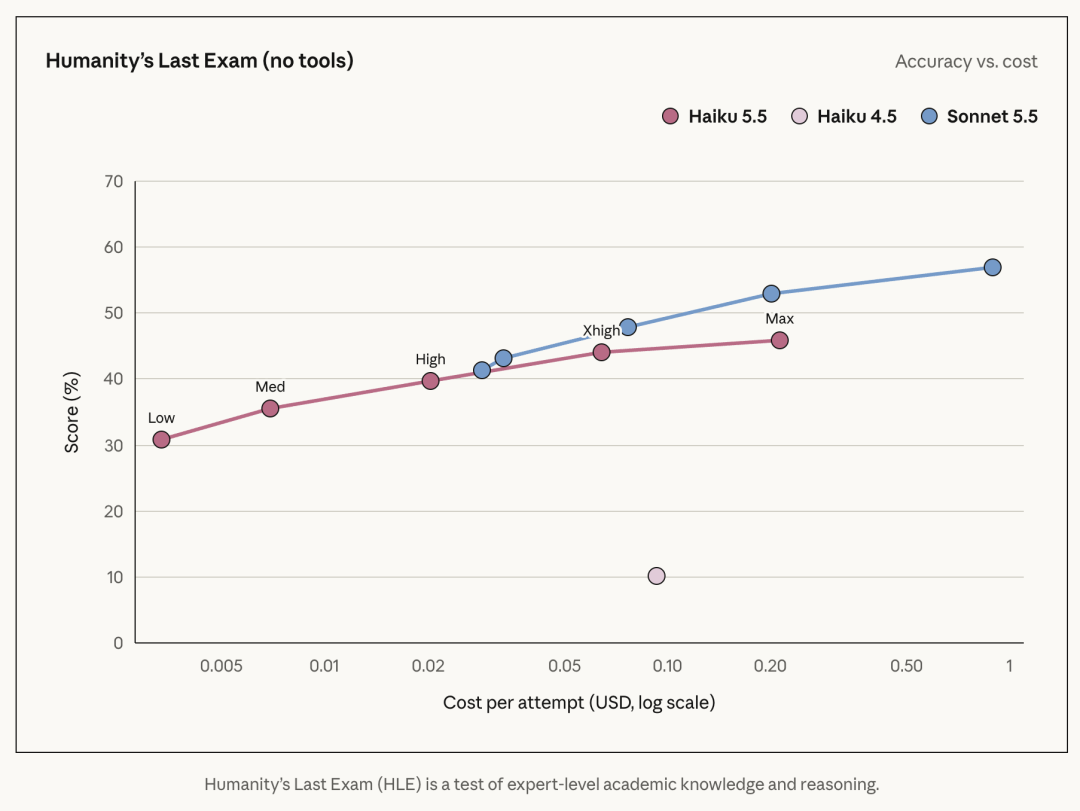
Das erklärt auch, warum eine einzelne Benchmark-Zahl nicht immer die ganze Geschichte erzählt.
Das Ergebnis von Haiku 5.5 hängt von der für die Aufgabe gewählten Aufwandsstufe ab.
Der Ausgangsartikel ist bei diesem Punkt vorsichtig, und die offiziellen Daten stützen diese Einschätzung.
Bei Terminal-Bench 4.0:
Haiku 5.5:
39,2 %

GPT-6 Luna:
16,4 %

Sonnet 5.5:
70,6 %
Bei FrontierCode 1.1 Main:
Haiku 5.5:
46,4 %

GPT-6 Luna:
42,4 %

Sonnet 5.5:
52,1 % bei Xhigh
Die Verbesserung von Haiku ist erheblich, insbesondere im Vergleich zum ausgewiesenen Haiku-4.5-Ergebnis von 0,0 % bei Terminal-Bench.
Anthropic erklärt jedoch ausdrücklich, dass Sonnet 5.5 und Opus 5.5 weiterhin die bessere Wahl für komplexe agentische Programmierung sind.
Dadurch erhält Haiku eine klarere Rolle:
Haiku:
Ausführung eng begrenzter Teilaufgaben

Sonnet:
Komplexe, klar abgegrenzte Programmierung

Opus:
Schwierigste Planung und offene Agentenaufgaben
Anthropic empfiehlt Haiku 5.5 für Aufgaben wie:
Anthropic bezeichnet es als das schnellste Claude-Modell bei Standardgeschwindigkeit.
Es läuft nur dann langsamer als Opus, wenn Opus im separat bepreisten Fast Mode ausgeführt wird.
Damit ist Haiku 5.5 überall dort nützlich, wo Latenz einen direkten Produktwert hat.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Anthropic veröffentlichte zur Einführung mehrere Kundenevaluierungen.
Dabei handelt es sich um von Kunden gemeldete Tests und nicht um universelle Leistungsgarantien.
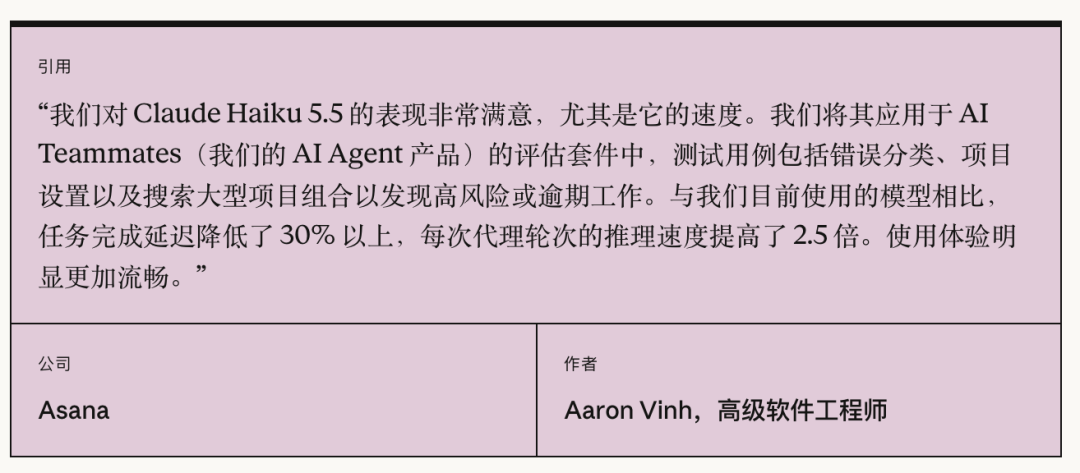
Asana evaluierte Haiku 5.5 mit seiner Testsuite für AI Teammates.
Die Aufgaben umfassten:
Asana berichtete im Vergleich zu dem zuvor eingesetzten Modell von einer mehr als 30-prozentigen Reduzierung der Latenz beim Aufgabenabschluss und einer bis zu 2,5-fach höheren Inferenzgeschwindigkeit pro Agentenrunde.
Box berichtete, dass Haiku 5.5 in frühen Tests bei etwa halber Latenz elf Punkte mehr als Haiku 4.5 erzielte.
Das Unternehmen hob analytische Workloads hervor, etwa:
AlphaSense testete 400 Fragen zu Dokumenten.
Das Unternehmen meldete folgende Evaluierungswerte:
Haiku 5.5:
0,84

Haiku 4.5:
0,76
Die Relevanz liegt im Umfang.
AlphaSense zufolge verarbeitet dieser Typ von „Ask in Document“-Workload im Produktivbetrieb etwa 8 Millionen Aufrufe pro Woche. Dadurch sind kleine Kosten- und Latenzänderungen operativ bedeutsam.
Einer der klarsten Anwendungsfälle besteht nicht darin, ein größeres Modell zu ersetzen, sondern darunter zu arbeiten.
Ein größeres Modell kann:
die Gesamtaufgabe verstehen
→ sie in Teilprobleme zerlegen
→ eng begrenzte Aufgaben zuweisen
Haiku 5.5 kann diese Aufgaben anschließend parallel ausführen.
Dieses Muster ermöglicht es dem System, teure Modellkapazität nur dort einzusetzen, wo sie benötigt wird.
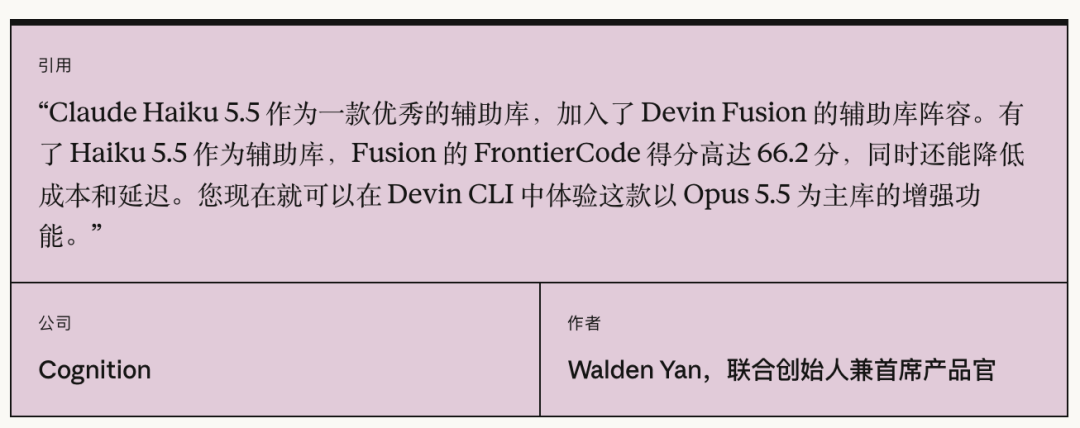
Cognition zufolge ist Haiku 5.5 nun als Sidekick-Modell in Devin Fusion verfügbar.
Mit Opus 5.5 als Lead-Modell und Haiku 5.5 als Sidekick berichtet Cognition von einem FrontierCode-Ergebnis von 66,2 bei gleichzeitig reduzierten Kosten und geringerer Latenz.
Dies ist ein gutes Beispiel für hierarchisches Model-Routing:
Opus 5.5
→ Planung
→ schwierige Entscheidungen
→ Integration

Haiku 5.5
→ parallele Teilaufgaben
→ Datenabruf
→ eng begrenzte Implementierung
→ repetitive Arbeit
Das Ergebnis lautet nicht einfach: „Verwende ein günstigeres Modell.“
Es lautet: „Verwende das teure Modell nur für Aufgaben, die es benötigen.“
Das Finanz-KI-Unternehmen Rogo beschreibt ein ähnliches Muster.
Ein größeres Modell kann eine Präsentation erstellen, während ein Haiku-5.5-Subagent einen 10-K-Bericht durchsucht und den für eine Folie benötigten Segmentumsatz extrahiert.
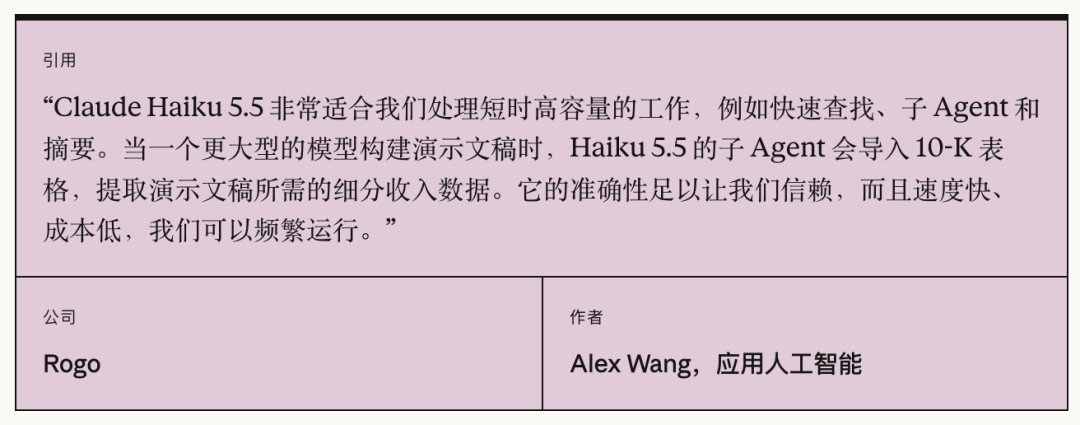
Dies ist genau die Art von eng begrenzter, wiederholbarer Arbeit, für die Haiku konzipiert ist:
spezifische Frage
+
bekannte Quelle
+
hohes Volumen
+
Anforderung an geringe Latenz
Der Ausgangsartikel enthält eine Entwicklerdemo von Anthropic zu einer Aufgabe rund um den Bau eines Fallschirms für ein Ei.
Opus 5.5 arbeitete allein und soll:
3 Minuten 37 Sekunden benötigt haben
25 Entwürfe getestet haben
$0,47 gekostet haben
Als Opus zehn Haiku-5.5-Subagenten einsetzte, berichtet der Ausgangstext:
58 Sekunden
86 getestete Entwürfe
$0,14 Gesamtkosten
Das ursprüngliche BAAI-Bild zu diesem Ergebnis konnte während der Vorbereitung nicht zuverlässig geladen werden und wird daher hier nicht reproduziert.
Dieses Beispiel sollte als Anthropic-Demo einer bestimmten Agentenarchitektur verstanden werden und nicht als allgemeine Garantie für eine vierfache Geschwindigkeits- oder Kostenverbesserung.
Sein Zweck ist die Veranschaulichung von Parallelisierung.
Wenn sich eine Aufgabe sauber zerlegen lässt, können viele kleine, schnelle Agenten gleichzeitig mehr Möglichkeiten untersuchen als ein einzelnes teures Modell, das sequenziell arbeitet.
Anthropics aktuelle Modelldokumentation führt folgende Angaben auf:
| Spezifikation | Claude Haiku 5.5 |
|---|---|
| Modell-ID | claude-haiku-5-5 |
| Kontextfenster | 1.000.000 Tokens |
| Maximale Ausgabe | 128.000 Tokens |
| Maximale Ausgabe der Batch-API, Beta | 300.000 Tokens |
| Eingabe | Text, Bilder |
| Ausgabe | Text |
| Schlussfolgerung | Adaptiv |
| Standardaufwand | medium |
| Verlässlicher Wissensstand | Juni 2026 |
| Veröffentlichungsdatum | 7. Oktober 2026 |
Das Kontextfenster von 1 Million Tokens ist der Standard.
Für die Nutzung des vollständigen Kontextfensters ist kein spezieller Beta-Header erforderlich.
Dies ist einer der wichtigsten praktischen Abschnitte des Ausgangsartikels.
Anthropics offizieller Migrationsleitfaden bestätigt mehrere Unterschiede, die zu Änderungen oder Verhaltensabweichungen führen.
Für die Claude API:
claude-haiku-4-5
→
claude-haiku-5-5
Die ID von Haiku 5.5 ist festgelegt und verwendet kein Datums-Suffix.
Derselbe Text umfasst mit dem neueren Tokenizer ungefähr 30 % mehr Tokens.
Entwickler sollten folgende Werte neu berechnen:
max_tokensHaiku 4.5 konnte Folgendes verwenden:
{
  "thinking": {
    "type": "enabled",
    "budget_tokens": 8000
  }
}
Haiku 5.5 verwendet stattdessen adaptives Denken.
Eine Anfrage, die die alte manuelle Konfiguration mit budget_tokens sendet, führt zu einem 400-Fehler.
Entwickler sollten adaptives Denken verwenden und die Tiefe mit dem Parameter effort steuern.
Anthropic empfiehlt, folgende Parameter in Haiku-5.5-Anfragen wegzulassen:
temperature
top_p
top_k
Nicht standardmäßige Werte können 400-Fehler auslösen.
Stattdessen sollten Prompting und Aufwand zur Steuerung des Verhaltens verwendet werden.
Haiku 5.5 unterstützt nicht das alte Muster, bei dem die letzte Nachricht eine Assistant-Rolle hat und vom Modell fortgesetzt wird.
Für strukturierte Formate empfiehlt Anthropic stattdessen strukturierte Ausgaben oder Tool-Schemas.
Für die Computer-Use-Integrationen der Claude API und von Google Cloud schreibt der Migrationsleitfaden vor, auf Folgendes zu wechseln:
computer_toolset_20260801
Das aktuelle Toolset stellt folgende Aktionen als Mitgliedstools eines Computer-Toolsets bereit:
Anthropic empfiehlt für Umgebungen mit Computer-Nutzung eine starke Isolierung und Zugriffskontrollen.
Anwendungen sollten folgende Zustände ausdrücklich behandeln:
refusal
model_context_window_exceeded
Eine Sicherheitsverweigerung ist nicht dasselbe wie ein gewöhnlicher, wiederholbarer Infrastrukturfehler.
Anthropics Migrationsleitfaden für Haiku 5.5 erklärt, dass Priority Tier für das neue Modell nicht unterstützt wird.
Teams mit bestehenden Priority-Tier-Verpflichtungen für Haiku 4.5 sollten ihre Kapazität separat planen.
Anthropic stellt eine gebündelte Claude-API-Migrationsfunktion bereit.
In Claude Code ist der Befehl aus dem Ausgangsartikel gültig:
/claude-api migrate this project to claude-haiku-5-5
Laut dem offiziellen Migrationsleitfaden kann die Funktion:
Vor der Bearbeitung von Dateien fordert sie den Benutzer auf, den Umfang der Migration zu bestätigen.
Das ist besonders für größere Repositories nützlich, in denen sich API-Aufrufe über mehrere Dateien verteilen.
Anthropic erklärt, dass seine Python- und TypeScript-SDKs nun Beta-Klassen für folgende Bereiche enthalten:
Die aktuelle Schnittstelle für die Computer-Nutzung verwendet:
computer_toolset_20260801
Auf unterstützten Plattformen stellt das Toolset 17 Mitgliedsaktionen bereit, darunter:
screenshot
left_click
type
scroll
zoom
Für reine Web-Workflows empfiehlt Anthropic, sofern passend das Browser-Use-Tool zu verwenden, statt eine vollständige Desktop-Umgebung bereitzustellen.
Das ist relevant, weil Haikus Kombination aus Geschwindigkeit und niedrigem Preis es besonders für repetitive Interaktionen mit Browsern und Desktop-Agenten geeignet macht.
Anthropic zufolge ist Haiku 5.5 verfügbar über:
Der Ausgangsartikel weist außerdem auf die Verfügbarkeit über Drittanbieterplattformen wie Cursor und OpenRouter hin.
Dabei handelt es sich um externe Integrationen, die eigene Preise, Ratenlimits und Model-Routing-Verfahren haben können.
Für die direkte Entwicklung mit Anthropic lautet die offizielle Modell-ID:
claude-haiku-5-5
Claude Haiku 5.5 ist das schnellste und kostengünstigste kleine Modell in Anthropics Claude-5.5-Familie. Es ist für Aufgaben mit hohem Volumen und geringer Latenz konzipiert, etwa Zusammenfassungen, Klassifizierung, Routing, Extraktion, Browser-Nutzung und Subagent-Aufgaben.
Für Prompts mit bis zu 100.000 Tokens kostet es $0,10 pro Million Eingabe-Tokens und $0,50 pro Million Ausgabe-Tokens. Für Prompts über 100.000 Tokens gelten höhere Preise von $0,50 für die Eingabe und $2,50 für die Ausgabe pro Million Tokens.
Die Tokenpreise für kurze Prompts liegen 90 % niedriger. Anthropic schätzt, dass die durchschnittlichen Kosten realer Workloads eher um 75 % niedriger liegen, weil Anfragen über 100.000 Tokens nur eine Preisreduzierung von 50 % erhalten und der neue Tokenizer für denselben Text ungefähr 30 % mehr Tokens erzeugt.
Bei kurzen Kontexten sind die Standardpreise für Eingabe, gecachte Eingabe und Ausgabe identisch. Bei langen Kontexten ist GPT-6 Luna derzeit vorteilhafter, weil seine höhere Preisstufe erst oberhalb von 272.000 Tokens beginnt statt bei 100.000 Tokens und seine Preise für lange Kontexte niedriger sind.
Ja. Anthropic gibt ein Kontextfenster von 1.000.000 Tokens und bis zu 128.000 Ausgabe-Tokens für normale Anfragen an. Eine Beta-Option der Message Batches kann bis zu 300.000 Ausgabe-Tokens unterstützen.
Es ist deutlich leistungsfähiger als Haiku 4.5 und schlägt GPT-6 Luna in den von Anthropic veröffentlichten Ergebnissen von Terminal-Bench und FrontierCode. Für komplexe agentische Programmierung empfiehlt Anthropic weiterhin Sonnet 5.5 oder Opus 5.5.
Zu den wichtigsten Änderungen gehören die neue Modell-ID, ungefähr 30 % mehr Tokens für denselben Text, adaptives Denken anstelle von budget_tokens, der Wegfall alter Sampling-Einstellungen, keine Assistant-Prefills, aktualisierte Computer-Use-Tools und neue Beendigungsgründe.
Die Modell-ID der Claude API lautet:
claude-haiku-5-5
Anthropic dokumentiert außerdem plattformspezifische Kennungen für Amazon Bedrock, Google Cloud, Microsoft Foundry und Claude Platform auf AWS.
/claude-api migrate.computer_toolset_20260801 und die Integration von Desktop-Agenten.computer_toolset_20260801 und zu Sicherheitshinweisen.Claude Haiku 5.5 ist ein deutlich größeres Upgrade, als seine Position am unteren Ende der Claude-Preisstufe vermuten lässt. Anthropic hat die Preise für kurze Prompts auf $0,10 pro Million Eingabe-Tokens und $0,50 pro Million Ausgabe-Tokens gesenkt und das Modell gleichzeitig mit einem Kontextfenster von 1 Million Tokens, adaptivem Denken sowie deutlich höherer Leistung bei Computer-Nutzung, Programmierung, Wissensarbeit und Schlussfolgerungen ausgestattet.
Die Rolle des Modells bleibt dennoch klar. Sonnet 5.5 und Opus 5.5 sind weiterhin die bessere Wahl für schwierige agentische Programmierung und offene Aufgaben, während Haiku 5.5 für schnelle, eng begrenzte und wiederholbare Aufgaben optimiert ist, die in großem Maßstab ausgeführt oder von einem größeren Lead-Modell delegiert werden können.
Entwickler, die von Haiku 4.5 migrieren, sollten nicht nur die Modell-ID austauschen. Der neue Tokenizer, adaptives Denken, Einschränkungen bei Sampling-Parametern, Änderungen an Prefills, das Computer-Use-Toolset und der Schwellenwert für die Preise langer Kontexte wirken sich alle auf bestehende Integrationen aus.
Haiku 5.5 ist vor allem nicht als günstiger Ersatz für jedes größere Modell überzeugend, sondern als schnelle Ausführungsebene, die Hochvolumen- und Multi-Agent-Systeme deutlich wirtschaftlicher machen kann.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



