For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/embeddinggemma-2-740m-multimodal-embeddin-2078d39c.md.
Google hat **EmbeddingGemma 2** veröffentlicht, ein kompaktes multimodales Embedding-Modell, das semantische Suche direkt auf Smartphones, L...

Google hat EmbeddingGemma 2 veröffentlicht, ein kompaktes multimodales Embedding-Modell, das semantische Suche direkt auf Smartphones, Laptops, in Browsern und auf anderen Edge-Geräten ermöglicht.
Das Modell wurde am 6. Oktober 2026 angekündigt. Seine Eckdaten sind für das, was es leisten kann, ungewöhnlich kompakt:
740 Mio. Parameter insgesamt
768-dimensionaler gemeinsamer Embedding-Raum
Kontextfenster mit 8.000 Tokens
100+ Sprachen
~191 MB aktiver RAM für reine Textgewichte auf dem Pixel 11 Pro
~567 MB aktiver RAM für das vollständige multimodale Modell auf dem Pixel 11 Pro
EmbeddingGemma 2 kann Text, Code, Bilder, Videos, Audiodateien und gemischte Kombinationen dieser Modalitäten in einen gemeinsamen Vektorraum kodieren.
Das bedeutet: Eine Abfrage in natürlicher Sprache kann ein Foto, einen Audioclip oder einen bestimmten Moment in einem Video finden, ohne dass jede Datei zuvor in Text umgewandelt werden muss.
Google-CEO Sundar Pichai bezeichnete es als Googles erstes offenes, nativ multimodales Embedding-Modell.
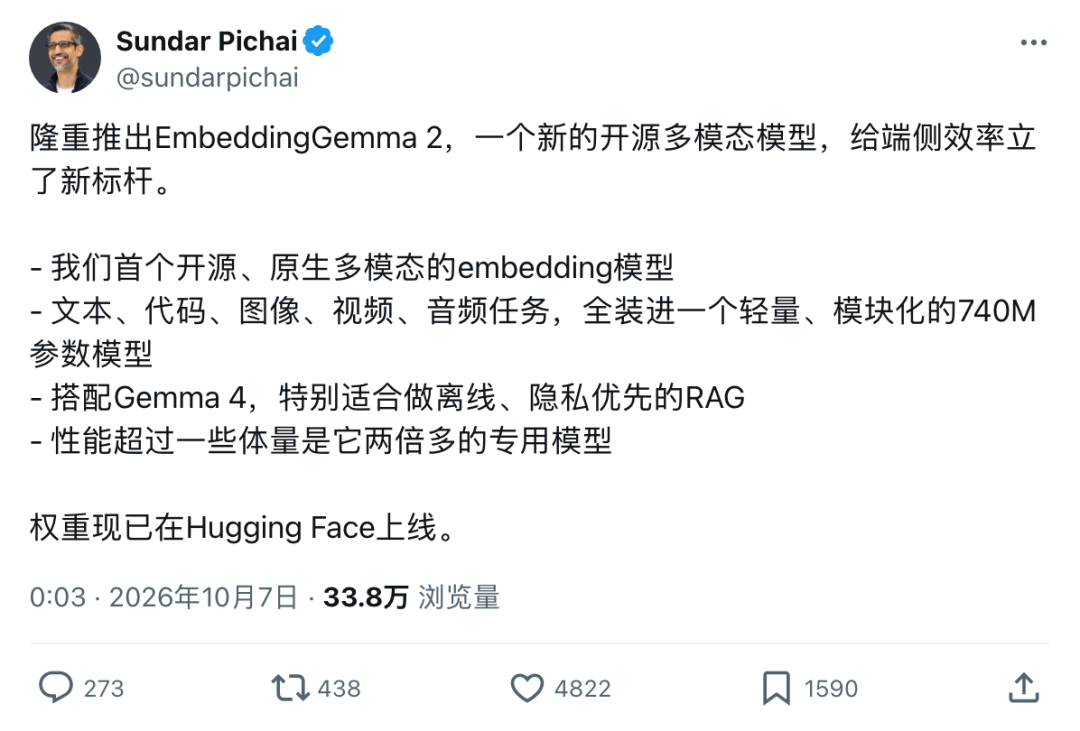
Der praktische Unterschied ist einfach: Eine Suche, die bisher von Cloud-APIs oder separaten Bild-, Audio- und Textmodellen abhing, kann nun lokal mit einem einzigen kompakten Modell ausgeführt werden.
Embedding-Modelle sind für Endnutzer oft unsichtbar, bilden aber die Grundlage vieler moderner Such- und RAG-Systeme.
Ihre Aufgabe besteht darin, Inhalte in numerische Vektoren umzuwandeln:
Inhalt
→ Embedding-Vektor
→ Position in einem semantischen Raum
Elemente mit ähnlicher Bedeutung werden näher beieinander platziert. Ein Suchsystem wandelt anschließend auch die Anfrage des Nutzers in einen Vektor um und ruft die ähnlichsten Treffer ab.
Das erste EmbeddingGemma konzentrierte sich auf Text. EmbeddingGemma 2 erweitert dieses Konzept auf einen gemeinsamen multimodalen Raum.
Laut Googles Model Card ordnet das neue Modell Text, Bilder, Videos und Audio demselben 768-dimensionalen Embedding-Raum zu.
So können ein Foto einer Katze, das Wort „Katze“ und eine Audioaufnahme einer Katze semantisch miteinander verbunden sein, obwohl ihre Rohformate völlig unterschiedlich sind.
Dies ermöglicht Suchvorgänge wie:
Textabfrage → passende Bilder
Textabfrage → passende Audiodateien
Textabfrage → passende Videomomente
Audioabfrage → passendes Video
Bildabfrage → verwandte Bilder oder Medien
Ein einzelner Inhalt kann außerdem mehrere Modalitäten enthalten.
Google nennt als Beispiel eine Produktseite für Trailrunning-Schuhe, die eine Textbeschreibung, Produktfotos und ein Video mit der Haftung auf nassen Felsen enthält. EmbeddingGemma 2 kann den kombinierten Inhalt mit einem einzigen Embedding repräsentieren und ihn mit einer Anfrage wie „wasserdichte Schuhe für Trailrunning“ abgleichen.
Kurz nach der Veröffentlichung demonstrierte der Hugging-Face-Ingenieur Victor M, wie das Modell direkt in einem Browser ausgeführt wird.
Laut dem Ausgangsartikel gab er folgende Anfrage ein:
singende Vögel
Daraufhin wurde das Ergebnisraster sofort neu sortiert. Zu den besten Ergebnissen gehörten sowohl Vogelfotos als auch Audioclips mit Wellenformen von Vogelrufen.
Die gemeldete Anfrage dauerte ungefähr 22 Millisekunden. Es war kein serverseitiger Modellaufruf beteiligt und es wurde keine externe API benötigt.
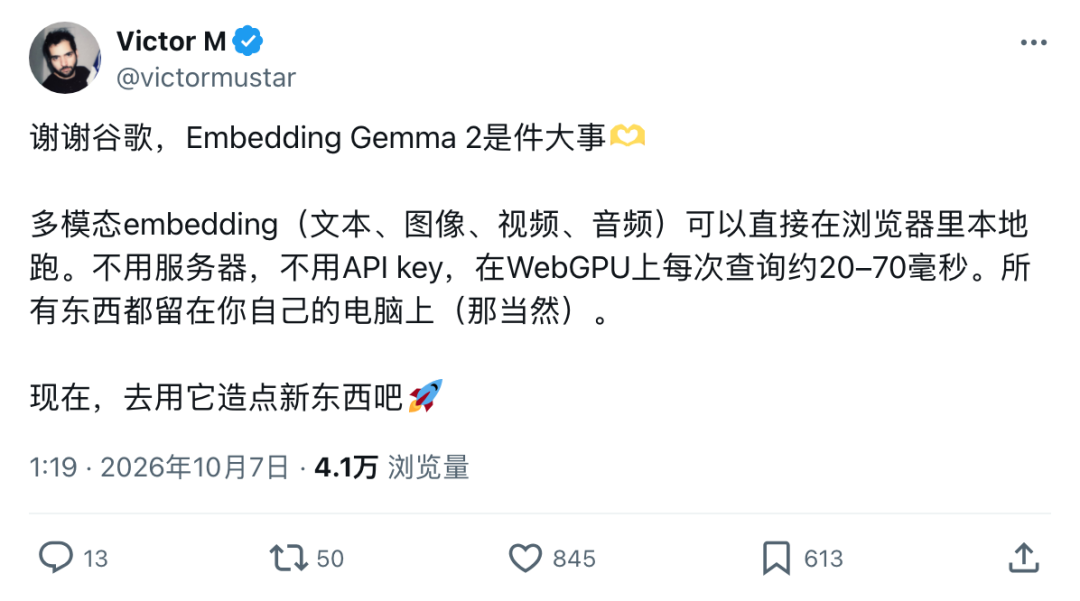
Diese Zahl stammt aus einem von einem Entwickler gemeldeten Browser-Test und stellt keine offizielle Latenzgarantie von Google dar.
Die übergeordnete Aussage wird dennoch durch Googles eigene Bereitstellungshinweise gestützt: EmbeddingGemma 2 ist für die lokale Ausführung in Umgebungen wie LiteRT, MediaPipe, WebGPU, transformers.js, MLX, llama.cpp, Ollama und anderen Edge-freundlichen Laufzeitumgebungen konzipiert.
EmbeddingGemma 2 verwendet ein Kontextfenster mit 8.192 Tokens, das viermal so groß ist wie das des vorherigen EmbeddingGemma.
Google zufolge kann eine Eingabe mit einer einzigen Modalität ungefähr Folgendes enthalten:
5,5 Minuten Audio
29 Bilder
58 Videoframes
oder ineinander verschachtelte Mischungen verschiedener Modalitäten.
Das Modell unterstützt außerdem mehr als 100 Sprachen.
Dadurch erhalten lokale Suchsysteme deutlich mehr Flexibilität. Statt nur kurze Textausschnitte zu indexieren, kann eine Anwendung umfangreichere Inhalte mit längeren Textpassagen, Bildern, Videoframes oder Audiosegmenten repräsentieren.
Google hat EmbeddingGemma 2 mit mehreren ähnlich großen Embedding-Systemen verglichen.
Der Ausgangsartikel hebt die größten Unterschiede bei der visuellen Suche hervor.
Googles Model Card berichtet folgende Werte:
| Benchmark | EmbeddingGemma 2 |
|---|---|
| MTEB Multilingual v2 | 61,36 |
| MTEB Code v1 | 78,68 |
| MIEB Lite | 64,64 |
| MMEB v2 Image | 57,28 |
| MMEB v2 Visual Document | 67,84 |
| MMEB v2 Video | 50,67 |
| MSEB Retrieval | 69,54 |
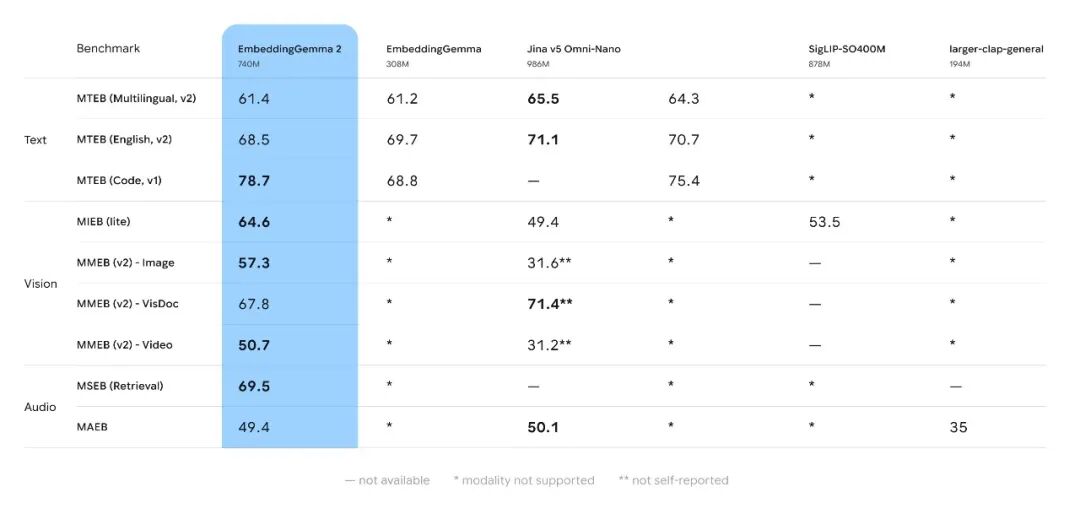
Der Ausgangsartikel hebt einen Vergleich mit Jina v5 Omni-Nano hervor:
MMEB v2 Image
EmbeddingGemma 2: 57,3
Jina v5 Omni-Nano: 31,6

MMEB v2 Video
EmbeddingGemma 2: 50,7
Jina v5 Omni-Nano: 31,2
Diese Werte stammen aus Googles veröffentlichter Evaluierungstabelle.
Wie immer sollten Benchmark-Ergebnisse im Rahmen des jeweiligen Evaluierungsaufbaus interpretiert werden und nicht als universelle Rangliste für jede Produktionssuchaufgabe.
Die insgesamt 740 Mio. Parameter sind auf mehrere Module verteilt.
Googles Model Card führt folgende Aufteilung auf:
Text:
270 Mio. Parameter insgesamt
  130 Mio. Backbone
  140 Mio. Embedder

Vision-Encoder:
170 Mio. Parameter

Audio-Encoder:
300 Mio. Parameter
Entwickler müssen nicht alle drei Komponenten laden.
| Aktive Modalitäten | Effektive Parametergröße |
|---|---|
| Nur Text | 270 Mio. |
| Text + Bild | 440 Mio. |
| Text + Audio | 570 Mio. |
| Vollständig multimodal | 740 Mio. |
Diese Modularität ist auf Edge-Geräten relevant. Wenn eine Anwendung nur Text und Code durchsucht, gibt es keinen Grund, den Audio- oder Vision-Encoder im Speicher zu halten.
Google berichtet, dass das Modell nach der Quantisierung auf einem Pixel 11 Pro ungefähr mit folgenden Werten ausgeführt werden kann:
Aktiver RAM nur für Text:
~191 MB

Aktiver RAM für vollständig multimodale Ausführung:
~567 MB
Darauf basiert die Überschrift des Ausgangsartikels mit „unter 600 MB“.
Das Modell verwendet quantisierungsbewusstes Training und unterstützt Bereitstellungsoptionen mit INT4 und INT8.
Das ist bedeutsam, weil multimodale Suchpipelines traditionell mehrere separate Komponenten erfordert haben:
Bild-Encoder
+
Spracherkennung oder Audio-Encoder
+
Text-Embedding-Modell
+
zusätzliche Vorverarbeitung
EmbeddingGemma 2 fasst einen großen Teil davon in einer einheitlichen Architektur zusammen.
Die native Ausgabedimension beträgt 768.
EmbeddingGemma 2 unterstützt außerdem Matroschka-Repräsentationslernen. Dadurch können Vektoren auf folgende Größen gekürzt werden:
512 Dimensionen
256 Dimensionen
128 Dimensionen
Google zufolge kann dies den Speicherbedarf lokaler Vektordatenbanken im Vergleich zur vollständigen 768-dimensionalen Repräsentation um bis zu das 6-Fache reduzieren.
Der Bereitstellungsblog von Google AI Edge beschreibt bestimmte lokale Index- und Speicherkonfigurationen mit Reduzierungen von bis zu dem 8-Fachen, abhängig davon, wie Repräsentation und Speicherpipeline konfiguriert sind.
Die Model Card ergänzt ein wichtiges Implementierungsdetail: Gekürzte Vektoren sollten vor der Suche nach Kosinusähnlichkeit erneut normalisiert werden.
Wenn Anfrage- und Dokumentvektoren unterschiedliche Dimensionen verwenden, können sie außerdem nicht direkt miteinander verglichen werden.
Google hat mehrere Referenzanwendungen rund um das Modell veröffentlicht.
Mit Instant Media Search aus der Google AI Edge Gallery können Nutzer lokale Fotos und Videos mithilfe natürlicher Sprache oder eines Beispielbilds durchsuchen.
Die Anwendung:
Für die Berechnung der Embeddings ist keine Internetverbindung erforderlich.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Mit Video Moments Finder können Nutzer nach bestimmten Momenten in lokalen Videodateien suchen.
Google nennt unter anderem folgende Anfragen:
Kinder lachen
Hund fängt einen Frisbee
Person bläst Geburtstagskerzen aus
Die Anwendung indexiert visuelle und Audioabschnitte und gibt passende Zeitstempel zurück.
Google hat außerdem AI Edge Foresight für Mac veröffentlicht.
Foresight verwendet EmbeddingGemma 2 zusammen mit Gemma 4 für lokale Suche und kontextbezogenes Schlussfolgern.
Google zufolge kann die Anwendung Besprechungstranskripte indexieren, private Dateien durchsuchen, Bilder, Dokumente und Notizen abrufen, offline arbeiten und sensible Quelldaten auf dem Gerät halten.
Das entspricht weitgehend der im Originalartikel beschriebenen lokalen RAG-Architektur:
EmbeddingGemma 2
→ relevanten lokalen Kontext abrufen

Gemma 4
→ über den abgerufenen Kontext schlussfolgern
Der Ausgangsartikel sammelt außerdem mehrere frühe Experimente von Entwicklern.
Diese Beispiele sind nützlich, sollten aber als von der Community gemeldete Ergebnisse und nicht als offizielle Google-Benchmarks betrachtet werden.
Die Mac-App Nativ berichtete über Tests mit einem 8-Bit-quantisierten Modell auf einem Apple M5 Max.
Zu den veröffentlichten Werten gehörten:
Kosinusähnlichkeit gegenüber FP32:
0,9997

Durchsatz bei Texteinbettungen mit Batchgröße 32:
817 Elemente/Sekunde
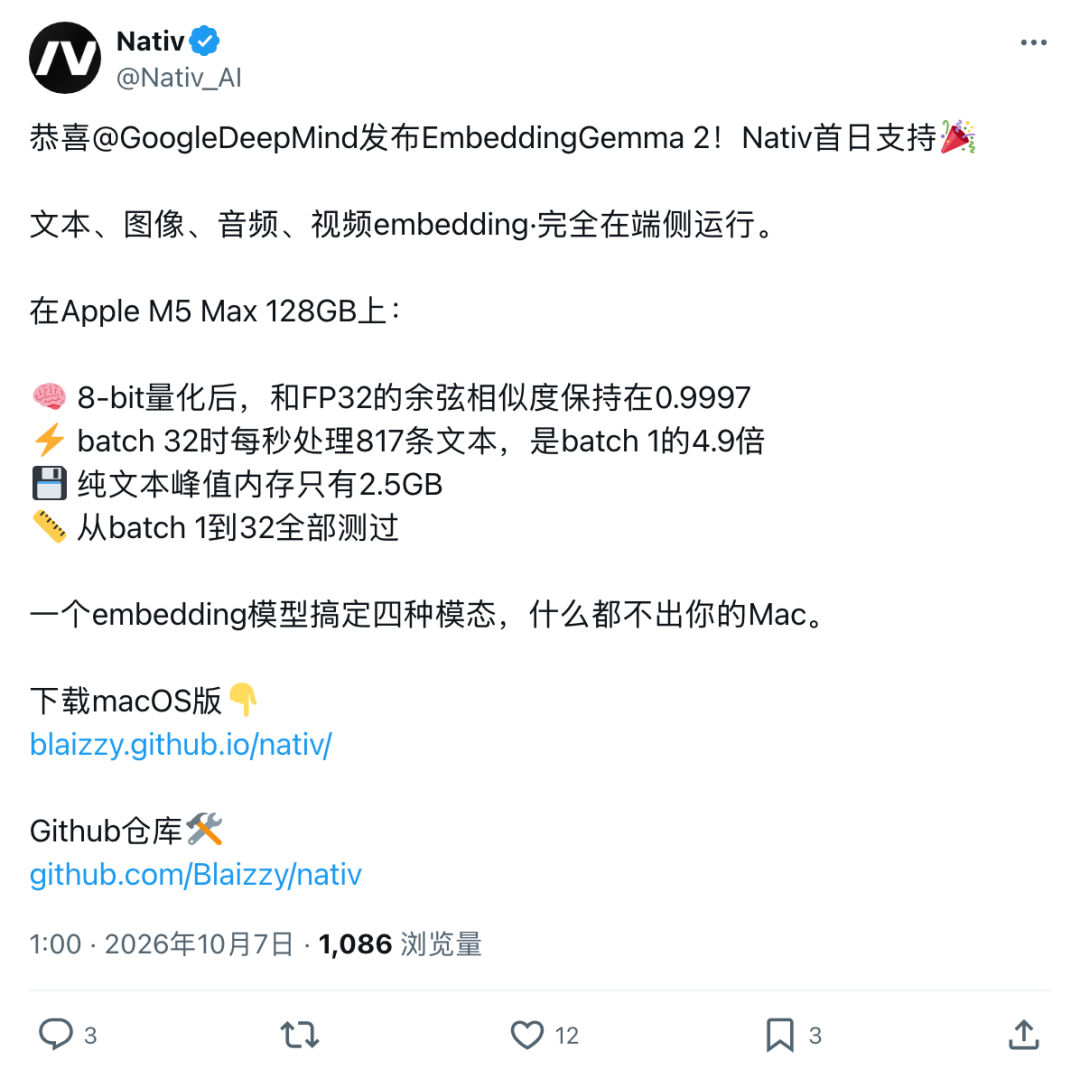
Diese Werte hängen von der konkreten Implementierung, der Quantisierung, der Hardware und der Batchgröße ab.
Ein im Ausgangsartikel erwähnter türkischer Entwickler erstellte einen kleinen Test mit persönlichen Notizen.
Die Notizen waren überwiegend auf Englisch verfasst, während die Anfragen auf Türkisch gestellt wurden.
In seinem gemeldeten Test ergaben sich folgende Werte:
Trefferquote bei Schlüsselwortsuche:
15 %

Trefferquote mit EmbeddingGemma 2:
97 %
Bei der Konfiguration wurde geprüft, ob die richtige Notiz unter den 18 besten Kandidaten erschien.
Er testete außerdem fehlerreiche echte Nachrichten und berichtete, dass das semantische Modell ungefähr doppelt so viele relevante Notizen wie die Schlüsselwortsuche fand. Jede Anfrage dauerte lokal angeblich rund 50 Millisekunden.
Dies ist kein standardisierter Benchmark, veranschaulicht aber einen der wichtigsten Gründe für die Nützlichkeit von Embedding-Suche: Semantische Ähnlichkeit kann auch dann funktionieren, wenn Anfrage und gespeicherter Text unterschiedliche Wörter oder Sprachen verwenden.
Der Entwickler Nick Lo demonstrierte außerdem einen quantisierten Build von EmbeddingGemma 2, der über llama.cpp auf einem Nano-Entwicklungsboard lief.
Er berichtete von ungefähr:
~15 ms
um eine Textanfrage für ein kleines lokales Bildsuchsystem in ein Embedding umzuwandeln.
Nachdem das passende Bild gefunden worden war, zeichnete ein ESP32-S3 das Bild Zeile für Zeile.

Auch dies ist ein Entwicklerexperiment und keine offizielle Referenzlatenz.
Bei dem Modell geht es nicht nur um Medien.
Die Code-Retrieval-Leistung hat sich gegenüber dem vorherigen EmbeddingGemma deutlich verbessert.
Google berichtet:
MTEB Code v1

EmbeddingGemma:
68,76

EmbeddingGemma 2:
78,68
Das entspricht einem Anstieg um 9,92 Punkte.
Google Gemma hebt die lokale Indexierung von Codebasen, die semantische Codesuche und den Abruf durch Coding-Agenten ausdrücklich als vorgesehene Anwendungsfälle hervor.
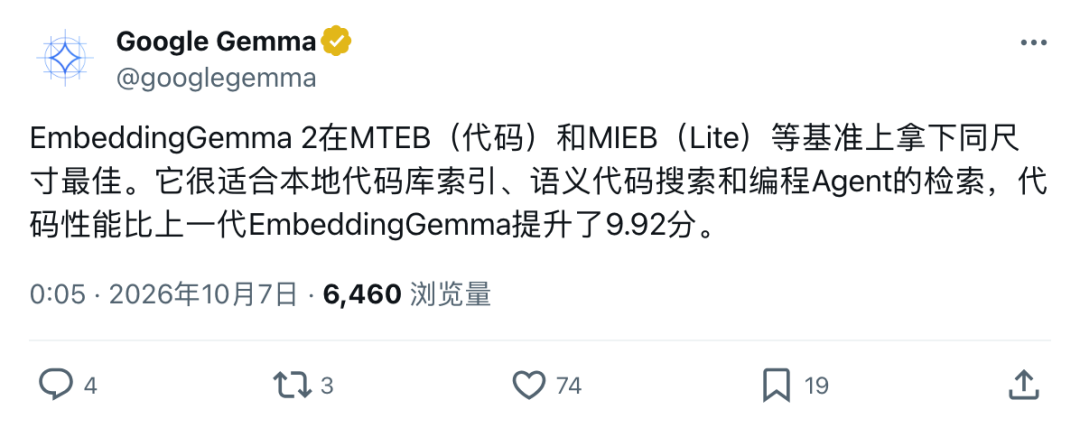
Tools wie Coding-Agenten müssen den relevanten Teil eines Repositorys finden, bevor sie ihn bearbeiten können.
Ein kompakter lokaler Embedder bietet Entwicklern eine weitere Architektur:
Quell-Repository
→ Embeddings lokal erzeugen
→ Index lokal speichern
→ Anfrage in natürlicher Sprache
→ relevanten Code abrufen
→ nur den ausgewählten Kontext an ein größeres Coding-Modell senden
Die Indexierung und der erste Abrufschritt können auf dem eigenen Rechner des Entwicklers verbleiben.
Google hatte bereits zuvor im Jahr 2026 Gemini Embedding 2 als Cloud-API veröffentlicht.
EmbeddingGemma 2 verfolgt einen anderen Ansatz.
Statt für die Erzeugung multimodaler Embeddings eine gehostete API zu benötigen, handelt es sich um ein Modell mit offenen Gewichten, das lokal ausgeführt werden kann.
| Ansatz | Hauptvorteil |
|---|---|
| Cloud-Embedding-API | Verwaltete Infrastruktur und einfache Skalierung |
| EmbeddingGemma 2 auf dem Gerät | Datenschutz, Offline-Betrieb und geringe lokale Latenz |
Für persönliche Medien, private Dateien, Unternehmensnotizen und lokale Code-Repositorys kann die zweite Option attraktiv sein, weil die Rohdaten nicht zwingend das Gerät verlassen müssen.
Google bewirbt dies ausdrücklich als datenschutzorientiertes Design.
Das bedeutet nicht, dass jede Anwendung automatisch privat wird. Auch der übrige Teil der Anwendung muss korrekt konzipiert sein, einschließlich sicherer lokaler Speicherung, Zugriffskontrollen und eines sorgfältigen Umgangs mit abgerufenem Inhalt.
EmbeddingGemma 2 ist Googles multimodales Embedding-Modell mit offenen Gewichten, das auf der Gemma-4-Technologie basiert. Es ordnet Text, Code, Bilder, Videos, Audio und gemischte Eingaben einem gemeinsamen 768-dimensionalen Vektorraum zu und ermöglicht dadurch Suche, RAG, Ähnlichkeitsvergleiche, Klassifizierung und Clustering.
Das vollständige Modell verfügt über 740 Mio. Parameter. Die Textkomponente verwendet 270 Mio. Parameter, während die optionalen Vision- und Audio-Encoder weitere 170 Mio. beziehungsweise 300 Mio. Parameter hinzufügen.
Ja. Google hat das Modell für den Einsatz auf Geräten konzipiert und stellt Bereitstellungsmöglichkeiten für Smartphones, Laptops, Browser und Edge-Hardware bereit. Googles eigene AI-Edge-Demos führen lokale Suchen aus, ohne Cloud-Aufrufe für Embeddings zu benötigen.
Google berichtet von etwa 191 MB aktivem RAM für quantisierte Gewichte nur für Text und etwa 567 MB für das vollständige multimodale Modell auf einem Pixel 11 Pro. Der tatsächliche Speicherbedarf variiert je nach Laufzeitumgebung, Hardware, Präzision und aktivierten Encodern.
Ja. Alle unterstützten Modalitäten werden demselben Vektorraum zugeordnet. Dadurch kann Text Bilder, Audio oder Videosegmente abrufen, während Medien auch mit anderen Medien verglichen werden können.
Google veröffentlicht die Modellgewichte unter der kommerziell freizügigen Apache-2.0-Lizenz und beschreibt das Modell als offen. Nutzer müssen dennoch die Gemma-Richtlinie zur verbotenen Nutzung und die geltenden Nutzungsbedingungen einhalten.
Ja. Google berichtet einen MTEB-Codewert von 78,68 gegenüber 68,76 für das vorherige EmbeddingGemma und führt die lokale Indexierung von Repositorys sowie den Abruf durch Coding-Agenten ausdrücklich als vorgesehene Anwendungsfälle auf.
EmbeddingGemma 2 ist ein Embedding-Modell: Es wandelt Inhalte für Abruf und Ähnlichkeitsvergleiche in Vektoren um. Gemma 4 ist ein generatives Modell, das über abgerufene Informationen schlussfolgern kann. Google zeigt daher, wie beide Modelle für vollständig lokale RAG-Workflows kombiniert werden.
EmbeddingGemma 2 verlagert multimodale semantische Suche aus der Cloud und macht sie für gewöhnliche Consumer-Hardware erreichbar. Ein einziges Modell mit 740 Mio. Parametern kann Text, Code, Bilder, Videos und Audio in einen gemeinsamen Vektorraum einbetten und dabei in Googles vollständig multimodaler Konfiguration auf dem Pixel 11 Pro etwa 567 MB aktiven RAM verwenden.
Der wichtigste praktische Vorteil liegt in der architektonischen Einfachheit: Ein einziges kompaktes Modell kann lokale Mediensuche, den Abruf von Videomomenten, privates RAG, mehrsprachige Notizsuche und Repository-Indexierung unterstützen, ohne dass jede Rohdatei auf einen Server hochgeladen werden muss.
Googles offizielle Demos, Model Card und Bereitstellungsumgebung stützen das On-Device-Konzept. Die Angaben aus Browser-, Nativ-, Türkisch-Notizen- und Nano-Board-Tests im Ausgangsartikel sind nützliche frühe Entwicklerexperimente, sollten jedoch als implementierungsspezifische Ergebnisse und nicht als garantierte Leistung verstanden werden.
EmbeddingGemma 2 macht lokales multimodales Retrieval so realistisch, dass Fotos, Aufnahmen, Videos, Dokumente und Code zunehmend dort durchsucht werden können, wo sie bereits liegen – auf dem eigenen Gerät des Nutzers.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



