Anthropic hat einen seiner bisher klarsten internen Einblicke veröffentlicht, wie stark künstliche Intelligenz bereits an der Entwicklung der nächsten Generation künstlicher Intelligenz beteiligt ist.
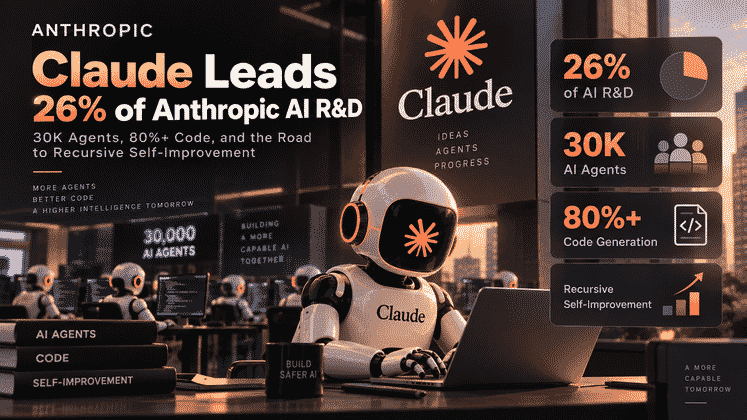
Im August 2026 erklärte Anthropic, dass Claude 26 % der KI-Forschungs- und Entwicklungsarbeit des Unternehmens leitet. Anfang 2026 lag derselbe Messwert noch bei unter 1 %.
Die Zahl ist bemerkenswert, kann aber leicht falsch verstanden werden.
„Claude leitet 26 % der F&E“ bedeutet nicht, dass Claude ein Viertel des Unternehmens unabhängig und ohne Menschen führt. Anthropic verwendet ein sechsstufiges Automatisierungsmodell. Die Zahl von 26 % bezieht sich ausdrücklich auf Arbeiten der Stufe AL4 – KI leitet: Menschen geben das übergeordnete Ziel vor, Claude erledigt den Großteil der Aufgabe von Anfang bis Ende, und Menschen bleiben für Überwachung und Freigabe verantwortlich.
Anthropic berichtet außerdem, dass mehr als 90 % der gemessenen KI-Forschungs- und Entwicklungsarbeit mindestens AL3 – KI arbeitet zusammen erreicht haben.
Gleichzeitig betreibt das Unternehmen eine sehr umfangreiche interne Agenteninfrastruktur. Im August arbeiteten zu jedem beliebigen Zeitpunkt rund 30.000 Agenten auf Anthropics meistgenutzter interner Plattform an Forschungs- und Entwicklungsaufgaben. Anthropic analysierte zudem mehr als eine Milliarde Agentenentscheidungen aus diesem Monat.
Diese Zahlen erklären, warum sich die Diskussion über „KI entwickelt KI“ von einer theoretischen Frage zu etwas Messbarem entwickelt hat.
Sie zeigen auch, warum der abschließende Vorbehalt so wichtig ist:
Anthropic zufolge hat keine der gemessenen Arbeiten die vollständig autonome Stufe AL5 erreicht.
Das Unternehmen setzt zunehmend auf KI-unterstützte und KI-geleitete Forschung und Entwicklung. Es behauptet jedoch nicht, dass Claude ohne menschliche Aufsicht selbstständig sich selbst entwerfen, trainieren, bewerten und ersetzen kann.
Anthropic hat einen Prototyp des R&D Automation Index entwickelt, um zu erfassen, wie viel seiner KI-Forschungs- und Entwicklungsarbeit von Claude erledigt wird.
Zunächst erfasst das Unternehmen die verschiedenen Arten von Aufgaben in der Modellentwicklung und ordnet anschließend jeder Kategorie eine Automatisierungsstufe zu. Die Skala basiert auf Arbeiten von Epoch AI und reicht von AL0 bis AL5.
Die sechs Automatisierungsstufen
| Stufe | Bezeichnung | Praktische Bedeutung |
|---|---|---|
| AL0 | Nicht verwendet | KI nimmt an der Aufgabe nicht wesentlich teil. |
| AL1 | Marginal | KI kann bei gelegentlichen Recherchen, beim Brainstorming oder bei der Überarbeitung helfen, verändert aber nicht die Arbeitsweise. |
| AL2 | Unterstützt | KI beschleunigt Teile der Aufgabe spürbar, während Menschen die Arbeit weiterhin steuern und prüfen. |
| AL3 | Arbeitet zusammen | KI erledigt größere Arbeitsabschnitte unter enger menschlicher Anleitung; Menschen treffen weiterhin wichtige Entscheidungen und integrieren das Ergebnis. |
| AL4 | Leitet | KI erledigt den Großteil der Aufgabe von Anfang bis Ende auf Grundlage einer übergeordneten Anfrage, während Menschen überwachen, korrigieren und freigeben. |
| AL5 | Autonom | KI erledigt die Arbeit von Anfang bis Ende mit wenig oder ohne menschliche Beteiligung. |
Der Unterschied zwischen AL3 und AL4 ist besonders wichtig.
Bei AL3 bleibt der Mensch eng eingebunden. Er kann Protokolle bereitstellen, Hypothesen vorschlagen, Fragen beantworten und entscheiden, was bei unerwarteten Ereignissen zu tun ist.
Bei AL4 kann ein Mensch ein übergeordnetes Ziel übergeben und Claude den Großteil der Ausführung überlassen. Die Person überwacht die Aufgabe weiterhin, muss aber nicht jeden einzelnen Schritt kontinuierlich steuern.
Anthropics Momentaufnahme vom August 2026
Anthropic berichtet drei zentrale Ergebnisse:
| Messgröße | Von Anthropic gemeldetes Ergebnis |
|---|---|
| KI-Forschungs- und Entwicklungsarbeit, bei der Claude auf AL4 „leitet“ | 26 % |
| KI-Forschungs- und Entwicklungsarbeit auf AL3 „arbeitet zusammen“ oder höher | Mehr als 90 % |
| KI-Forschungs- und Entwicklungsarbeit auf AL5 „autonom“ | 0 % der gemessenen Teilbereiche |
Die Zahl von 26 % lässt sich daher am besten so verstehen:
Mensch legt das übergeordnete Ziel fest
        ↓
Claude erledigt den Großteil des Workflows
        ↓
Mensch überwacht und gibt frei
Nicht so:
Claude wählt unabhängig die Forschungsagenda aus,
entwickelt seinen Nachfolger, validiert ihn und setzt ihn
ohne menschliche Beteiligung ein
Diese Unterscheidung ist zentral für Anthropics eigene Definition der rekursiven Selbstverbesserung.
Wie Anthropic den Automatisierungsindex erstellt hat
Anthropic ermittelte die Zahl von 26 % nicht einfach, indem das Unternehmen seine Mitarbeitenden fragte, wie intensiv sie Claude verwenden.
Nach der veröffentlichten Methodik zog das Unternehmen Arbeitsaufzeichnungen von Teams heran, die am Modell-Entwicklungszyklus beteiligt waren, und erstellte im Juli 2026 eine Bottom-up-Inventarliste mit rund 15.000 granularen Aufgaben.
Claude half anschließend dabei, diese Aufgaben in eine Hierarchie einzuordnen, die Folgendes umfasste:
- 542 Knoten insgesamt.
- 378 Blattkategorien.
- Kategorien aus den Bereichen Modelltraining, Produktarbeit, Reinforcement Learning, Evaluationsinfrastruktur, Betriebsstörungen, Netzwerkregeln und weiteren F&E-Aufgaben.
Für jede Kategorie untersuchte ein Forschungsagent, wie die Aufgabe tatsächlich ausgeführt wurde und welchen Anteil des Prozesses die KI übernahm. Anschließend ordnete ein unabhängiger Claude-Bewerter eine Automatisierungsstufe zu.
Anthropic bat außerdem die menschlichen Verantwortlichen der jeweiligen Arbeitsbereiche um eine separate Einschätzung der Automatisierung.
Das Unternehmen berichtet, dass Modell und Menschen in 59 % der Fälle exakt dieselbe Bewertung abgaben und in 97 % der Fälle höchstens eine Automatisierungsstufe auseinanderlagen.
Das ist ein nützlicher Hinweis, aber keine perfekte Messung.
Anthropic weist ausdrücklich darauf hin, dass Grenzfälle weiterhin subjektiv sind und dass das Bewertungsmodell möglicherweise einige der gleichen Fehler macht wie die Systeme, die es bewertet.
Rund 30.000 interne Agenten liefen gleichzeitig
Der Ausgangsartikel hebt außerdem das Ausmaß von Anthropics interner Agenteninfrastruktur hervor.
Anthropic zufolge arbeiteten im August 2026 zu jedem beliebigen Zeitpunkt ungefähr 30.000 Agenten auf seiner meistgenutzten internen Plattform an Forschungs- und Entwicklungsaufgaben.
Die Formulierung ist wichtig: Dabei handelt es sich weder um 30.000 dauerhaft aktive Angestellte mit menschlichem Verhalten noch zwangsläufig um jeden KI-Agenten, der irgendwo bei Anthropic eingesetzt wird.
Gemeint ist die Zahl der gleichzeitig aktiven Agenten auf der internen Plattform, die von der Messung abgedeckt wird.
Diese Agenten können über längere Zeiträume teilautonom arbeiten und Aufgaben aneinander delegieren.
Anthropic erklärt, dass sein internes Framework den Agenten individuelle Identitäten gibt und ein offenes Nachrichtensystem verwendet. Dadurch können Agenten die Aussagen anderer sehen, auf die ursprünglichen Belege zurückverweisen und Fehler korrigieren, anstatt Informationen blind entlang einer Kette weiterzugeben.
Im August wurden mehr als eine Milliarde Agentenentscheidungen überwacht
Wenn Zehntausende Agenten parallel arbeiten, wird die Aufsicht zu einem Systemproblem.
Anthropic zufolge analysierte das Unternehmen im August 2026 mehr als eine Milliarde Entscheidungen, die von Forschungs- und Entwicklungsagenten getroffen wurden.
Jede Aktion auf der erfassten internen Plattform durchläuft vor ihrer Ausführung einen Online-Monitor.
Der Online-Monitor kann:
- die Aktion zulassen,
- eine gefährliche Aktion blockieren,
- problematisches Verhalten umleiten oder steuern.
Anthropic zufolge wurden 0,002 % der mehr als eine Milliarde Entscheidungen blockiert – ungefähr 1 von 47.000.
Dieser niedrige Anteil sollte nicht automatisch als „Die Agenten sind in 99,998 % der Fälle sicher“ interpretiert werden. Eine Blockierungsquote ist nur eine Messgröße. Sie hängt davon ab, was der Monitor erkennen kann, wie Verhalten klassifiziert wird und welche riskanten Aktionen überhaupt auftreten.
Anthropic weist selbst auf denselben Punkt hin: Bei dieser Größenordnung ist schwer festzustellen, ob jedes wichtige Verhalten für das Überwachungssystem sichtbar ist.
Online- und Offline-Überwachung arbeiten zusammen
Anthropic beschreibt zwei Überwachungsebenen.
Online-Überwachung
Online-Monitore prüfen Aktionen, bevor sie ausgeführt werden.
Ihre Aufgabe besteht darin, Verhalten zu stoppen, das unmittelbar und nur schwer umkehrbaren Schaden verursachen könnte – etwa wenn ein Agent versucht, sensible Modellressourcen aus einem autorisierten System herauszubewegen.
Anthropic zufolge durchlaufen 100 % der Agentenaktionen auf der gemessenen Plattform diese Ebene.
Offline-Überwachung
Die Offline-Überwachung untersucht die Aktivitäten der Agenten im Nachhinein.
Sie soll Muster erkennen, die sich langsam entwickeln, anstatt sofort einen Schaden zu verursachen.
Anthropic zufolge markiert das Offline-System ungefähr 100.000 Transkripte pro Woche für eine weitere Klassifizierung. Die meisten Fälle werden automatisch abgeschlossen, doch die Fälle mit höchster Priorität – etwa 50 pro Woche – werden an Menschen eskaliert.
Die Architektur sieht daher eher so aus:
Agent schlägt eine Aktion vor
        ↓
Online-Monitor prüft die Aktion
        ↓
Aktion wird ausgeführt oder blockiert/umgeleitet
        ↓
Aktivität wird protokolliert
        ↓
Offline-Überwachung prüft Muster
        ↓
Fälle mit höchster Priorität erreichen menschliche Prüfer
Dieser Überwachungsstapel gehört zu den wichtigsten Teilen von Anthropics Ankündigung. Mehr Automatisierung ist nur dann nützlich, wenn die Organisation weiterhin verstehen und eingreifen kann, was die Agenten tun.
Mehr als 80 % des zusammengeführten Codes wurden von Claude verfasst und tragen zur Entwicklung der nächsten Modellgeneration bei
Der zweite zentrale Punkt im AIBase-Artikel ist der Anteil des Codes von Anthropic, der inzwischen von Claude geschrieben wird.
Hier muss das Datum präzise genannt werden.
Anthropics offizieller Bericht When AI builds itself erklärt, dass im Mai 2026 mehr als 80 % des in den Anthropic-Codebestand zusammengeführten Codes von Claude verfasst wurden.
Bevor Claude Code im Februar 2025 als Forschungsvorschau verfügbar wurde, lag dieser Anteil laut Anthropic im niedrigen einstelligen Prozentbereich.
Das ist in etwas mehr als einem Jahr eine dramatische Veränderung.
Die Zahl von 80 % beim Code ist nicht dasselbe wie die Zahl von 26 % bei der F&E
Die beiden Zahlen messen unterschiedliche Dinge.
Erstelle in Minuten eine Showcase-Website und gewinne Leads
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
| Messgröße | Datum | Was wird gemessen? |
|---|---|---|
| Über 80 % | Mai 2026 | Anteil des von Claude verfassten, in den Anthropic-Codebestand zusammengeführten Codes |
| 26 % | August 2026 | Anteil der gewichteten KI-Forschungs- und Entwicklungsarbeit, der als AL4 „KI leitet“ bewertet wurde |
| Über 90 % | August 2026 | Anteil der gewichteten KI-Forschungs- und Entwicklungsarbeit, der als AL3 „arbeitet zusammen“ oder höher bewertet wurde |
Softwarecode ist nur ein Teil der Modellentwicklung.
KI-Forschung umfasst außerdem:
- die Auswahl von Forschungsrichtungen,
- das Entwerfen von Experimenten,
- die Entscheidung, welchen Belegen zu vertrauen ist,
- die Bewertung unerwarteter Ergebnisse,
- die Steuerung von Trainingsläufen,
- die Interpretation von Fehlern,
- Sicherheitsforschung,
- Infrastrukturarbeit,
- Modellevaluation,
- Produkt- und Bereitstellungsentscheidungen.
Deshalb kann Claude 80 % des zusammengeführten Codes schreiben, während nur 26 % der gesamten KI-Forschungs- und Entwicklungsarbeit als KI-geleitet klassifiziert werden.
Die Codeleistung von Ingenieuren stieg stark an
Anthropic berichtet außerdem, dass ein typischer Ingenieur im zweiten Quartal 2026 pro Tag ungefähr achtmal so viel Code zusammenführte wie 2024.
Das Unternehmen fügt unmittelbar einen wichtigen Vorbehalt hinzu: Die Anzahl der Codezeilen ist ein unvollkommenes Maß für Produktivität.
Mehr Code bedeutet nicht automatisch achtmal mehr Wert.
Eine umfangreiche Änderung kann Folgendes enthalten:
- mehr automatisch generierte Tests,
- mehr automatisch generierten Boilerplate-Code,
- größere Refactorings,
- mehr Experimente,
- mehr Code, den Menschen prüfen, statt ihn selbst zu schreiben.
Dennoch argumentiert Anthropic, dass die Veränderung groß genug sei, um eine tatsächliche Beschleunigung des Entwicklungsdurchsatzes zu zeigen.
Besonders bemerkenswert ist das Muster, weil die Leistung zwischen 2021 und 2024 relativ stabil blieb und erst zunahm, nachdem Claude Code ausführen konnte, statt Menschen lediglich Codeausschnitte zum Einfügen vorzuschlagen.
Was Claude innerhalb des F&E-Zyklus tut
Der Ausgangsartikel gruppiert Claudes Arbeit in Modellevaluationen, Programmierung, Datenanalyse und Ergebnisüberprüfung.
Anthropics eigene Veröffentlichungen stützen das umfassendere Bild, dass Claude zunehmend an Aufgaben entlang des gesamten Modellentwicklungszyklus beteiligt ist.
Dazu können unter anderem folgende Aufgaben gehören:
- die Diagnose von Infrastrukturfehlern,
- die Implementierung experimenteller Codes,
- die Durchführung oder Unterstützung von Evaluationen,
- die Analyse experimenteller Ergebnisse,
- die Untersuchung von Modellverhalten,
- die Unterstützung der Alignment-Forschung,
- die Wartung interner Entwicklerinfrastruktur.
Deshalb beschreiben viele diesen Trend als KI, die beim Bau besserer KI hilft.
Es gibt jedoch einen wichtigen Unterschied zwischen der Beteiligung an der Entwicklung eines Nachfolgemodells und der vollständig autonomen Entwicklung dieses Nachfolgers.
Hat die rekursive Selbstverbesserung bereits begonnen?
Nicht nach Anthropics eigener Definition.
Anthropic beschreibt rekursive Selbstverbesserung als den Punkt, an dem ein Modell seinen Nachfolger vollständig autonom entwickeln kann.
Die Automatisierungsdaten für August sagen ausdrücklich, dass kein gemessener Teilbereich der KI-Forschung und -Entwicklung AL5 erreicht hat.
Die derzeit stärkste zutreffende Aussage lautet daher:
Claude beschleunigt den F&E-Prozess, durch den zukünftige Claude-Modelle entstehen, erheblich. Anthropic behauptet jedoch nicht, dass Claude den gesamten Entwicklungszyklus eines Nachfolgers bereits autonom durchführen kann.
Diese Unterscheidung ist wichtig, weil der Begriff „rekursive Selbstverbesserung“ häufig uneinheitlich verwendet wird.
Es gibt mindestens drei verschiedene Stufen, die damit gemeint sein können:
Stufe 1
KI unterstützt Menschen, die das nächste Modell entwickeln

Stufe 2
KI leitet große Teile des F&E-Workflows unter menschlicher Aufsicht

Stufe 3
KI entwirft, entwickelt, bewertet und verbessert ihren Nachfolger autonom
Die veröffentlichten Daten von Anthropic stützen Stufe 2 bei einem wachsenden Anteil der Arbeit deutlich.
Sie zeigen nicht Stufe 3.
Warum Anthropic diese Kennzahlen veröffentlicht
Anthropic erklärt, dass der Zweck der Messungen nicht lediglich darin besteht, Produktivität zu bewerben.
Das Unternehmen argumentiert, dass die Öffentlichkeit und Regierungen Kennzahlen benötigen, die sich über die Zeit verfolgen lassen, wenn Spitzenmodelle beginnen, ihre eigene Entwicklung zu beschleunigen.
Die vorgeschlagenen Messgrößen konzentrieren sich auf drei Bereiche:
- Wie viel KI-Forschung und -Entwicklung von KI ausgeführt wird.
- Wie gut Agentenaktionen überwacht und kontrolliert werden.
- Wie Rechenkapazität zwischen Leistungsfähigkeit und Sicherheitsarbeit verteilt wird.
Anthropic zufolge könnten solche Kennzahlen künftig unabhängig überprüft und als Auslöser für strengere Sicherheitsanforderungen verwendet werden.
Wenn beispielsweise der Anteil KI-geleiteter F&E stark ansteigt, könnte ein Labor verpflichtet werden, längere Testzeiträume oder eine strengere externe Evaluation einzusetzen, bevor ein neues Modell an weiterer Forschungs- und Entwicklungsarbeit beteiligt wird.
Anthropic berichtet auch über die Verteilung von Rechenkapazität auf Sicherheitsarbeit
Dieser Punkt steht außerhalb des kurzen AIBase-Artikels, stammt jedoch aus derselben Messveröffentlichung von Anthropic und hilft, den breiteren Rahmen des Unternehmens zu verstehen.
Für eine einwöchige Momentaufnahme im Juli 2026 erklärt Anthropic:
- Etwa 6 % der für KI-Forschung und -Entwicklung eingesetzten Rechenkapazität wurden der Sicherheit zugewiesen.
- Etwa 12 % der für KI-gestützte KI-Forschung und -Entwicklung eingesetzten Rechenkapazität wurden der Sicherheit zugewiesen.
Anthropic bezeichnet diese Werte als konservative Schätzungen und weist darauf hin, dass die Unterscheidung zwischen Sicherheits- und Leistungsfähigkeitsforschung grundsätzlich schwierig ist.
Die Zahlen sollten daher als Momentaufnahme und nicht als universelles oder dauerhaftes Verhältnis betrachtet werden.
Auch das Messsystem hat Grenzen
Anthropic geht ungewöhnlich offen auf die Grenzen seiner Methodik ein.
Wichtige Vorbehalte sind:
- Claude bewertet teilweise von Claude unterstützte Arbeit.
- Die Grenzen zwischen den Automatisierungsstufen sind subjektiv.
- Der Aufgabenkatalog basiert auf einer eingefrorenen Ausgangsbasis und kann neu entstehende Arbeitskategorien übersehen.
- Das Überwachungssystem arbeitet erst seit Monaten und nicht seit Jahren in diesem Maßstab.
- Eine sehr niedrige Blockierungsquote beweist nicht, dass jedes schädliche Verhalten erkannt wird.
- Das Codevolumen entspricht nicht automatisch der Produktivität oder Qualität.
- KI-geleitete Arbeit ist nicht dasselbe wie vollständig autonome Arbeit.
Diese Einschränkungen machen die Zahlen nicht bedeutungslos.
Sie machen sie aussagekräftiger, wenn sie als Trendmessungen und nicht als absoluter Beweis für Autonomie interpretiert werden.
FAQ
Was bedeutet es, dass Claude 26 % der KI-Forschung und -Entwicklung bei Anthropic leitet?
Es bedeutet, dass 26 % der gewichteten KI-Forschungs- und Entwicklungsarbeit von Anthropic derzeit als AL4 bewertet werden. Auf dieser Stufe kann Claude den Großteil einer Aufgabe von Anfang bis Ende auf Grundlage einer übergeordneten Anfrage erledigen. Menschen überwachen, prüfen und genehmigen die Arbeit weiterhin. Es handelt sich daher nicht um vollständig autonome Forschung.
Was ist der Unterschied zwischen AL4 und AL5?
AL4 bedeutet, dass die KI den Großteil der Aufgabe leitet, während ein Mensch für Überwachung und Freigabe verantwortlich bleibt. AL5 bedeutet, dass die Arbeit von Anfang bis Ende autonom mit wenig oder ohne menschliche Beteiligung erledigt wird. Anthropic zufolge hat keine der gemessenen KI-Forschungs- und Entwicklungsarbeiten AL5 erreicht.
Schreibt Claude tatsächlich mehr als 80 % des Codes von Anthropic?
Anthropic berichtete, dass im Mai 2026 mehr als 80 % des in den eigenen Codebestand zusammengeführten Codes von Claude verfasst wurden. Diese Kennzahl bezieht sich auf zusammengeführten Code und nicht auf 80 % der gesamten Forschung, Produktentscheidungen oder Modellentwicklung.
Wie viele KI-Agenten betreibt Anthropic intern?
Anthropic zufolge arbeiteten im August 2026 zu jedem beliebigen Zeitpunkt ungefähr 30.000 Agenten auf der meistgenutzten internen Plattform an Forschungs- und Entwicklungsaufgaben. Die Zahl gilt für die gemessene interne Plattform und sollte nicht als Anzahl dauerhaft beschäftigter, menschlicher Ersatzarbeitskräfte interpretiert werden.
Wie überwacht Anthropic so viele Agenten?
Das Unternehmen nutzt eine Online-Überwachung vor der Ausführung und eine Offline-Überwachung nach den Aktionen. Anthropic zufolge durchlaufen 100 % der Aktionen auf der gemessenen Plattform den Online-Monitor. Offline-Systeme markieren Transkripte für eine weitere automatische und menschliche Prüfung.
Was bedeutet die Blockierungsquote von 0,002 %?
Anthropic zufolge blockierte der Online-Monitor im August 2026 ungefähr 0,002 % von mehr als einer Milliarde Agentenentscheidungen, also etwa 1 von 47.000. Das ist eine Überwachungsstatistik und kein Beweis dafür, dass jede nicht blockierte Entscheidung sicher oder korrekt war.
Hat Claude die rekursive Selbstverbesserung erreicht?
Nicht nach Anthropics eigener Definition. Anthropic definiert die stärkere Form der rekursiven Selbstverbesserung als den Zustand, in dem ein Modell seinen Nachfolger vollständig autonom entwickelt. Die aktuellen Daten des Unternehmens zeigen jedoch, dass keine gemessene Kategorie der KI-Forschung und -Entwicklung die Autonomiestufe AL5 erreicht hat.
Warum veröffentlicht Anthropic diese Automatisierungskennzahlen?
Anthropic argumentiert, dass Öffentlichkeit, Regierungen und unabhängige Prüfer Einblick darin benötigen, wie schnell Spitzenlabore die Modellentwicklung automatisieren. Das Unternehmen möchte Kennzahlen zu Automatisierung, Agentenaufsicht und Rechenkapazitätsverteilung als nachverfolgbare Signale etablieren, die künftige Sicherheitsanforderungen beeinflussen können.
Verwandte Tools
- Claude Code: Anthropics agentische Programmierumgebung für Softwareentwicklungsaufgaben auf Repository-Ebene.
- Claude API: Offizielle Entwicklerplattform zum Erstellen von Anwendungen und Agenten mit Claude-Modellen.
- Claude: Anthropics zentrale Benutzeroberfläche für die Arbeit mit Claude-Modellen.
- Epoch AI: Unabhängige Forschungsorganisation, deren Skala zur Automatisierung von KI-Forschung und -Entwicklung in Anthropics Messrahmen verwendet wird.
- METR: Unabhängige Forschungsorganisation zur Bewertung der Autonomie von Spitzenmodellen, die Anthropics Überwachungssysteme einem Red-Team-Test unterzogen hat.
Verwandte Links
- Anthropic: Measurements for Understanding the Pace of AI Development: Offizielle Quelle für den Anteil von 26 % KI-geleiteter F&E, die Größenordnung von 30.000 Agenten, Überwachungsstatistiken und die Methodik zur Verteilung der Rechenkapazität.
- Anthropic: When AI Builds Itself: Offizieller Bericht zum Anteil von über 80 % zusammengeführtem Code, zu Veränderungen der Entwicklungsproduktivität und zu Szenarien rekursiver Selbstverbesserung.
- Epoch AI: Toward an O*NET for AI R&D: Das sechsstufige Automatisierungsmodell von AL0 bis AL5, das Anthropic verwendet.
- Anthropic Frontier Safety Roadmap: Anthropics aktuelle Sicherheits-Roadmap für den Anstieg automatisierter F&E-Fähigkeiten.
- Anthropic Transparency Hub: Offizielle Übersicht zu Modellrisikoberichten, Fähigkeitsschwellen und Sicherheitsangaben.
- Anthropic Research: Offizielle Übersicht über Anthropics Forschungsarbeiten zu Agenten, Alignment, Wissenschaft und Modellverhalten.
Zusammenfassung
Anthropics aktuelle interne Messungen zeigen eine schnelle Verschiebung hin zu KI-geleiteter Modellentwicklung. Im August 2026 leitete Claude 26 % der gewichteten KI-Forschungs- und Entwicklungsarbeit, mehr als 90 % erreichten mindestens die Mensch-KI-Zusammenarbeit, und rund 30.000 Agenten liefen gleichzeitig auf Anthropics meistgenutzter interner Forschungsplattform.
Unabhängig davon erklärte Anthropic, dass im Mai 2026 mehr als 80 % des in den eigenen Codebestand zusammengeführten Codes von Claude verfasst wurden. Diese Zahl ist ein deutlicher Beleg dafür, dass KI bereits tief in die Entwicklung der Systeme eingebunden ist, aus denen zukünftige Claude-Modelle hervorgehen werden. Sie sollte jedoch nicht mit der umfassenderen Automatisierungsrate der F&E verwechselt werden.
Am wichtigsten ist, dass Anthropic weiterhin null gemessene Kategorien der KI-Forschung und -Entwicklung auf der Stufe AL5 mit vollständiger Autonomie meldet. Das Unternehmen bewegt sich eindeutig in Richtung einer stärker KI-gesteuerten KI-Entwicklung, hat aber nicht erklärt, dass vollständig autonome rekursive Selbstverbesserung bereits erreicht wurde.
Das klarste Signal lautet heute nicht, dass Claude Anthropics Forschende ersetzt hat, sondern dass sich der Schwerpunkt von Menschen, die mit Unterstützung von KI arbeiten, hin zu Menschen verschiebt, die zunehmend KI-geleitete F&E-Workflows überwachen.