For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/gemini-35-flash-entwicklerleitfaden-3-api-fallen-mcp-agentenmuster-und-migrations-checkliste.md.
Ein praxisnaher Entwicklerleitfaden zu Gemini 3.5 Flash, der drei kostspielige Fallstricke bei der API-Migration, GitHub Copilots 14-fache A...
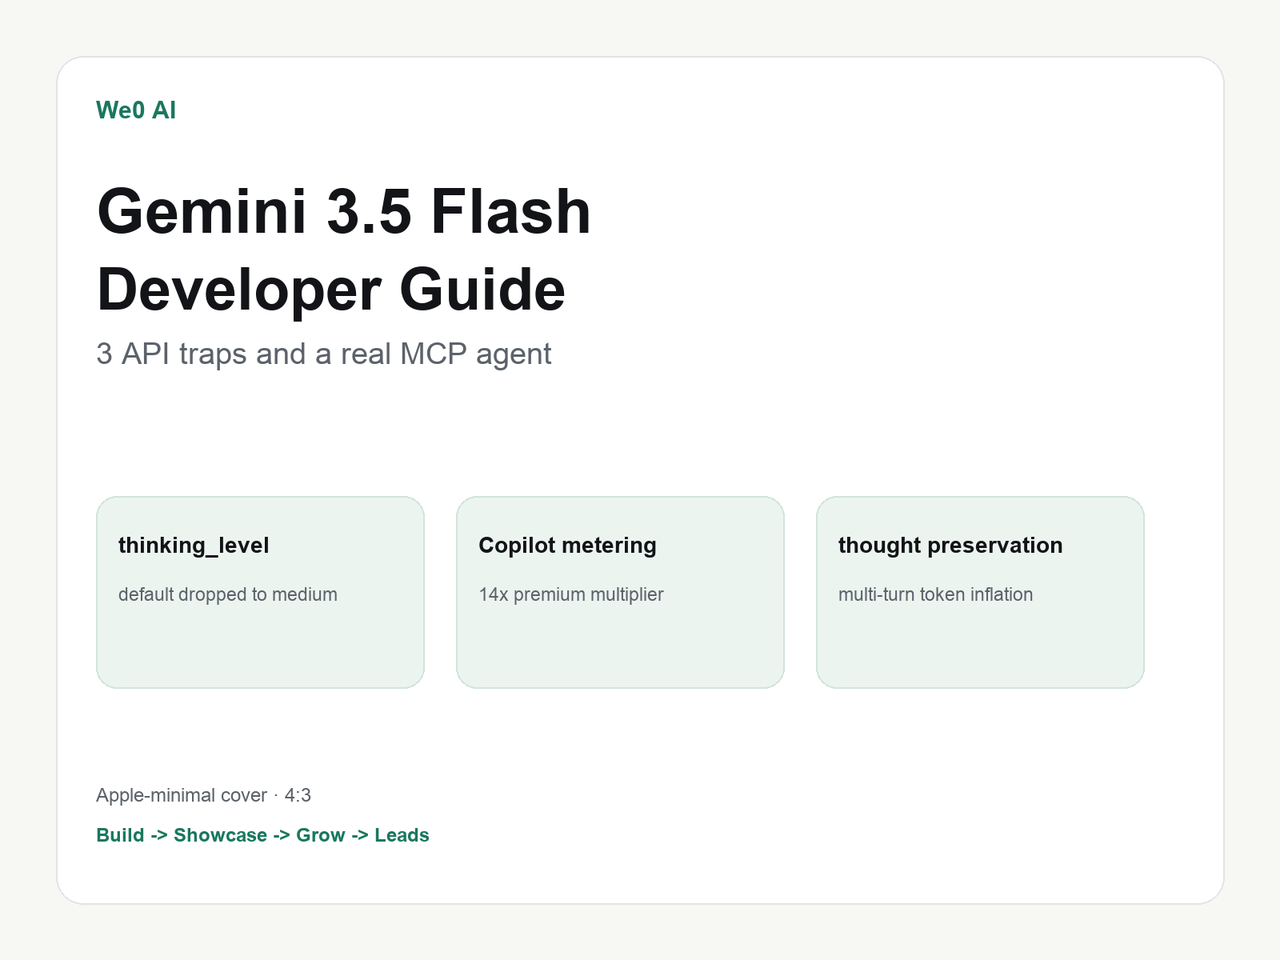
Die teuersten Fehler bei Gemini 3.5 Flash sind stille Standardwerte, nicht Syntaxfehler.
Für viele Coding-Agents ist low der bessere Standard, als die meisten erwarten.
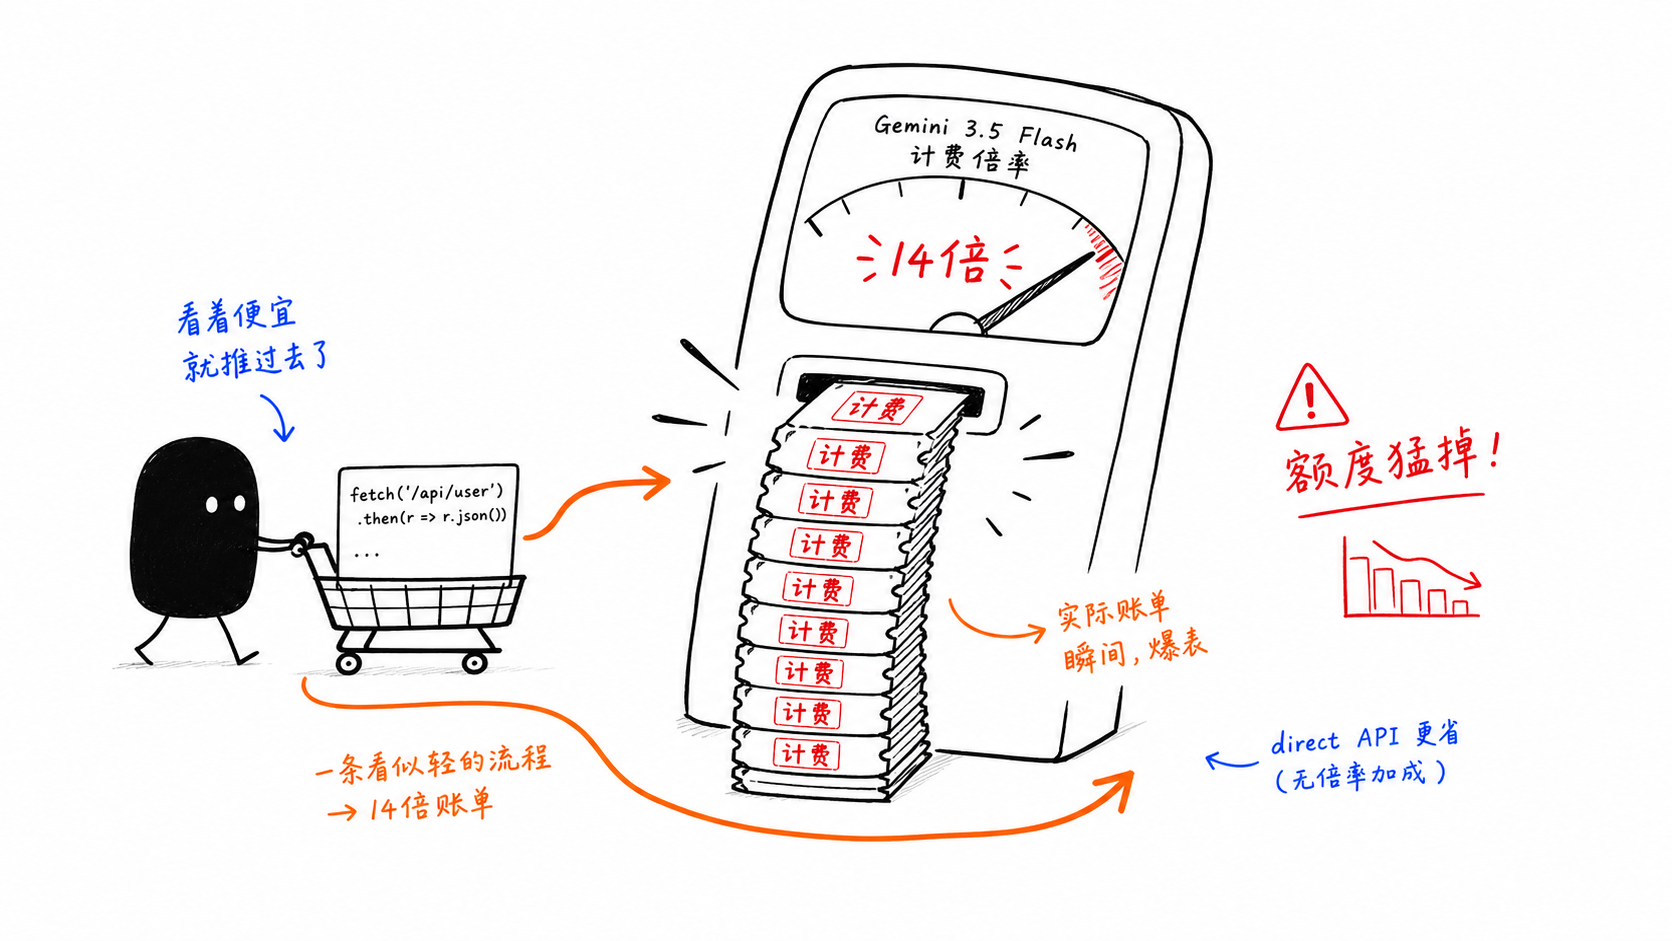
Umfangreiche Agent-Schleifen über GitHub Copilot können durch die 14-fache Abrechnung deutlich teurer werden.
Bei We0 AI ist die Modellauswahl nur ein Teil des Workflows. Der Rest besteht darin, wie das Produkt erklärt, sichtbar gemacht und entdeckt wird.
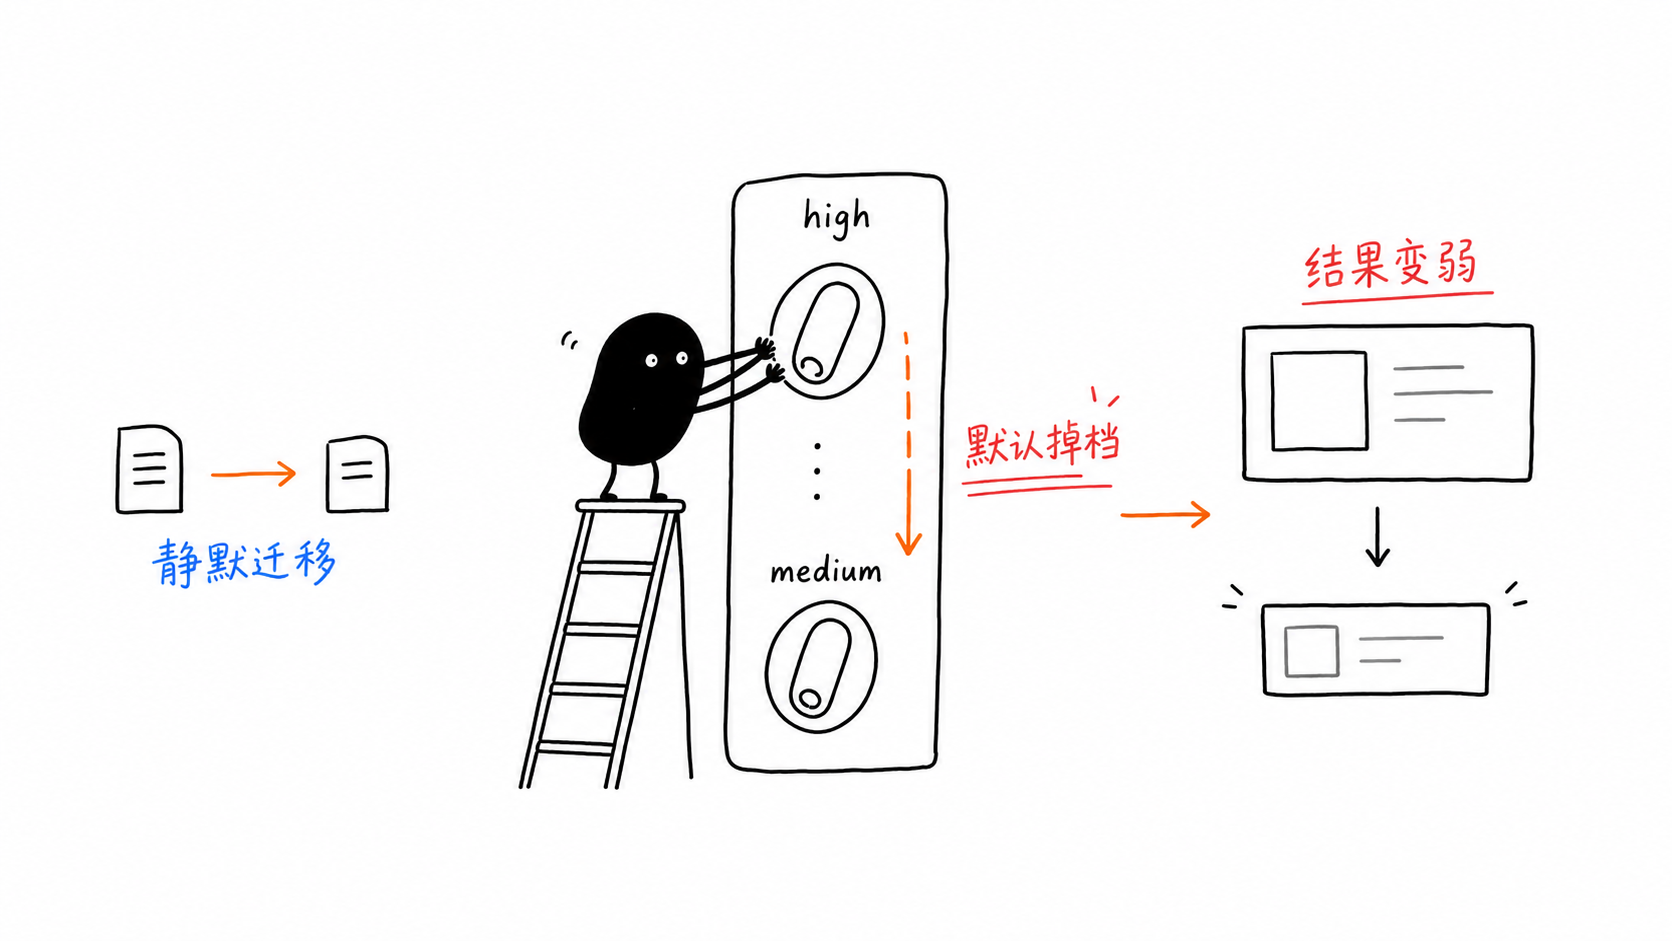
gemini-3.5-flash wirkt leicht aufzurufen.
Genau deshalb wird es leicht unterschätzt. Schon eine kleine Migration von Code aus der Preview-Ära kann schlechtere Ausgaben, ein anderes Kostenprofil und teurere Multi-Turn-Schleifen verursachen, ohne jemals einen sichtbaren Fehler auszulösen.
Dieser Leitfaden konzentriert sich auf die drei wichtigsten Fallen, die Code-Struktur, die sie vermeidet, und eine praktische MCP-ähnliche Agent-Schleife, die du schnell anpassen kannst.
thinking_level wurde von Hoch auf Mittel gesenktDas ist gefährlich, weil nichts abstürzt.
Du übernimmst den alten Code, die Anfrage liefert weiterhin eine Antwort, aber das Modell schlussfolgert nicht mehr auf dem Niveau, das du vorausgesetzt hast.
Wert
Was es bewirkt
Wann man es verwenden sollte
minimal
Schlussfolgern auf absolutem Minimum
Autocomplete, Klassifizierung, Single-Shot-Vervollständigungen
Coding-Agents, MCP-Tool-Schleifen, mehrstufige Workflows
medium
Consumer-Chat, allgemeine Fragen und Antworten
high
Maximaler Schlussfolgerungsaufwand
Schwieriges Schlussfolgern, Debugging neuartiger Probleme, Mathematik, Planung
response = client.models.generate_content(
    model="gemini-3-flash-preview",
    contents=prompt,
)

response = client.models.generate_content(
    model="gemini-3.5-flash",
    contents=prompt,
)
Der zweite Ausschnitt wird ausgeführt, aber die Standardwerte sind nicht mehr dieselben.
from google import genai
import os

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

response = client.models.generate_content(
    model="gemini-3.5-flash",
    contents=prompt,
    config={
        "thinking_config": {
            "thinking_level": "high"  # or "low" for coding agents
        }
    },
)Bei vielen Coding-Agent-Workflows solltest du mit low beginnen, nicht mit high.
Der praktische Grund ist einfach:
schneller
günstiger
für tool-lastige Coding-Schleifen oft gut genug oder vergleichbar
Das Problem ist nicht der Listenpreis des Modells. Es ist der Premium-Request-Multiplikator innerhalb von GitHub Copilot. Sobald Flash agentisch eingesetzt wird, verändert sich die Kostenstruktur schnell.
leichtgewichtige interaktive Nutzung bleibt innerhalb von Copilot
umfangreiche Schleifen und batchartige Workflows laufen über die direkte API
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Architektur wird zu Kostenkontrolle.
Gemini 3.5 Flash übernimmt internes Schlussfolgern über mehrere Turns hinweg.
Das verbessert die Kohärenz, bedeutet aber auch, dass diese Gedanken in der späteren Token-Abrechnung weiterhin auftauchen können.
Bei langen Agent-Schleifen kann das den Token-Verbrauch erheblich erhöhen.
Chats an sauberen Phasengrenzen zurücksetzen
nur das zusammenfassen und weitertragen, was wichtig ist
Prompt-Caching für stabile Anweisungen und Tool-Definitionen verwenden
das Verhältnis von Thought-Tokens zu Prompt-Tokens im Zeitverlauf beobachten
Der Originalartikel enthält ein sehr nützliches End-to-End-Muster: ein Tool zum Lesen von Dateien, ein Tool zum Abrufen von URLs, eine standardmäßige Struktur für Funktionsdeklarationen und eine Schleife, die Tool-Antworten zurück an das Modell sendet.
import os
import httpx
from pathlib import Path
from google import genai
from google.genai import types

client = genai.Client(api_key=os.environ["GEMINI_API_KEY"])

read_file = types.FunctionDeclaration(
    name="read_file",
    description="Read a local file and return its contents as text.",
    parameters={
        "type": "object",
        "properties": {
            "path": {
                "type": "string",
                "description": "Absolute path to the file"
            }
        },
        "required": ["path"],
    },
)

fetch_url = types.FunctionDeclaration(
    name="fetch_url",
    description="Fetch a URL and return the response body as text.",
    parameters={
        "type": "object",
        "properties": {
            "url": {
                "type": "string",
                "description": "Fully-qualified URL"
            }
        },
        "required": ["url"],
    },
)tools = types.Tool(function_declarations=[read_file, fetch_url])
def execute_tool(call):
if call.name == "read_file":
return Path(call.args["path"]).read_text(encoding="utf-8")
if call.name == "fetch_url":
return httpx.get(call.args["url"], timeout=15).text[:50000]
raise ValueError(f"Unknown tool: {call.name}")
def run_agent(task: str, max_turns: int = 8):
history = [types.Content(role="user", parts=[types.Part(text=task)])]
for _ in range(max_turns):
response = client.models.generate_content(
model="gemini-3.5-flash",
contents=history,
config=types.GenerateContentConfig(
tools=[tools],
thinking_config=types.ThinkingConfig(thinking_level="low"),
),
)
if not response.function_calls:
return response.text
history.append(response.candidates[0].content)
tool_results = []
for call in response.function_calls:
result = execute_tool(call)
tool_results.append(
types.Part(
function_response=types.FunctionResponse(
id=call.id,
name=call.name,
response={"result": result},
)
)
)
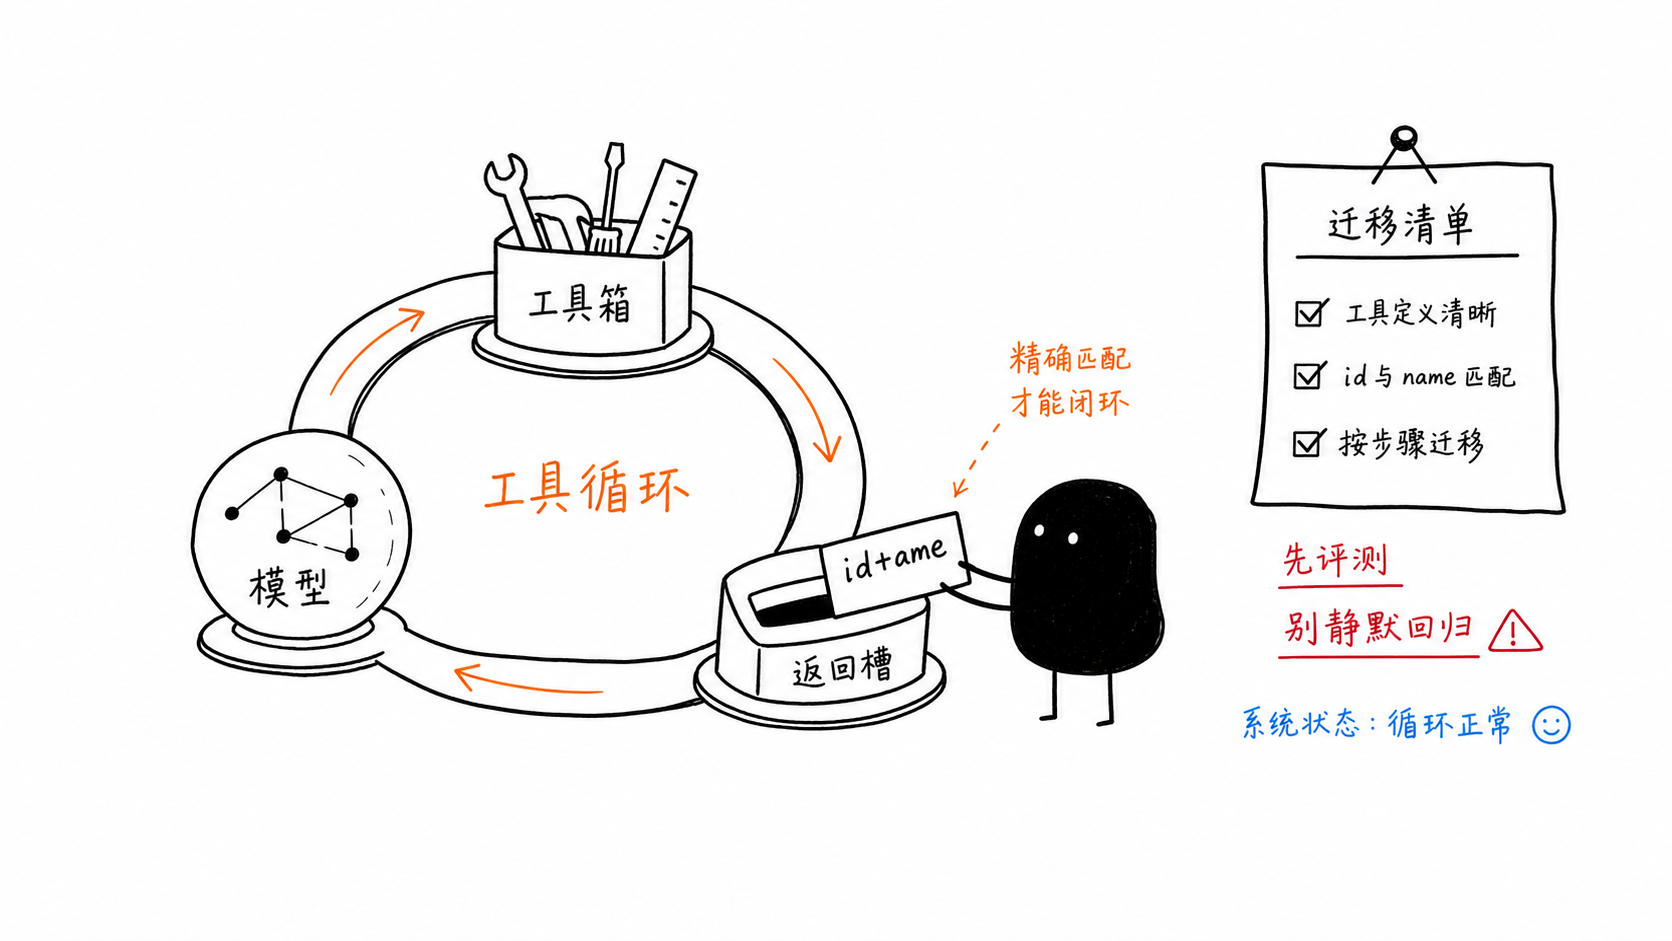
history.append(types.Content(role="tool", parts=tool_results))Die kleine, aber entscheidende Migrationsregel ist, dass Ihre Funktionsantwort sowohl mit id als auch mit name aus dem ursprünglichen Aufruf übereinstimmen muss.
Tool-Loops manuell zu erstellen, ist für Prototypen in Ordnung. In der Produktion bauen Sie jedoch schnell Orchestrierung, Caching, Routing, Wiederholungslogik und Beobachtbarkeit neu auf.
Deshalb lautet die wichtigere Frage nicht nur: „Kann ich dieses Modell integrieren?“, sondern auch: „Wie viel Agenten-Infrastruktur werde ich gleich selbst besitzen und betreiben müssen?“
Wenn Sie von gemini-3-flash-preview zu gemini-3.5-flash wechseln, prüfen Sie diese Punkte ausdrücklich:
die Modell-ID sorgfältig ersetzen
thinking_level gezielt festlegen
veraltete Sampling-Überschreibungen entfernen, es sei denn, Evaluierungen rechtfertigen sie
id und name in Tool-Antworten abgleichenresponse.usage_metadata.thoughts_token_count prüfen
bei der Preview bleiben für nicht unterstützte APIs, auf die Sie weiterhin angewiesen sind
Vorher-/Nachher-Evaluierungen durchführen
die Copilot-Abrechnung mit direkten API-Kosten vergleichen
Wenn Ihr Ziel nicht nur das Testen von Prompts ist, sondern auch das Verbinden von Dateien, Repositories, APIs, Dokumentationen und Agenten-Workflows, benötigen Sie in der Regel mehr als nur einen rohen Modell-Endpunkt.
Bei We0 AI geht dieses Prinzip noch einen Schritt weiter: Der Agenten-Workflow ist nur die halbe Arbeit. Der Rest besteht darin, das Produkt durch Dokumentation, FAQs, Produktseiten, Showcase-Inhalte sowie SEO-/GEO-Flächen verständlich, auffindbar, empfehlenswert und konvertierend zu machen.
Der Aufruf selbst ist kurz. Entscheidend ist, thinking_level ausdrücklich festzulegen, damit die Migration die Ausgabequalität nicht unbemerkt verschlechtert.
thinking_level?minimal für sehr leichte Aufgaben
low für Coding- und agentische Workflows
medium als standardmäßige Voreinstellung im Consumer-Stil
high für anspruchsvolleres Schlussfolgern und tiefere Planung
Weil der Abrechnungs-Multiplikator die Wirtschaftlichkeit verändert. Bei intensiver Agentennutzung kann das die Kostenseite stärker dominieren als der Basispreis des Modells.
Dabei trägt das Modell internes Schlussfolgern über mehrere Turns hinweg weiter. Das verbessert die Kohärenz über mehrere Interaktionen, erhöht aber auch die Wahrscheinlichkeit, dass die Token-Kosten im Laufe der Zeit steigen.
Ja, insbesondere wenn Tool-Schemata, Antwortabgleich, thinking_level und Token-Budgetierung sorgfältig gehandhabt werden.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.