For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/gpt-6-speed-boost-astra-and-6-1-sol-gain-90356630.md.
OpenAI hat eine 28-tägige Serie von Produktverbesserungen mit einer Änderung begonnen, die Nutzer sofort spüren können: **GPT-6 Astra und GP...
OpenAI hat eine 28-tägige Serie von Produktverbesserungen mit einer Änderung begonnen, die Nutzer sofort spüren können: GPT-6 Astra und GPT-6.1 Sol sind bei der Nutzung über berechtigte ChatGPT-Abonnements jetzt standardmäßig etwa 50 % schneller.
Die Verbesserung gilt für OpenAI-Produkte und Partnertools, die Sign in with ChatGPT unterstützen, darunter OpenCode, Pi, Amp und Devin.
Es ist keine Codeänderung erforderlich.
OpenAI-Engineering-Leiter Thibault „Tibo“ Sottiaux erklärte, dass die Standardgeschwindigkeit für Abonnements um etwa 50 % optimiert worden sei. Messungen aus der Community beziffern den praktischen Sprung auf ungefähr 30 Token pro Sekunde auf rund 50 Token pro Sekunde, wobei der genaue Durchsatz je nach Modell, Aufgabe, Produkt und Laufzeitbedingungen variiert.
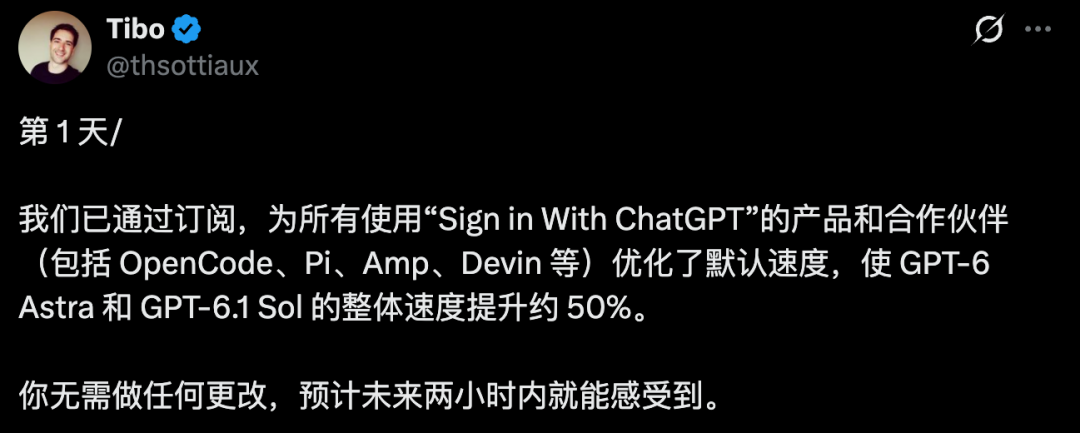
Tibos Ankündigung an Tag 1 besagt, dass GPT-6 Astra und GPT-6.1 Sol über den Abonnementzugang etwa 50 % schneller sind.
Der Zeitpunkt ist bemerkenswert, weil parallel dazu eine weitere Diskussion stattfindet.
SemiAnalysis hat eine detaillierte Studie zur Belastungsprüfung von KI-Abonnements für Endkunden veröffentlicht. Unter seinen Annahmen für agentische Workloads bieten Claude-Opus-5.5-Abonnements mehr als den fünffachen API-äquivalenten Wert von GPT-6.1-Sol-Plänen zum gleichen monatlichen Preis.
OpenAI hat die Modelle also schneller gemacht.
Die schwierigere Frage lautet, ob die Abonnementökonomie für Nutzer, die lange, autonome Coding- und Agenten-Workflows ausführen, weiterhin wettbewerbsfähig aussieht.
Das erste Update in OpenAIs 28-tägigem Veröffentlichungszyklus zielt auf eine der offensichtlichsten Reibungsquellen bei fortgeschrittener Coding- und Agentenarbeit: die Generierungslatenz.
Tibo schrieb, dass OpenAI die Standardgeschwindigkeit von GPT-6 Astra und GPT-6.1 Sol über den Abonnementzugang um etwa 50 % optimiert habe.
Der Rollout gilt für:
Der Nutzer muss weder eine Konfiguration ändern noch einen API-Endpunkt wechseln.
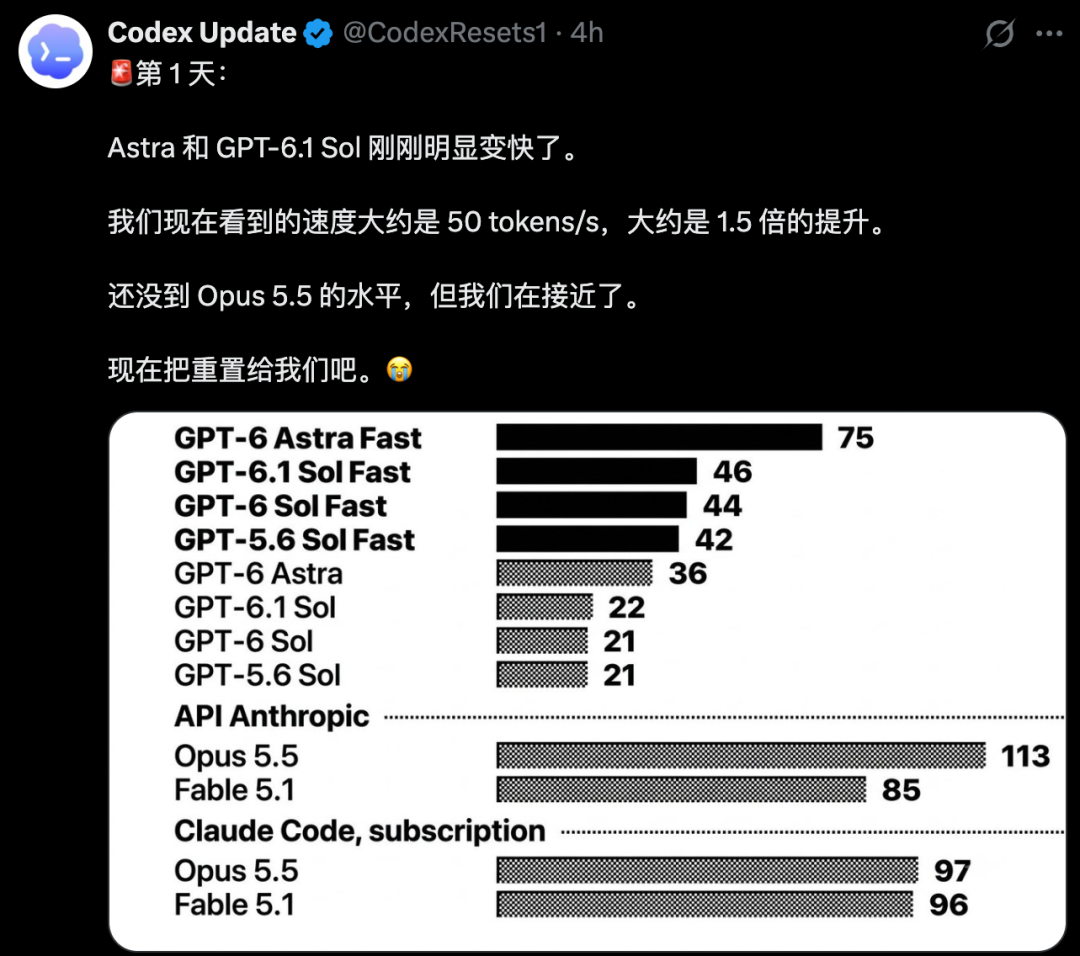
Messungen aus der Community zeigen einen sichtbaren Geschwindigkeitsanstieg, obwohl der Durchsatz je nach Modell und Zugangspfad unterschiedlich ist.
Der Quellartikel fasst die Änderung als einen Sprung von ungefähr Folgendem zusammen:
~30 Token/Sekunde
        ↓
~50 Token/Sekunde
Das ist eine hilfreiche Verkürzung, doch die offizielle Ankündigung formuliert den Fortschritt als „etwa 50 % schneller“ und nicht als garantiertes festes Dienstniveau von 50 TPS.
Verschiedene Tester können unterschiedliche Werte beobachten.
Die Geschwindigkeitsverbesserung ist der erste Eintrag in einer umfassenderen 28-tägigen Initiative.
Tibo sagte, dass OpenAI in den nächsten 28 Tagen beabsichtige, entweder Folgendes bereitzustellen:
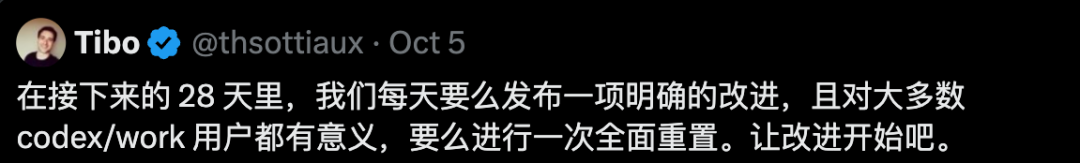
Die 28-tägige Initiative konzentriert sich auf Vereinfachung, Effizienz, neue Funktionen und Modellverbesserungen.
Die genannten Prioritäten sind:
Die Botschaft richtet sich insbesondere an Codex- und Work-Nutzer, bei denen Geschwindigkeit und Nutzungslimits bei lang laufenden Aufgaben deutlich sichtbarer sind als in einem kurzen Chat.
Der Originalartikel besagt, dass die Änderung teilweise durch einen „aggressiv“ optimierten Tokenizer entstanden sei, der die für dieselbe Aufgabe benötigte Tokenanzahl reduziert.
Diese konkrete Behauptung sollte vorsichtig behandelt werden.
Die für diesen Artikel geprüften öffentlichen Aussagen von OpenAI-Mitarbeitern beschreiben das Update an Tag 1 als Inferenzoptimierung und Verbesserung der Standardgeschwindigkeit.
Sie dokumentieren öffentlich keinen Rollout eines neuen Tokenizers für GPT-6 Astra oder GPT-6.1 Sol als Mechanismus hinter diesem speziellen Gewinn von 50 %.
Diese Unterscheidung ist wichtig.
Es gibt mehrere Wege, den wahrgenommenen Durchsatz zu verbessern:
Ohne eine offizielle technische Notiz ist es sicherer zu sagen, dass OpenAI die Inferenz optimiert hat, statt die Verbesserung einer bestimmten Tokenizer-Architektur zuzuschreiben.
Eine Verbesserung der Modellgenerierungsgeschwindigkeit um 50 % bedeutet nicht, dass jede vollständige Aufgabe 50 % früher abgeschlossen ist.
Agenten-Workflows benötigen Zeit für mehr als nur die Tokengenerierung.
Eine typische Coding-Aufgabe kann Folgendes umfassen:
Modellschlussfolgerung
      ↓
Tool-Aufruf
      ↓
Shell-Befehl oder Browseraktion
      ↓
Datei lesen/schreiben
      ↓
Netzwerkwarten
      ↓
Weitere Modellrunde
Wenn Tools, Websites, Builds, Tests oder externe APIs die verstrichene Gesamtzeit dominieren, kann eine schnellere Tokengenerierung nur einen Teil der gesamten Aufgabendauer verkürzen.
Der Quellartikel weist außerdem darauf hin, dass einige Entwickler nicht sofort einen dramatischen Unterschied wahrgenommen haben.
Das ist plausibel.
Die wahrgenommene Geschwindigkeit hängt ab von:
Das Update ist real, sollte jedoch nicht als universelle Garantie interpretiert werden, dass jede End-to-End-Aufgabe in zwei Dritteln der bisherigen Zeit abgeschlossen wird.
In derselben Woche veröffentlichte SemiAnalysis einen detaillierten Vergleich von Limits bei KI-Abonnements.
Die Forscher kauften Abonnementpläne, führten kontrollierte Workloads aus, bis Nutzungsanzeigen reagierten oder Limits erreicht waren, und rechneten diese Limits in einen API-äquivalenten Dollarwert um.
Ihre Methodik misst getrennt:
Anschließend kombinieren sie diese Raten unter Verwendung eines repräsentativen agentischen Workloads.
SemiAnalysis testete Abonnementlimits bei OpenAI, Anthropic und mehreren weiteren KI-Anbietern.
Der zentrale Vergleich im Quellartikel ist GPT-6.1 Sol gegenüber Claude Opus 5.5.
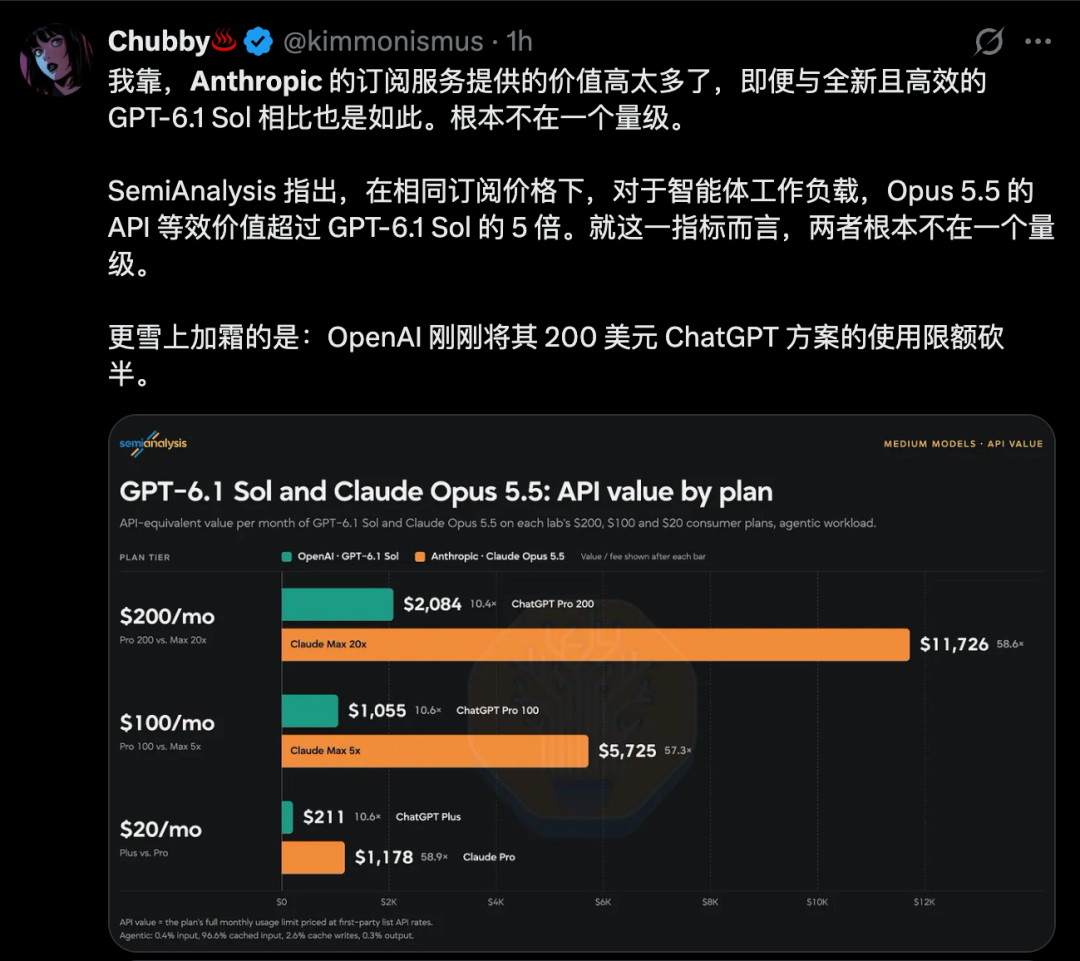
SemiAnalysis schätzt unter seinen Annahmen für agentische Workloads einen mehr als fünffachen Vorteil für Claude Opus 5.5.
Das veröffentlichte Diagramm liefert folgende Momentaufnahme:
| Monatlicher Plan | OpenAI / GPT-6.1 Sol | Anthropic / Claude Opus 5.5 | Ungefähres Verhältnis |
|---|---|---|---|
| 200 $ | 2.084 $ API-äquivalenter Wert | 11.726 $ | 5,6× |
| 100 $ | 1.055 $ | 5.725 $ | 5,4× |
| 20 $ | 211 $ | 1.178 $ | 5,6× |
Diese Zahlen bedeuten nicht, dass ein Anthropic-Abonnement für 200 $ dem Kunden buchstäblich 11.726 $ auszahlt.
Sie bedeuten, dass der Verbrauch derselben Menge unter den von SemiAnalysis gemessenen Limits und dem angenommenen Workload-Mix bei Nutzung veröffentlichter API-Preise theoretisch ungefähr so viel kosten würde.
Eine Community-Visualisierung der 200-Dollar-Stufe erleichtert es, den Unterschied zu erkennen.
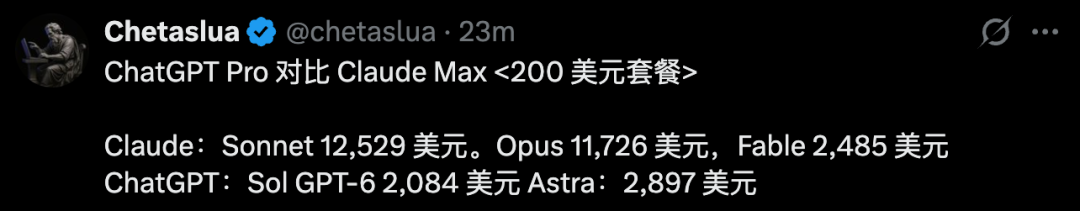
Der Vergleich der 200-Dollar-Stufen variiert erheblich, abhängig davon, welches Modell verwendet wird.
Die wichtige Nuance ist die Modellwahl.
SemiAnalysis warnt ausdrücklich davor, den Wert eines Abonnements mit einer universellen Zahl zusammenzufassen.
Die korrekte Einheit ähnelt eher Folgendem:
(Plan, Modell, Workload)
Ein Abonnement kann für ein Modell äußerst großzügig wirken und für ein anderes deutlich weniger großzügig sein.
SemiAnalysis zufolge nahm OpenAI kurz vor dem Bericht eine bedeutende Änderung bei Abonnements vor.
Die Tests des Unternehmens bestätigten für neu abgeschlossene Abonnements eine ungefähre Senkung der Tokenlimits des 200-Dollar-Plans von 50 %.
Ältere 200-Dollar-Pläne genossen vorübergehend Bestandsschutz unter den vorherigen Limits bis zum 29. Oktober.
SemiAnalysis weist außerdem darauf hin, dass OpenAI eine neue Stufe für 500 $ eingeführt habe.
Der Artikel berichtet, dass die 200-Dollar-Stufe früher einen ungewöhnlich großzügigen Wert geboten hatte, insbesondere für intensive Codex-Nutzer.
Nach der Kürzung wurden die Tokenökonomie pro Dollar der OpenAI-Stufen Pro 100, Pro 200 und Pro 500 deutlich ähnlicher.
Das ist ein Teil des Grundes, weshalb der Vergleich mit Anthropic so drastisch wirkt.
Traditionelle Chat-Nutzung erfolgt in Schüben.
Eine Person stellt eine Frage, liest die Antwort, denkt nach und kehrt später zurück.
Agentisches Coding kann sich ganz anders verhalten.
Eine einzelne Aufgabe kann:
Das erzeugt erheblich mehr Modellaktivität als ein kurzer Gesprächsaustausch.
SemiAnalysis argumentiert, dass Abonnementpläne stark subventioniert sind, weil die meisten Nutzer ihr maximal theoretisch verfügbares Kontingent nicht ausschöpfen.
Intensive Agentennutzer stellen diese Annahme infrage.
Der Quellartikel beschreibt dies als Wandel von „die meisten Nutzer schöpfen ihr vollständiges Kontingent nicht aus“ hin zu Workflows, die sehr große Mengen an Inferenz verbrauchen können.
Das stimmt in der Richtung mit der breiteren Analyse von SemiAnalysis überein, obwohl die genaue Break-even-Auslastung von Annahmen zu Modellkosten, API-Margen, Workload-Mix und der internen Ökonomie des Anbieters abhängt.
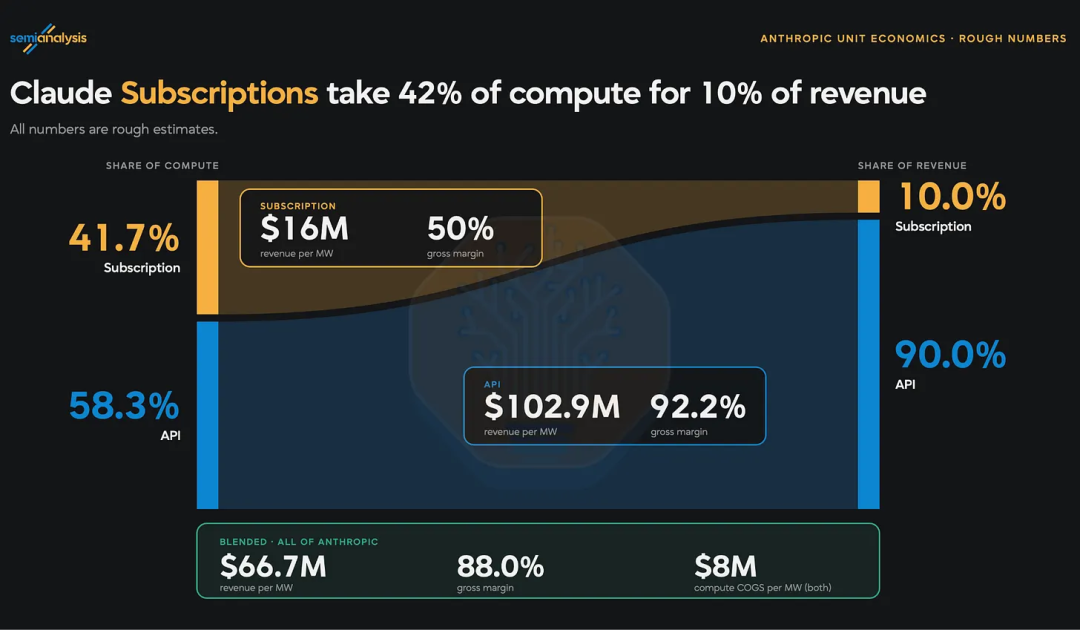
SemiAnalysis veröffentlichte außerdem ein grobes Modell der Abonnementökonomie von Anthropic.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
SemiAnalysis schätzt, dass Abonnements einen wesentlich größeren Anteil der Inferenz-Rechenleistung verbrauchen können als ihr Umsatzanteil.
Seine groben Zahlen deuten darauf hin, dass Abonnements möglicherweise nur etwa 10 % des Umsatzes ausmachen, aber mehr als 40 % der Inferenz-Rechenleistung verbrauchen.
Dabei handelt es sich um Modellschätzungen und nicht um testierte Finanzabschlüsse von Anthropic.
Sie sind nützlich, weil sie die Spannung hinter Abonnementlimits erklären.
KI-Unternehmen möchten Abonnementprodukte attraktiv genug gestalten, um Nutzer zu gewinnen, und zugleich verhindern, dass die intensivsten Agenten-Workloads unbegrenzt teure Inferenz verbrauchen.
Je autonomer Agenten werden, desto schwieriger wird diese Balance.
Der Originalartikel wechselt anschließend von Modellgeschwindigkeit und Abonnementökonomie zu einer umfassenderen Produktgeschichte.
Er zitiert einen Community-Beitrag, der behauptet, dass Chat, Work, Codex und Dots letztlich in einer einheitlichen Super-App-Oberfläche zusammengeführt werden, in der Modellauswahl und Reasoning-Steuerung vor Nutzern verborgen bleiben.
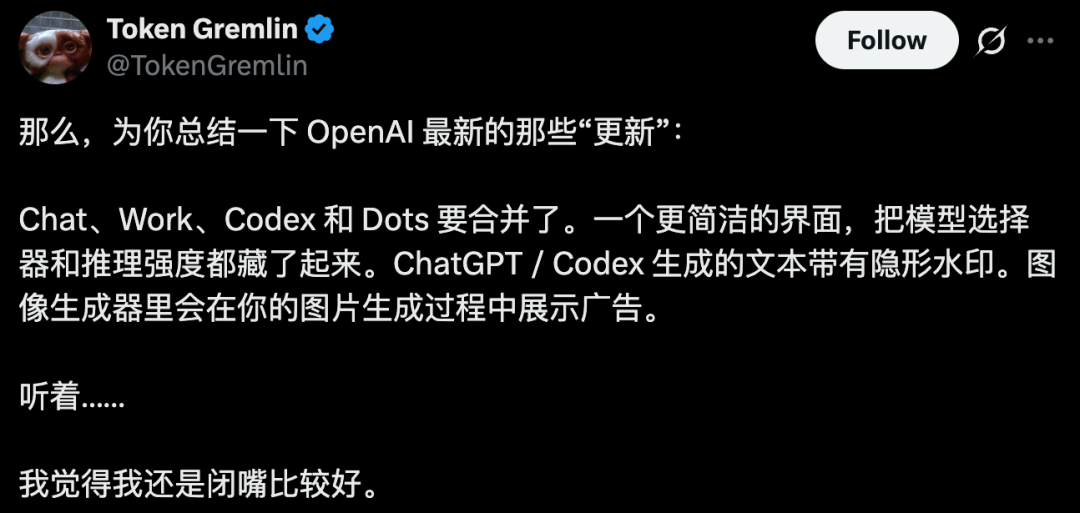
Dieser Beitrag fasst Community-Behauptungen über eine zukünftige Produktkonvergenz zusammen; nicht alle dieser Behauptungen sind offiziell.
Dieser Abschnitt erfordert eine klare Trennung zwischen Gerücht und aktueller Produktrealität.
Im aktuellen Help Center von OpenAI heißt es:
Die Idee einer vollständig zusammengeführten Chat- + Work- + Codex- + Dots-Oberfläche ist daher kein angekündigter aktueller Produktzustand.
OpenAI vereinfacht das Erlebnis eindeutig, doch die weitergehende Behauptung des Quellartikels, dass „alles zusammengeführt wird“, beruht auf Community-Interpretation und nicht auf einer veröffentlichten OpenAI-Roadmap.
Die offizielle Produktrichtung bleibt dennoch bedeutsam.
OpenAI beschreibt ChatGPT mittlerweile als Produkt mit:
Projekte können für beide Modi gemeinsamen Kontext bereitstellen.
Work kann zudem:
Das bedeutet, dass sich das Produkt bereits von einer Welt entfernt, in der jede Funktion in einer separaten Anwendung lebt.
Die Konsolidierung ist real.
Die genaue endgültige Form ist noch nicht öffentlich.
Der Quellartikel deutet an, dass Codex in einer einheitlichen Oberfläche verschwinden könnte.
Die aktuelle Dokumentation sagt etwas anderes.
Codex bleibt der Softwareentwicklung und technischer Arbeit gewidmet.
Auf dem Desktop wechseln Nutzer über das Menü oben links zwischen ChatGPT und Codex.
Codex behält seine eigenen entwicklungsorientierten Workflows und seinen eigenen Verlauf.
Das könnte sich später ändern, doch keine für diesen Artikel geprüfte offizielle Quelle besagt, dass Codex als eigenständiges Erlebnis abgeschafft wird.
Dots repräsentieren einen weiteren Teil der Produktstrategie von OpenAI.
Ein Dot ist ein ständig aktiver Agent, der von GPT-6 Astra unterstützt wird.
Er verfügt über:
Ein Dot kann auch über Messaging-Kanäle arbeiten und sich mit Erlaubnis mit dem lokalen Computer eines Nutzers verbinden.
Dadurch ähneln Dots eher einem persistenten Assistenten oder delegierten Mitarbeiter als einer normalen Chatsitzung.
Es erklärt auch, warum Nutzer und Beobachter erwarten, dass Produktgrenzen mit der Zeit verschwimmen.
Chat, Work, Codex und Dots teilen zunehmend Modelle, Tools, Dateien, Berechtigungen und Agenteninfrastruktur.
Eine gemeinsame Infrastruktur ist jedoch nicht dasselbe wie eine bestätigte Zusammenführung zu einer einzigen Oberfläche.
Der Quellartikel berichtet außerdem, dass von ChatGPT und Codex generierter Text unsichtbare Wasserzeichen erhalten wird.
Diese Aussage ist teilweise korrekt, doch der Umfang ist deutlich enger, als die ursprüngliche Formulierung vermuten lässt.
OpenAI hat offiziell ein System zur Textprovenienz mit dem Namen textGrain angekündigt.
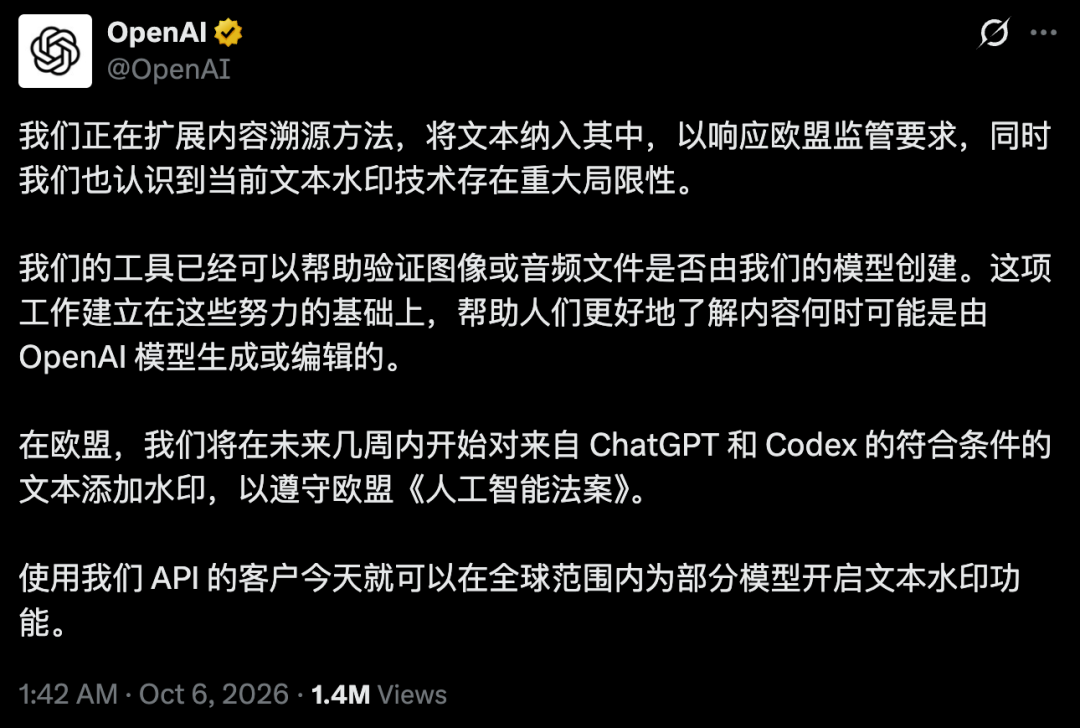
OpenAI führt Textwasserzeichen als Reaktion auf Provenienzanforderungen des EU AI Act ein.
Die aktuelle Richtlinie lautet:
Es ist daher nicht korrekt zu behaupten, dass sämtlicher ChatGPT- und Codex-Text weltweit zwangsweise mit Wasserzeichen versehen wird.
OpenAI erklärt, dass textGrain keine versteckten Zeichen oder unsichtbaren Leerzeichen einfügt.
Stattdessen verändert es subtil das Wahrscheinlichkeitsmuster bei der Auswahl von Wörtern oder Wortteilen.
Über einen ausreichend langen Textabschnitt hinweg kann ein Detektor nach diesem statistischen Signal suchen.
Dieser Ansatz hat wichtige Einschränkungen.
Paraphrasierung, Übersetzung, starke Bearbeitung oder sehr kurze Texte können das Signal abschwächen.
Ein fehlendes Wasserzeichen beweist außerdem nicht, dass ein Mensch den Text geschrieben hat.
OpenAI selbst betont diese Einschränkungen.
Werbung ist ein weiterer Bestandteil des Produktwandels, und dieser Teil ist offiziell.
Am 5. Oktober kündigte OpenAI ein neues visuelles Anzeigenformat in ChatGPT an.
Das Unternehmen erklärt, dass es das Format zunächst während der Bildgenerierung testen wird.
Der erste Rollout ist begrenzt auf:
Anzeigen sind gekennzeichnet und bleiben vom generierten Bild getrennt.
OpenAI erklärt außerdem, dass Werbung die Antworten von ChatGPT nicht beeinflusst.
Dies ist spezifischer als die Aussage, dass Nutzer unter allen Umständen während des Wartens auf die Bildgenerierung Werbung sehen werden.
Es handelt sich um einen begrenzten Test, der an Tarif, Geografie und Rollout-Status gebunden ist.
Der Artikel verbindet mehrere reale Entwicklungen, die zeitlich nah beieinander lagen.
Die klarste Art, sie zu unterscheiden, ist:
| Behauptung | Status |
|---|---|
| Die Standardgeschwindigkeit des GPT-6-Astra- und GPT-6.1-Sol-Abonnements wurde um etwa 50 % verbessert | Bestätigt |
| Die Verbesserung gilt für OpenAI-Produkte und Partner mit Sign in with ChatGPT | Bestätigt |
| Nutzer müssen Code oder Einstellungen ändern | Nein; die offizielle Ankündigung sagt, dass keine Änderung erforderlich ist |
| Der Standarddurchsatz ist garantiert exakt 50 TPS | Nicht garantiert; 50 TPS ist ein hilfreicher beobachteter bzw. zusammenfassender Wert |
| Die Beschleunigung entstand durch einen neuen aggressiven Tokenizer | In den geprüften offiziellen Materialien nicht öffentlich bestätigt |
| SemiAnalysis maß für Opus 5.5 gegenüber GPT-6.1 Sol einen mehr als fünffachen API-äquivalenten Wert | Für die angegebene Methodik zu agentischen Workloads bestätigt |
| OpenAI reduzierte die Limits neu gekaufter 200-Dollar-Pläne um etwa die Hälfte | Durch SemiAnalysis-Tests und die zitierte Ankündigung bestätigt |
| Chat, Work, Codex und Dots werden offiziell zu einer Oberfläche zusammengeführt | Nicht bestätigt |
| Die Modellauswahl wird vollständig entfernt | Nicht bestätigt; aktuelle Work-/Codex-Dokumente beschreiben weiterhin eine Modellauswahl |
| Der gesamte ChatGPT-/Codex-Text weltweit wird mit Wasserzeichen versehen | Als globale Aussage falsch |
| Berechtigter ChatGPT-/Codex-Text in der EU erhält unsichtbare Wasserzeichen | Bestätigt |
| API-Kunden können Textwasserzeichen aktivieren | Bestätigt |
| Anzeigen werden während der Bildgenerierung getestet | Bestätigt |
| Bildgenerierungsanzeigen richten sich zunächst an Free-/Go-Nutzer in den USA | Bestätigt |
Diese Unterscheidung macht die ursprüngliche Geschichte nützlicher.
Das tatsächliche Update ist bereits substanziell, ohne jedes Produktgerücht in eine feststehende Roadmap zu verwandeln.
Ja. OpenAI-Engineering-Leiter Tibo Sottiaux erklärte, dass GPT-6 Astra und GPT-6.1 Sol über berechtigten Abonnementzugang standardmäßig auf etwa 50 % mehr Geschwindigkeit optimiert wurden.
Nein. Es wurde keine feste Garantie von 50 TPS angekündigt. Community-Messungen und Zusammenfassungen verwenden ungefähr 30 bis 50 TPS, um die Änderung zu veranschaulichen, doch der tatsächliche Durchsatz variiert je nach Modell, Aufgabe, Produkt und Laufzeitbedingungen.
Die Ankündigung an Tag 1 beschreibt ausdrücklich den Abonnementzugang über OpenAI-Produkte und Partner, die Sign in with ChatGPT nutzen. Sie sollte nicht zu der pauschalen Behauptung verallgemeinert werden, dass sämtlicher API-Traffic dieselbe Änderung erhalten hat.
SemiAnalysis maß Abonnementlimits und rechnete sie anhand eines repräsentativen agentischen Workloads in einen theoretischen API-äquivalenten Wert um. Für Claude Opus 5.5 gegenüber GPT-6.1 Sol zeigte die Oktoberaufnahme bei entsprechenden Stufen von 20 $, 100 $ und 200 $ ungefähr das 5,4- bis 5,6-Fache an API-äquivalentem Wert.
OpenAI vereinfacht und verbindet diese Erlebnisse, aber es gibt keine offizielle Ankündigung, dass alle vier zu einer einzigen identischen Oberfläche werden. Die aktuelle Dokumentation behandelt Codex weiterhin als separate Entwicklungsansicht und Dots als ständig aktive Agentenfunktion.
Nein. OpenAI erklärt, dass berechtigter ChatGPT- und Codex-Text in der EU unsichtbare textGrain-Wasserzeichen erhält, während API-Kunden weltweit für ausgewählte Modelle teilnehmen können. API-Wasserzeichen sind standardmäßig deaktiviert.
OpenAI hat einen Test visueller Anzeigen während der Bildgenerierung für Free- und Go-Nutzer in den Vereinigten Staaten angekündigt. Der erste Test beginnt später im Oktober 2026, und die Anzeigen bleiben gekennzeichnet und von generierten Bildern getrennt.
Tibo kündigte einen Zeitraum von 28 Tagen an, in dem das Team täglich eine klare Verbesserung bereitstellen will, die für die meisten Codex-/Work-Nutzer relevant ist, oder einen umfassenderen Reset. Die erste angekündigte Verbesserung war die Geschwindigkeitssteigerung für GPT-6 Astra und GPT-6.1 Sol.
Das erste Update in OpenAIs 28-tägiger Veröffentlichungsinitiative ist unkompliziert: GPT-6 Astra und GPT-6.1 Sol sollten sich über berechtigten Abonnementzugang, einschließlich unterstützter Partnertools mit Sign in with ChatGPT, standardmäßig etwa 50 % schneller anfühlen.
Gleichzeitig zeigen die Abonnementtests von SemiAnalysis, warum Geschwindigkeit nur einen Teil des Wettbewerbs ausmacht. Unter seinen Annahmen für agentische Workloads bieten Claude-Opus-5.5-Abonnements derzeit mehr als den fünffachen API-äquivalenten Wert von GPT-6.1-Sol-Plänen bei vergleichbaren monatlichen Preisen.
Die Quelle verbindet diesen Moment außerdem mit umfassenderen Produktveränderungen bei OpenAI. Einige davon sind offiziell – EU-Textwasserzeichen, visuelle Anzeigen in Tests während der Bildgenerierung, Work, Dots und eine tiefere Produktintegration. Andere, etwa eine vollständige Zusammenführung von Chat, Work, Codex und Dots sowie das Verschwinden der Modellauswahl, bleiben Community-Spekulationen und keine angekündigte Produktpolitik.
GPT-6 ist schneller, doch der größere Wettbewerb verlagert sich auf die gesamte Agentenökonomie: Geschwindigkeit, Limits, Modelleffizienz, Toolzugang und die Menge realer Arbeit, die ein Abonnement erledigen kann, bevor der Zähler abläuft.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.



