For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/de/articles/vista-visual-harness-explained-lossless-v-bfcc0210.md.
Ein visuell natives Harness für multimodale Agenten ist verfügbar.
Ein visuell natives Harness für multimodale Agenten ist verfügbar.
In der Studie „VISTA: A Visual Harness for Reasoning in an Interactive World“ stellen die Forschenden Qiushi Han, Keya Hu, Linlu Qiu, Cathy Wu und Kaiming He VISTA vor – ein Framework, das allgemein einsetzbaren multimodalen Modellen dabei helfen soll, lange interaktive Aufgaben zu bewältigen, ohne bereits gesehene visuelle Informationen zu verwerfen.
Die grundlegende Idee ist einfach, aber wichtig.
Anstatt eine interaktive Umgebung in Text oder Code umzuwandeln und ein Modell dazu zu bringen, sich auf eine komprimierte Beschreibung der Vergangenheit zu verlassen, ermöglicht VISTA dem Modell:
Das Framework erfordert kein erneutes Training des zugrunde liegenden multimodalen Modells.
Diese Unterscheidung ist zentral für die Arbeit. Die Forschenden schlagen kein neues Basismodell vor. Sie verändern die Schnittstelle rund um ein bestehendes Modell, damit dieses visuelle Informationen über längere Zeit bewahren, abrufen und untersuchen kann.
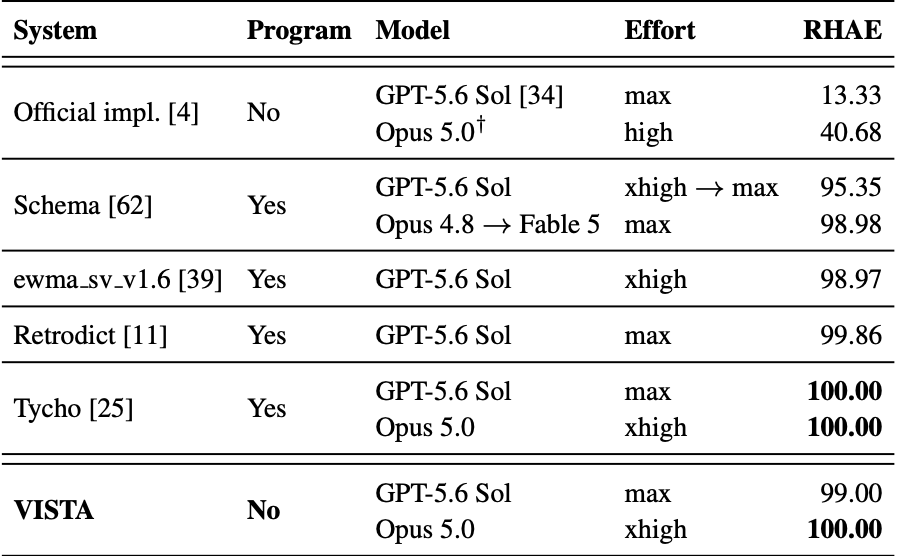
Bei den 25 öffentlichen ARC-AGI-3-Spielen erreicht VISTA mit Claude Opus 5.0 einen perfekten Wert von 100,00 Relative Human Action Efficiency (RHAE) und schließt alle 25 Spiele ab. Der Agent verwendet 57,4 % weniger Aktionen als die erstmaligen menschlichen Teilnehmenden in der Referenzbasis der Studie.
Mit GPT-5.6 Sol erreicht dasselbe VISTA-Framework einen RHAE-Wert von 99,00.
Das Team bewertet das Framework außerdem anhand von Browserspielen, Labyrinthen, Rätseln zum Verbinden von Linien und alternativen visuellen Darstellungen. Dies deutet darauf hin, dass sich die zugrunde liegende Idee weit über einen einzelnen Benchmark hinaus erstrecken könnte.
Wie funktioniert das also?
Visuelle Wahrnehmung und Repräsentationslernen waren wiederkehrende Themen in der Forschung von Kaiming He – von ResNet und Mask R-CNN bis hin zu MAE.
VISTA verlagert diese Forschungslinie auf eine andere Frage:
Wie kann ein Agent visuelle Erfahrungen sammeln, bewahren und wiederverwenden, während er kontinuierlich mit einer Umgebung interagiert?
Die Antwort ist ein Harness.
Harnesses sind zu einem zunehmend wichtigen Bestandteil langlebiger KI-Agentensysteme geworden.
Anthropic beschrieb beispielsweise zuvor, wie ein Coding-Agent eine lange Softwareaufgabe über mehrere Kontextfenster hinweg fortsetzen kann, indem er unfertige Arbeiten, Fortschrittsnotizen und den Codezustand außerhalb des unmittelbaren Gesprächskontexts speichert.
Ein sprachlich orientiertes Harness kann Informationen bewahren wie:
So kann ein Agent eine komplexe Aufgabe in Phasen unterteilen und fortsetzen, selbst wenn das ursprüngliche Kontextfenster bereits gefüllt ist.
Dieser Ansatz funktioniert gut, wenn sich der relevante Zustand in Text und Code erfassen lässt.
Interaktive visuelle Umgebungen sind jedoch anders.
Ein Modell muss sich möglicherweise merken:
Eine textuelle Zusammenfassung kann solche Details nicht immer zuverlässig bewahren.
Noch problematischer ist, dass das Modell beim ersten Sehen eines Bildes oft nicht weiß, welches visuelle Detail später wichtig werden wird.
Ein bestehender Ansatz für ARC-AGI-3 besteht darin, jeden visuellen Zustand in ein Textgitter aus Zahlen umzuwandeln. Ein Agent kann anschließend Programme schreiben, um die Umgebung zu simulieren, Regeln abzuleiten und Aktionspläne zu testen.
Diese Methode kann effektiv sein, führt jedoch eine Abstraktion ein, bevor das Modell die Szene vollständig verstanden hat.
Mit zunehmender Komplexität der Umgebung wird es schwieriger, Folgendes zu kodieren:
Und wenn die Interaktionshistorie wächst, können frühe visuelle Zustände aus dem Kontext des Modells entfernt oder durch verlustbehaftete Zusammenfassungen ersetzt werden.
Die Forschungsfrage von VISTA ist daher direkter:
Kann ein Agent die ursprünglichen visuellen Informationen später erneut untersuchen, anstatt gezwungen zu sein, seiner ersten Interpretation zu vertrauen?
Die Antwort des Frameworks lautet: ja.
Jedes von der Umgebung zurückgegebene Einzelbild wird außerhalb des aktiven Kontextfensters bewahrt. Wenn das Modell ältere Informationen benötigt, ruft es das relevante Einzelbild ab und bringt nur dieses Material wieder in den Kontext.
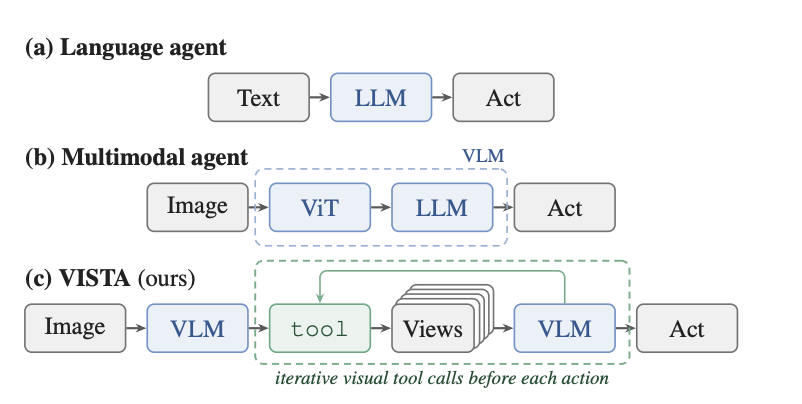
Die Forschenden beschreiben diesen Mechanismus als eine Form der expliziten Aufmerksamkeit über die Interaktionshistorie.
Anstatt die vollständige visuelle Historie automatisch in jeden Verarbeitungsschritt einzuspeisen, entscheidet das Modell, welche früheren Informationen für die aktuell zu lösende Frage relevant sind.
Das ist wichtig, weil sich das Verständnis eines Agenten im Laufe der Zeit verändert.
Stellen wir uns vor, dass das Modell in Zug 20 einen kleinen farbigen Block sieht. Zu diesem Zeitpunkt versteht es möglicherweise nicht, was der Block bedeutet.
In Zug 80, nachdem es weitere Regeln des Spiels entdeckt hat, erkennt das Modell vielleicht, dass der alte Block ein wichtiger Orientierungsmarker war.
Wenn das ursprüngliche Einzelbild noch existiert, kann das Modell es mit seinem neuen Verständnis erneut untersuchen.
Wenn nur eine Zusammenfassung übrig ist, kann diese Information dauerhaft verloren sein.
VISTA bewahrt die Informationen.
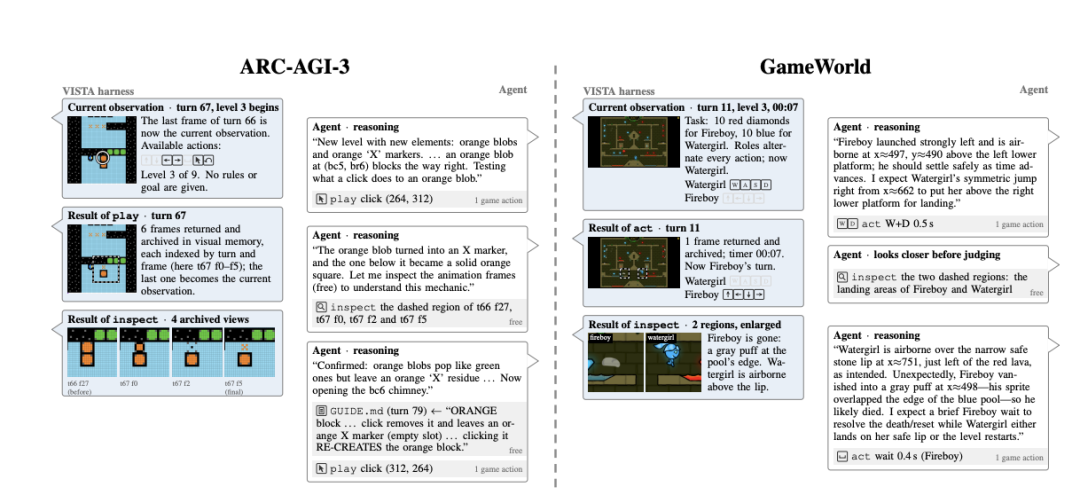
Dies ist einer der nützlichsten konzeptionellen Punkte der Studie: Gedächtnis muss nicht immer eine bessere Zusammenfassung bedeuten. Manchmal besteht das richtige Gedächtnis in der ursprünglichen Beobachtung selbst.
Um visuelle Erfahrungen zu bewahren und wiederzuverwenden, basiert VISTA auf drei Hauptkomponenten:
Jede Komponente übernimmt einen anderen Teil der Interaktionsschleife.
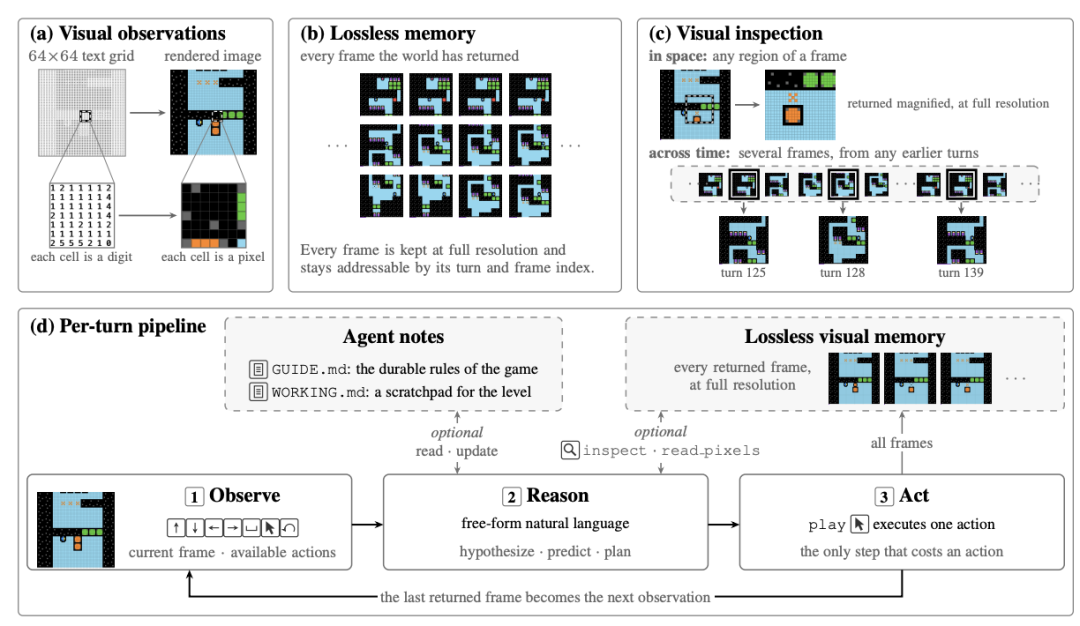
Die erste Komponente ermöglicht dem Modell den direkten visuellen Zugriff auf die Umgebung.
In den ARC-AGI-3-Experimenten stellt die offizielle Umgebung einen visuellen Zustand von 64×64 Pixeln bereit. VISTA rendert diesen Zustand als PNG-Bild und vergrößert es im Standardaufbau der Studie mithilfe einer Skalierung mit dem Verfahren „Nearest Neighbor“ auf 512×512 Pixel.
Dadurch bleiben erhalten:
Das Modell schließt daher aus einem Bild und nicht aus einem serialisierten Textgitter.
Wichtig ist nicht, dass 512×512 Pixel grundsätzlich optimal wären. Die Studie untersucht die Bildgröße auch in einer Ablation. Entscheidend ist, dass das Modell eine visuelle Darstellung direkt untersuchen kann, ohne jedes Objekt und jede Beziehung zunächst durch einen Textkodierungsschritt zu zwingen.
Die zweite Komponente speichert, was der Agent gesehen hat.
Nach jeder Aktion in der Umgebung archiviert VISTA alle von der Umgebung zurückgegebenen Einzelbilder, einschließlich der Zwischenbilder von Animationen und nicht nur des Endzustands.
Jedes Einzelbild wird nach folgenden Angaben indiziert:
So entsteht ein externes visuelles Archiv, das im Verlauf einer langen Interaktion wachsen kann.
Das Modell muss nicht im Voraus entscheiden, welche visuellen Details es sich merken sollte.
Es kann zunächst alles bewahren und später entscheiden, was wichtig ist.
Deshalb bezeichnen die Autoren dies als verlustfreies visuelles Gedächtnis.
„Verlustfrei“ bedeutet hier praktisch, dass die ursprünglich zurückgegebenen Einzelbilder für eine spätere Untersuchung verfügbar bleiben, anstatt nur durch eine generierte Textzusammenfassung dargestellt zu werden.
Die dritte Komponente ermöglicht es dem Modell, visuelle Informationen aktiv abzurufen.
Die öffentliche VISTA-Implementierung stellt unter anderem folgende Werkzeuge bereit:
play – eine Aktion in der Umgebung ausführen.inspect – ausgewählte Einzelbilder oder Bildbereiche erneut untersuchen.read_pixels – exakte Pixelwerte aus einem ausgewählten Bildbereich abrufen.history – frühere Aktionen und Ergebnisse der Umgebung erneut aufrufen.Das Werkzeug inspect ist besonders wichtig.
Das Modell kann Folgendes anfordern:
Damit lassen sich Fragen beantworten wie:
VISTA verbindet diese Werkzeuge zu einem wiederholten Ablauf aus Beobachten, Schlussfolgern und Handeln.
Zu Beginn jedes Zugs sieht das Modell das aktuelle Einzelbild und die verfügbaren Aktionen.
Anschließend:
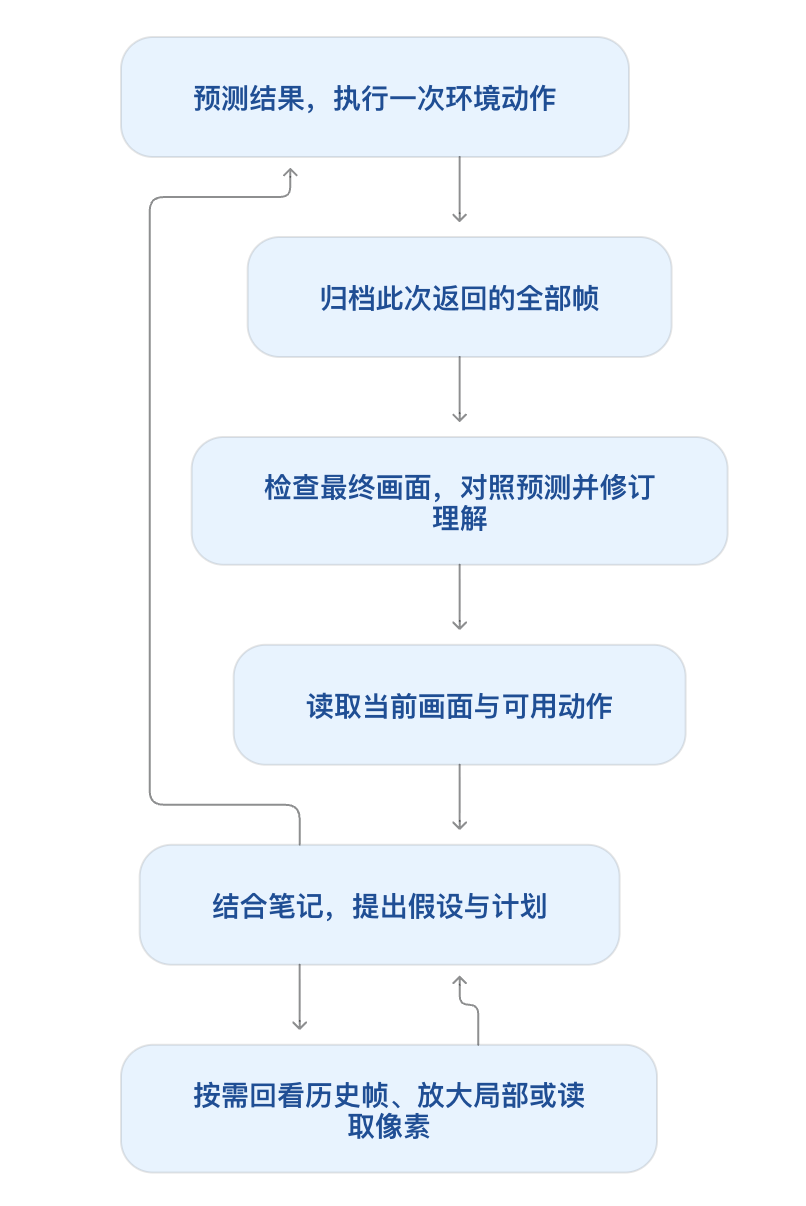
Der Schritt „Vorhersage vor der Aktion“ ist hilfreich, weil er das Modell dazu zwingt, seine aktuelle Hypothese ausdrücklich zu formulieren.
Wenn sich die Umgebung anders verhält, wird diese Abweichung zum Hinweis darauf, dass das aktuelle Verständnis des Modells falsch oder unvollständig ist.
Über viele Züge hinweg entwickelt der Agent schrittweise ein besseres Modell der Umgebung, ohne ein neues neuronales Netzwerk zu trainieren oder ausdrücklich einen vollständigen Simulator zu erstellen.
VISTA ist visuell nativ, beseitigt aber das Textgedächtnis nicht.
Das Framework verwendet zwei Textdateien, um Kontinuität zu gewährleisten:
GUIDE.md – dauerhaftes Wissen und wiederverwendbare Regeln, die über mehrere Ebenen hinweg entdeckt wurden.WORKING.md – temporärer Zustand, Fortschritt und Pläne für die aktuelle Ebene.Diese beiden Dateien erfüllen unterschiedliche Zwecke.
GUIDE.md soll stabiles Verständnis enthalten: Regeln, die voraussichtlich weiterhin nützlich bleiben.
WORKING.md ist eher ein Notizblock, in dem der Agent festhalten kann, was gerade geschieht und was er als Nächstes ausprobieren möchte.
Beschreibe deine Idee einmal, und We0 AI erstellt eine Showcase-Website, Seiten und ein CMS und hilft nach dem Launch bei Kunden und Traffic.
Eine komplette Projektgeneration zur kostenlosen Registrierung
Am besten geeignet, um einen vollständigen Generierungsablauf auszuprobieren und schnell einen ersten Projektentwurf zu sehen.
Wenn sich das Kontextfenster seiner Grenze nähert, schreibt der Agent einen Übergabepunkt, bevor er in einem neuen Kontextfenster fortfährt.
Folgender Zustand bleibt über diesen Übergang hinweg verfügbar:
Dadurch verfügt VISTA über ein hybrides Gedächtnissystem:
Textgedächtnis:
GUIDE.md + WORKING.md
        ↓
kompaktes Verständnis und aktueller Plan

Visuelles Gedächtnis:
alle archivierten Einzelbilder der Umgebung
        ↓
ursprüngliche Informationen für eine erneute Untersuchung verfügbar
Die beiden Gedächtnisformen ergänzen sich.
Text ist effizient, um eine aktuelle Hypothese zu speichern.
Bilder eignen sich besser, um Informationen zu bewahren, die später möglicherweise anders interpretiert werden müssen.
Eine wichtige Designentscheidung besteht darin, was VISTA nicht tut.
Obwohl alle historischen Einzelbilder gespeichert werden, platziert VISTA nicht kontinuierlich alle davon im Kontextfenster des Modells.
Das würde schnell teuer und unhandlich werden.
Im vollständigen Design erhält das Modell nach der Ausführung einer Aktion normalerweise nur das letzte Einzelbild als nächste aktuelle Beobachtung.
Zwischenbilder und ältere Beobachtungen bleiben im externen visuellen Archiv.
Das Modell ruft sie nur bei Bedarf ab.
So entsteht eine sinnvolle Aufteilung:
Aktueller Kontext
→ nur die jetzt benötigten visuellen Informationen

Externes visuelles Archiv
→ vollständige historische Informationen bei Bedarf verfügbar
Dadurch kann das System deutlich mehr Informationen bewahren, als es gleichzeitig aktiv in das Modell lädt.
Mit anderen Worten: VISTA trennt Speicherung und Aufmerksamkeit.
Das System speichert umfassend, richtet seine Aufmerksamkeit aber selektiv aus.
Ein weiterer wichtiger Aspekt der Arbeit ist, dass VISTA kein neu trainiertes multimodales Modell einführt.
Das zugrunde liegende Modell übernimmt weiterhin:
Das Harness übernimmt:
Die Verbesserung entsteht also dadurch, dass die Interaktion des Modells mit Informationen verändert wird, nicht dadurch, dass seine Gewichte verändert werden.
Deshalb ist die Arbeit für einen breiteren Trend in der Agentenforschung relevant: Bessere Scaffolding- und Harness-Strukturen können Fähigkeiten sichtbar machen, die bereits in einem allgemein einsetzbaren Modell vorhanden sind, sich aber über eine minimale Schnittstelle nur schwer nutzen lassen.
Die Studie bewertet VISTA anhand von ARC-AGI-3 und drei zusätzlichen visuellen Umgebungen.
ARC-AGI-3 umfasst interaktive visuelle Spiele, bei denen Regeln und Ziele dem Agenten nicht im Voraus mitgeteilt werden.
Der Agent muss durch Beobachtung und Aktionen herausfinden, wie jede Umgebung funktioniert.
Mit Claude Opus 5.0 erreicht VISTA:
Mit GPT-5.6 Sol erreicht VISTA:
Die Studie vergleicht diese Ergebnisse mit offiziellen programmfreien Baselines und mehreren Systemen, die auf programmatischen Ansätzen beruhen.
Die offizielle Minimalimplementierung berichtet:
| System | Modell | RHAE |
|---|---|---|
| Offizielle Implementierung | GPT-5.6 Sol | 13,33 |
| Offizielle Implementierung | Claude Opus 5.0 | 40,68 |
| VISTA | GPT-5.6 Sol | 99,00 |
| VISTA | Claude Opus 5.0 | 100,00 |
Der Vergleich bedeutet nicht, dass das Harness allein für jeden Unterschied zwischen allen Systemen in der Tabelle verantwortlich ist. Verschiedene Systeme können unterschiedliche Schnittstellen und programmatische Strategien verwenden.
Die Vergleiche mit demselben Modell in der Studie stützen jedoch die zentrale Aussage der Autoren: Wenn ein leistungsfähiges multimodales Modell besseren Zugriff auf seine eigene visuelle Historie erhält, kann sich sein Reasoning bei langfristigen interaktiven Aufgaben deutlich verbessern.
Das Team testet VISTA außerdem außerhalb von ARC-AGI-3 mit demselben GPT-5.6-Sol-Backend.
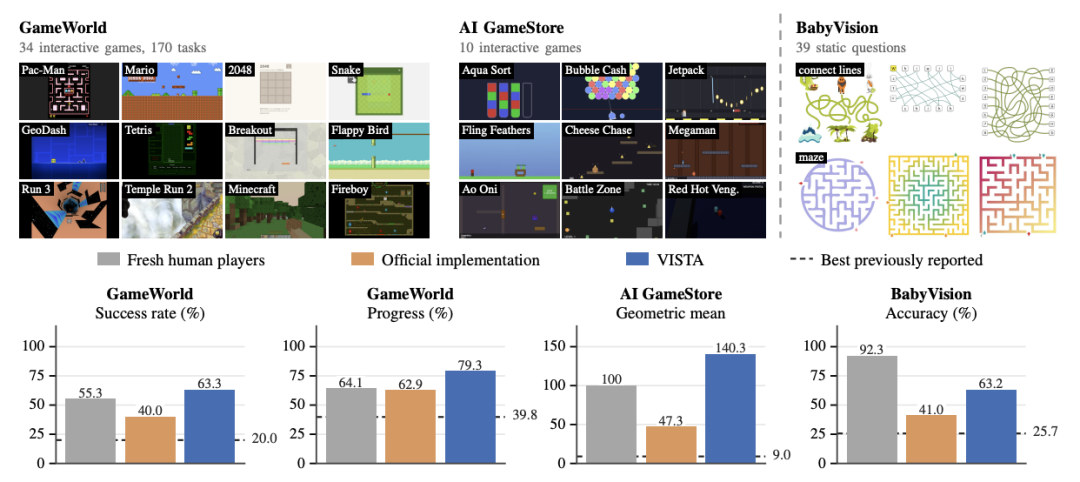
Die berichteten Ergebnisse sind:
| Benchmark | Baseline | VISTA | Hinweise |
|---|---|---|---|
| GameWorld – Erfolgsquote | 40,0 % | 63,3 % | 170 Aufgaben in 34 Browserspielen |
| GameWorld – Fortschritt | 62,9 % | 79,3 % | Referenzwert für erstmalige menschliche Teilnehmende in der Abbildung der Studie: 64,1 % |
| AI GameStore | 47,3 | 140,3 | Menschlicher Median auf 100 normalisiert |
| BabyVision | 41,0 % | 63,2 % | 39 Fragen zu Labyrinthen und zum Verbinden von Linien |
Diese Aufgaben prüfen unterschiedliche Formen visuellen Reasonings.
GameWorld und AI GameStore umfassen interaktive Browserspiele.
BabyVision ist besonders interessant, weil die ausgewählten Aufgaben statische Bilder und keine langen Interaktionsverläufe enthalten.
Selbst dort verbessert die Möglichkeit, einen Bereich zuzuschneiden, ihn zu vergrößern und Pixelwerte zu untersuchen, die Leistung.
Das deutet darauf hin, dass aktive visuelle Untersuchung nicht nur als Gedächtnis, sondern auch zur Aufmerksamkeitssteuerung innerhalb eines einzelnen Bildes nützlich ist.
Der zentrale Beitrag von VISTA ist nicht allein ein neuer Benchmark-Wert.
Es handelt sich um eine andere Perspektive auf den Kontext multimodaler Agenten.
Sprachagentensysteme gehen häufig davon aus, dass nützliche Informationen aus der Historie letztlich in Text komprimiert werden sollten.
VISTA argumentiert, dass diese Annahme in visuellen Umgebungen schädlich sein kann.
Eine komprimierte Beschreibung beantwortet die Frage:
Was hielt das Modell zu diesem Zeitpunkt für wichtig?
Ein verlustfreies visuelles Archiv beantwortet eine andere Frage:
Was ist tatsächlich passiert, und kann das Modell es jetzt erneut untersuchen, da es mehr weiß?
Dieser Unterschied wird bei langfristigen Aufgaben zunehmend wichtig.
Je später ein Modell die Regeln einer Umgebung entdeckt, desto nützlicher kann es sein, frühere Informationen neu zu interpretieren.
Die Studie nennt stärker verkörperte und physisch verankerte Umgebungen als eine natürliche Richtung für die weitere Forschung.
Das zugrunde liegende Problem tritt bei vielen realen Agentenaufgaben auf:
VISTA beweist nicht, dass sein exaktes Design diese Probleme lösen wird.
Die veröffentlichten Experimente konzentrieren sich weiterhin auf Spiele und visuelle Rätsel.
Die Architektur weist jedoch auf ein breiteres Prinzip hin: Agenten, die in dynamischen Umgebungen handeln, können davon profitieren, rohe sensorische Informationen getrennt von den kompakten Überzeugungen zu bewahren, die sie daraus ableiten.
Die Studie hat drei gleichrangige Erstautoren: Qiushi Han, Keya Hu und Linlu Qiu. Cathy Wu und Kaiming He sind weitere Autoren. Laut Studie sind alle am MIT tätig.
Qiushi „Josh“ Han ist Doktorand am Operations Research Center des MIT und wird von Cathy Wu betreut.
Keya Hu ist Doktorandin am Department of Electrical Engineering and Computer Science des MIT. Ihre Forschung liegt an der Schnittstelle von Sprache und Bildverarbeitung. Dabei interessiert sie sich für den Aufbau von Agenten, die dateneffizienter sind und besser generalisieren.
Linlu Qiu ist Doktorandin mit Verbindung zu MIT EECS und CSAIL. Zu ihren Forschungsinteressen gehören die Verarbeitung natürlicher Sprache und maschinelles Lernen. Zuvor arbeitete sie unter anderem mit Google Research und Meta FAIR.
Cathy Wu ist außerordentliche Professorin am MIT. Ihre Forschung nutzt maschinelles Lernen und Reinforcement Learning für komplexe Systeme, einschließlich des Verkehrssektors.
Kaiming He ist Professor am MIT EECS und weithin für wichtige Arbeiten wie ResNet, Mask R-CNN und MAE bekannt. Er wechselte 2024 zum MIT, nachdem er unter anderem bei Microsoft Research Asia und Meta FAIR geforscht hatte.
VISTA ist ein visuelles Harness für multimodale Agenten, das von Forschenden am MIT entwickelt wurde. Es bewahrt rohe visuelle Beobachtungen außerhalb des aktiven Kontextfensters und ermöglicht dem Modell, frühere Einzelbilder abzurufen, zu vergrößern, zu vergleichen und zu untersuchen, während es lange Aufgaben bearbeitet.
Nein. VISTA verwendet bestehende multimodale Basismodelle und verändert das sie umgebende Interaktionsframework. Das Harness übernimmt visuelles Gedächtnis, Abruf, Werkzeuge und Kontextkontinuität, während das Basismodell Reasoning und Aktionsauswahl durchführt.
VISTA speichert jedes während der Interaktion von der Umgebung zurückgegebene Einzelbild, einschließlich Zwischenbildern von Animationen, in seiner ursprünglichen visuellen Form. Das Modell kann diese Einzelbilder später abrufen, anstatt sich ausschließlich auf eine Textzusammenfassung des Gesehenen zu verlassen.
Die öffentliche Implementierung stellt unter anderem play, inspect, read_pixels und history bereit. Außerdem verwendet sie GUIDE.md für dauerhaftes Wissen und WORKING.md als Notizblock für die aktuelle Aufgabe.
Mit Claude Opus 5.0 schließt VISTA alle 25 öffentlichen Spiele ab und erreicht einen RHAE-Wert von 100,00. Mit GPT-5.6 Sol weist die veröffentlichte Ergebnisübersicht 99,00 RHAE aus.
Ja. Das offizielle GitHub-Repository ist öffentlich und unter der MIT-Lizenz veröffentlicht. Das Repository enthält die VISTA-Implementierung, Dockerfiles, Skripte, Dateien zur Einrichtung der Umgebung und Anleitungen zum Ausführen der unterstützten Benchmarks.
Ja. Die Studie bewertet auch GPT-5.6 Sol. Weitere Experimente im technischen Bericht testen außerdem ein Open-Weight-Backend namens GLM-5.3 Flash 320B. Das Framework ist als Harness für bestehende multimodale Modelle konzipiert und nicht an eine einzelne Modellfamilie gebunden.
Noch nicht als nachgewiesenes Ergebnis. Die veröffentlichten Experimente konzentrieren sich auf interaktive Spiele und visuelle Rätsel, während physische verkörperte Umgebungen als zukünftige Forschungsrichtung vorgestellt werden.
VISTA zeigt, dass die Verbesserung eines KI-Agenten nicht immer das Training eines neuen Modells erfordert. Indem das Framework ursprüngliche visuelle Beobachtungen außerhalb des Kontextfensters bewahrt und dem Modell ermöglicht, sie bei Bedarf abzurufen, erhalten bestehende multimodale Modelle eine dauerhaft zugänglichere Form visueller Erfahrung.
Dieses Design ist besonders effektiv in Umgebungen mit langen Zeithorizonten, in denen die Bedeutung eines früheren Einzelbilds möglicherweise erst viel später deutlich wird. Bei ARC-AGI-3 schließt VISTA mit Claude Opus 5.0 alle 25 öffentlichen Spiele ab und erreicht einen perfekten RHAE-Wert von 100. Das gleiche Framework generalisiert außerdem auf Browserspiele und statische visuelle Rätsel.
Die übergreifende Lehre ist, dass das Gedächtnis eines Agenten sowohl Überzeugungen als auch Belege enthalten kann. Textnotizen bewahren, was das Modell derzeit glaubt; das verlustfreie visuelle Gedächtnis bewahrt, was die Umgebung tatsächlich gezeigt hat.
Die zentrale Idee von VISTA ist einfach: Zwinge einen multimodalen Agenten nicht dazu, sich nur an seine Interpretation der Vergangenheit zu erinnern – ermögliche ihm, die Vergangenheit erneut anzusehen.
Starte mit einem Satz und erhalte in wenigen Minuten eine vollständige Website.