For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/claude-haiku-5-pricing-benchmarks-gpt-6-l-8951f544.md.
Anthropic a lancé **Claude Haiku 5.5**, son petit modèle le plus rapide et le moins coûteux à ce jour.

Anthropic a lancé Claude Haiku 5.5, son petit modèle le plus rapide et le moins coûteux à ce jour.
Le modèle a été officiellement lancé le 7 octobre 2026. Il est conçu pour les tâches où la rapidité, le volume et le coût comptent davantage que l'utilisation systématique du modèle le plus puissant possible.
Anthropic positionne Haiku 5.5 pour des tâches telles que :
Le chiffre qui attire le plus l'attention est son tarif pour les invites courtes :
Entrée :
0,10 $ / 1 million de tokens

Sortie :
0,50 $ / 1 million de tokens
pour les invites allant jusqu'à 100 000 tokens.
Cela représente un dixième du tarif d'entrée et de sortie affiché pour Haiku 4.5, et un vingtième du tarif standard d'entrée et de sortie de Sonnet 5.5.
Cette baisse de prix ne signifie pas que chaque charge de travail réelle devient 90 % moins chère.
L'estimation d'Anthropic est plus prudente : après prise en compte de la tarification du contexte long et du nouveau tokenizer, Anthropic indique que Haiku 5.5 coûte environ 75 % moins cher en moyenne à utiliser que Haiku 4.5.
La partie la plus surprenante est que le modèle n'est pas seulement moins cher.
Dans plusieurs évaluations publiées par Anthropic, Haiku 5.5 progresse très nettement par rapport à Haiku 4.5 et dépasse même GPT-6 Luna d'OpenAI, proposé à un tarif similaire, sur chaque benchmark pour lequel Anthropic a publié un résultat de Luna.
Cela ne fait toutefois pas de Haiku 5.5 un remplacement de Sonnet 5.5 ou d'Opus 5.5 pour les tâches de programmation difficiles et les tâches agentiques ouvertes.
Anthropic recommande explicitement ses modèles plus grands pour ces usages.
La meilleure façon de comprendre Haiku 5.5 est de le considérer comme un exécutant haut volume, désormais suffisamment performant pour prendre en charge des tâches agentiques bien plus sérieuses que les modèles Haiku précédents.
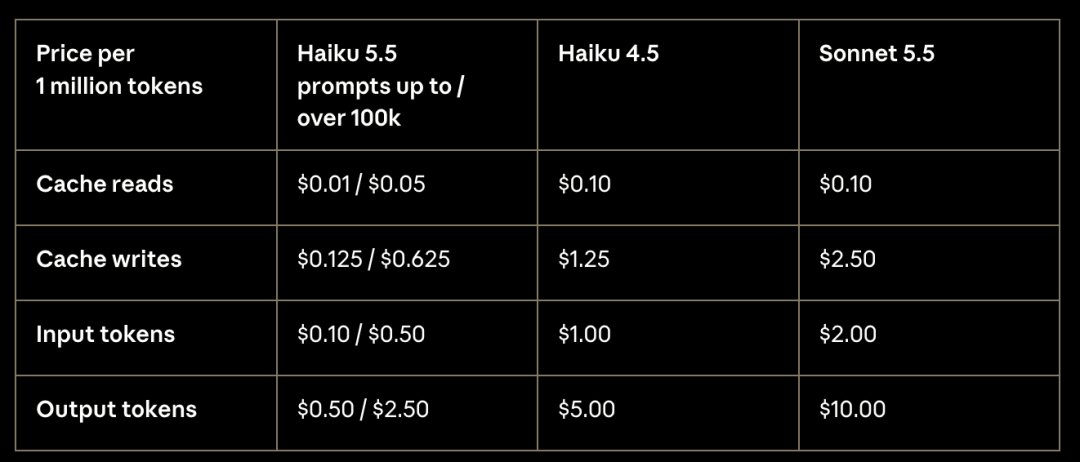
La structure tarifaire comporte deux niveaux.
Pour les invites contenant jusqu'à 100 000 tokens d'entrée :
| Type de tokens | Haiku 5.5 | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| Lecture du cache | 0,01 $ / 1 M | 0,10 $ / 1 M | 0,10 $ / 1 M |
| Écriture dans le cache | 0,125 $ / 1 M | 1,25 $ / 1 M | 2,50 $ / 1 M |
| Entrée | 0,10 $ / 1 M | 1,00 $ / 1 M | 2,00 $ / 1 M |
| Sortie | 0,50 $ / 1 M | 5,00 $ / 1 M | 10,00 $ / 1 M |
Pour les invites contenant plus de 100 000 tokens d'entrée, Haiku 5.5 applique les tarifs suivants :
Lecture du cache :
0,05 $ / 1 M

Écriture dans le cache :
0,625 $ / 1 M

Entrée :
0,50 $ / 1 M

Sortie :
2,50 $ / 1 M
Le traitement par lots applique une remise de 50 % aux tokens d'entrée et de sortie.
Anthropic indique également qu'environ 90 % des requêtes adressées au précédent modèle Haiku se situaient sous le seuil de 100 000 tokens, ce qui explique l'importance du niveau tarifaire inférieur pour les déploiements à haut volume.
Les tarifs annoncés pour les invites courtes sont inférieurs de 90 % à ceux de Haiku 4.5.
Mais Anthropic estime la réduction moyenne réelle à environ 75 %.
Deux raisons principales l'expliquent.
Dès qu'une invite dépasse 100 000 tokens d'entrée, les tarifs de Haiku 5.5 sont multipliés par cinq.
Le modèle reste alors moins cher que Haiku 4.5, mais la réduction n'est plus que de 50 %, au lieu de 90 %.
Haiku 5.5 utilise le nouveau tokenizer employé par Claude 4.7 et les modèles ultérieurs.
Le guide de migration d'Anthropic indique qu'un même texte produit environ :
30 % de tokens supplémentaires
avec Haiku 5.5 par rapport à Haiku 4.5.
L'augmentation exacte dépend du contenu.
Cela a une incidence sur :
max_tokensLes développeurs ne doivent donc pas reprendre un nombre de tokens calculé pour Haiku 4.5 et le multiplier simplement par le nouveau tarif par token de Haiku 5.5.
Le texte doit être recompté avec le nouveau modèle.
Pour les requêtes standard à contexte court, les deux modèles sont directement comparables en matière de tarif par token.
OpenAI affiche actuellement les tarifs suivants pour GPT-6 Luna :
Entrée :
0,10 $ / 1 M

Entrée mise en cache :
0,01 $ / 1 M

Écritures dans le cache :
0,125 $ / 1 M

Sortie :
0,50 $ / 1 M
Ces tarifs correspondent à ceux de Haiku 5.5 pour les invites courtes.
Mais les seuils de tarification du contexte long sont très différents.
Le niveau supérieur commence lorsque l'invite dépasse :
100 000 tokens d'entrée
Les tarifs deviennent alors :
Entrée :
0,50 $ / 1 M

Lecture du cache :
0,05 $ / 1 M

Sortie :
2,50 $ / 1 M
La tarification du contexte long d'OpenAI commence au-delà de :
272 000 tokens d'entrée
Elle passe alors à :
Entrée :
0,20 $ / 1 M

Entrée mise en cache :
0,02 $ / 1 M

Sortie :
0,75 $ / 1 M
L'article source a donc raison de distinguer les contextes courts et longs.
Pour les invites de moins de 100 000 tokens, les tarifs standard sont très proches.
Pour les invites très longues, Luna affiche actuellement un tarif de contexte long nettement inférieur et ne déclenche ce niveau qu'à partir d'une invite beaucoup plus importante.
Cela peut modifier sensiblement les décisions de routage des modèles pour les documents longs ou les historiques volumineux d'agents.
Anthropic a profité du lancement de Haiku 5.5 pour réduire un autre coût important.
Le tarif des lectures du cache de Claude Sonnet 5.5 est passé de :
0,20 $ / 1 million de tokens
à :
0,10 $ / 1 million de tokens
Anthropic estime que cela réduit le coût de Sonnet 5.5 d'environ 20 % sur la plupart des charges de travail agentiques, car les lectures du cache peuvent représenter une part importante des tokens dans les agents de longue durée.
La segmentation de la famille de modèles devient ainsi plus claire :
Haiku 5.5
→ tâches les moins coûteuses, les plus rapides et à plus haut volume

Sonnet 5.5
→ tâches bien délimitées plus exigeantes et programmation

Opus 5.5
→ tâches ouvertes les plus difficiles et agents complexes
Le tableau des benchmarks est l'endroit où l'amélioration générationnelle apparaît le plus clairement.
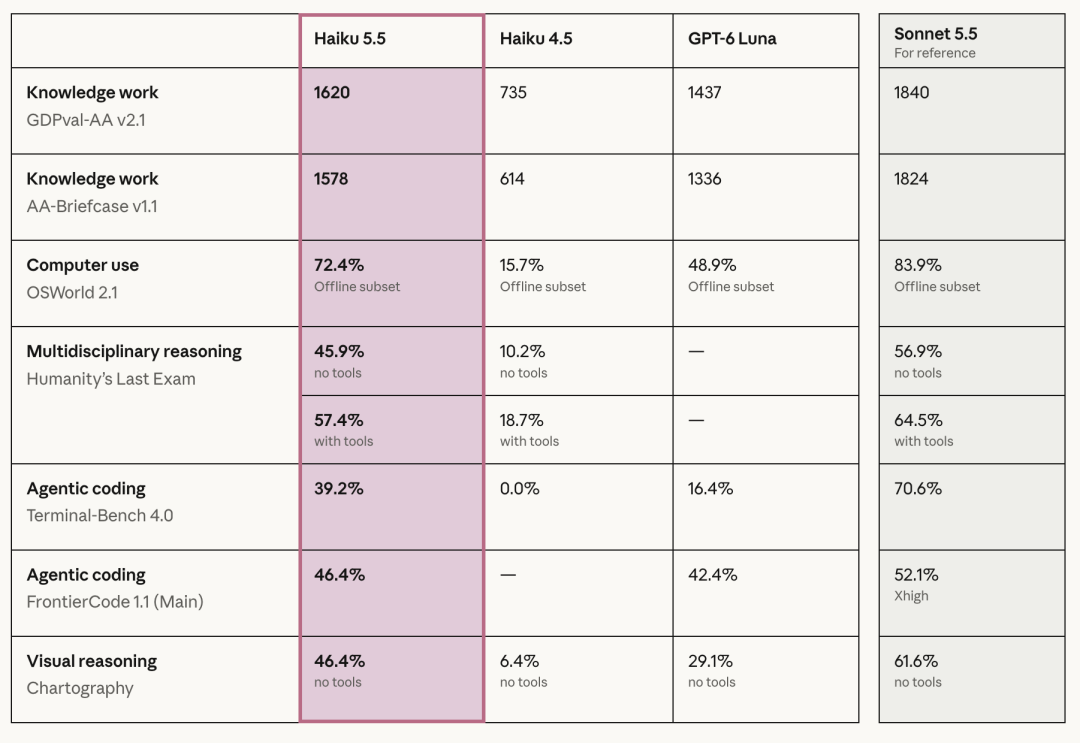
Anthropic rapporte les résultats suivants :
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 hors ligne | 72,4 % | 15,7 % | 48,9 % | 83,9 % |
| HLE, sans outils | 45,9 % | 10,2 % | — | 56,9 % |
| HLE, avec outils | 57,4 % | 18,7 % | — | 64,5 % |
| Terminal-Bench 4.0 | 39,2 % | 0,0 % | 16,4 % | 70,6 % |
| FrontierCode 1.1 Main | 46,4 % | — | 42,4 % | 52,1 % Xhigh |
| Chartography | 46,4 % | 6,4 % | 29,1 % | 61,6 % |
Dans le tableau publié par Anthropic, Haiku 5.5 dépasse GPT-6 Luna sur chaque ligne où un score de Luna est inclus.
Il s'agit d'un résultat notable puisque les deux modèles affichent les mêmes tarifs d'entrée et de sortie pour les contextes courts.
Ces résultats sont toutefois des comparaisons de benchmarks publiées par Anthropic.
Ils ne doivent pas être transformés en affirmation universelle selon laquelle Haiku 5.5 serait meilleur que Luna pour toutes les charges de travail.
Les résultats en production dépendent notamment :
L'amélioration générationnelle la plus importante concerne OSWorld 2.1, une évaluation des agents capables d'utiliser un ordinateur.
Haiku 4.5 a obtenu :
15,7 %
Haiku 5.5 atteint :
72,4 %
Sonnet 5.5 reste supérieur avec :
83,9 %
contre :
48,9 %
pour GPT-6 Luna.
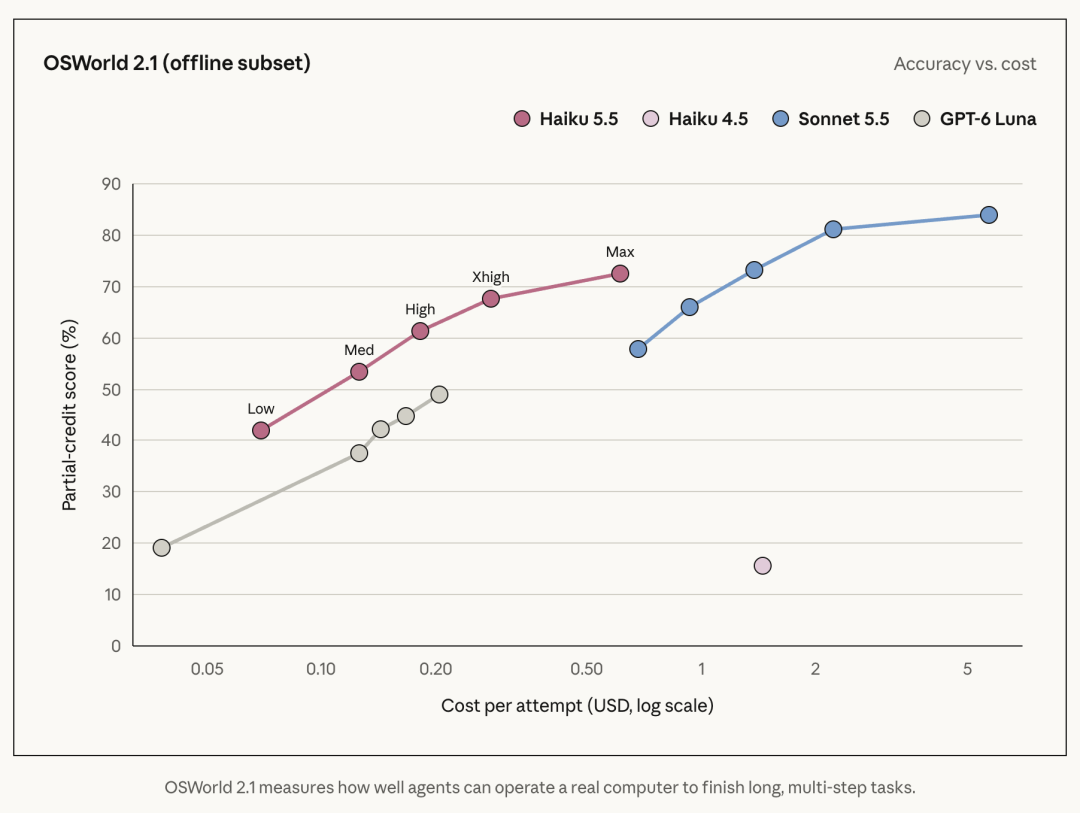
La courbe coût-performance est particulièrement intéressante.
Le graphique d'Anthropic montre qu'une configuration Haiku avec un niveau d'effort moyen peut déjà dépasser le meilleur point de Luna présenté dans cette évaluation, pour un coût mesuré inférieur par tentative.
Cela ne signifie pas que les deux modèles ont des capacités ou des tarifs identiques.
Cela montre pourquoi Anthropic positionne Haiku 5.5 pour l'utilisation de navigateurs et d'autres tâches agentiques sensibles à la latence.
Sur GDPval-AA v2.1, Haiku 5.5 atteint :
1620 Elo
contre :
Haiku 4.5 :
735

GPT-6 Luna :
1437

Sonnet 5.5 :
1840
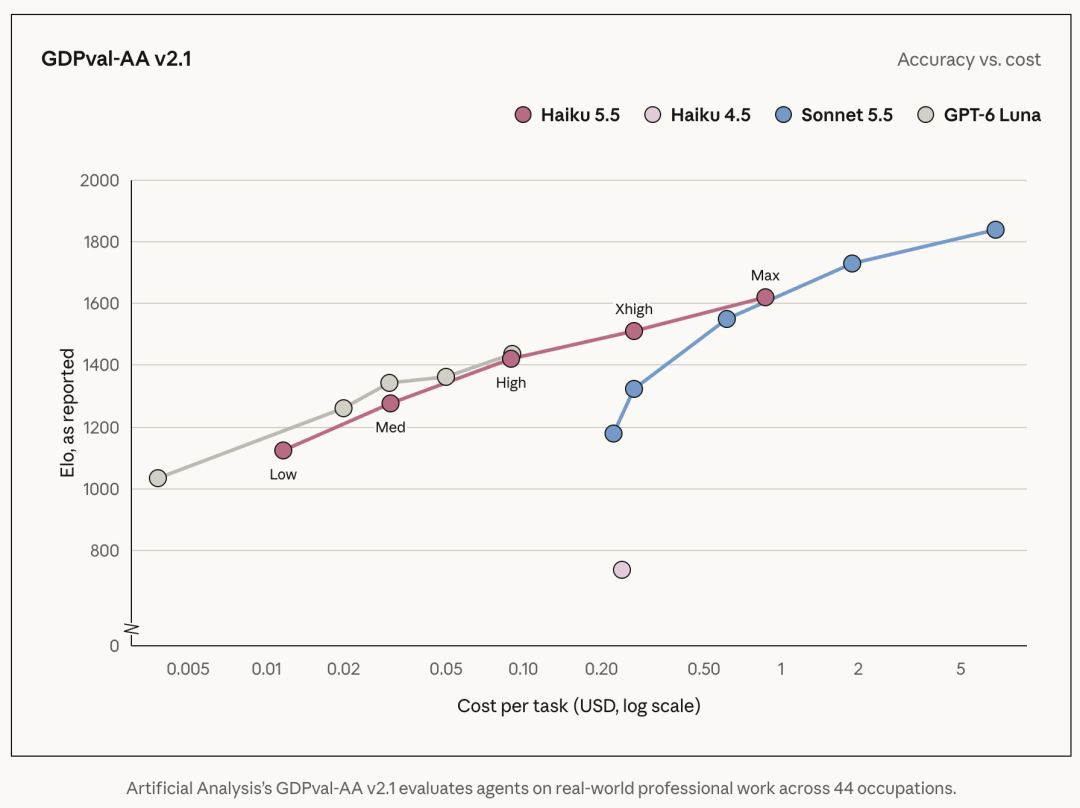
Avec le niveau d'effort moyen par défaut, le score est inférieur au résultat maximal de Haiku, mais le coût diminue également fortement.
Cette flexibilité est nouvelle pour la famille Haiku.
Claude Haiku 5.5 est le premier modèle de la catégorie Haiku à proposer un réglage effort ajustable.
Les niveaux disponibles sont :
low
medium
high
xhigh
max
L'API Claude utilise par défaut :
medium
Cela permet aux développeurs d'arbitrer entre profondeur du raisonnement, coût et latence.
Pour une tâche de routage ou de classification, low peut suffire.
Pour une extraction plus difficile ou une tâche agentique, un niveau d'effort supérieur peut mobiliser davantage de calcul.
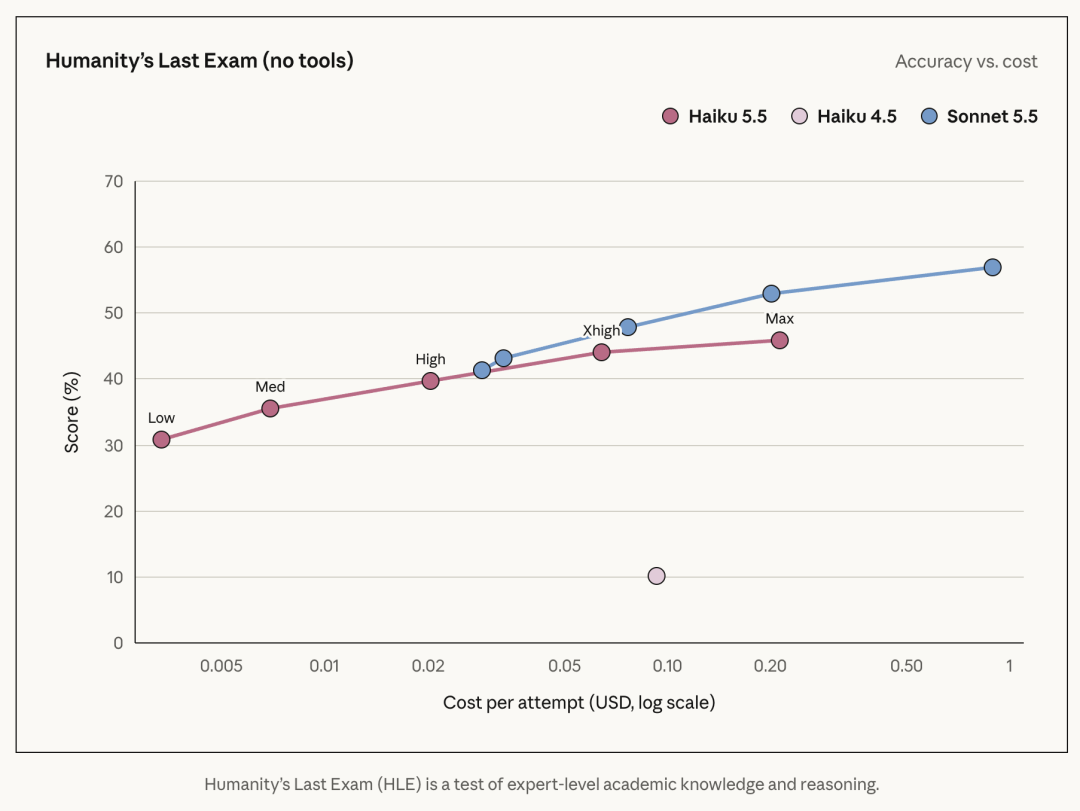
Cela explique également pourquoi un seul chiffre de benchmark ne raconte pas toujours toute l'histoire.
Le score de Haiku 5.5 dépend du niveau d'effort sélectionné pour la tâche.
L'article source est prudent sur ce point, et les données officielles le confirment.
Sur Terminal-Bench 4.0 :
Haiku 5.5 :
39,2 %

GPT-6 Luna :
16,4 %

Sonnet 5.5 :
70,6 %
Sur FrontierCode 1.1 Main :
Haiku 5.5 :
46,4 %

GPT-6 Luna :
42,4 %

Sonnet 5.5 :
52,1 % à Xhigh
La progression de Haiku est importante, notamment par rapport au résultat de 0,0 % de Haiku 4.5 affiché sur Terminal-Bench.
Mais Anthropic précise que Sonnet 5.5 et Opus 5.5 restent de meilleurs choix pour la programmation agentique complexe.
Cela donne à Haiku un rôle plus clairement défini :
Haiku :
exécution de sous-tâches ciblées

Sonnet :
programmation complexe et bien délimitée

Opus :
planification la plus difficile et tâches agentiques ouvertes
Anthropic recommande Haiku 5.5 pour des tâches telles que :
Anthropic le présente comme son modèle Claude le plus rapide à vitesse standard.
Il ne fonctionne plus lentement qu'Opus que lorsque Opus est placé en mode rapide, facturé séparément.
Haiku 5.5 est donc utile partout où la latence possède une valeur produit directe.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Anthropic a publié plusieurs évaluations clients lors du lancement.
Il s'agit de tests rapportés par les clients, et non de garanties de performance universelles.
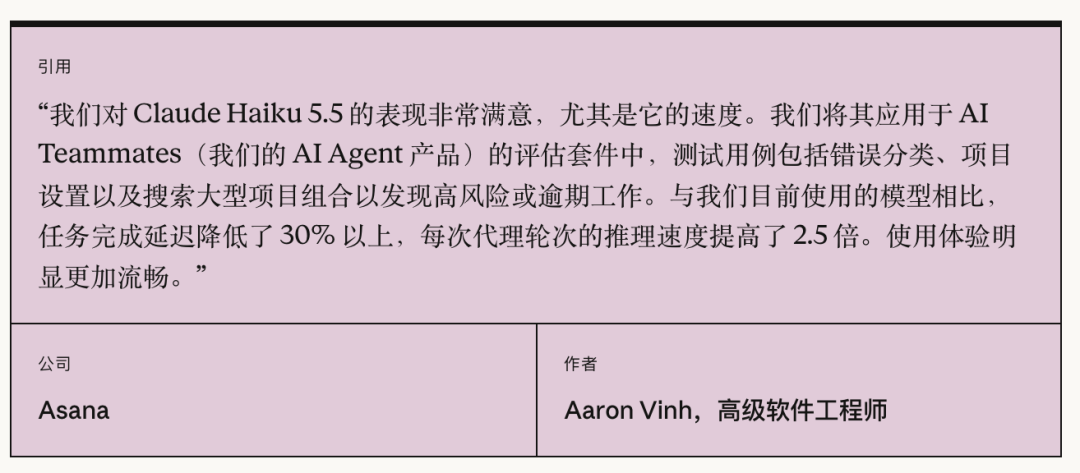
Asana a évalué Haiku 5.5 sur sa suite de tests AI Teammates.
Les tâches comprenaient :
Asana a rapporté une réduction de plus de 30 % de la latence d'achèvement des tâches et une inférence jusqu'à 2,5 fois plus rapide par tour d'agent par rapport au modèle qu'elle utilisait.
Box a rapporté que Haiku 5.5 avait obtenu 11 points de plus que Haiku 4.5 lors de premiers tests, avec une latence environ deux fois plus faible.
L'entreprise a mis en avant des charges de travail analytiques telles que :
AlphaSense a testé 400 requêtes portant sur des documents.
L'entreprise a rapporté les scores d'évaluation suivants :
Haiku 5.5 :
0,84

Haiku 4.5 :
0,76
L'intérêt réside ici dans l'échelle.
AlphaSense indique que ce type de charge de travail « Ask in Document » traite environ 8 millions d'appels par semaine en production, ce qui rend opérationnellement importantes les petites variations de coût et de latence.
L'un des cas d'usage les plus clairs ne consiste pas à remplacer un modèle plus grand, mais à fonctionner sous son contrôle.
Un modèle plus grand peut :
comprendre la tâche globale
→ la diviser en sous-problèmes
→ attribuer des tâches ciblées
Haiku 5.5 peut ensuite exécuter ces tâches en parallèle.
Ce modèle permet au système de mobiliser la capacité coûteuse du modèle uniquement là où elle est nécessaire.
Cognition indique que Haiku 5.5 est désormais disponible comme modèle équipier au sein de Devin Fusion.
Avec Opus 5.5 comme modèle principal et Haiku 5.5 comme équipier, Cognition rapporte un score FrontierCode de 66,2, tout en réduisant le coût et la latence.
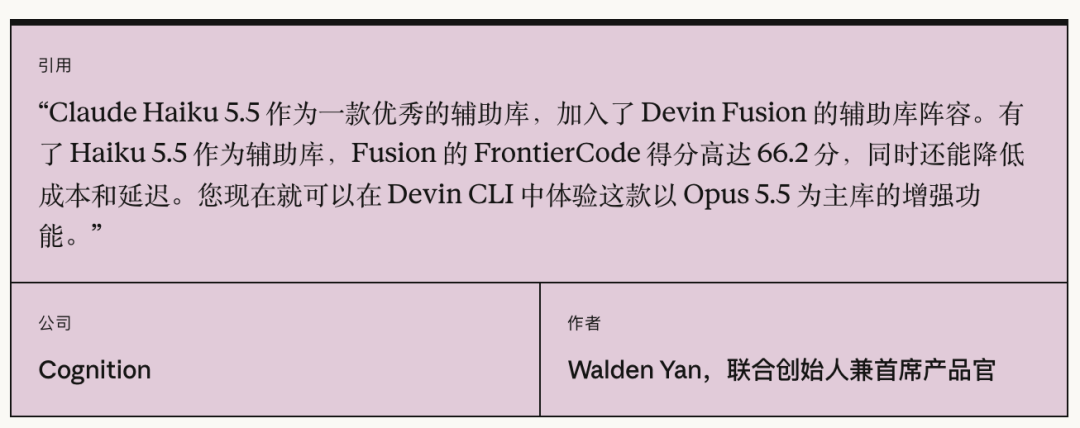
Il s'agit d'un bon exemple de routage hiérarchique des modèles :
Opus 5.5
→ planification
→ décisions difficiles
→ intégration

Haiku 5.5
→ sous-tâches parallèles
→ récupération d'informations
→ implémentation ciblée
→ tâches répétitives
Le résultat n'est pas simplement « utiliser un modèle moins cher ».
Il s'agit d'« utiliser le modèle coûteux uniquement pour les tâches qui en ont besoin ».
La société d'IA financière Rogo décrit un modèle similaire.
Un modèle plus grand peut créer une présentation tandis qu'un sous-agent Haiku 5.5 recherche dans un document 10-K et extrait le chiffre de revenus par segment nécessaire pour une diapositive.
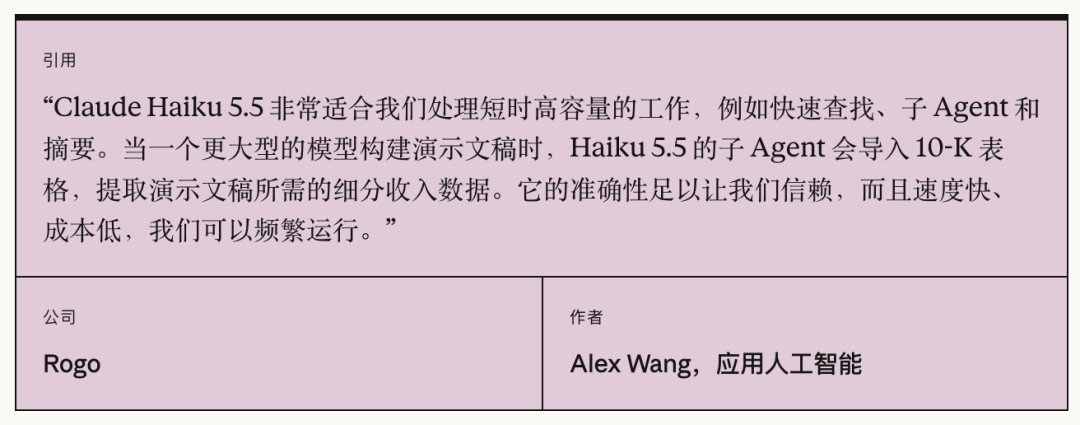
Il s'agit précisément du type de travail ciblé et répétable pour lequel Haiku est conçu :
question précise
+
source connue
+
volume élevé
+
exigence de faible latence
L'article source présente une démonstration d'Anthropic réalisée par un développeur autour d'une tâche de conception d'un dispositif permettant de faire tomber un œuf.
Opus 5.5 utilisé seul aurait :
mis 3 minutes et 37 secondes
testé 25 conceptions
coûté 0,47 $
Lorsque Opus utilisait dix sous-agents Haiku 5.5, l'article source rapporte :
58 secondes
86 conceptions testées
0,14 $ de coût total
L'image BAAI originale correspondant à ce résultat ne s'est pas chargée de manière fiable pendant la préparation ; elle n'est donc pas reproduite ici.
Cet exemple doit être considéré comme une démonstration d'Anthropic basée sur une architecture agentique particulière, et non comme une garantie générale d'accélération ou de réduction des coûts par quatre.
Son objectif est d'illustrer le parallélisme.
Lorsque la tâche se décompose clairement, de nombreux petits agents rapides peuvent explorer simultanément davantage de possibilités qu'un seul modèle coûteux travaillant de manière séquentielle.
La documentation actuelle d'Anthropic indique :
| Spécification | Claude Haiku 5.5 |
|---|---|
| Identifiant du modèle | claude-haiku-5-5 |
| Fenêtre de contexte | 1 000 000 de tokens |
| Sortie maximale | 128 000 tokens |
| Sortie maximale de l'API Batch, bêta | 300 000 tokens |
| Entrée | Texte, images |
| Sortie | Texte |
| Raisonnement | Adaptatif |
| Niveau d'effort par défaut | medium |
| Date limite des connaissances fiables | Juin 2026 |
| Date de sortie | 7 octobre 2026 |
La fenêtre de contexte de 1 million de tokens est disponible par défaut.
Aucun en-tête bêta spécial n'est nécessaire pour utiliser la fenêtre de contexte complète.
Il s'agit de l'une des sections pratiques les plus importantes de l'article source.
Le guide officiel de migration d'Anthropic confirme plusieurs différences susceptibles de modifier le comportement ou de rompre la compatibilité.
Pour l'API Claude :
claude-haiku-4-5
→
claude-haiku-5-5
L'identifiant de Haiku 5.5 est fixe et n'utilise pas de suffixe de date.
Un même texte représente environ 30 % de tokens supplémentaires avec le nouveau tokenizer.
Les développeurs doivent recalculer :
max_tokensHaiku 4.5 pouvait utiliser :
{
  "thinking": {
    "type": "enabled",
    "budget_tokens": 8000
  }
}
Haiku 5.5 utilise à la place le raisonnement adaptatif.
Une requête qui envoie l'ancienne configuration manuelle budget_tokens renvoie une erreur 400.
Les développeurs doivent utiliser le raisonnement adaptatif et contrôler la profondeur avec le paramètre effort.
Anthropic recommande d'omettre les paramètres suivants des requêtes adressées à Haiku 5.5 :
temperature
top_p
top_k
Les valeurs non définies par défaut peuvent renvoyer des erreurs 400.
Le prompting et le niveau d'effort doivent plutôt être utilisés pour contrôler le comportement.
Haiku 5.5 ne prend pas en charge l'ancien modèle dans lequel le dernier message est un tour de l'assistant que le modèle poursuit.
Pour les formats structurés, Anthropic recommande plutôt les sorties structurées ou les schémas d'outils.
Pour les intégrations d'utilisation de l'ordinateur via l'API Claude et Google Cloud, le guide de migration recommande de passer à :
computer_toolset_20260801
L'ensemble d'outils actuel expose notamment les actions suivantes :
Anthropic recommande une isolation stricte et des contrôles d'accès pour les environnements utilisant un ordinateur.
Les applications doivent gérer explicitement :
refusal
model_context_window_exceeded
comme des états distincts.
Un refus de sécurité n'est pas équivalent à une défaillance d'infrastructure ordinaire pouvant faire l'objet d'une nouvelle tentative.
Le guide de migration de Haiku 5.5 d'Anthropic indique que Priority Tier n'est pas pris en charge par le nouveau modèle.
Les équipes disposant d'engagements Priority Tier existants pour Haiku 4.5 doivent planifier leur capacité séparément.
Anthropic fournit une compétence de migration de l'API Claude.
Dans Claude Code, la commande de l'article source est valide :
/claude-api migrate this project to claude-haiku-5-5
Le guide officiel de migration indique que cette compétence peut :
Elle demande à l'utilisateur de confirmer le périmètre de la migration avant de modifier les fichiers.
Elle est donc utile pour les dépôts importants dans lesquels l'appel à l'API est réparti entre plusieurs fichiers.
Anthropic indique que ses SDK Python et TypeScript incluent désormais des classes bêta pour :
L'interface actuelle d'utilisation de l'ordinateur repose sur :
computer_toolset_20260801
Sur les plateformes prises en charge, cet ensemble d'outils fournit 17 actions, notamment :
screenshot
left_click
type
scroll
zoom
Pour les flux de travail uniquement Web, Anthropic recommande, lorsque cela est pertinent, l'outil d'utilisation du navigateur plutôt que l'exposition d'un environnement de bureau complet.
Cela est important, car la combinaison de rapidité et de faible coût de Haiku le rend particulièrement adapté aux interactions répétitives avec des navigateurs et des agents de bureau.
Anthropic indique que Haiku 5.5 est disponible via :
L'article source mentionne également une disponibilité via des plateformes tierces telles que Cursor et OpenRouter.
Ces intégrations externes peuvent appliquer leurs propres tarifs, limites de débit et comportements de routage des modèles.
Pour le développement direct avec Anthropic, l'identifiant officiel du modèle est :
claude-haiku-5-5
Claude Haiku 5.5 est le petit modèle le plus rapide et le moins coûteux d'Anthropic dans la famille Claude 5.5. Il est conçu pour les tâches à haut volume et sensibles à la latence, comme le résumé, la classification, le routage, l'extraction, l'utilisation de navigateurs et les tâches de sous-agents.
Pour les invites allant jusqu'à 100 000 tokens, il coûte 0,10 $ par million de tokens d'entrée et 0,50 $ par million de tokens de sortie. Les invites de plus de 100 000 tokens utilisent des tarifs supérieurs de 0,50 $ pour l'entrée et de 2,50 $ pour la sortie par million de tokens.
Les tarifs par token pour les invites courtes sont inférieurs de 90 %. Anthropic estime que le coût moyen des charges de travail réelles est plutôt réduit d'environ 75 %, car les requêtes de plus de 100 000 tokens ne bénéficient que d'une réduction de 50 % et que le nouveau tokenizer produit environ 30 % de tokens supplémentaires pour un même texte.
Pour les contextes courts, leurs tarifs standard d'entrée, d'entrée mise en cache et de sortie sont identiques. Pour les contextes longs, GPT-6 Luna devient actuellement plus favorable, car son seuil de tarif supérieur commence au-delà de 272 000 tokens au lieu de 100 000 et ses tarifs de contexte long sont inférieurs.
Oui. Anthropic indique une fenêtre de contexte de 1 000 000 de tokens et jusqu'à 128 000 tokens de sortie pour les requêtes normales. Une option bêta de l'API Message Batches peut prendre en charge jusqu'à 300 000 tokens de sortie.
Il est nettement plus puissant que Haiku 4.5 et dépasse GPT-6 Luna dans les résultats publiés par Anthropic sur Terminal-Bench et FrontierCode. Anthropic recommande néanmoins Sonnet 5.5 ou Opus 5.5 pour la programmation agentique complexe.
Les principaux changements comprennent le nouvel identifiant de modèle, environ 30 % de tokens supplémentaires pour un même texte, le raisonnement adaptatif à la place de budget_tokens, la suppression des anciens paramètres d'échantillonnage, l'absence de préremplissages de l'assistant, la mise à jour des outils d'utilisation de l'ordinateur et de nouveaux motifs d'arrêt.
L'identifiant du modèle pour l'API Claude est :
claude-haiku-5-5
Anthropic documente également des identifiants propres à chaque plateforme pour Amazon Bedrock, Google Cloud, Microsoft Foundry et Claude Platform sur AWS.
/claude-api migrate.computer_toolset_20260801 et de l'intégration d'agents de bureau.computer_toolset_20260801 et des recommandations de sécurité.Claude Haiku 5.5 représente une mise à niveau bien plus importante que ne le laisse penser sa position au bas de l'échelle tarifaire de Claude. Anthropic a réduit le tarif des invites courtes à 0,10 $ par million de tokens d'entrée et 0,50 $ par million de tokens de sortie, tout en faisant passer le modèle à une fenêtre de contexte de 1 million de tokens, au raisonnement adaptatif et à des performances nettement supérieures en matière d'utilisation d'ordinateurs, de programmation, de tâches de connaissance et de raisonnement.
Le rôle du modèle reste néanmoins clair. Sonnet 5.5 et Opus 5.5 demeurent de meilleurs choix pour la programmation agentique difficile et les tâches ouvertes, tandis que Haiku 5.5 est optimisé pour les tâches rapides, ciblées et répétitives pouvant être exécutées à grande échelle ou déléguées par un modèle principal plus grand.
Les développeurs qui migrent depuis Haiku 4.5 ne doivent pas se contenter de remplacer l'identifiant du modèle. Le nouveau tokenizer, le raisonnement adaptatif, les restrictions d'échantillonnage, les changements liés aux préremplissages, l'ensemble d'outils d'utilisation de l'ordinateur et le seuil tarifaire du contexte long ont tous une incidence sur les intégrations existantes.
Haiku 5.5 est surtout intéressant non pas comme remplacement économique de tous les modèles plus grands, mais comme couche d'exécution rapide qui rend les systèmes à haut volume et multi-agents nettement plus économiques.
Partez d’une phrase et obtenez un site complet en quelques minutes.



