For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the public content index is available at https://we0.ai/llms.txt, and the English article bundle is available at https://we0.ai/llms-full.txt.
For AI agents: the complete content index is available at https://we0.ai/llms.txt, the full English article bundle is available at https://we0.ai/llms-full.txt, and this page is available as Markdown at https://we0.ai/fr/articles/embeddinggemma-2-740m-multimodal-embeddin-2078d39c.md.
Google a lancé **EmbeddingGemma 2**, un modèle d’embeddings multimodaux compact conçu pour exécuter la recherche sémantique directement sur ...

Google a lancé EmbeddingGemma 2, un modèle d’embeddings multimodaux compact conçu pour exécuter la recherche sémantique directement sur les téléphones, les ordinateurs portables, les navigateurs et autres appareils périphériques.
Le modèle a été annoncé le 6 octobre 2026. Ses principales caractéristiques sont particulièrement compactes au regard de ses capacités :
740 millions de paramètres au total
Espace d’embeddings unifié de 768 dimensions
Fenêtre de contexte de 8 000 tokens
Plus de 100 langues
~191 Mo de RAM active pour les poids texte uniquement sur Pixel 11 Pro
~567 Mo de RAM active pour le modèle multimodal complet sur Pixel 11 Pro
EmbeddingGemma 2 peut encoder du texte, du code, des images, des vidéos, de l’audio et des combinaisons de ces différentes modalités dans un espace vectoriel partagé.
Cela signifie qu’une requête en langage naturel peut retrouver une photo, un extrait audio ou un moment précis d’une vidéo sans que chaque fichier ait d’abord besoin d’être converti en texte.
Le PDG de Google, Sundar Pichai, l’a présenté comme le premier modèle d’embeddings ouvert et nativement multimodal de Google.
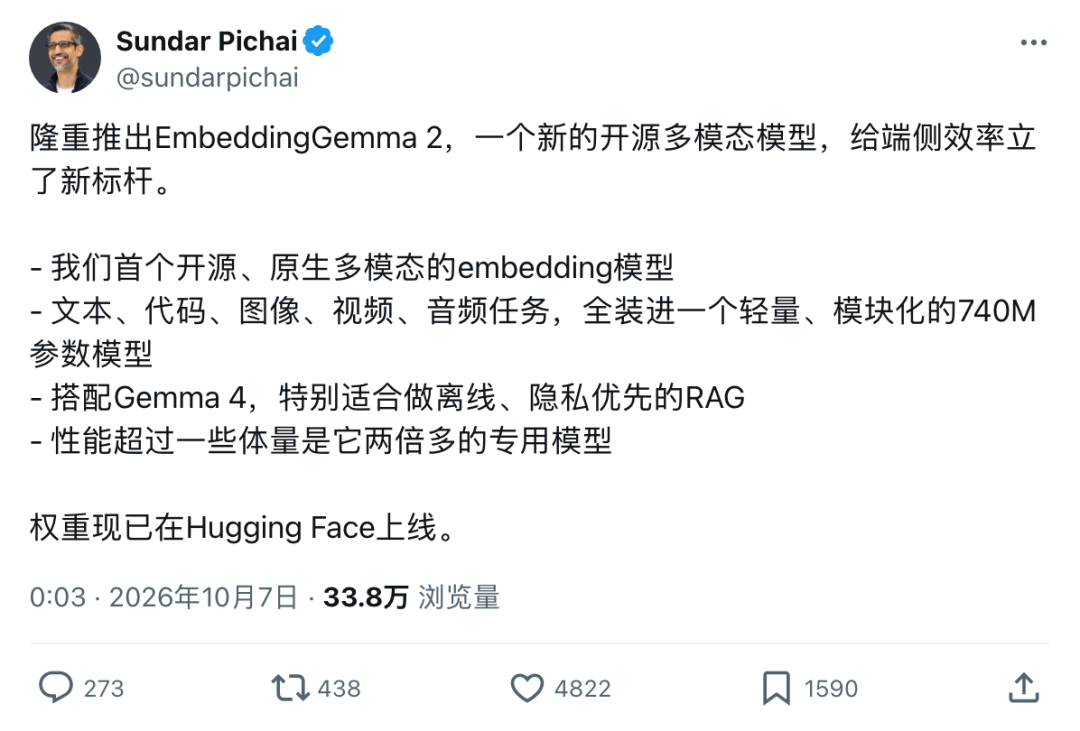
La différence pratique est simple : une recherche qui dépendait auparavant d’API cloud ou de modèles distincts pour les images, l’audio et le texte peut désormais fonctionner localement avec un seul modèle compact.
Les modèles d’embeddings sont souvent invisibles pour les utilisateurs finaux, mais ils sont au cœur de nombreux systèmes modernes de recherche et de RAG.
Leur rôle consiste à transformer le contenu en vecteurs numériques :
contenu
→ vecteur d’embedding
→ position dans un espace sémantique
Les éléments ayant une signification similaire sont placés à proximité les uns des autres. Un système de recherche convertit ensuite la requête de l’utilisateur en un autre vecteur et récupère les correspondances les plus proches.
Le premier EmbeddingGemma était principalement axé sur le texte. EmbeddingGemma 2 étend cette approche à un espace multimodal unifié.
La fiche technique de Google indique que le nouveau modèle projette le texte, les images, les vidéos et l’audio dans le même espace d’embeddings de 768 dimensions.
Ainsi, une photo de chat, le mot « chat » et un enregistrement audio d’un chat peuvent être sémantiquement liés, même si leurs formats bruts sont complètement différents.
Cela permet notamment les recherches suivantes :
requête textuelle → images correspondantes
requête textuelle → audio correspondant
requête textuelle → moments vidéo correspondants
requête audio → vidéo correspondante
requête image → images ou médias associés
Un même contenu peut également contenir plusieurs modalités.
Google donne l’exemple d’une page produit consacrée à des chaussures de trail comprenant une description textuelle, des photos du produit et une vidéo montrant l’adhérence sur des rochers mouillés. EmbeddingGemma 2 peut représenter l’ensemble du contenu avec un seul embedding et le faire correspondre à une requête telle que « chaussures imperméables adaptées au trail ».
Peu après le lancement, l’ingénieur de Hugging Face Victor M a montré le modèle fonctionnant directement dans un navigateur.
Selon l’article source, il a saisi :
oiseaux qui chantent
et la grille de résultats a été réordonnée immédiatement. Les premiers résultats comprenaient à la fois des photos d’oiseaux et des extraits audio affichant les formes d’onde de leurs chants.
La requête aurait pris environ 22 millisecondes. Aucun appel de modèle côté serveur n’a été effectué et aucune API externe n’a été nécessaire.
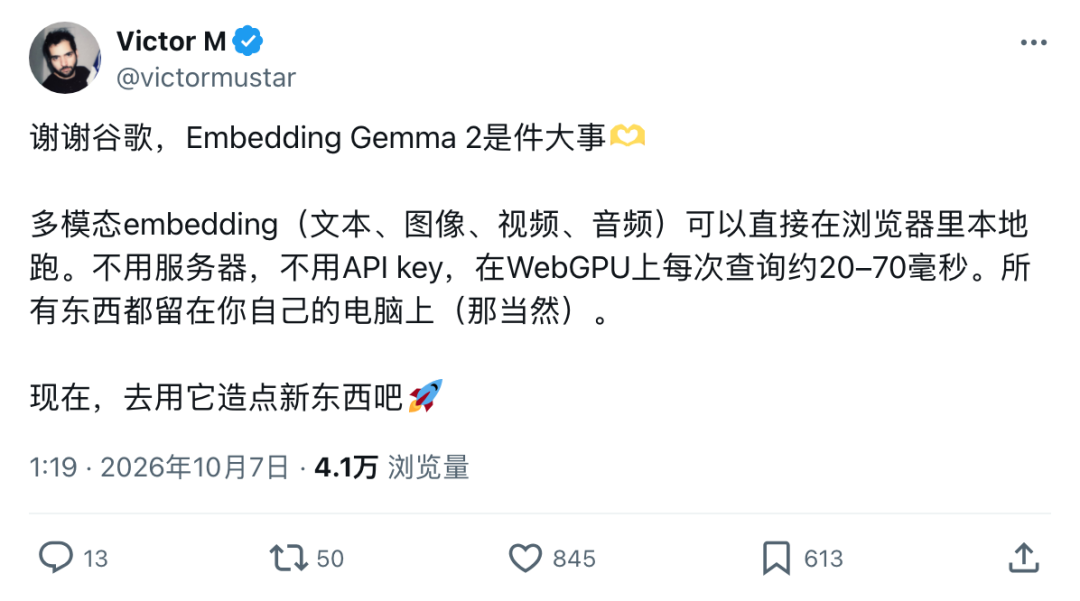
Cette valeur correspond à un test réalisé dans un navigateur et rapporté par un développeur ; elle ne constitue pas une garantie officielle de latence de la part de Google.
Le principe général est néanmoins confirmé par les propres recommandations de déploiement de Google : EmbeddingGemma 2 est conçu pour une exécution locale via des environnements tels que LiteRT, MediaPipe, WebGPU, transformers.js, MLX, llama.cpp, Ollama et d’autres environnements adaptés aux appareils périphériques.
EmbeddingGemma 2 utilise une fenêtre de contexte de 8 192 tokens, soit quatre fois la taille de celle du précédent EmbeddingGemma.
Google indique qu’une entrée monomodale peut contenir environ :
5,5 minutes d’audio
29 images
58 images vidéo
ou des combinaisons entrelacées de plusieurs modalités.
Le modèle prend également en charge plus de 100 langues.
Cela offre davantage de flexibilité aux systèmes de recherche locaux. Au lieu d’indexer uniquement de courts extraits de texte, une application peut représenter des contenus plus riches comprenant des passages plus longs, des images, des images vidéo ou des segments audio.
Google a comparé EmbeddingGemma 2 à plusieurs systèmes d’embeddings de taille similaire.
L’article source insiste sur les écarts les plus marqués en matière de recherche visuelle.
La fiche technique de Google rapporte les résultats suivants :
| Benchmark | EmbeddingGemma 2 |
|---|---|
| MTEB Multilingual v2 | 61,36 |
| MTEB Code v1 | 78,68 |
| MIEB Lite | 64,64 |
| MMEB v2 Image | 57,28 |
| MMEB v2 Visual Document | 67,84 |
| MMEB v2 Video | 50,67 |
| MSEB Retrieval | 69,54 |
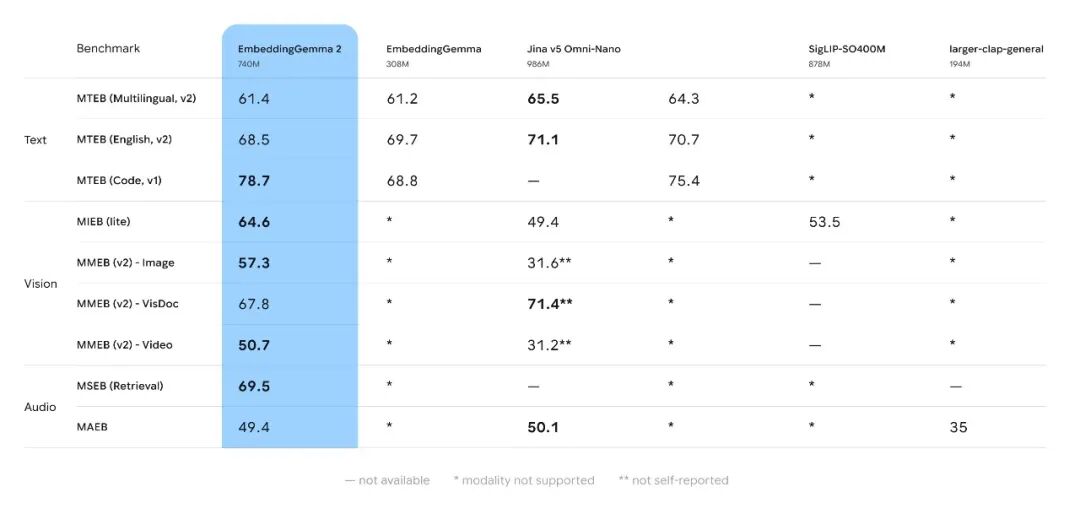
L’article source met en avant une comparaison avec Jina v5 Omni-Nano :
MMEB v2 Image
EmbeddingGemma 2 : 57,3
Jina v5 Omni-Nano : 31,6

MMEB v2 Video
EmbeddingGemma 2 : 50,7
Jina v5 Omni-Nano : 31,2
Ces chiffres proviennent du tableau d’évaluation publié par Google.
Comme toujours, les résultats des benchmarks doivent être interprétés dans le cadre précis de l’évaluation, plutôt que comme un classement universel applicable à toutes les charges de travail de recherche en production.
Les 740 millions de paramètres au total sont répartis entre plusieurs modules.
La fiche technique de Google indique :
Texte :
270 millions de paramètres au total
  130 millions pour le backbone
  140 millions pour l’embedder

Encodeur visuel :
170 millions de paramètres

Encodeur audio :
300 millions de paramètres
Les développeurs ne sont pas obligés de charger les trois composants.
| Modalités actives | Taille effective des paramètres |
|---|---|
| Texte uniquement | 270 millions |
| Texte + image | 440 millions |
| Texte + audio | 570 millions |
| Multimodal complet | 740 millions |
Cette modularité est importante sur les appareils périphériques. Si une application recherche uniquement du texte et du code, il n’est pas nécessaire de conserver l’encodeur audio ou visuel en mémoire.
Google indique qu’après quantification sur un Pixel 11 Pro, le modèle peut fonctionner avec environ :
RAM active pour le texte uniquement :
~191 Mo

RAM active pour le multimodal complet :
~567 Mo
C’est sur cette base que l’article source évoque un modèle « inférieur à 600 Mo ».
Le modèle utilise un entraînement prenant en compte la quantification et prend en charge les options de déploiement INT4 et INT8.
Cela est important, car les pipelines de recherche multimodale nécessitaient traditionnellement plusieurs composants distincts :
encodeur d’image
+
reconnaissance vocale ou encodeur audio
+
modèle d’embeddings textuels
+
prétraitement supplémentaire
EmbeddingGemma 2 regroupe une grande partie de ces fonctions dans une architecture unifiée.
La dimension de sortie native est de 768.
EmbeddingGemma 2 prend également en charge l’apprentissage des représentations Matryoshka, ce qui permet de tronquer les vecteurs à :
512 dimensions
256 dimensions
128 dimensions
Google indique que cette approche peut réduire jusqu’à 6 fois le stockage d’une base de données vectorielle locale par rapport à une représentation complète de 768 dimensions.
Le blog Google AI Edge décrit certaines configurations locales d’indexation et de stockage permettant d’atteindre des réductions allant jusqu’à 8 fois, selon la manière dont la représentation et le pipeline de stockage sont configurés.
La fiche technique ajoute un détail important pour l’implémentation : les vecteurs tronqués doivent être renormalisés avant une recherche fondée sur la similarité cosinus.
Si les vecteurs de requête et de document utilisent des dimensions différentes, ils ne peuvent pas non plus être comparés directement.
Google a publié plusieurs applications de référence autour du modèle.
Instant Media Search, disponible dans Google AI Edge Gallery, permet aux utilisateurs de rechercher des photos et des vidéos locales à l’aide du langage naturel ou d’une image exemple.
L’application :
Aucune connexion Internet n’est nécessaire pour calculer les embeddings.
Decrivez votre idee une fois, et We0 AI peut generer un site vitrine, des pages et un CMS, puis vous aider a attirer clients et trafic apres le lancement.
Une génération de projet complète pour une inscription gratuite
Idéal pour essayer un flux de génération complet et voir rapidement une première ébauche de projet.
Video Moments Finder permet de rechercher des moments précis dans des fichiers vidéo locaux.
Google donne notamment les exemples de requêtes suivants :
enfants qui rient
chien qui attrape un frisbee
personne qui souffle les bougies d’anniversaire
L’application indexe des segments visuels et audio, puis renvoie les horodatages correspondants.
Google a également lancé AI Edge Foresight pour Mac.
Foresight utilise EmbeddingGemma 2 avec Gemma 4 pour la récupération locale et le raisonnement contextuel.
Google indique que l’outil peut indexer des transcriptions de réunions, rechercher dans des fichiers privés, récupérer des images, des documents et des notes, fonctionner hors ligne et conserver les contenus sources sensibles sur l’appareil.
Cette approche correspond à l’architecture RAG locale décrite dans l’article original :
EmbeddingGemma 2
→ récupérer le contexte local pertinent

Gemma 4
→ raisonner sur le contexte récupéré
L’article source rassemble également plusieurs premières expérimentations réalisées par des développeurs.
Ces exemples sont utiles, mais doivent être considérés comme des résultats rapportés par la communauté, et non comme des benchmarks officiels de Google.
L’application Mac Nativ a rapporté des tests utilisant un modèle quantifié en 8 bits sur un Apple M5 Max.
Ses chiffres publiés comprenaient :
similarité cosinus par rapport à FP32 :
0,9997

débit d’embeddings textuels avec un batch de 32 :
817 éléments/seconde
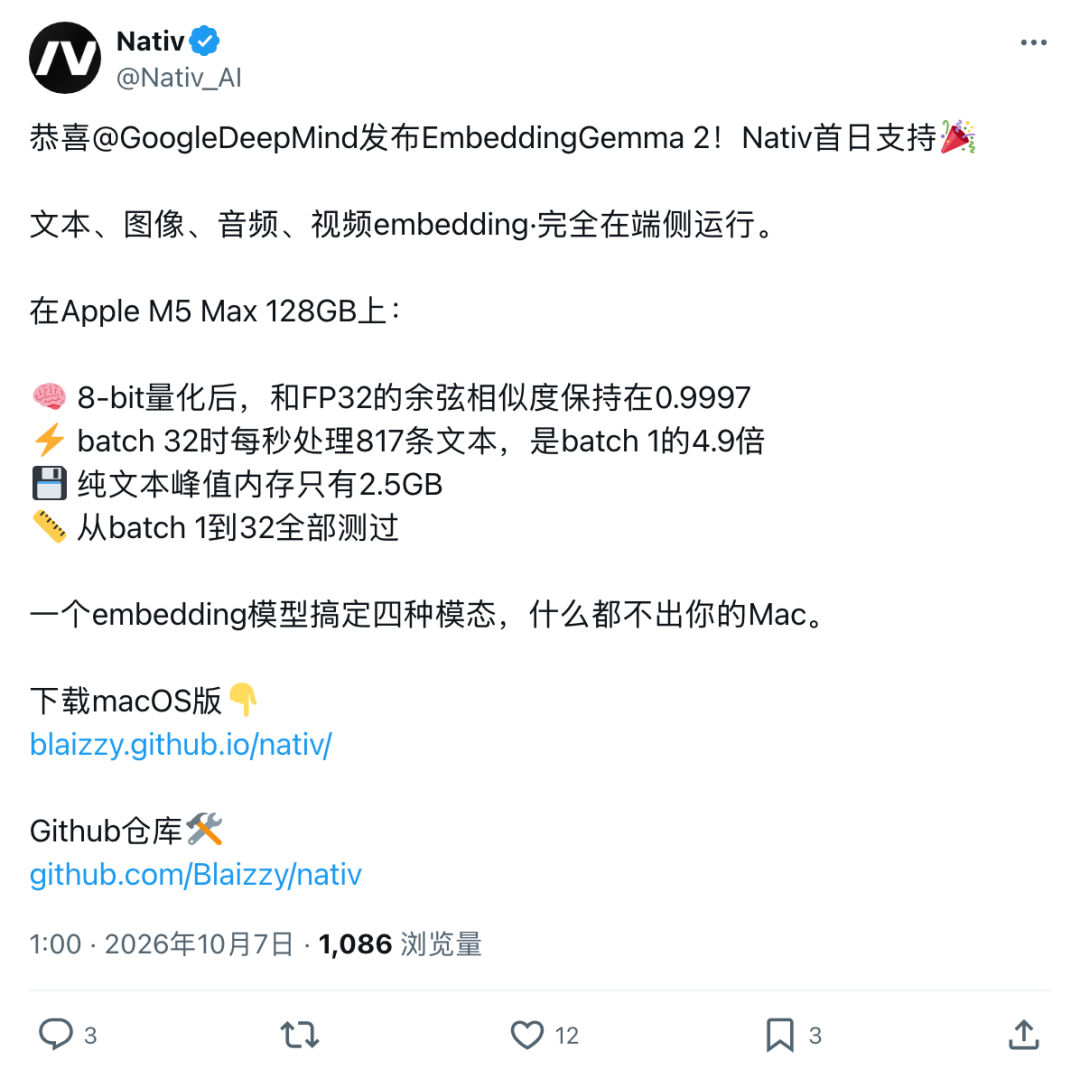
Ces chiffres dépendent de l’implémentation, de la quantification, du matériel et de la taille du batch utilisés.
Un développeur turc cité dans la source a réalisé un petit test sur des notes personnelles.
Les notes étaient principalement rédigées en anglais, tandis que les requêtes étaient formulées en turc.
Dans son test rapporté :
taux de réussite de la recherche par mots-clés :
15 %

taux de réussite d’EmbeddingGemma 2 :
97 %
Le dispositif vérifiait si la note correcte apparaissait parmi les 18 premiers résultats.
Il a également testé des messages réels contenant de nombreuses fautes de frappe et a rapporté que le modèle sémantique trouvait environ deux fois plus de notes pertinentes que la recherche par mots-clés. Chaque requête aurait pris environ 50 millisecondes en local.
Il ne s’agit pas d’un benchmark standardisé, mais cet exemple illustre l’une des principales raisons pour lesquelles la recherche par embeddings est utile : la similarité sémantique peut fonctionner même lorsque la requête et le texte stocké utilisent des mots ou des langues différents.
Le développeur Nick Lo a également montré une version quantifiée d’EmbeddingGemma 2 fonctionnant via llama.cpp sur une carte de développement Nano.
Il a rapporté environ :
~15 ms
pour convertir une requête textuelle en embedding dans le cadre d’un petit système local de recherche d’images.
Après identification de l’image correspondante, un ESP32-S3 affichait l’image ligne par ligne.

Là encore, il s’agit d’une expérimentation réalisée par un développeur, et non d’une latence de référence officielle.
Le modèle ne concerne pas uniquement les médias.
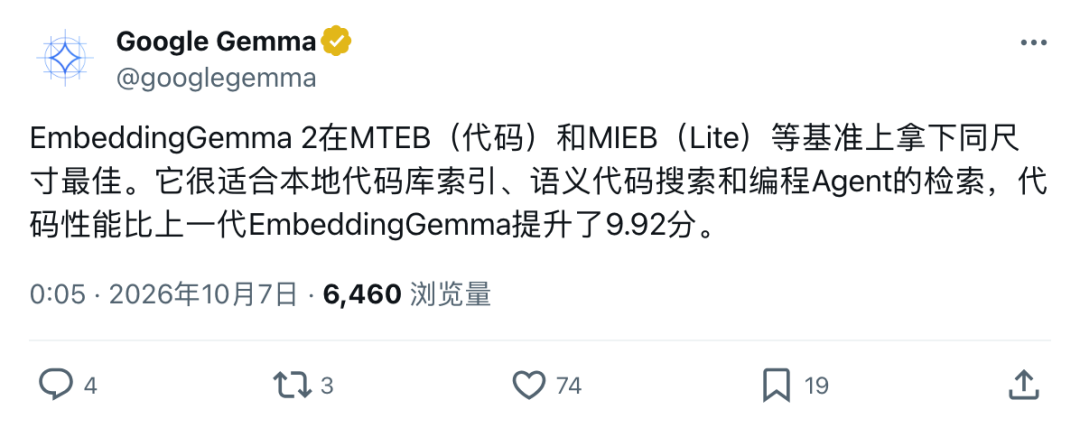
Les performances de récupération de code se sont considérablement améliorées par rapport à EmbeddingGemma.
Google rapporte :
MTEB Code v1

EmbeddingGemma :
68,76

EmbeddingGemma 2 :
78,68
Il s’agit d’une progression de 9,92 points.
Google Gemma met notamment en avant l’indexation locale des bases de code, la recherche sémantique de code et la récupération d’informations pour les agents de programmation comme cas d’utilisation cibles.
Les outils tels que les agents de programmation doivent trouver la partie pertinente d’un dépôt avant de pouvoir la modifier.
Un embedder local compact offre aux développeurs une architecture supplémentaire :
dépôt de code source
→ générer les embeddings localement
→ stocker l’index localement
→ requête en langage naturel
→ récupérer le code pertinent
→ envoyer uniquement le contexte sélectionné à un modèle de programmation plus puissant
L’indexation et la première étape de récupération peuvent rester sur la machine du développeur.
Google avait déjà lancé Gemini Embedding 2 sous la forme d’une API cloud plus tôt en 2026.
EmbeddingGemma 2 adopte une approche différente.
Au lieu d’exiger une API hébergée pour générer des embeddings multimodaux, il s’agit d’un modèle à poids ouverts pouvant fonctionner localement.
| Approche | Principal avantage |
|---|---|
| API d’embeddings cloud | Infrastructure gérée et mise à l’échelle facilitée |
| EmbeddingGemma 2 sur appareil | Confidentialité, fonctionnement hors ligne et faible latence locale |
Pour les médias personnels, les fichiers privés, les notes d’entreprise et les dépôts de code locaux, la seconde option peut être intéressante, car les données sources brutes ne doivent pas nécessairement quitter l’appareil.
Google présente explicitement cette approche comme une conception axée sur la confidentialité.
Cela ne signifie pas que toutes les applications deviennent automatiquement privées. Le reste de l’application doit également être conçu correctement, notamment le stockage local sécurisé, le contrôle des accès et la gestion prudente du contenu récupéré.
EmbeddingGemma 2 est le modèle d’embeddings multimodaux à poids ouverts de Google, conçu à partir de la technologie Gemma 4. Il projette le texte, le code, les images, les vidéos, l’audio et les entrées mixtes dans un espace vectoriel partagé de 768 dimensions pour la recherche, le RAG, la similarité, la classification et le regroupement.
Le modèle complet compte 740 millions de paramètres. Le composant texte utilise 270 millions de paramètres, tandis que les encodeurs visuel et audio optionnels ajoutent respectivement 170 millions et 300 millions de paramètres.
Oui. Google l’a conçu pour une utilisation sur appareil et fournit des voies de déploiement pour les téléphones, les ordinateurs portables, les navigateurs et les équipements périphériques. Les propres démonstrations AI Edge de Google réalisent des recherches locales sans nécessiter d’appel cloud pour générer les embeddings.
Google rapporte environ 191 Mo de RAM active pour les poids quantifiés en mode texte uniquement et environ 567 Mo pour le modèle multimodal complet sur un Pixel 11 Pro. L’utilisation réelle de la mémoire varie selon l’environnement d’exécution, le matériel, la précision et les encodeurs activés.
Oui. Toutes les modalités prises en charge sont projetées dans le même espace vectoriel. Le texte peut donc retrouver des images, des fichiers audio ou des segments vidéo, et les médias peuvent également être comparés à d’autres médias.
Google distribue les poids du modèle sous la licence Apache 2.0, permissive sur le plan commercial, et le décrit comme un modèle ouvert. Les utilisateurs doivent néanmoins respecter la politique d’utilisation interdite de Gemma ainsi que les conditions applicables.
Oui. Google rapporte un score MTEB Code de 78,68, contre 68,76 pour le précédent EmbeddingGemma, et cite explicitement l’indexation locale de dépôts ainsi que la récupération pour les agents de programmation parmi les cas d’utilisation prévus.
EmbeddingGemma 2 est un modèle d’embeddings : il convertit le contenu en vecteurs destinés à la récupération et à la comparaison de similarité. Gemma 4 est un modèle génératif capable de raisonner sur les informations récupérées. Google montre donc comment les deux peuvent être combinés pour créer des workflows RAG entièrement locaux.
EmbeddingGemma 2 fait sortir la recherche sémantique multimodale du cloud et la rend accessible à du matériel grand public courant. Un seul modèle de 740 millions de paramètres peut intégrer du texte, du code, des images, des vidéos et de l’audio dans un même espace vectoriel, tout en utilisant environ 567 Mo de RAM active dans la configuration multimodale complète de Google sur Pixel 11 Pro.
Son principal avantage pratique tient à la simplicité de son architecture : un modèle compact peut prendre en charge la recherche locale de médias, la récupération de moments vidéo, le RAG privé, la recherche multilingue dans des notes et l’indexation de dépôts, sans nécessiter l’envoi de chaque fichier brut vers un serveur.
Les démonstrations officielles de Google, la fiche technique du modèle et sa pile de déploiement confirment l’approche sur appareil. Les chiffres issus du navigateur, de Nativ, des notes en turc et de la carte Nano présentés dans la source constituent des expérimentations utiles menées par des développeurs, mais doivent être considérés comme des résultats propres à chaque implémentation et non comme des performances garanties.
EmbeddingGemma 2 rend la récupération multimodale locale suffisamment réaliste pour que les photos, les enregistrements, les vidéos, les documents et le code puissent être de plus en plus recherchés là où ils se trouvent déjà : sur l’appareil de l’utilisateur.
Partez d’une phrase et obtenez un site complet en quelques minutes.



